워크로드 그룹
핵심 요약 Apache Doris Workload Group은 단일 클러스터를 이름이 지정된 여러 그룹으로 나눕니다. 각 그룹에는 CPU 할당 비율, 메모리 상한, 쿼리 동시 실행 한도, IO 사용 한도가 개별적으로 설정됩니다. 대규모 ETL 작업은 한 그룹에, 대시보드는 다른 그룹에, 비정형 쿼리를 실행하는 분석가는 세 번째 그룹에 배치합니다. 한 그룹에서 쿼리가 통제 불능 상태가 되더라도 다른 그룹까지 함께 영향을 받는 일을 막을 수 있습니다. CPU 격리는 Linux cgroups가 담당하고, 메모리, IO, 동시 실행 제어는 BE 프로세스가 담당합니다.
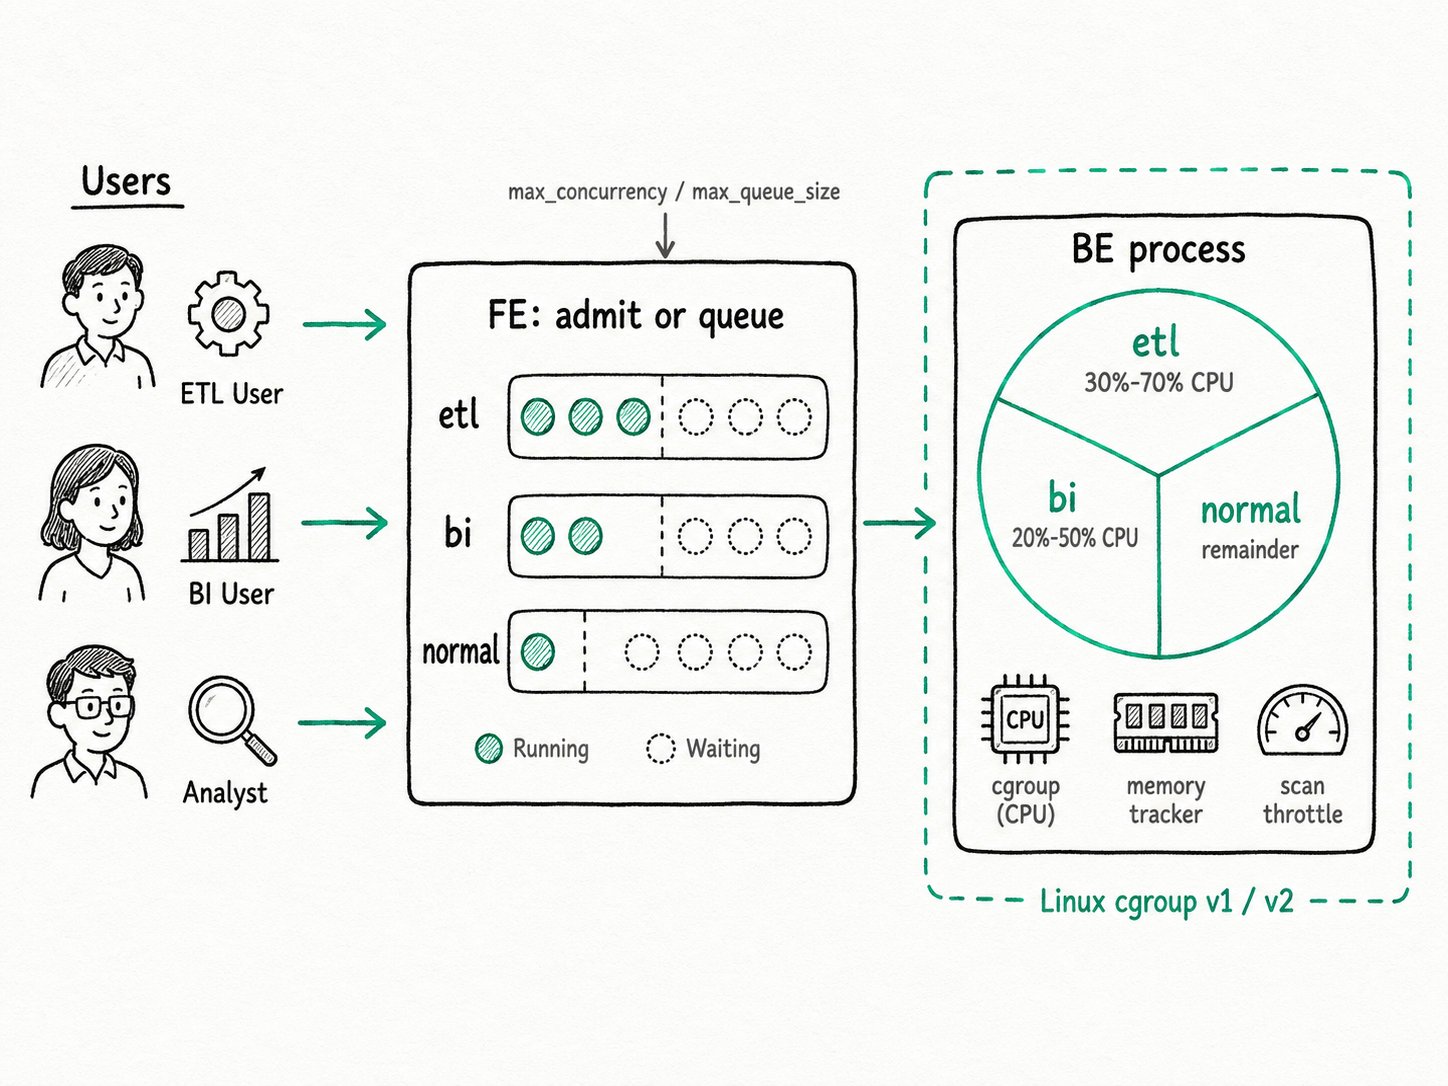
Apache Doris에서 워크로드 그룹을 사용하는 이유는 무엇인가요?
Apache Doris의 워크로드 그룹은 공유 클러스터에서 서로 다른 워크로드가 서로의 리소스를 고갈시키지 않도록 합니다. 운영 환경의 Doris 클러스터가 단 하나의 워크로드만 실행하는 경우는 거의 없습니다. 보통 하루는 이렇습니다. 오전 2시에 ETL 파이프라인이 전날 파티션을 다시 쓰고, 오전 9시에는 재무팀이 일일 보고서를 다시 실행합니다. 업무 시간에는 경영진용 대시보드가 십오 초마다 동일한 GROUP BY region 쿼리로 조회하고, 분석가는 SELECT * 쿼리를 실행하면서 WHERE 절을 깜박합니다.
리소스 제어가 없으면 이 네 가지 워크로드가 하나의 공용 리소스 풀을 공유합니다. ETL 작업은 대시보드를 처리하는 스레드와 동일한 스레드에서 실행됩니다. 문제 있는 비정형 쿼리가 BE 메모리를 가득 채우면 보고서 쿼리가 강제로 종료됩니다. 동시 실행 수에 제한이 없으므로 대시보드 새로고침 요청이 갑자기 몰리면 ETL 부하까지 겹쳐 모든 워크로드의 성능이 떨어집니다.
Workload Group은 하드웨어를 추가하지 않고 이 문제를 해결합니다. 워크로드 유형별로 그룹을 정의하고, 각 그룹에 허용할 한도를 설정한 다음, 사용자를 적절한 그룹에 연결하면 됩니다. 클러스터는 동일한 BE 집합에서 계속 실행되지만, 이제 BE 스케줄러, 메모리 트래커, cgroup 컨트롤러가 설정한 경계에 따라 리소스를 나눕니다.
Apache Doris의 워크로드 그룹이란 무엇인가요?
Apache Doris의 워크로드 그룹은 프로세스 내부 격리 기능입니다. 모든 BE 프로세스가 모든 그룹을 처리하지만, BE는 각 스레드, 스캔 슬롯, 메모리가 어느 그룹에 속하는지 추적합니다. CPU 격리는 BE 작업 스레드를 그룹별 cgroup에 배치합니다. 메모리 격리는 BE 메모리 트래커에서 그룹별 사용량을 추적하고, 그룹이 상한을 초과하면 스필이나 쿼리 취소를 실행합니다. 동시 실행 제어는 FE에서 이루어집니다. 각 그룹에는 대기열이 있으며, 한도를 넘는 쿼리는 대기하거나 즉시 실패합니다.
주요 용어
min_cpu_percent/max_cpu_percent: 그룹에 예약되는 CPU 대역폭(소프트 하한)과 절대 초과할 수 없는 한도(하드 상한)입니다. 모든 그룹의min_cpu_percent합계는 100% 미만이어야 합니다.min_memory_percent/max_memory_percent: 그룹에 보장되는 BE 메모리 비율과 쿼리가 스필되거나 강제로 종료되기 전에 사용할 수 있는 최대 메모리 비율입니다.max_concurrency/max_queue_size/queue_timeout: 실행 중인 쿼리 수의 상한, 대기열 크기, 대기열에 들어간 쿼리가 기다릴 수 있는 시간입니다. 이 세 값은 모두 클러스터 전체가 아닌 FE별로 적용됩니다.read_bytes_per_second/remote_read_bytes_per_second: 그룹별 IO 제한입니다. 로컬 테이블에는 데이터 디렉터리별로, 외부 소스에는 BE별로 적용됩니다.normal그룹: 처음 시작할 때 자동으로 생성되는 기본 그룹으로, 다른 그룹에 연결되지 않은 모든 세션에서 사용됩니다. 삭제할 수 없습니다.
Apache Doris의 워크로드 그룹은 어떻게 작동하나요?
Apache Doris의 워크로드 그룹은 FE에서 대상 그룹을 결정하고 쿼리 실행을 허용하거나 대기열에 넣은 다음, BE에서 CPU, 메모리, IO 한도를 적용합니다.
- 그룹 결정(FE). FE는 명시적인
/*+ SET_VAR(workload_group='...') */힌트, 세션 변수workload_group, 사용자 속성default_workload_group,normal순서로 그룹을 선택합니다. FE는 선택한 그룹에 대한 USAGE 권한을 확인합니다. - 실행 허용 또는 대기열 배치(FE). 그룹의 대기열은 현재 FE에서 해당 그룹의 쿼리가 몇 개 실행 중인지 확인합니다.
max_concurrency미만이면 쿼리에 슬롯을 할당하고 실행합니다. 한도를 초과하면 대기하며, 대기열 크기는max_queue_size, 대기 시간은queue_timeout으로 제한됩니다. 대기열이 가득 차면 쿼리를 즉시 거부합니다. - 스레드를 cgroup에 고정(BE). 각 BE는 그룹마다
/sys/fs/cgroup/doris/<wg_id>(cgroup v2) 또는/sys/fs/cgroup/cpu/doris/<wg_id>(v1) 아래에 cgroup 하나를 유지합니다. 해당 그룹의 프래그먼트가 실행되면 작업 스레드가 그 cgroup에 들어갑니다. 커널의 CFS 스케줄러는min_cpu_percent(cpu.weight사용)와max_cpu_percent(cpu.max사용)를 적용합니다. - 그룹별 메모리 추적(BE). 모든 메모리 할당에는 그룹 ID가 표시됩니다. 그룹의 메모리 트래커가 추적하는 사용량이
memory_low_watermark를 넘으면 스필을 지원하는 연산자가 디스크로 스필하기 시작합니다. 사용량이memory_high_watermark를 넘으면 BE는 해당 그룹의 쿼리를 일시 중지하고, 사용량을 다시 기준치 아래로 낮추기 위해 메모리를 가장 많이 사용하는 쿼리를 취소할 수 있습니다. - 스캔 제한(BE). 로컬 및 원격 스캔 스레드 풀에는 그룹별 상한(
scan_thread_num,max_remote_scan_thread_num)이 있으며,read_bytes_per_second는 각 그룹의 스캔이 사용할 수 있는 디스크 IO 양을 제한합니다. 이 설정으로 인덱스를 사용하지 않는 전체 테이블 스캔이 SSD 대역폭을 모두 소진하는 것을 막을 수 있습니다.
빠른 시작
-- One group for ETL, one for BI dashboards
CREATE WORKLOAD GROUP etl PROPERTIES (
  'min_cpu_percent'='30','max_cpu_percent'='70',
  'min_memory_percent'='30','max_memory_percent'='70',
  'max_concurrency'='10');

CREATE WORKLOAD GROUP bi PROPERTIES (
  'min_cpu_percent'='20','max_cpu_percent'='50',
  'min_memory_percent'='20','max_memory_percent'='50',
  'max_concurrency'='50','max_queue_size'='100','queue_timeout'='3000');

-- Bind users persistently
SET PROPERTY FOR 'etl_user' 'default_workload_group'='etl';
SET PROPERTY FOR 'bi_user'  'default_workload_group'='bi';

-- One-off override for a single query
SELECT /*+ SET_VAR(workload_group='bi') */ region, SUM(revenue)
FROM orders WHERE dt = CURRENT_DATE() GROUP BY region;
예상 결과
+------+-------------------+-------------------+-----------------+
| name | running_query_num | waiting_query_num | max_concurrency |
+------+-------------------+-------------------+-----------------+
| etl  | 4                 | 0                 | 10              |
| bi   | 47                | 12                | 50              |
+------+-------------------+-------------------+-----------------+
SHOW WORKLOAD GROUPS(또는 SELECT ... FROM information_schema.workload_groups)로 실시간 쿼리 수를 확인할 수 있습니다. 대기 중인 12개 쿼리는 bi에서 이미 실행 중인 47개 쿼리 뒤에서 차례를 기다립니다. ETL 쿼리 네 개는 BI가 바쁠 때도 CPU의 30%를 보장받으며, 70%를 초과해서 사용할 수는 없습니다.
Apache Doris의 워크로드 그룹은 언제 사용해야 하나요?
단일 클러스터에서 여러 유형의 워크로드를 실행하며, 하드웨어를 추가로 구매하지 않고도 부하가 걸렸을 때 예측 가능한 동작이 필요하다면 Apache Doris의 워크로드 그룹을 사용하세요.
적합한 경우
- 혼합 워크로드 클러스터: 공유 BE에서 ETL, 예약 보고서, 대시보드, 분석가의 비정형 쿼리를 함께 실행하는 경우입니다.
- 완벽한 격리보다 비용이 더 중요한 멀티 테넌트 배포: 여러 팀이 하나의 클러스터를 사용하면서 부하가 걸렸을 때도 예측 가능한 동작이 필요한 경우입니다.
- 문제를 일으키는 것으로 알려진 워크로드를 제한하려는 경우입니다. 팀에서 습관적으로 실행하는
SELECT *, 때때로 요청이 폭증하는 Kafka 백필 등 과도한 리소스 사용을 억제하고 싶은 워크로드에 적합합니다. - 스토리지와 컴퓨팅이 분리된 모드에서 Compute Group과 함께 사용하는 경우입니다. Compute Group은 별도의 BE 집합을 제공하고, 워크로드 그룹은 그 안의 리소스를 나눕니다.
적합하지 않은 경우
- 별도의 SLA, 별도의 보안 도메인, 과금 대상 테넌트 등 물리적 격리가 필요한 경우입니다. BE 충돌이나 커널 OOM은 여전히 같은 프로세스의 모든 그룹에 영향을 줍니다. 대신 Resource Group이나 전용 Compute Group을 사용하세요.
- 클러스터 전체의 동시 실행 한도를 하나의 값으로 설정하려는 경우입니다. FE가 세 개이면
max_concurrency=10설정으로 클러스터 전체에서 최대 30개의 쿼리를 동시에 실행할 수 있습니다. 이를 고려해 FE별 상한을 조정하거나, 사용자를 하나의 FE에 고정하는 로드 밸런서를 클러스터 앞에 배치하세요. - 권한이 없는 Docker 또는 Kubernetes 컨테이너에서 BE를 실행하는 경우입니다. CPU 한도를 적용하려면 BE 프로세스가 호스트의 cgroup 트리에 대한 읽기 및 쓰기 권한을 가져야 합니다. 특권 모드(또는 Doris Operator)가 없으면 CPU 제한은 오류 표시 없이 적용되지 않습니다. 메모리와 동시 실행 제어는 여전히 작동하지만, 가장 유용한 제어 수단을 사용할 수 없게 됩니다.
- 메모리 오버커밋을 활성화하고
max_memory_percent의 합계를 100%까지 설정한 경우입니다. 소프트 한도를 초과했을 때 사용할 여유 메모리가 남지 않으며, 전체 상한에 도달하면 BE는 해당 그룹에서 메모리를 가장 많이 사용하는 쿼리를 취소합니다. 10~20%의 여유를 남겨 두세요. - 워크로드가 짧은 시간에 몰렸다가 끝나는 특성이 강해 고정 할당보다 Snowflake 방식의 자동 확장 웨어하우스가 더 저렴한 경우입니다. Workload Group은 고정된 리소스 풀을 나누며, 새로운 컴퓨팅 리소스를 프로비저닝하지 않습니다.
더 알아보기
- Workload Group 참조: 전체 속성 표, cgroup 설정 절차, 4.0의 속성 이름 변경에 따른 마이그레이션 참고 사항입니다.
- 워크로드 관리 개요: Workload Group, Resource Group, Compute Group의 관계와 각 기능을 선택해야 하는 상황을 설명합니다.
- 동시 실행 제어 및 대기열 관리: FE별 대기열의 동작 방식, 관리자가 사용하는
bypass_workload_group재정의 설정, 여러 FE를 사용할 때의 대기열 관련 주의 사항을 설명합니다. - 디스크 스필: 그룹이
memory_low_watermark에 도달했을 때의 동작과 슬롯 기반 메모리 정책의 작동 방식을 설명합니다. information_schema.workload_groups: 그룹의 실시간 상태를 보여 주는 시스템 테이블로, 위 예제에서 사용합니다.- Resource Group: 더 강력한 SLA 경계를 위한 물리적 BE 노드 격리 기능입니다.
- Compute Group: 스토리지와 컴퓨팅이 분리된 환경에서 데이터 복사 없이 격리를 추가하는 기능입니다.
- Apache Doris의 멀티 테넌트 워크로드 격리: 16코어 BE에서 CPU 소프트 한도와 하드 한도를 측정한 내부 벤치마크가 포함된 초기 설계 블로그 글입니다.
- MPP 아키텍처: Workload Group이 쿼리별로 프래그먼트 인스턴스 수를 제한하는 실행 모델입니다.