Doris와 Iceberg 사용하기
새로운 개방형 데이터 관리 아키텍처인 Data Lakehouse는 데이터 웨어하우스의 고성능 및 실시간 처리 기능에 데이터 레이크의 저렴한 비용과 유연성을 결합하여, 사용자가 다양한 데이터 처리 및 분석 요구 사항을 더 편리하게 충족할 수 있도록 합니다. 기업 빅데이터 시스템에서도 점점 더 널리 활용되고 있습니다.
최근 버전에서 Apache Doris는 데이터 레이크와의 통합을 강화했으며, 이제 성숙한 Data Lakehouse 솔루션을 제공합니다.
- Apache Doris는 0.15 버전부터 Hive 및 Iceberg 외부 테이블을 도입하여, 데이터 레이크에서 Apache Iceberg와 연계할 수 있는 가능성을 모색했습니다.
- Apache Doris는 1.2 버전부터 Multi-Catalog 기능을 정식 도입하여 다양한 데이터 소스의 메타데이터를 자동으로 매핑하고 데이터에 접근할 수 있게 했으며, 외부 데이터 읽기와 쿼리 실행의 성능도 폭넓게 최적화했습니다. 이제 빠르고 사용하기 편리한 Lakehouse 아키텍처 구축을 완벽하게 지원합니다.
- Apache Doris는 2.1 버전에서 Data Lakehouse 아키텍처를 한층 강화하여 주요 데이터 레이크 포맷(Hudi, Iceberg, Paimon 등)의 읽기 및 쓰기 기능을 개선하고, 다양한 SQL 방언과의 호환성과 기존 시스템에서 Apache Doris로의 원활한 마이그레이션을 지원했습니다. 데이터 과학 및 대규모 데이터 읽기 시나리오를 위해 Doris는 Arrow Flight 고속 읽기 인터페이스를 통합하여 데이터 전송 효율을 100배 향상했습니다.
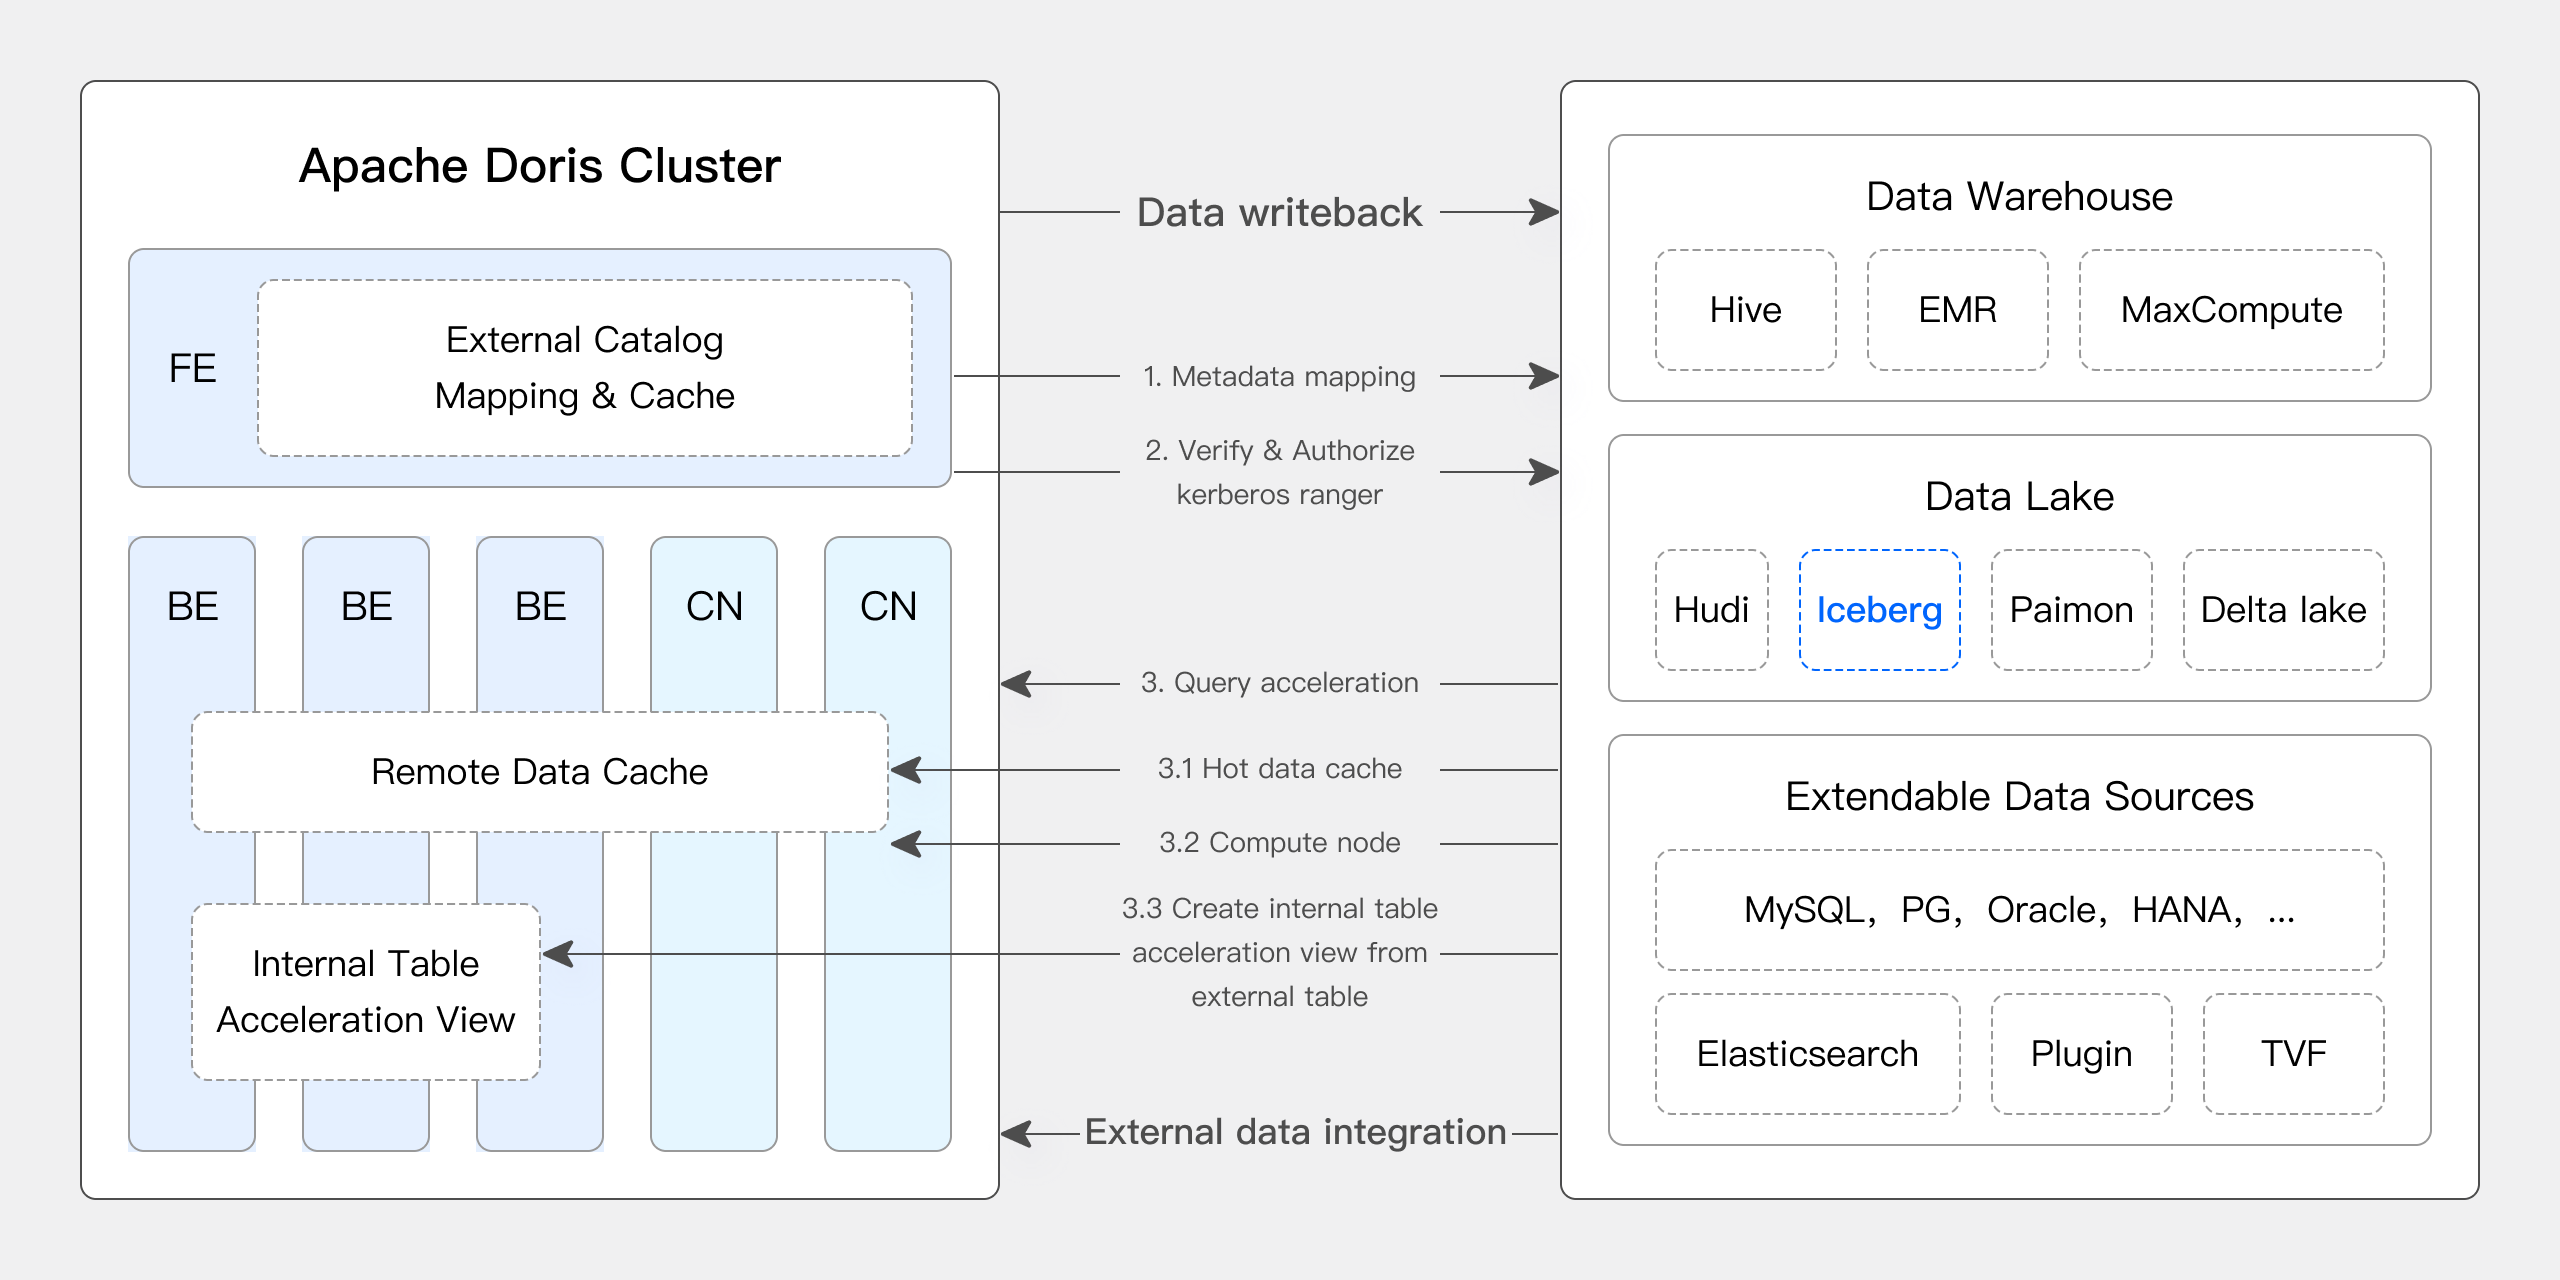
Apache Doris & Iceberg
Apache Iceberg는 대규모 데이터를 분석하고 관리할 수 있는 오픈 소스 고성능·고신뢰성 데이터 레이크 테이블 포맷입니다. Apache Doris를 비롯한 다양한 주요 쿼리 엔진을 지원하고, HDFS 및 다양한 클라우드 객체 스토리지와 호환됩니다. ACID 준수, 스키마 진화, 고급 필터링, 숨겨진 파티셔닝, 파티션 레이아웃 진화를 지원하며, Time Travel과 버전 롤백 등의 기능을 통해 고성능 쿼리와 데이터의 신뢰성, 일관성, 유연성을 보장합니다.
Apache Doris는 Iceberg의 주요 핵심 기능을 기본 지원합니다:
- Hive Metastore, Hadoop, REST, Glue, Google Dataproc Metastore, DLF 등 다양한 Iceberg Catalog 유형을 지원합니다.
- Iceberg V1/V2 테이블 포맷과 Position Delete, Equality Delete 파일 읽기를 기본 지원합니다.
- 테이블 함수를 통해 Iceberg 테이블의 스냅샷 이력을 쿼리할 수 있습니다.
- Time Travel 기능을 지원합니다.
- Iceberg 테이블 엔진을 기본 지원합니다. Apache Doris에서 Iceberg 테이블을 직접 생성하고 관리하며 데이터를 쓸 수 있습니다. 다양한 파티션 Transform 함수를 지원하여 숨겨진 파티셔닝과 파티션 레이아웃 진화 등의 기능을 제공합니다.
- Iceberg V2 테이블에서
UPDATE,DELETE,MERGE INTO를 비롯한 행 수준 DML을 지원합니다.
사용자는 Apache Doris + Apache Iceberg를 기반으로 효율적인 Data Lakehouse 솔루션을 빠르게 구축하여 다양한 실시간 데이터 분석 및 처리 요구 사항에 유연하게 대응할 수 있습니다.
- Doris의 고성능 쿼리 엔진으로 Iceberg 테이블 데이터와 다른 데이터 소스를 연계해 분석하여 통합 페더레이션 데이터 분석 플랫폼을 구축합니다.
- Doris에서 Iceberg 테이블을 직접 관리하고 구축하며, 데이터 정제와 처리, Iceberg 테이블에 데이터 쓰기를 모두 수행하여 데이터 레이크용 통합 데이터 처리 플랫폼을 구축합니다.
- Iceberg 테이블 엔진을 통해 Doris 데이터를 다른 업스트림 및 다운스트림 시스템과 공유하고 추가로 처리할 수 있도록 하여 통합 개방형 데이터 스토리지 플랫폼을 구축합니다.
앞으로 Apache Iceberg는 Apache Doris의 기본 테이블 엔진 중 하나로 활용되어 레이크 포맷 데이터에 대한 더욱 포괄적인 분석 및 관리 기능을 제공할 예정입니다. Apache Doris는 이미 INSERT, UPDATE, DELETE, MERGE INTO를 비롯한 Iceberg의 핵심 행 수준 DML을 지원하며, 쓰기 시 정렬, 증분 데이터 읽기, 메타데이터 관리 등의 기능을 계속 개선하여 통합된 고성능 실시간 데이터 레이크 플랫폼을 함께 구축해 나갈 것입니다.
자세한 내용은 Iceberg Catalog를 참조하세요.
사용자 가이드
이 문서는 Docker 환경에서 Apache Doris + Apache Iceberg 테스트 및 데모 환경을 빠르게 구성하는 방법과 다양한 기능의 사용법을 주로 설명합니다.
이 문서에서 언급하는 모든 스크립트와 코드는 다음 주소에서 확인할 수 있습니다: https://github.com/apache/doris/tree/master/samples/datalake/iceberg_and_paimon
01 환경 준비
이 문서는 Docker Compose를 사용하여 배포하며, 구성 요소와 버전은 다음과 같습니다:
| 구성 요소 | 버전 |
|---|---|
| Apache Doris | 기본값 2.1.5, 변경 가능 |
| Apache Iceberg | 1.4.3 |
| MinIO | RELEASE.2024-04-29T09-56-05Z |
02 환경 배포
-
모든 구성 요소 시작
bash ./start_all.sh -
시작 후 다음 스크립트로 Doris 명령줄에 로그인할 수 있습니다:
-- login doris
bash ./start_doris_client.sh
03 Iceberg 테이블 생성
Doris 명령줄에 로그인하면 Doris 클러스터에 Iceberg라는 이름의 Iceberg Catalog가 이미 생성되어 있습니다(SHOW CATALOGS/SHOW CREATE CATALOG iceberg로 확인할 수 있습니다). 이 Catalog의 생성문은 다음과 같습니다:
-- Already created
CREATE CATALOG `iceberg` PROPERTIES (
    "type" = "iceberg",
    "iceberg.catalog.type" = "rest",
    "warehouse" = "s3://warehouse/",
    "uri" = "http://rest:8181",
    "s3.access_key" = "admin",
    "s3.secret_key" = "password",
    "s3.endpoint" = "http://minio:9000"
);
Iceberg Catalog에 데이터베이스와 Iceberg 테이블을 생성합니다:
mysql> SWITCH iceberg;
Query OK, 0 rows affected (0.00 sec)

mysql> CREATE DATABASE nyc;
Query OK, 0 rows affected (0.12 sec)

mysql> CREATE TABLE iceberg.nyc.taxis
       (
           vendor_id BIGINT,
           trip_id BIGINT,
           trip_distance FLOAT,
           fare_amount DOUBLE,
           store_and_fwd_flag STRING,
           ts DATETIME
       )
       PARTITION BY LIST (vendor_id, DAY(ts)) ()
       PROPERTIES (
           "compression-codec" = "zstd",
           "write-format" = "parquet"
       );
Query OK, 0 rows affected (0.15 sec)
04 데이터 삽입
Iceberg 테이블에 데이터를 삽입합니다:
mysql> INSERT INTO iceberg.nyc.taxis
       VALUES
        (1, 1000371, 1.8, 15.32, 'N', '2024-01-01 9:15:23'),
        (2, 1000372, 2.5, 22.15, 'N', '2024-01-02 12:10:11'),
        (2, 1000373, 0.9, 9.01, 'N', '2024-01-01 3:25:15'),
        (1, 1000374, 8.4, 42.13, 'Y', '2024-01-03 7:12:33');
Query OK, 4 rows affected (1.61 sec)
{'status':'COMMITTED', 'txnId':'10085'}
CREATE TABLE AS SELECT를 사용해 Iceberg 테이블을 생성합니다:
mysql> CREATE TABLE iceberg.nyc.taxis2 AS SELECT * FROM iceberg.nyc.taxis;
Query OK, 4 rows affected (0.25 sec)
{'status':'COMMITTED', 'txnId':'10088'}
05 데이터 쿼리
-
단순 쿼리
mysql> SELECT * FROM iceberg.nyc.taxis;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.37 sec)

mysql> SELECT * FROM iceberg.nyc.taxis2;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.35 sec) -
파티션 프루닝
mysql> SELECT * FROM iceberg.nyc.taxis where vendor_id = 2 and ts >= '2024-01-01' and ts < '2024-01-02';
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
1 row in set (0.06 sec)

mysql> EXPLAIN VERBOSE SELECT * FROM iceberg.nyc.taxis where vendor_id = 2 and ts >= '2024-01-01' and ts < '2024-01-02';

....
|   0:VICEBERG_SCAN_NODE(71)
|      table: taxis
|      predicates: (ts[#5] < '2024-01-02 00:00:00'), (vendor_id[#0] = 2), (ts[#5] >= '2024-01-01 00:00:00')
|      inputSplitNum=1, totalFileSize=3539, scanRanges=1
|      partition=1/0
|      backends:
|        10002
|          s3://warehouse/wh/nyc/taxis/data/vendor_id=2/ts_day=2024-01-01/40e6ca404efa4a44-b888f23546d3a69c_5708e229-2f3d-4b68-a66b-44298a9d9815-0.zstd.parquet start: 0 length: 3539
|      cardinality=6, numNodes=1
|      pushdown agg=NONE
|      icebergPredicatePushdown=
|           ref(name="ts") < 1704153600000000
|           ref(name="vendor_id") == 2
|           ref(name="ts") >= 1704067200000000
....
EXPLAIN VERBOSE문의 결과를 살펴보면 조건식vendor_id = 2 and ts >= '2024-01-01' and ts < '2024-01-02'이 최종적으로 하나의 파티션(partition=1/0)만 선택하는 것을 확인할 수 있습니다.또한 테이블 생성 시 파티션 Transform 함수
DAY(ts)를 지정했으므로, 데이터의 원래 값2024-01-01 03:25:15.000000이 파일 디렉터리의 파티션 정보ts_day=2024-01-01로 변환되는 것을 확인할 수 있습니다.
06 Time Travel
데이터를 몇 행 더 삽입합니다:
INSERT INTO iceberg.nyc.taxis VALUES (1, 1000375, 8.8, 55.55, 'Y', '2024-01-01 8:10:22'), (3, 1000376, 7.4, 32.35, 'N', '2024-01-02  1:14:45');
Query OK, 2 rows affected (0.17 sec)
{'status':'COMMITTED', 'txnId':'10086'}

mysql> SELECT * FROM iceberg.nyc.taxis;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         3 | 1000376 |           7.4 |       32.35 | N                  | 2024-01-02 01:14:45.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         1 | 1000375 |           8.8 |       55.55 | Y                  | 2024-01-01 08:10:22.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
6 rows in set (0.11 sec)
$snapshots 시스템 테이블을 사용해 테이블의 스냅샷 정보를 쿼리합니다(4.1.4 이전 버전에서는 iceberg_meta() 테이블 함수도 사용할 수 있었지만, 4.1.4 버전부터 제거되었습니다):
mysql> select * from iceberg.nyc.taxis$snapshots;
+---------------------+---------------------+---------------------+-----------+-----------------------------------------------------------------------------------------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| committed_at        | snapshot_id         | parent_id           | operation | manifest_list                                                                                             | summary                                                                                                                                                                                                                                                        |
+---------------------+---------------------+---------------------+-----------+-----------------------------------------------------------------------------------------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| 2024-07-29 03:38:22 | 8483933166442433486 |                  -1 | append    | s3://warehouse/wh/nyc/taxis/metadata/snap-8483933166442433486-1-5f7b7736-8022-4ba1-9db2-51ae7553be4d.avro | {"added-data-files":"4","added-records":"4","added-files-size":"14156","changed-partition-count":"4","total-records":"4","total-files-size":"14156","total-data-files":"4","total-delete-files":"0","total-position-deletes":"0","total-equality-deletes":"0"} |
| 2024-07-29 03:40:23 | 4726331391239920914 | 8483933166442433486 | append    | s3://warehouse/wh/nyc/taxis/metadata/snap-4726331391239920914-1-6aa3d142-6c9c-4553-9c04-08ad4d49a4ea.avro | {"added-data-files":"2","added-records":"2","added-files-size":"7078","changed-partition-count":"2","total-records":"6","total-files-size":"21234","total-data-files":"6","total-delete-files":"0","total-position-deletes":"0","total-equality-deletes":"0"}  |
+---------------------+---------------------+---------------------+-----------+-----------------------------------------------------------------------------------------------------------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
2 rows in set (0.07 sec)
FOR VERSION AS OF 문을 사용해 지정한 스냅샷을 쿼리합니다:
mysql> SELECT * FROM iceberg.nyc.taxis FOR VERSION AS OF 8483933166442433486;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.05 sec)

mysql> SELECT * FROM iceberg.nyc.taxis FOR VERSION AS OF 4726331391239920914;
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000375 |           8.8 |       55.55 | Y                  | 2024-01-01 08:10:22.000000 |
|         3 | 1000376 |           7.4 |       32.35 | N                  | 2024-01-02 01:14:45.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
6 rows in set (0.04 sec)
FOR TIME AS OF 문을 사용해 지정한 스냅샷을 쿼리합니다:
mysql> SELECT * FROM iceberg.nyc.taxis FOR TIME AS OF "2024-07-29 03:38:23";
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.04 sec)

mysql> SELECT * FROM iceberg.nyc.taxis FOR TIME AS OF "2024-07-29 03:40:22";
+-----------+---------+---------------+-------------+--------------------+----------------------------+
| vendor_id | trip_id | trip_distance | fare_amount | store_and_fwd_flag | ts                         |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
|         2 | 1000373 |           0.9 |        9.01 | N                  | 2024-01-01 03:25:15.000000 |
|         1 | 1000374 |           8.4 |       42.13 | Y                  | 2024-01-03 07:12:33.000000 |
|         2 | 1000372 |           2.5 |       22.15 | N                  | 2024-01-02 12:10:11.000000 |
|         1 | 1000371 |           1.8 |       15.32 | N                  | 2024-01-01 09:15:23.000000 |
+-----------+---------+---------------+-------------+--------------------+----------------------------+
4 rows in set (0.05 sec)
07 Iceberg 행 수준 DML
행 수준 DML(UPDATE, DELETE, MERGE INTO)을 사용하려면 대상 테이블이 Iceberg V2를 사용해야 합니다. Time Travel 절의 iceberg.nyc.taxis 상태를 유지하기 위해, 다음 예제에서는 iceberg.nyc.taxis2를 사용해 전용 테이블을 초기화합니다.
mysql> CREATE TABLE iceberg.nyc.taxis_dml
       (
           vendor_id BIGINT,
           trip_id BIGINT,
           trip_distance FLOAT,
           fare_amount DOUBLE,
           store_and_fwd_flag STRING,
           ts DATETIME
       )
       PARTITION BY LIST (vendor_id, DAY(ts)) ()
       PROPERTIES (
           "format-version" = "2",
           "compression-codec" = "zstd",
           "write-format" = "parquet"
       );
Query OK, 0 rows affected (0.18 sec)

mysql> INSERT INTO iceberg.nyc.taxis_dml SELECT * FROM iceberg.nyc.taxis2;
Query OK, 4 rows affected (0.32 sec)
{'status':'COMMITTED', 'txnId':'10089'}
Iceberg 테이블의 행을 업데이트합니다:
mysql> UPDATE iceberg.nyc.taxis_dml
       SET fare_amount = fare_amount + 3,
           store_and_fwd_flag = 'Y'
       WHERE trip_id = 1000371;
Query OK, 1 row affected (0.44 sec)
{'status':'COMMITTED', 'txnId':'10090'}

mysql> SELECT trip_id, fare_amount, store_and_fwd_flag
       FROM iceberg.nyc.taxis_dml
       WHERE trip_id = 1000371;
+---------+-------------+--------------------+
| trip_id | fare_amount | store_and_fwd_flag |
+---------+-------------+--------------------+
| 1000371 |       18.32 | Y                  |
+---------+-------------+--------------------+
1 row in set (0.07 sec)
Iceberg 테이블에서 행을 삭제합니다:
mysql> DELETE FROM iceberg.nyc.taxis_dml
       WHERE trip_id = 1000373;
Query OK, 1 row affected (0.31 sec)
{'status':'COMMITTED', 'txnId':'10091'}

mysql> SELECT trip_id
       FROM iceberg.nyc.taxis_dml
       ORDER BY trip_id;
+---------+
| trip_id |
+---------+
| 1000371 |
| 1000372 |
| 1000374 |
+---------+
3 rows in set (0.06 sec)
MERGE INTO를 사용해 하나의 문에서 기존 행을 업데이트하고 새 행을 삽입합니다:
mysql> MERGE INTO iceberg.nyc.taxis_dml t
       USING (
           SELECT 2 AS vendor_id, 1000372 AS trip_id, 2.5 AS trip_distance,
                  30.00 AS fare_amount, 'Y' AS store_and_fwd_flag,
                  CAST('2024-01-02 12:10:11' AS DATETIME) AS ts
           UNION ALL
           SELECT 3, 1000380, 6.7, 28.50, 'N', CAST('2024-01-04 10:20:00' AS DATETIME)
       ) s
       ON t.trip_id = s.trip_id
       WHEN MATCHED THEN UPDATE SET
           fare_amount = s.fare_amount,
           store_and_fwd_flag = s.store_and_fwd_flag
       WHEN NOT MATCHED THEN INSERT
           (vendor_id, trip_id, trip_distance, fare_amount, store_and_fwd_flag, ts)
       VALUES
           (s.vendor_id, s.trip_id, s.trip_distance, s.fare_amount, s.store_and_fwd_flag, s.ts);
Query OK, 2 rows affected (0.53 sec)
{'status':'COMMITTED', 'txnId':'10092'}

mysql> SELECT vendor_id, trip_id, fare_amount, store_and_fwd_flag
       FROM iceberg.nyc.taxis_dml
       ORDER BY trip_id;
+-----------+---------+-------------+--------------------+
| vendor_id | trip_id | fare_amount | store_and_fwd_flag |
+-----------+---------+-------------+--------------------+
|         1 | 1000371 |       18.32 | Y                  |
|         2 | 1000372 |       30.00 | Y                  |
|         1 | 1000374 |       42.13 | Y                  |
|         3 | 1000380 |       28.50 | N                  |
+-----------+---------+-------------+--------------------+
4 rows in set (0.09 sec)
08 PyIceberg와 연동
Doris 2.1.8/3.0.4 이상 버전을 사용하세요.
이전 예제의 상태를 유지하기 위해 아래 예제에서는 nyc.taxis2를 사용합니다.
Iceberg 테이블을 불러옵니다:
from pyiceberg.catalog import load_catalog

catalog = load_catalog(
	"iceberg",
	**{
		"warehouse" = "warehouse",
		"uri" = "http://rest:8181",
		"s3.access-key-id" = "admin",
		"s3.secret-access-key" = "password",
		"s3.endpoint" = "http://minio:9000"
	},
)
table = catalog.load_table("nyc.taxis2")
테이블을 Arrow Table로 읽습니다:
print(table.scan().to_arrow())

pyarrow.Table
vendor_id: int64
trip_id: int64
trip_distance: float
fare_amount: double
store_and_fwd_flag: large_string
ts: timestamp[us]
----
vendor_id: [[1],[1],[2],[2]]
trip_id: [[1000371],[1000374],[1000373],[1000372]]
trip_distance: [[1.8],[8.4],[0.9],[2.5]]
fare_amount: [[15.32],[42.13],[9.01],[22.15]]
store_and_fwd_flag: [["N"],["Y"],["N"],["N"]]
ts: [[2024-01-01 09:15:23.000000],[2024-01-03 07:12:33.000000],[2024-01-01 03:25:15.000000],[2024-01-02 12:10:11.000000]]
테이블을 Pandas DataFrame으로 읽습니다:
print(table.scan().to_pandas())

vendor_id  trip_id  trip_distance  fare_amount store_and_fwd_flag                    ts
0          1  1000371            1.8        15.32                  N   2024-01-01 09:15:23
1          1  1000374            8.4        42.13                  Y   2024-01-03 07:12:33
2          2  1000373            0.9         9.01                  N   2024-01-01 03:25:15
3          2  1000372            2.5        22.15                  N   2024-01-02 12:10:11
테이블을 Polars DataFrame으로 읽습니다:
import polars as pl

print(pl.scan_iceberg(table).collect())

shape: (4, 6)
┌───────────┬─────────┬───────────────┬─────────────┬────────────────────┬─────────────────────┐
│ vendor_id ┆ trip_id ┆ trip_distance ┆ fare_amount ┆ store_and_fwd_flag ┆ ts                  │
│ ---       ┆ ---     ┆ ---           ┆ ---         ┆ ---                ┆ ---                 │
│ i64       ┆ i64     ┆ f32           ┆ f64         ┆ str                ┆ datetime[μs]        │
╞═══════════╪═════════╪═══════════════╪═════════════╪════════════════════╪═════════════════════╡
│ 1         ┆ 1000371 ┆ 1.8           ┆ 15.32       ┆ N                  ┆ 2024-01-01 09:15:23 │
│ 1         ┆ 1000374 ┆ 8.4           ┆ 42.13       ┆ Y                  ┆ 2024-01-03 07:12:33 │
│ 2         ┆ 1000373 ┆ 0.9           ┆ 9.01        ┆ N                  ┆ 2024-01-01 03:25:15 │
│ 2         ┆ 1000372 ┆ 2.5           ┆ 22.15       ┆ N                  ┆ 2024-01-02 12:10:11 │
└───────────┴─────────┴───────────────┴─────────────┴────────────────────┴─────────────────────┘
PyIceberg로 Iceberg 테이블에 데이터를 쓰는 방법은 단계별 안내를 참조하세요.
09 부록
PyIceberg로 Iceberg 테이블에 데이터 쓰기
Iceberg 테이블을 불러옵니다:
from pyiceberg.catalog import load_catalog

catalog = load_catalog(
	"iceberg",
	**{
		"warehouse" = "warehouse",
		"uri" = "http://rest:8181",
		"s3.access-key-id" = "admin",
		"s3.secret-access-key" = "password",
		"s3.endpoint" = "http://minio:9000"
	},
)
table = catalog.load_table("nyc.taxis2")
Arrow Table을 사용해 테이블에 데이터를 씁니다:
import pyarrow as pa

df = pa.Table.from_pydict(
	{
		"vendor_id": pa.array([1, 2, 2, 1], pa.int64()),
		"trip_id": pa.array([1000371, 1000372, 1000373, 1000374], pa.int64()),
		"trip_distance": pa.array([1.8, 2.5, 0.9, 8.4], pa.float32()),
		"fare_amount": pa.array([15.32, 22.15, 9.01, 42.13], pa.float64()),
		"store_and_fwd_flag": pa.array(["N", "N", "N", "Y"], pa.string()),
		"ts": pa.compute.strptime(
			["2024-01-01 9:15:23", "2024-01-02 12:10:11", "2024-01-01 3:25:15", "2024-01-03 7:12:33"],
			"%Y-%m-%d %H:%M:%S",
			"us",
		),
	}
)
table.append(df)
Pandas DataFrame을 사용해 테이블에 데이터를 씁니다:
import pyarrow as pa
import pandas as pd

df = pd.DataFrame(
	{
		"vendor_id": pd.Series([1, 2, 2, 1]).astype("int64[pyarrow]"),
		"trip_id": pd.Series([1000371, 1000372, 1000373, 1000374]).astype("int64[pyarrow]"),
		"trip_distance": pd.Series([1.8, 2.5, 0.9, 8.4]).astype("float32[pyarrow]"),
		"fare_amount": pd.Series([15.32, 22.15, 9.01, 42.13]).astype("float64[pyarrow]"),
		"store_and_fwd_flag": pd.Series(["N", "N", "N", "Y"]).astype("string[pyarrow]"),
		"ts": pd.Series(["2024-01-01 9:15:23", "2024-01-02 12:10:11", "2024-01-01 3:25:15", "2024-01-03 7:12:33"]).astype("timestamp[us][pyarrow]"),
	}
)
table.append(pa.Table.from_pandas(df))
Polars DataFrame을 사용해 테이블에 데이터를 씁니다:
import polars as pl

df = pl.DataFrame(
	{
		"vendor_id": [1, 2, 2, 1],
		"trip_id": [1000371, 1000372, 1000373, 1000374],
		"trip_distance": [1.8, 2.5, 0.9, 8.4],
		"fare_amount": [15.32, 22.15, 9.01, 42.13],
		"store_and_fwd_flag": ["N", "N", "N", "Y"],
		"ts": ["2024-01-01 9:15:23", "2024-01-02 12:10:11", "2024-01-01 3:25:15", "2024-01-03 7:12:33"],
	},
	{
		"vendor_id": pl.Int64,
		"trip_id": pl.Int64,
		"trip_distance": pl.Float32,
		"fare_amount": pl.Float64,
		"store_and_fwd_flag": pl.String,
		"ts": pl.String,
	},
).with_columns(pl.col("ts").str.strptime(pl.Datetime, "%Y-%m-%d %H:%M:%S"))
table.append(df.to_arrow())