로그 저장 및 분석
로그는 시스템 동작을 상세하게 기록한 것으로, 이벤트의 주체, 시간, 위치, 내용 등의 핵심 정보를 담고 있습니다. 운영 관측성, 네트워크 보안 모니터링, 비즈니스 분석 등의 요구에 따라 기업은 일반적으로 흩어진 로그를 중앙에서 수집, 저장, 분석하여 방대한 로그에서 가치를 도출해야 합니다.
이러한 용도를 위해 Apache Doris는 범용 OLAP 기능에 역색인과 고속 전문 검색을 더하고, 쓰기 성능과 저장 공간 효율을 극대화합니다. Apache Doris를 사용하면 개방적이고 성능이 뛰어나며 비용이 낮은 통합 로그 저장 및 분석 플랫폼을 구축할 수 있습니다.
이 문서에서는 이 솔루션과 관련된 다음 주제를 다룹니다.
- 전체 아키텍처: Apache Doris 기반 로그 플랫폼의 핵심 구성 요소와 기반 아키텍처.
- 기능 및 장점: Elasticsearch와 비교했을 때 차별화되는 기능.
- 운영 가이드: 리소스 산정부터 로그 쿼리까지 전체 과정.
1. 전체 아키텍처
Apache Doris 기반 로그 저장 및 분석 플랫폼의 아키텍처는 다음과 같습니다.
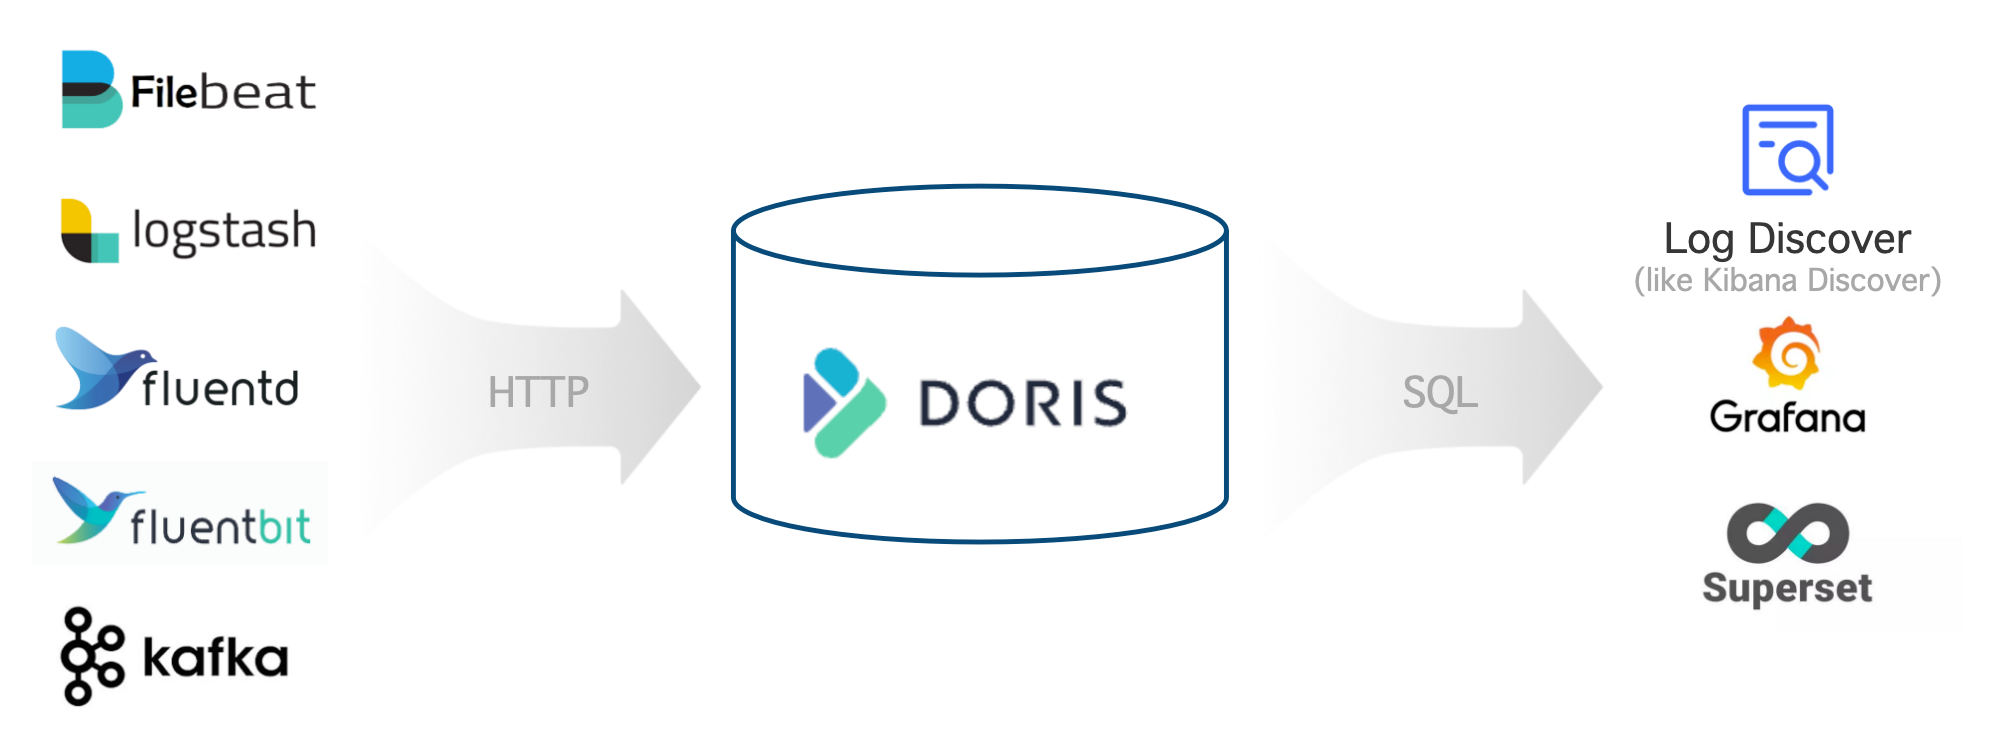
전체 아키텍처는 세 부분으로 구성됩니다.
| 계층 | 구성 요소 | 설명 |
|---|---|---|
| 로그 수집 및 전처리 | Logstash, Filebeat, Fluentbit, Kafka 등 | HTTP API를 통해 Apache Doris에 로그 데이터 쓰기 |
| 로그 저장 및 분석 | Apache Doris | 고성능, 저비용 통합 저장소와 SQL 인터페이스를 통한 다양한 검색 및 분석 기능 제공 |
| 로그 분석 및 알림 | Grafana, Superset, Doris WebUI 등 | 표준 MySQL 프로토콜로 Doris를 쿼리하고 사용하기 쉬운 시각화 인터페이스 제공 |
2. 기능 및 장점
Apache Doris 기반 로그 플랫폼은 다음과 같은 핵심 기능을 제공합니다.
| 기능 | 설명 |
|---|---|
| 높은 처리량과 낮은 지연 시간의 데이터 적재 | 하루 수백 TB의 데이터를 GB/s 속도로 안정적이고 지속적으로 적재하며 지연 시간은 1초 미만 |
| 대용량 데이터의 저비용 저장 | PB 규모의 저장을 지원하며, Elasticsearch 대비 저장 비용을 60%~80% 절감하고 콜드 데이터를 S3/HDFS로 계층화하면 추가로 50% 절감 |
| 고성능 전문 검색 및 분석 | 역색인과 전문 검색을 지원하며, 키워드로 상세 데이터를 조회하거나 추세를 분석하는 쿼리에 수초 내 응답 |
| 개방적이고 사용하기 쉬운 생태계 | 업스트림에서는 Logstash, Filebeat, Fluentbit, Kafka 등과 연결하고, 다운스트림에서는 표준 MySQL 프로토콜을 통해 Grafana, Superset, Doris WebUI와 연결 |
2.1 높은 성능과 낮은 비용
벤치마크와 실제 운영 환경에서의 검증 결과, Apache Doris 기반 로그 플랫폼은 Elasticsearch보다 비용 대비 성능이 5~10배 뛰어납니다. 이러한 장점은 주로 고성능 저장 및 쿼리 엔진과 로그 활용에 특화된 최적화에서 비롯됩니다.
- 더 높은 쓰기 처리량: Elasticsearch의 쓰기 병목은 데이터 파싱과 역색인 구축에 사용되는 CPU에서 발생합니다. Apache Doris는 SIMD 등의 CPU 벡터화 명령어를 사용하여 JSON 파싱과 인덱스 구축 속도를 높이고, 로그 활용에 필요하지 않은 정방향 인덱스 등의 데이터 구조를 제거하여 역색인 구조를 단순화합니다. 동일한 리소스에서 Doris의 쓰기 성능은 Elasticsearch의 3~5배입니다.
- 더 낮은 저장 비용: Elasticsearch는 데이터를 여러 형태로 중복 저장하고(정방향 인덱스, 역색인, doc values 컬럼 저장소), 전반적인 압축률도 비교적 낮습니다. Doris는 정방향 인덱스를 제거하여 인덱스 데이터를 30% 줄입니다. 또한 Zstandard 압축 알고리즘을 적용한 컬럼 기반 저장 방식을 채택하여 압축률 5~10을 달성하며, 이는 Elasticsearch의 1.5보다 훨씬 높습니다. 핫/콜드 계층화 기능은 과거 로그를 오브젝트 스토리지로 자동 이동하여 콜드 데이터 저장 비용을 70% 이상 절감할 수 있습니다. 전체 저장 비용은 Elasticsearch의 약 20%에 불과합니다.
- 더 높은 쿼리 성능: Doris는 전문 검색 파이프라인을 단순화하고, 로그 활용에 필요하지 않은 관련성 점수 계산 등의 알고리즘을 생략합니다. "특정 키워드를 포함하는 최신 로그 100개"와 같은 일반적인 쿼리에는 계획 및 실행 계층에서 TopN 동적 가지치기 등의 전용 최적화를 적용합니다.
2.2 강력한 분석 기능
Apache Doris는 표준 SQL을 지원하고 MySQL 프로토콜 및 구문과 호환되므로, Doris 기반 로그 시스템은 다음과 같은 장점이 있습니다.
- 쉬운 사용: 엔지니어와 데이터 분석가는 SQL에 익숙하므로 새로운 기술 스택을 배우지 않고도 빠르게 시작할 수 있습니다.
- 풍부한 생태계: MySQL 명령줄, 다양한 GUI / BI 도구, 빅데이터 생태계와 원활하게 통합되어 복잡하고 다양한 데이터 처리 및 분석 요구를 충족합니다.
- 강력한 분석 능력: SQL은 데이터 분석의 사실상 표준으로, 검색, 집계, 다중 테이블 JOIN, 서브쿼리, UDF, 논리 뷰, 구체화된 뷰 등을 지원합니다.
2.3 유연한 스키마
다음은 JSON 형식의 일반적인 반정형 로그 예시입니다. 최상위 필드(timestamp, source, node, component, level, clientRequestId, message, properties)는 비교적 고정되어 있지만, 확장 속성 properties 내부의 중첩 필드(예: properties.size, properties.format)는 더 동적이며 로그마다 달라질 수 있습니다.
{
  "timestamp": "2014-03-08T00:50:03.8432810Z",
  "source": "ADOPTIONCUSTOMERS81",
  "node": "Engine000000000405",
  "level": "Information",
  "component": "DOWNLOADER",
  "clientRequestId": "671db15d-abad-94f6-dd93-b3a2e6000672",
  "message": "Downloading file path: benchmark/2014/ADOPTIONCUSTOMERS81_94_0.parquet.gz",
  "properties": {
    "size": 1495636750,
    "format": "parquet",
    "rowCount": 855138,
    "downloadDuration": "00:01:58.3520561"
  }
}
Apache Doris는 다음 두 가지 메커니즘을 통해 유연한 스키마를 지원합니다.
- Light Schema Change: 최상위 필드가 가끔 변경되는 경우,
ADD/DROP COLUMN과ADD/DROP INDEX같은 스키마 변경을 수초 내에 완료할 수 있습니다. 계획 단계에서는 현재 어떤 필드에 인덱스가 필요한지만 고려하면 됩니다. - VARIANT 반정형 타입:
properties같은 확장 필드에는 임의의 JSON 데이터를 쓸 수 있습니다. 필드 이름과 타입을 자동으로 감지하고, 자주 나타나는 필드는 분리하여 컬럼 기반으로 저장합니다. 또한VARIANT에 역색인을 생성하여 내부 필드의 쿼리와 검색 속도를 높일 수 있습니다.
Elasticsearch의 동적 매핑과 비교하면 Apache Doris의 유연한 스키마에는 다음과 같은 장점이 있습니다.
- 동일한 필드에 여러 타입을 허용합니다.
VARIANT는 충돌을 자동으로 처리하고 타입을 승격하므로 로그 데이터의 지속적인 변화에 더 잘 대응합니다. VARIANT는 드물게 나타나는 필드를 하나의 컬럼으로 자동 병합하여 필드, 메타데이터, 컬럼이 너무 많아 발생하는 성능 문제를 방지합니다.- 컬럼과 인덱스의 동적 추가 및 삭제를 지원하므로 모든 필드에 미리 인덱스를 생성할 필요가 없어 불필요한 비용을 줄일 수 있습니다.
3. 운영 가이드
다음 표는 Apache Doris 기반 로그 플랫폼을 구축하는 전체 여섯 단계 과정을 정리한 것입니다.
| 단계 | 목적 |
|---|---|
| 1단계: 리소스 산정 | FE/BE 노드 수, 디스크 용량, 오브젝트 스토리지 크기 산정 |
| 2단계: 클러스터 배포 | 물리 머신 또는 가상 머신에 Apache Doris 배포 |
| 3단계: FE 및 BE 설정 조정 | 로그 활용에 맞게 주요 매개변수 조정 |
| 4단계: 테이블 생성 | 파티셔닝과 버케팅, 압축, 컴팩션, 인덱스, 계층화 정책 설계 |
| 5단계: 로그 수집 | Logstash, Filebeat, Kafka 또는 사용자 정의 프로그램과 통합 |
| 6단계: 로그 쿼리 및 분석 | SQL 및 시각화 도구를 통한 로그 검색과 분석 |
3.1 리소스 산정
클러스터를 배포하기 전에 서버 하드웨어 리소스를 산정해야 합니다. 주요 단계는 다음과 같습니다.
-
다음 공식을 사용하여 쓰기 리소스를 산정합니다.
Average write throughput = Daily incremental data / 86400 sPeak write throughput = Average write throughput * Peak-to-average write ratioCPU cores required for peak writes = Peak write throughput / Per-core write throughput
-
다음 공식을 사용하여 저장 리소스를 산정합니다.
Required storage = Daily incremental data / Compression ratio * Replica count * Data retention period
-
쿼리 리소스 산정: 쿼리 리소스 사용량은 쿼리 수와 복잡도에 따라 달라집니다. 초기 계획에서는 CPU 리소스의 50%를 쿼리용으로 확보한 뒤 실제 테스트 결과에 따라 조정합니다.
-
리소스 합산: 1단계와 3단계에서 필요한 CPU 코어 수를 산정한 다음, 머신당 CPU 코어 수로 나누어 BE 서버 수를 구합니다. 이를 2단계 결과와 결합하여 BE 서버당 필요한 저장 용량을 산정하고, 데이터 디스크 4~12개에 분산하여 디스크당 용량을 계산합니다.
예시: 하루 신규 로그 100 TB에 대한 리소스 산정
다음 조건을 예로 들어 보겠습니다. 일일 신규 데이터 100 TB(압축 전), 압축률 5, 복제본 1개, 핫 데이터 보관 기간 3일, 콜드 데이터 보관 기간 30일, 평균 대비 최대 쓰기 처리량 비율 200%, 코어당 쓰기 처리량 10 MB/s, 쿼리용으로 CPU 50% 확보 조건입니다. 산정 결과는 다음과 같습니다.
- FE: 서버 3대, 각 서버에 CPU 16코어, 메모리 64 GB, 100 GB SSD 한 개
- BE: 서버 15대, 각 서버에 CPU 32코어, 메모리 256 GB, 600 GB SSD 열 개
- S3 오브젝트 스토리지: 콜드 데이터 저장 공간 600 TB
주요 지표의 값과 계산 방식은 다음과 같습니다.
| 주요 지표(단위) | 값 | 설명 |
|---|---|---|
| 일일 증가 데이터(TB) | 100 | 실제 요구에 따라 입력 |
| 압축률 | 5 | 일반적으로 3~10(인덱스 포함), 실제 요구에 따라 입력 |
| 복제본 수 | 1 | 실제 요구에 따라 입력, 기본값 1, 가능한 값: 1, 2, 3 |
| 핫 데이터 보관 기간(일) | 3 | 실제 요구에 따라 입력 |
| 콜드 데이터 보관 기간(일) | 30 | 실제 요구에 따라 입력 |
| 전체 보관 기간(일) | 33 | 공식: Hot data retention + Cold data retention |
| 예상 핫 데이터 저장 용량(TB) | 60 | 공식: Daily incremental data / Compression ratio * Replica count * Hot data retention |
| 예상 콜드 데이터 저장 용량(TB) | 600 | 공식: Daily incremental data / Compression ratio * Replica count * Cold data retention |
| 평균 대비 최대 쓰기 처리량 비율 | 200% | 실제 요구에 따라 입력, 기본값 200% |
| 머신당 CPU 코어 수 | 32 | 실제 요구에 따라 입력, 기본값 32코어 |
| 평균 쓰기 처리량(MB/s) | 1214 | 공식: Daily incremental data / 86400 s |
| 최대 쓰기 처리량(MB/s) | 2427 | 공식: Average write throughput * Peak-to-average write ratio |
| 최대 쓰기에 필요한 CPU 코어 수 | 242.7 | 공식: Peak write throughput / Per-core write throughput |
| 쿼리용으로 확보한 CPU 비율 | 50% | 실제 요구에 따라 입력, 기본값 50% |
| 예상 BE 서버 수 | 15.2 | 공식: CPU cores required for peak writes / CPU cores per machine / (1 - CPU reserved for queries) |
| 예상 BE 서버 수(반올림) | 15 | 공식: MAX(Replica count, rounded estimated number of BE servers) |
| BE 서버당 예상 저장 용량(TB) | 5.7 | 공식: Estimated hot-data storage / Estimated number of BE servers / (1 - 30%). 여기서 30%는 저장 공간 예비분입니다. I/O 성능을 높이려면 BE당 데이터 디스크 4~12개를 마운트하는 것이 좋습니다 |
3.2 클러스터 배포
리소스 산정이 끝나면 Apache Doris 클러스터를 배포할 수 있습니다. 물리 머신 또는 가상 머신에 배포하는 것이 좋습니다. 수동 배포 절차는 수동 배포를 참조하세요.
3.3 FE 및 BE 설정 조정
클러스터를 배포한 후에는 로그 저장 및 분석에 더 적합하도록 FE와 BE 매개변수를 각각 조정합니다.
3.3.1 FE 설정 조정
fe/conf/fe.conf에서 다음 표에 따라 FE 설정을 조정합니다.
| 조정할 매개변수 | 설명 |
|---|---|
max_running_txn_num_per_db = 10000 | 동시성이 높은 데이터 적재에서는 실행 중인 트랜잭션이 많으므로 이 매개변수 값을 높입니다 |
streaming_label_keep_max_second = 3600label_keep_max_second = 7200 | 잦은 데이터 적재로 생성되는 트랜잭션 레이블이 메모리를 많이 사용하므로 보관 시간을 줄입니다 |
enable_round_robin_create_tablet = true | 태블릿 생성 시 라운드 로빈을 사용하여 최대한 균등하게 분산합니다 |
tablet_rebalancer_type = partition | 밸런싱 시 각 파티션 내에서 태블릿을 최대한 균등하게 유지하는 전략을 사용합니다 |
autobucket_min_buckets = 10 | 로그량 증가 시 버킷이 부족해지지 않도록 자동 버케팅의 최소 버킷 수를 1에서 10으로 높입니다 |
max_backend_heartbeat_failure_tolerance_count = 10 | 로그를 처리하는 BE 서버는 부하가 높아 잠시 하트비트를 보내지 못할 수 있으므로 허용 횟수를 1에서 10으로 높입니다 |
매개변수에 관한 자세한 내용은 FE 설정을 참조하세요.
3.3.2 BE 설정 조정
be/conf/be.conf에서 다음 표에 따라 BE 설정을 조정합니다.
| 모듈 | 조정할 매개변수 | 설명 |
|---|---|---|
| 저장소 | storage_root_path = /path/to/dir1;/path/to/dir2;...;/path/to/dir12 | 디스크 디렉터리에 핫 데이터 저장 경로를 설정합니다 |
| 저장소 | enable_file_cache = true | 파일 캐시를 활성화합니다 |
| 저장소 | file_cache_path = [{"path": "/mnt/datadisk0/file_cache", "total_size":53687091200, "query_limit": "10737418240"},{"path": "/mnt/datadisk1/file_cache", "total_size":53687091200,"query_limit": "10737418240"}] | 콜드 데이터의 캐시 경로와 관련 설정을 지정합니다.path: 캐시 경로total_size: 캐시 경로의 전체 크기(바이트 단위), 53687091200바이트 = 50 GBquery_limit: 단일 쿼리가 캐시 경로에서 읽을 수 있는 최대 데이터 크기(바이트 단위), 10737418240바이트 = 10 GB |
| 쓰기 | write_buffer_size = 1073741824 | 쓰기 버퍼 파일 크기를 늘려 작은 파일과 랜덤 I/O를 줄이고 성능을 높입니다 |
| 컴팩션 | max_cumu_compaction_threads = 8 | CPU 코어 수 / 4로 설정합니다. 이는 CPU의 1/4을 쓰기에, 1/4을 백그라운드 컴팩션에 사용하고 1/2을 쿼리 및 기타 작업용으로 확보한다는 의미입니다 |
| 컴팩션 | inverted_index_compaction_enable = true | 인덱스 컴팩션을 활성화하여 컴팩션 중 CPU 사용량을 줄입니다 |
| 컴팩션 | enable_segcompaction = falseenable_ordered_data_compaction = false | 로그 활용에 필요하지 않은 두 가지 컴팩션 기능을 비활성화합니다 |
| 컴팩션 | enable_compaction_priority_scheduling = false | 우선순위가 낮은 컴팩션은 디스크당 작업 2개로 제한되어 컴팩션 속도가 느려집니다 |
| 컴팩션 | total_permits_for_compaction_score = 200000 | 메모리 사용량을 제어하는 데 사용됩니다. 시계열 정책 자체로도 메모리 사용량을 제어할 수 있습니다 |
| 캐시 | disable_storage_page_cache = trueinverted_index_searcher_cache_limit = 30% | 로그 데이터는 양이 많아 데이터 캐시의 효과가 제한적이므로 데이터 캐시를 비활성화하고 대신 인덱스 캐시를 사용합니다 |
| 캐시 | inverted_index_cache_stale_sweep_time_sec = 3600index_cache_entry_stay_time_after_lookup_s = 3600 | 인덱스 캐시를 최대 한 시간 동안 메모리에 유지합니다 |
| 캐시 | enable_inverted_index_cache_on_cooldown = trueenable_write_index_searcher_cache = false | 인덱스를 콜드 스토리지에 업로드할 때 자동으로 캐싱하도록 설정합니다 |
| 캐시 | tablet_schema_cache_recycle_interval = 3600segment_cache_capacity = 20000 | 다른 캐시의 메모리 사용량을 줄입니다 |
| 캐시 | inverted_index_ram_dir_enable = true | 쓰기 중 인덱스 임시 파일로 인해 발생하는 I/O 오버헤드를 줄입니다 |
| 스레드 | pipeline_executor_size = 24doris_scanner_thread_pool_thread_num = 48 | 32코어 CPU 기준 연산 및 I/O 스레드 설정입니다. 코어 수에 비례하여 늘리거나 줄입니다 |
| 스레드 | scan_thread_nice_value = 5 | 쿼리 I/O 스레드의 우선순위를 낮춰 쓰기 성능과 적시성을 보장합니다 |
| 기타 | string_type_length_soft_limit_bytes = 10485760 | String 데이터의 길이 제한을 10 MB로 높입니다 |
| 기타 | trash_file_expire_time_sec = 300path_gc_check_interval_second = 900path_scan_interval_second = 900 | 휴지통 파일의 회수 속도를 높입니다 |
매개변수에 관한 자세한 내용은 BE 설정을 참조하세요.
3.4 테이블 생성
로그 데이터의 쓰기와 쿼리에는 각각 고유한 특성이 있으므로, 테이블 생성 시 다음 절의 특화된 설정을 적용하여 성능을 높이세요.
3.4.1 파티셔닝 및 버케팅 매개변수 설정
파티셔닝:
- 시간 필드에 범위 파티셔닝(
PARTITION BY RANGE(ts))을 사용하고 동적 파티셔닝("dynamic_partition.enable" = "true")을 활성화하여 일별 파티션을 자동으로 관리합니다. Datetime시간 필드를 키로 사용합니다(DUPLICATE KEY(ts)). 이렇게 하면 최신 로그 N개를 쿼리할 때 속도가 몇 배 빨라집니다.
버케팅:
- 버킷 수를 클러스터 전체 디스크 수의 약 3배로 설정하고, 버킷당 압축된 데이터가 약 5 GB가 되도록 합니다.
- 랜덤 전략(
DISTRIBUTED BY RANDOM BUCKETS 60)과 쓰기 시 단일 태블릿 데이터 적재를 함께 사용하여 배치 쓰기 효율을 높입니다.
파티셔닝 및 버케팅에 관한 자세한 내용은 데이터 파티셔닝을 참조하세요.
3.4.2 압축 매개변수 설정
- Zstd 압축 알고리즘(
"compression" = "zstd")을 사용하여 데이터 압축률을 높입니다.
3.4.3 컴팩션 매개변수 설정
- 시계열 정책(
"compaction_policy" = "time_series")을 사용하여 쓰기 증폭을 줄입니다. 이는 처리량이 높은 로그 쓰기의 리소스 사용량을 줄이는 데 매우 중요합니다.
3.4.4 인덱스 구축 및 설정
- 자주 쿼리하는 필드에 인덱스를 구축합니다(
USING INVERTED). - 전문 검색이 필요한 필드는 토크나이저(
parser) 매개변수를 대부분의 요구에 적합한unicode로 설정합니다. 구문 검색을 지원하려면support_phrase를true로 설정하고, 필요하지 않다면false로 설정하여 저장 공간을 줄입니다.
3.4.5 저장 정책 설정
- 핫 데이터 저장: 클라우드 디스크를 사용한다면 복제본을 1개로 설정할 수 있습니다. 물리 디스크를 사용한다면 복제본을 최소 2개로 설정합니다(
"replication_num" = "2"). - 핫/콜드 계층화:
log_s3저장 위치(CREATE RESOURCE "log_s3")를 설정하고log_policy_3day계층화 정책(CREATE STORAGE POLICY log_policy_3day)을 지정하면, 3일이 지난 데이터가log_s3에 지정된 저장 위치로 자동 이동하여 콜드 데이터로 전환됩니다.
3.4.6 전체 테이블 생성 예시
CREATE DATABASE log_db;
USE log_db;

CREATE RESOURCE "log_s3"
PROPERTIES
(
    "type" = "s3",
    "s3.endpoint" = "your_endpoint_url",
    "s3.region" = "your_region",
    "s3.bucket" = "your_bucket",
    "s3.root.path" = "your_path",
    "s3.access_key" = "your_ak",
    "s3.secret_key" = "your_sk"
);

CREATE STORAGE POLICY log_policy_3day
PROPERTIES(
    "storage_resource" = "log_s3",
    "cooldown_ttl" = "259200"
);

CREATE TABLE log_table
(
  `ts` DATETIME,
  `host` TEXT,
  `path` TEXT,
  `message` TEXT,
  INDEX idx_host (`host`) USING INVERTED,
  INDEX idx_path (`path`) USING INVERTED,
  INDEX idx_message (`message`) USING INVERTED PROPERTIES("parser" = "unicode", "support_phrase" = "true")
)
ENGINE = OLAP
DUPLICATE KEY(`ts`)
PARTITION BY RANGE(`ts`) ()
DISTRIBUTED BY RANDOM BUCKETS 60
PROPERTIES (
  "compression" = "zstd",
  "compaction_policy" = "time_series",
  "dynamic_partition.enable" = "true",
  "dynamic_partition.create_history_partition" = "true",
  "dynamic_partition.time_unit" = "DAY",
  "dynamic_partition.start" = "-30",
  "dynamic_partition.end" = "1",
  "dynamic_partition.prefix" = "p",
  "dynamic_partition.buckets" = "60",
  "dynamic_partition.replication_num" = "2", -- Not needed in compute-storage separation
  "replication_num" = "2",                    -- Not needed in compute-storage separation
  "storage_policy" = "log_policy_3day"        -- Not needed in compute-storage separation
);
3.5 로그 수집
테이블을 생성한 후 로그 수집을 시작할 수 있습니다. Apache Doris는 일반적인 로그 수집기(Logstash, Filebeat, Kafka 등)와 통합할 수 있는 개방형 범용 Stream HTTP API를 제공합니다. 다음 표는 각 수집 방식이 적합한 상황을 정리한 것입니다.
| 수집 방식 | 적합한 상황 |
|---|---|
| Logstash | 풍부한 필터와 플러그인 생태계가 필요한 기존 Logstash 파이프라인 |
| Filebeat | 리소스 사용량에 민감한 환경에서의 경량 파일 수집 |
| Kafka Routine Load | 로그가 이미 Kafka에 저장되어 있고 Doris가 능동적으로 가져오는 경우 |
| 사용자 정의 프로그램(Stream Load) | 자체 개발 수집 프로그램 및 특수 데이터 소스와의 통합 |
3.5.1 Logstash와 통합
다음 단계를 따르세요.
-
Logstash Doris Output 플러그인을 다운로드하고 설치합니다. 다음 방법 중 하나를 선택하세요.
-
직접 다운로드: 여기를 클릭하여 다운로드합니다.
-
소스에서 빌드한 다음 아래 명령으로 설치합니다.
./bin/logstash-plugin install logstash-output-doris-1.2.0.gem
-
-
Logstash를 설정합니다. 다음 두 파일이 필요합니다.
-
logstash.yml: 쓰기 성능을 높이기 위해 Logstash가 로그를 배치로 묶을 때 사용하는 배치 크기와 지연 시간을 설정합니다.pipeline.batch.size: 1000000
pipeline.batch.delay: 10000 -
logstash_demo.conf: 수집할 로그의 입력 경로와 Apache Doris로 출력하기 위한 설정을 지정합니다.input {
file {
path => "/path/to/your/log"
}
}
output {
doris {
http_hosts => [ "<http://fehost1:http_port>", "<http://fehost2:http_port>", "<http://fehost3:http_port>" ]
user => "your_username"
password => "your_password"
db => "your_db"
table => "your_table"
# doris stream load http headers
headers => {
"format" => "json"
"read_json_by_line" => "true"
"load_to_single_tablet" => "true"
}
# field mapping: doris field name => logstash field name
# %{} to get a logstash field, [] for nested field such as [host][name] for host.name
mapping => {
"ts" => "%{@timestamp}"
"host" => "%{[host][name]}"
"path" => "%{[log][file][path]}"
"message" => "%{message}"
}
log_request => true
log_speed_interval => 10
}
}
-
-
Logstash를 실행하여 로그를 수집하고 Apache Doris로 출력합니다.
./bin/logstash -f logstash_demo.conf
설정에 관한 자세한 내용은 Logstash Doris Output 플러그인을 참조하세요.
3.5.2 Filebeat와 통합
다음 단계를 따르세요.
-
Apache Doris로 출력을 지원하는 Filebeat 바이너리를 준비합니다. 여기를 클릭하여 다운로드하거나 Apache Doris 소스에서 빌드할 수 있습니다.
-
Filebeat를 설정합니다. 주요 파일인
filebeat_demo.yml에서 수집할 로그의 입력 경로와 Apache Doris로 출력하기 위한 설정을 지정합니다.# input
filebeat.inputs:
- type: log
enabled: true
paths:
- /path/to/your/log
# multiline can join lines that span multiple lines (such as Java stack traces) into a single log
multiline:
type: pattern
# Behavior: lines starting with yyyy-mm-dd HH:MM:SS are treated as a new log; others are appended to the previous log
pattern: '^[0-9]{4}-[0-9]{2}-[0-9]{2} [0-9]{2}:[0-9]{2}:[0-9]{2}'
negate: true
match: after
skip_newline: true
processors:
# Use the js script plugin to replace \t in the log with spaces, to avoid JSON parsing errors
- script:
lang: javascript
source: >
function process(event) {
var msg = event.Get("message");
msg = msg.replace(/\t/g, " ");
event.Put("message", msg);
}
# Use the dissect plugin for simple log parsing
- dissect:
# 2024-06-08 18:26:25,481 INFO (report-thread|199) [ReportHandler.cpuReport():617] begin to handle
tokenizer: "%{day} %{time} %{log_level} (%{thread}) [%{position}] %{content}"
target_prefix: ""
ignore_failure: true
overwrite_keys: true
# queue and batch
queue.mem:
events: 1000000
flush.min_events: 100000
flush.timeout: 10s
# output
output.doris:
fenodes: [ "http://fehost1:http_port", "http://fehost2:http_port", "http://fehost3:http_port" ]
user: "your_username"
password: "your_password"
database: "your_db"
table: "your_table"
# output string format
## %{[agent][hostname]} %{[log][file][path]} are metadata that come with filebeat
## Another commonly used filebeat metadata is the collection timestamp %{[@timestamp]}
## %{[day]} %{[time]} are the fields parsed by the dissect step above
codec_format_string: '{"ts": "%{[day]} %{[time]}", "host": "%{[agent][hostname]}", "path": "%{[log][file][path]}", "message": "%{[message]}"}'
headers:
format: "json"
read_json_by_line: "true"
load_to_single_tablet: "true" -
Filebeat를 실행하여 로그를 수집하고 Apache Doris로 출력합니다.
chmod +x filebeat-doris-2.1.1
./filebeat-doris-2.1.1 -c filebeat_demo.yml
설정에 관한 자세한 내용은 Beats Doris Output 플러그인을 참조하세요.
3.5.3 Kafka와 통합
JSON 형식의 로그를 Kafka 메시지 큐에 쓴 다음, Kafka Routine Load를 생성하여 Apache Doris가 Kafka에서 데이터를 능동적으로 가져오도록 합니다.
아래 예시에서 property.*는 Librdkafka 클라이언트 설정입니다. 실제 Kafka 클러스터에 맞게 조정하세요.
-- Prepare the kafka cluster and topic log__topic_
-- Create a routine load that imports data from kafka log__topic_ into the log_table table
CREATE ROUTINE LOAD load_log_kafka ON log_db.log_table
COLUMNS(ts, host, path, message)
PROPERTIES (
"max_batch_interval" = "60",
"max_batch_rows" = "20000000",
"max_batch_size" = "1073741824",
"load_to_single_tablet" = "true",
"format" = "json"
)
FROM KAFKA (
"kafka_broker_list" = "host:port",
"kafka_topic" = "log__topic_",
"property.group.id" = "your_group_id",
"property.security.protocol"="SASL_PLAINTEXT",
"property.sasl.mechanism"="GSSAPI",
"property.sasl.kerberos.service.name"="kafka",
"property.sasl.kerberos.keytab"="/path/to/xxx.keytab",
"property.sasl.kerberos.principal"="<xxx@yyy.com>"
);
-- Check the status of the routine load
SHOW ROUTINE LOAD;
Kafka 설정에 관한 자세한 내용은 Routine Load를 참조하세요.
3.5.4 사용자 정의 프로그램으로 로그 수집
일반적인 로그 수집기와 통합하는 것 외에도, 사용자 정의 프로그램에서 HTTP API인 Stream Load를 사용하여 로그를 적재할 수 있습니다.
curl
--location-trusted
-u username:password
-H "format:json"
-H "read_json_by_line:true"
-H "load_to_single_tablet:true"
-H "timeout:600"
-T logfile.json
http://fe_host:fe_http_port/api/log_db/log_table/_stream_load
사용자 정의 프로그램을 사용할 때는 다음 주요 사항에 유의하세요.
- HTTP 인증에는 Basic Auth를 사용합니다.
echo -n 'username:password' | base64명령으로 값을 계산할 수 있습니다. - HTTP 헤더
format:json을 설정하여 데이터 형식을 JSON으로 지정합니다. - HTTP 헤더
read_json_by_line:true를 설정하여 각 줄에 JSON 하나가 있음을 지정합니다. - HTTP 헤더
load_to_single_tablet:true를 설정하여 각 데이터 적재를 단일 버킷에 쓰면 작은 파일을 줄일 수 있습니다. - 클라이언트는 100 MB~1 GB 크기의 배치를 전송하는 것이 좋습니다. Apache Doris 2.1 이상에서는 서버 측 Group Commit 기능을 통해 클라이언트 측 배치 크기를 줄일 수 있습니다.
3.6 로그 쿼리 및 분석
3.6.1 로그 쿼리
Apache Doris는 표준 SQL을 지원합니다. MySQL 클라이언트, JDBC 또는 기타 도구로 클러스터에 연결하여 SQL 쿼리를 실행할 수 있습니다.
mysql -h fe_host -P fe_mysql_port -u your_username -Dyour_db_name
참고할 수 있는 일반적인 SQL 쿼리 명령 5개는 다음과 같습니다.
-
최신 레코드 10개 조회:
SELECT * FROM your_table_name ORDER BY ts DESC LIMIT 10; -
최신 레코드 10개 중
host가8.8.8.8인 레코드 쿼리:SELECT * FROM your_table_name WHERE host = '8.8.8.8' ORDER BY ts DESC LIMIT 10; -
최신 레코드 10개를 검색하되,
message필드에error또는404가 포함된 레코드를 대상으로 합니다.MATCH_ANY는 Apache Doris의 전문 검색 SQL 구문으로, 인수에 있는 키워드 중 하나라도 일치하면 검색합니다.SELECT * FROM your_table_name WHERE message MATCH_ANY 'error 404'
ORDER BY ts DESC LIMIT 10; -
최신 레코드 10개를 검색하되,
message필드에image와faq가 모두 포함된 레코드를 대상으로 합니다.MATCH_ALL은 Apache Doris의 전문 검색 SQL 구문으로, 인수에 있는 모든 키워드가 일치하면 검색합니다.SELECT * FROM your_table_name WHERE message MATCH_ALL 'image faq'
ORDER BY ts DESC LIMIT 10; -
최신 레코드 10개를 검색하되,
message필드에image와faq가 모두 포함된 레코드를 대상으로 합니다.MATCH_PHRASE는 Apache Doris의 전문 검색 SQL 구문으로, 인수에 있는 모든 키워드가 동일한 순서로 일치하면 검색합니다. 예를 들어a image faq b는 일치하지만a faq image b는 일치하지 않습니다.SELECT * FROM your_table_name WHERE message MATCH_PHRASE 'image faq'
ORDER BY ts DESC LIMIT 10;
3.6.2 시각적 로그 분석
일부 외부 공급업체는 Apache Doris 기반의 시각적 로그 분석 플랫폼을 제공합니다. 여기에는 Kibana Discover와 유사한 로그 검색 및 분석 인터페이스가 포함되어 있어, 직관적이고 사용하기 쉬운 탐색형 로그 분석 경험을 제공합니다.
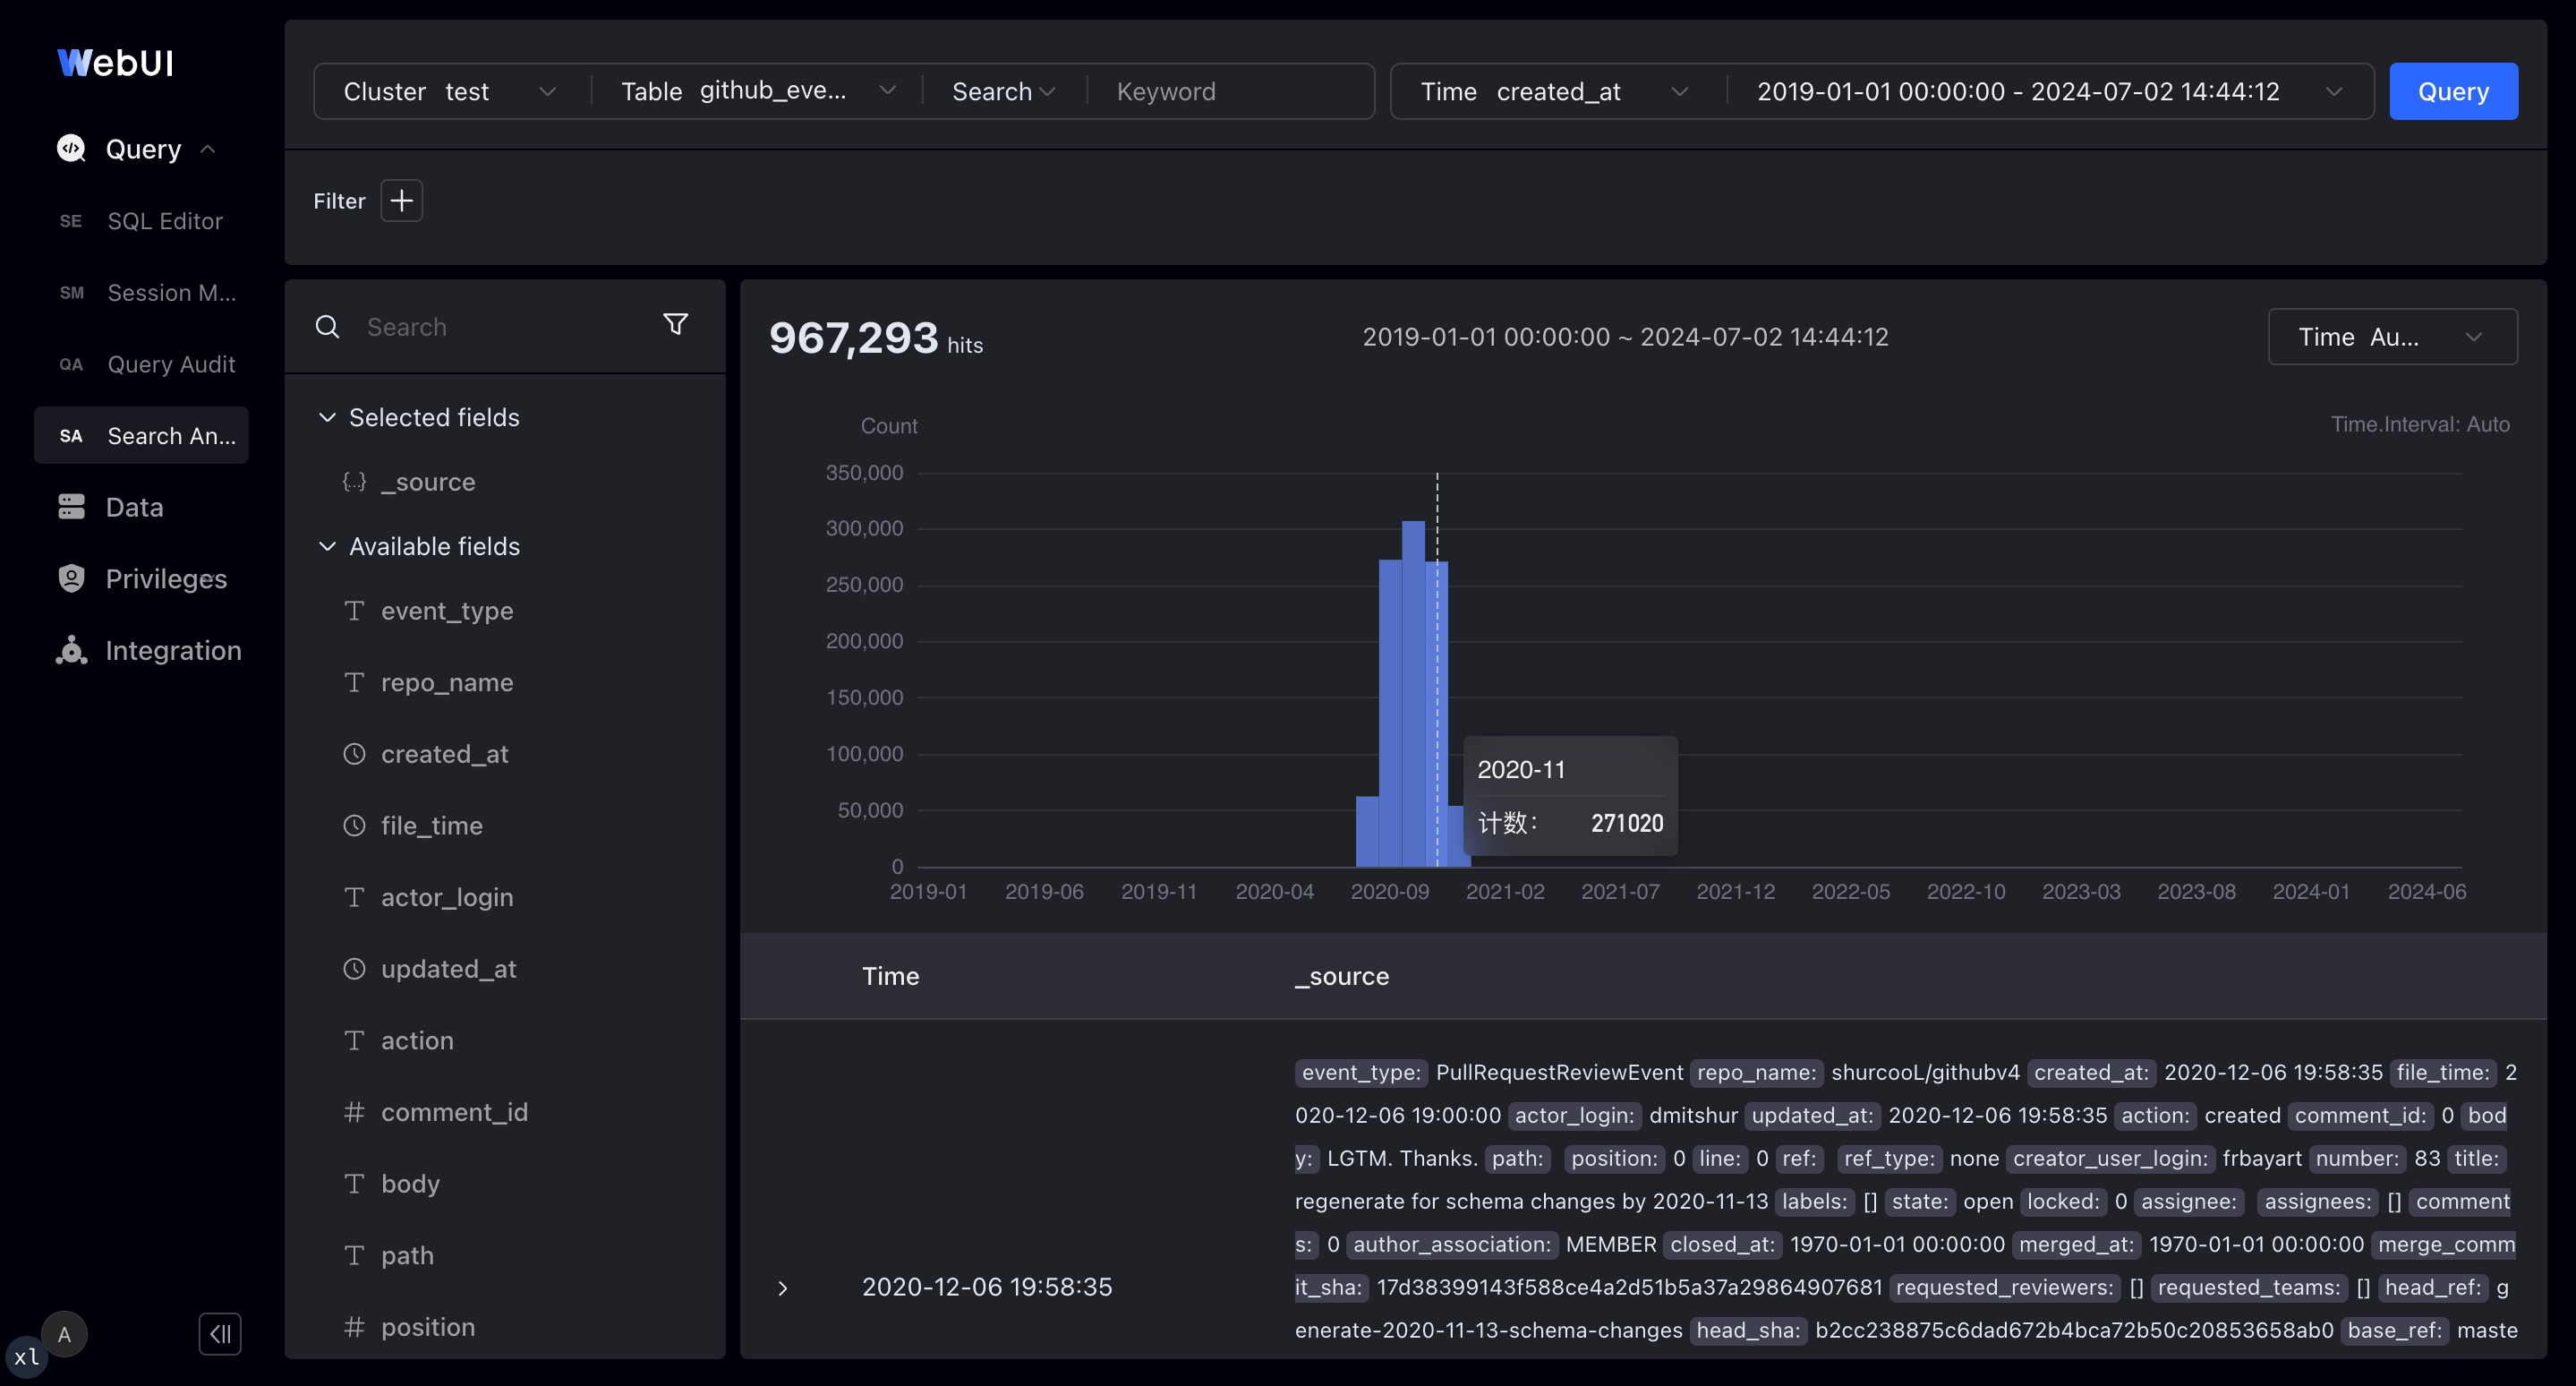
- 전문 검색 모드와 SQL 모드 모두 지원
- 시간 선택기와 히스토그램에서 로그 쿼리 시간 범위 선택 지원
- JSON 또는 테이블로 펼쳐 볼 수 있는 다양한 로그 상세 보기 지원
- 로그 데이터의 맥락에서 클릭으로 필터를 추가하거나 제거하는 대화형 기능 제공
- 검색 결과에서 필드의 상위 값을 표시하여 이상 징후를 발견하고 더 상세히 분석할 수 있도록 지원
추가 도움이 필요하면 dev@doris.apache.org로 문의하세요.
4. 자주 묻는 질문
질문1: 로그 활용 시 Apache Doris와 Elasticsearch의 핵심 차이점은 무엇인가요?
답변: Doris의 쓰기 처리량은 Elasticsearch의 3~5배이며, 저장 비용은 Elasticsearch의 약 20%에 불과합니다. 또한 Doris는 표준 SQL과 MySQL 프로토콜을 지원하여 더 강력한 분석 기능을 제공합니다. 핫/콜드 계층화를 통해 콜드 데이터를 S3/HDFS로 이동하면 저장 비용을 더 줄일 수 있습니다.
질문2: 로그 필드가 자주 변경됩니다. 어떻게 처리해야 하나요?
답변: Light Schema Change를 사용하면 최상위 필드에 대한 ADD/DROP COLUMN과 ADD/DROP INDEX 작업을 수초 내에 수행할 수 있습니다. 동적인 중첩 필드에는 VARIANT 타입을 사용하세요. 이 타입은 필드 이름과 타입을 자동으로 감지하고 VARIANT에 대한 역색인을 지원합니다.
질문3: 버킷 수는 어떻게 정해야 하나요?
답변: 버킷 수를 클러스터 전체 디스크 수의 약 3배로 설정하고, 버킷당 압축된 데이터가 약 5 GB가 되도록 합니다. 이를 DISTRIBUTED BY RANDOM 및 단일 태블릿 쓰기와 함께 사용하여 배치 쓰기 효율을 높입니다.
질문4: 핫/콜드 계층화 정책에서 cooldown_ttl의 단위는 무엇인가요?
답변: 단위는 초입니다. 예를 들어 259200은 3일을 의미하며, 이 기간이 지나면 데이터가 저장 정책에 지정된 오브젝트 스토리지 위치로 자동 이동하여 콜드 데이터로 전환됩니다.
질문5: 쓰기 측 배치 크기는 어떻게 정해야 하나요?
답변: 요청당 배치 크기는 100 MB~1 GB를 권장합니다. Apache Doris 2.1 이상에서는 서버 측 Group Commit 기능을 활성화하여 클라이언트에서 더 작은 배치 크기를 사용할 수 있습니다.
5. 문제 해결
| 증상 | 가능한 원인 | 권장 조치 |
|---|---|---|
| 동시성이 높은 데이터 적재가 트랜잭션 한도를 초과함 | max_running_txn_num_per_db의 기본값이 너무 작음 | max_running_txn_num_per_db = 10000으로 높입니다 |
| BE 하트비트 시간 초과가 자주 발생함 | 높은 로그 쓰기 부하로 인해 BE가 잠시 응답하지 않음 | max_backend_heartbeat_failure_tolerance_count = 10으로 높입니다 |
| 쓰기 시 작은 파일이나 랜덤 I/O가 많이 발생함 | 쓰기 버퍼가 너무 작거나 단일 태블릿 데이터 적재를 사용하지 않음 | write_buffer_size = 1073741824로 높이고 load_to_single_tablet:true로 설정합니다 |
| 컴팩션이 느려 쓰기에 영향을 줌 | 컴팩션 스레드가 부족하거나 낮은 우선순위 스케줄링 제한이 적용됨 | max_cumu_compaction_threads를 CPU 코어 수 / 4로 설정하고 enable_compaction_priority_scheduling을 비활성화합니다 |
| 인덱스 메모리 사용량이 너무 높음 | 데이터 캐시와 인덱스 캐시가 메모리를 두고 경합함 | disable_storage_page_cache를 비활성화하고 inverted_index_searcher_cache_limit = 30%로 제한합니다 |
| 전문 검색에서 구문 검색이 작동하지 않음 | 인덱스에 support_phrase가 활성화되어 있지 않음 | 인덱스 생성 시 "support_phrase" = "true"로 설정합니다 |
| 자동 버케팅으로 생성되는 버킷이 너무 적어 핫스폿이 발생함 | autobucket_min_buckets가 너무 작음 | autobucket_min_buckets = 10으로 높입니다 |