Query Cache
Query Cache는 Apache Doris 파이프라인 실행 엔진에서 중간 집계 결과를 태블릿 단위로 캐싱하여 반복되는 집계 쿼리의 속도를 높이는 메커니즘입니다.
사전 확인 사항
Query Cache를 사용하기 전에 다음 사항을 확인하세요.
- 쿼리 대상이 내부 OLAP 테이블입니다(Hive/JDBC/Iceberg/Hudi/Paimon 등의 외부 테이블은 해당하지 않음).
- 쿼리가 집계 쿼리입니다(
GROUP BY또는 집계 함수 포함). - 쿼리 계획이
AggregationNode → OlapScanNode패턴과 일치합니다. - 쿼리에
JOIN,SORT,UNION,WINDOW노드가 없습니다. - 쿼리가
now(),rand(),uuid()등의 비결정적 함수에 의존하지 않습니다. -
enable_query_cache = true가 설정되어 있습니다.
한 문장으로 보는 정의
Query Cache는 파이프라인 실행 엔진에서 집계 결과를 태블릿 단위로 캐싱합니다. 이후 쿼리의 실행 컨텍스트가 같으면 캐싱된 데이터를 바로 반환하여 반복적인 스캔과 계산을 피합니다.
Query Cache가 필요한 이유
분석 환경에서는 기반 데이터가 바뀌지 않아도 같은 집계 쿼리를 반복해서 실행하는 경우가 많습니다. 예를 들면 다음과 같습니다.
SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-01' GROUP BY region;
SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-01' GROUP BY region;
실행할 때마다 같은 태블릿을 다시 스캔하고 결과를 다시 계산하므로 CPU와 I/O가 낭비됩니다. Query Cache는 중간 집계 결과를 캐싱하고, 캐시가 적중하면 이를 바로 반환하여 지연 시간을 크게 줄입니다.
- 이 기능은 내부 OLAP 테이블의 집계 쿼리에만 적용됩니다. 일반 스캔, JOIN, 정렬 등의 연산은 Query Cache를 사용하지 않습니다.
- 외부 테이블은 지원하지 않습니다(Hive, JDBC, Iceberg, Hudi, Paimon 등).
동작 원리
지원하는 쿼리 패턴
실행 계획 트리가 다음 패턴 중 하나와 일치하는 프래그먼트만 캐시를 사용할 수 있습니다.
AggregationNode → OlapScanNode: 스캔 바로 위에서 수행하는 단일 단계 집계입니다.AggregationNode → AggregationNode → OlapScanNode: 스캔 위에서 수행하는 두 단계 집계입니다.
집계 노드와 스캔 노드 사이에는 FilterNode, ProjectNode 등의 중간 노드가 있어도 됩니다. 다만 캐싱할 하위 트리에는 JoinNode, SortNode, UnionNode, WindowNode, ExchangeNode가 포함되어서는 안 됩니다.
캐시 키를 구성하는 세 가지 요소
| 구성 요소 | 설명 |
|---|---|
| SQL 다이제스트 | 정규화된 실행 계획 트리에서 계산한 SHA-256 해시입니다. 집계 함수, 그룹화 표현식, 비파티션 필터 조건식, 프로젝션 컬럼, 결과에 영향을 주는 세션 변수가 계산에 포함됩니다. 의미가 같은 쿼리는 같은 다이제스트를 생성합니다. |
| 태블릿 ID 목록 | 현재 파이프라인 인스턴스에 할당된 태블릿 ID를 정렬한 목록입니다. |
| 태블릿 범위 | 파티션 조건식에서 도출한 각 태블릿의 유효 스캔 범위입니다(파티션과 필터 동작 참조). |
캐시 무효화 조건
| 발생 조건 | 설명 |
|---|---|
| 데이터 변경 | INSERT, DELETE, UPDATE 또는 컴팩션이 발생하면 태블릿 버전 번호가 증가합니다. 이후 쿼리는 버전을 비교하며, 일치하지 않으면 캐시 미스로 처리합니다. 증분 병합이 활성화되어 있으면 델타만 스캔하여 이전 버전의 항목을 재사용할 수도 있습니다. |
| 스키마 변경 | ALTER TABLE로 테이블 구조가 바뀌면 실행 계획과 다이제스트도 바뀝니다. |
| LRU 축출 | 캐시 메모리가 제한을 초과하면 LRU-K(K=2)에 따라 항목을 축출합니다. 새 항목은 최소 두 번 접근해야 캐시에 수용됩니다. |
| 만료 항목 정리 | 주기적인 정리 작업이 24시간이 지난 항목을 자동으로 제거합니다. |
| 강제 새로고침 | query_cache_force_refresh = true를 설정하면 캐시를 무시하고 쿼리를 다시 실행합니다. |
실행 흐름
첫 실행(캐시 미스):
- 스캔 연산자가 평소처럼 태블릿에서 데이터를 읽습니다.
- 집계 연산자가 결과를 계산합니다.
- 결과를 다운스트림 소비자에게 전달하고, 캐시에 쓰기 위해 누적합니다.
- 실행이 완료된 후 누적 결과가 항목별 크기 또는 행 수 제한을 초과하지 않으면 결과를 캐시에 씁니다.
이후 실행(캐시 적중):
- 스캔 연산자가 캐시 적중을 감지하고 스캔 범위를 건너뜁니다. 태블릿 데이터는 읽지 않습니다.
- 집계 연산자는 입력이 없으므로 출력을 생성하지 않습니다.
- 캐시 소스 연산자가 캐싱된 데이터 블록을 바로 제공합니다.
- 컬럼 순서가 캐시 항목과 다르면(예를 들어
SELECT a, b와SELECT b, a는 같은 다이제스트를 생성함) 컬럼을 자동으로 재배열합니다.
파티션과 필터 동작
높은 캐시 적중률을 얻으려면 파티션 조건식과 필터 표현식이 Query Cache와 어떻게 상호 작용하는지 이해해야 합니다.
단일 컬럼 RANGE 파티션 조건식
단일 컬럼 RANGE 파티셔닝을 사용하는 테이블에서는 파티션 조건식을 특별하게 처리합니다.
- 파티션 조건식을 다이제스트에서 분리합니다. 시스템은 조건식 범위와 각 파티션의 실제 범위 경계가 겹치는 구간을 계산하고, 이를 태블릿 범위 문자열로 캐시 키에 추가합니다.
- 파티션 필터 범위만 다른 두 쿼리는 공통 태블릿의 캐시를 공유할 수 있습니다.
예시: orders 테이블이 dt 컬럼을 기준으로 일별 파티셔닝되어 있습니다.
-- Query A
SELECT region, SUM(revenue) FROM orders
WHERE dt >= '2024-01-01' AND dt < '2024-01-03' GROUP BY region;

-- Query B
SELECT region, SUM(revenue) FROM orders
WHERE dt >= '2024-01-02' AND dt < '2024-01-04' GROUP BY region;
- 쿼리 A는
2024-01-01과2024-01-02파티션을 스캔합니다. - 쿼리 B는
2024-01-02와2024-01-03파티션을 스캔합니다. - 파티션
2024-01-02의 태블릿 다이제스트와 범위가 같으므로, 쿼리 B는 쿼리 A의2024-01-02캐시를 재사용하고2024-01-03파티션만 다시 계산하면 됩니다.
다중 컬럼 RANGE / LIST / 비파티션 테이블
다중 컬럼 RANGE 파티셔닝, LIST 파티셔닝을 사용하거나 파티셔닝을 사용하지 않는 테이블에서는 파티션 조건식을 분리할 수 없으므로 다이제스트에 직접 포함합니다. 파티션 조건식에 작은 차이만 있어도 다른 다이제스트가 생성되어 캐시 미스가 발생합니다.
비파티션 필터 표현식
비파티션 필터 표현식(예: WHERE status = 'active')은 정규화된 실행 계획 다이제스트에 포함됩니다. 두 쿼리는 정규화된 필터 표현식의 의미가 같을 때만 캐시를 공유할 수 있습니다.
| 쿼리 1 | 쿼리 2 | 캐시 공유 여부 |
|---|---|---|
WHERE status = 'active' | WHERE status = 'active' | 예(같은 다이제스트) |
WHERE status = 'active' | WHERE status = 'inactive' | 아니요(다른 다이제스트) |
WHERE status = 'active' AND region = 'ASIA' | WHERE region = 'ASIA' AND status = 'active' | 예(정규화 후에는 순서와 무관) |
세션 변수
쿼리 결과에 영향을 주는 세션 변수(예: time_zone, sql_mode, sql_select_limit)는 다이제스트에 포함됩니다. 두 쿼리 사이에 이러한 변수 중 하나라도 바뀌면 다른 캐시 키가 생성되어 캐시 미스가 발생합니다.
Query Cache를 비활성화하는 조건
| 조건 | 이유 |
|---|---|
| 프래그먼트가 런타임 필터의 대상인 경우 | 계획 단계에서는 런타임 필터 값을 알 수 없으므로 캐싱하면 잘못된 결과를 반환할 수 있습니다. |
비결정적 표현식이 포함된 경우(rand(), now(), uuid(), UDF 등) | 입력이 같아도 실행할 때마다 결과가 달라집니다. |
| 캐싱할 하위 트리에 JOIN, SORT, UNION 또는 WINDOW 노드가 포함된 경우 | "집계-스캔" 패턴만 지원합니다. |
스캔 노드가 OlapScanNode가 아닌 경우(예: 외부 테이블 스캔) | 캐시는 태블릿 ID와 버전에 의존하는데, 외부 테이블에는 이러한 정보가 없습니다. |
Query Cache가 외부 테이블을 지원하지 않는 이유
Query Cache는 내부 OLAP 테이블에만 있는 세 가지 속성에 의존합니다.
- 태블릿 기반 데이터 구성: 캐시 키에는 태블릿 ID와 각 태블릿의 스캔 범위가 포함됩니다. 외부 테이블은 HDFS, S3, JDBC 등의 외부 시스템에 저장되며 태블릿 개념이 없습니다.
- 버전 기반 무효화: 내부 태블릿마다 단조 증가하는 버전 번호가 있으며, 캐시는 이를 사용하여 데이터가 오래되었는지 감지합니다. 외부 테이블은 이러한 버전 메커니즘을 Doris에 제공하지 않습니다.
- OlapScanNode 요구 사항: 실행 계획 정규화 로직은 집계 캐시 지점 아래의 유효한 스캔 노드로
OlapScanNode만 인식합니다.
외부 테이블에 캐싱이 필요하면 SQL Cache를 사용하세요.
증분 병합(실험적 기능)
기본적으로 버전이 뒤처진 캐시 항목(예: 매시간 데이터를 적재하는 테이블의 현재 파티션에 대한 항목)은 폐기되며, 전체 스캔을 통해 인스턴스 전체를 다시 계산합니다. 증분 병합을 활성화하면 BE는 오래된 항목을 재사용합니다. (cached_version, current_version] 구간의 델타 rowset만 스캔하고, 해당 부분 집계 상태를 캐싱된 부분 집계 블록과 함께 내보낸 다음(상위 병합 집계에서 둘을 결합함), 병합된 항목을 새 버전으로 다시 씁니다. 매시간 데이터를 적재하는 패턴에서는 자주 사용하는 파티션의 스캔 비용이 "매시간 파티션 전체"에서 "한 시간 동안 새로 들어온 데이터"로 줄어듭니다.
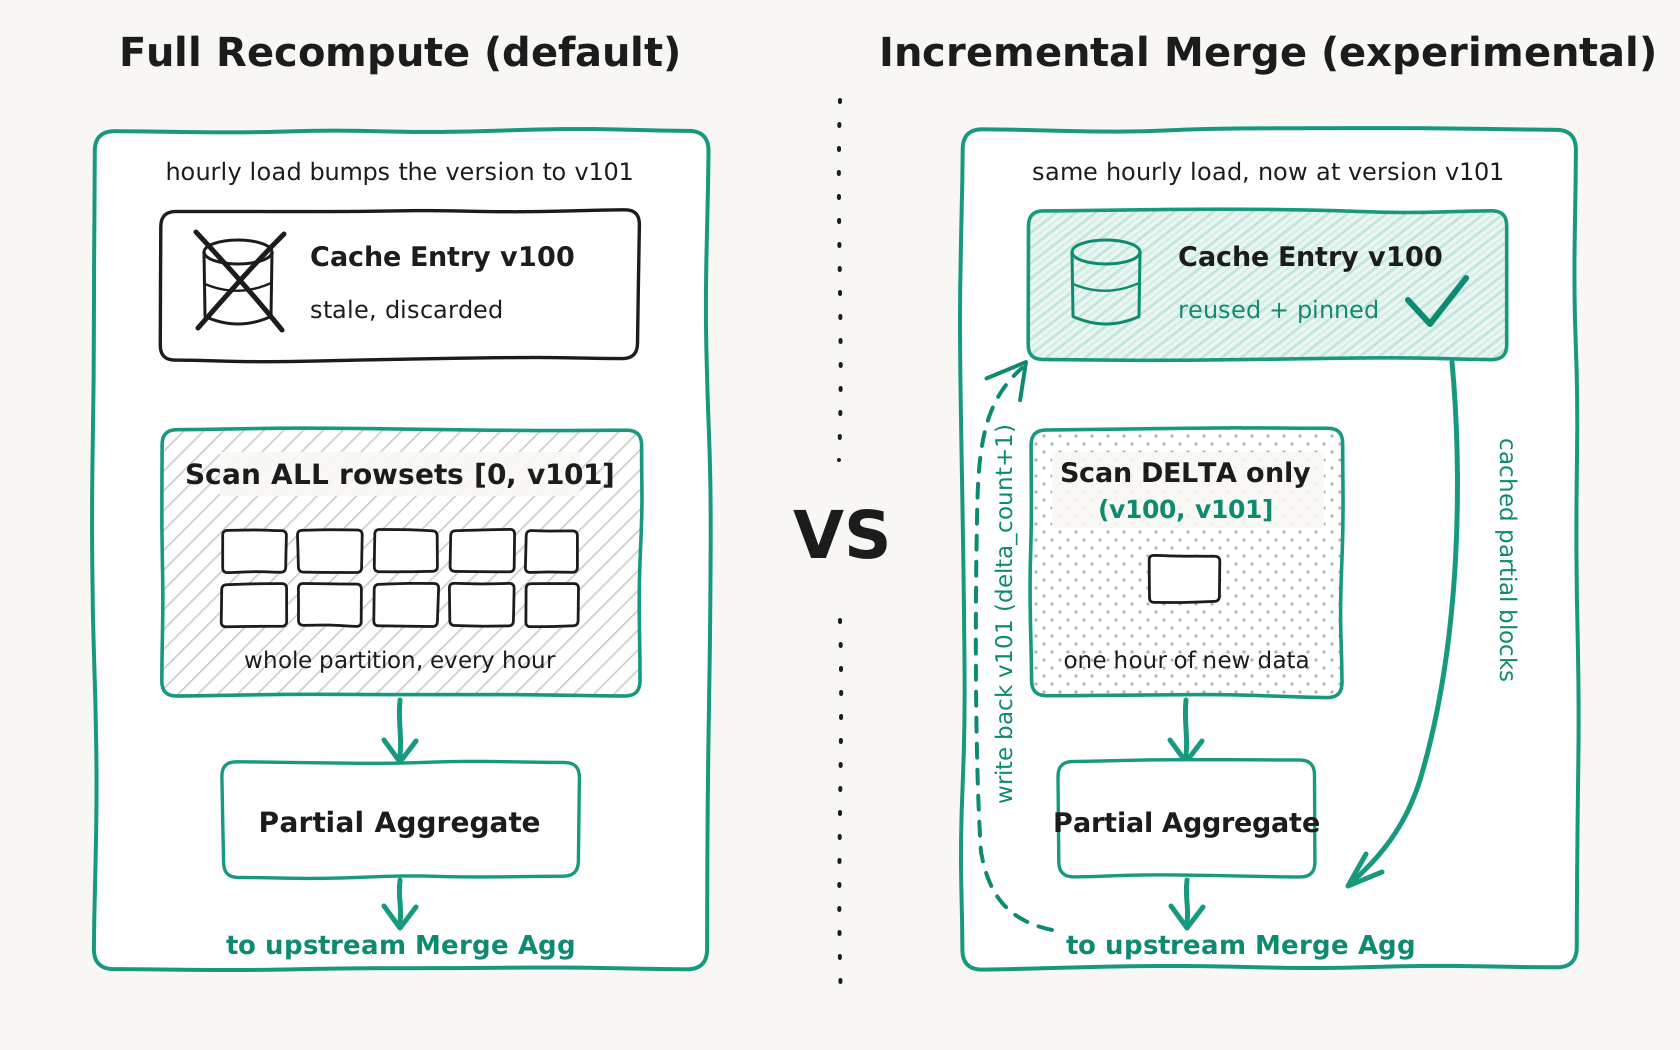
SET enable_query_cache = true;
SET enable_query_cache_incremental = true;  -- shown as experimental_enable_query_cache_incremental in SHOW VARIABLES
사전 요구 사항
증분 병합은 다음 조건을 모두 충족할 때만 적용됩니다. 그 외의 경우에는 별도 알림 없이 전체 재계산으로 전환되므로 결과는 항상 정확합니다.
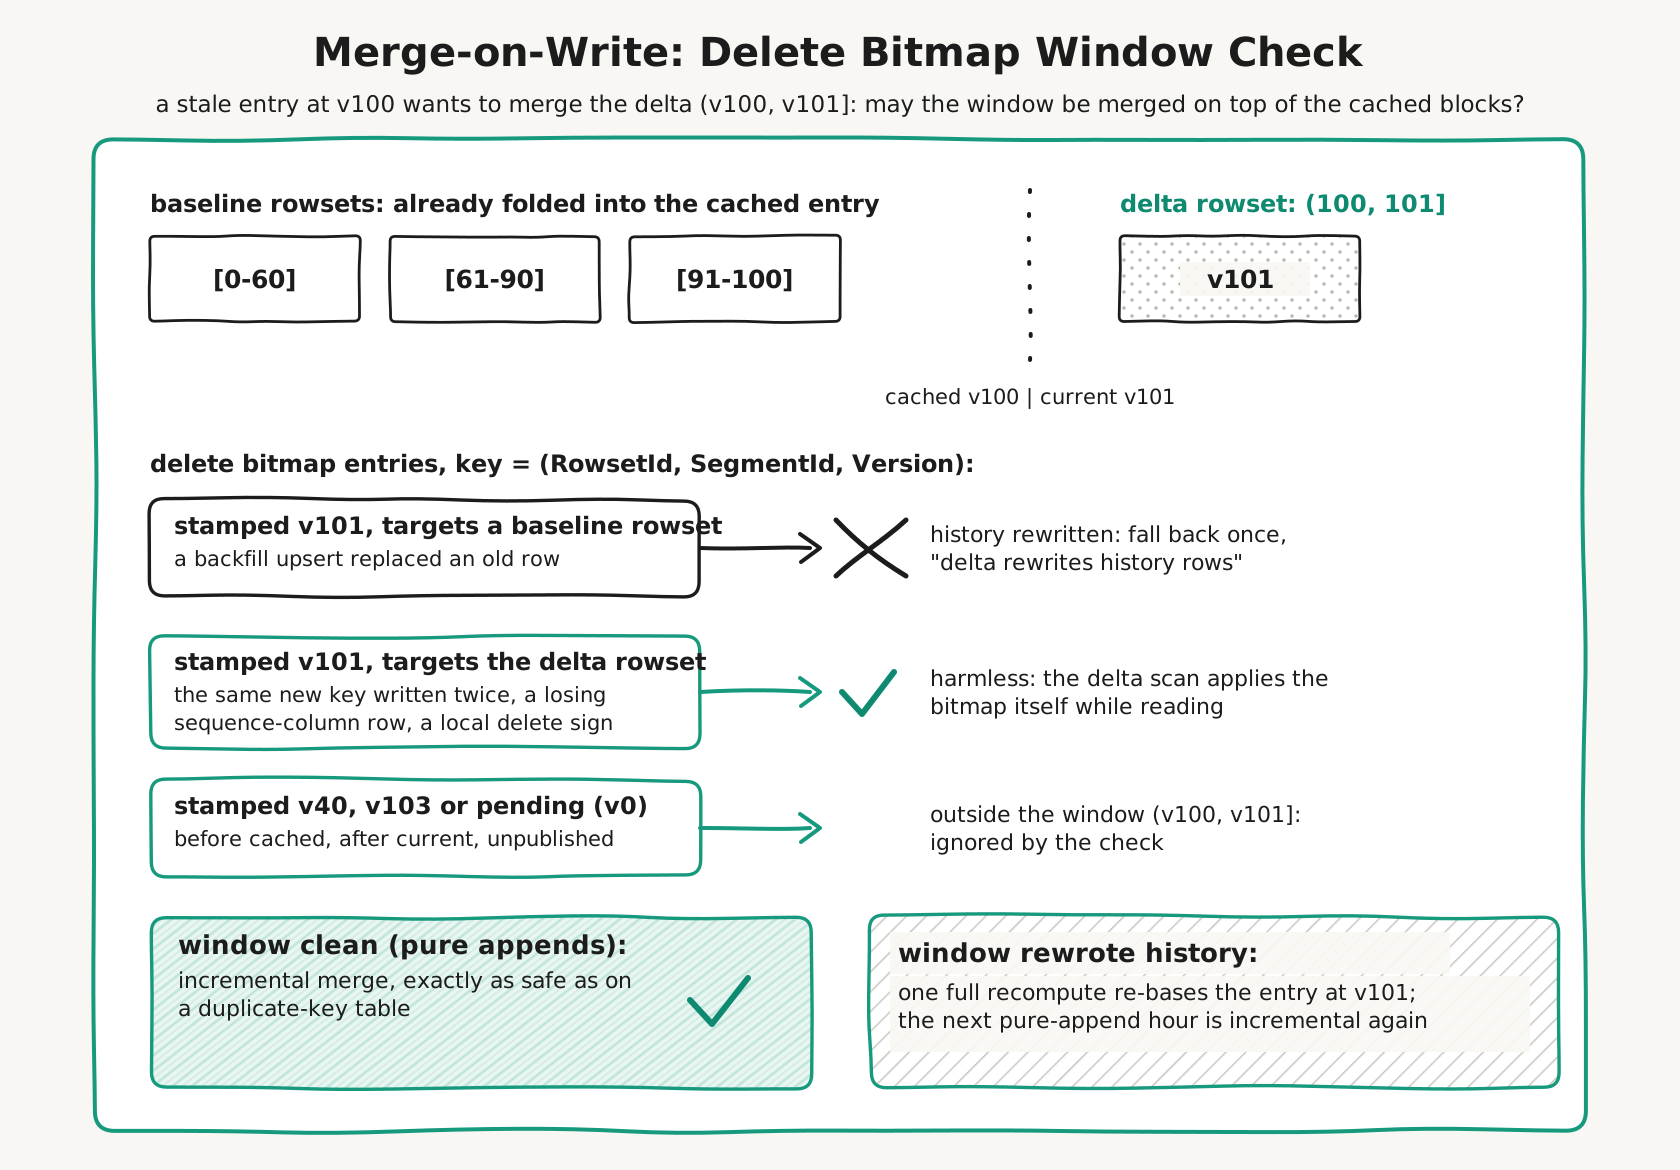
- 스캔하는 인덱스(기본 테이블 또는 선택한 rollup)가 추가 전용이어야 합니다. 즉, DUP_KEYS 모델이거나 델타 구간에서 기존 키를 다시 쓰지 않은 merge-on-write UNIQUE_KEYS 테이블이어야 합니다. merge-on-write 테이블에서는 BE가 태블릿별로
(cached_version, current_version]구간의 delete bitmap을 확인합니다. 새 키만 추가한 구간(기본 키 테이블에서 흔히 사용하는 "시간별 데이터 적재" 패턴)은 증분 병합합니다. 반면 upsert, 부분 업데이트 또는 delete sign이 이전 키에 영향을 주었다면 한 번의 전체 재계산으로 전환합니다. 이때 캐시 항목의 기준이 갱신되므로 다음에 순수 추가 방식으로 데이터를 적재하면 다시 증분 병합할 수 있습니다. Merge-on-read UNIQUE 테이블은 읽을 때 중복을 해소하고 AGG 테이블은 스토리지 계층 내부에서 행을 병합하므로, 이들에서는 "캐싱된 스냅샷 + 델타 = 새 스냅샷"이라는 관계가 성립하지 않습니다. 집계된 구체화된 뷰도 같은 이유로 제외됩니다. - 캐시 지점이 스캔 바로 위의 non-finalize 집계여야 합니다(일반적인 두 단계 집계 형태, 예: 분산 컬럼이 아닌 컬럼에 대한
GROUP BY). 단일 단계 집계와 중첩 집계 캐시 지점은 제외됩니다. - 태블릿 뷰를 쿼리에서 요청한 버전으로 동기화할 수 있어야 합니다. 컴퓨팅-스토리지 통합 모드에서는 이 조건이 자연스럽게 충족됩니다. 컴퓨팅-스토리지 분리(클라우드) 모드에서는 태블릿별 판단 과정에서 먼저 로컬 뷰(rowset과 merge-on-write 테이블의 delete bitmap)를 요청한 버전까지 갱신합니다. 이 작업에는 대개 추가 비용이 없습니다. 뷰가 이미 최신이면 아무 작업도 하지 않고, 그렇지 않으면 스캔에서 어차피 수행할 동기화를 앞당길 뿐입니다. 동기화가 실패하거나 짧은 빠른 실패 제한 시간(
query_cache_decision_sync_timeout_ms, 느린 메타 서비스가 캐시 수용 여부를 판단하는 스레드를 붙잡지 않도록 하는 BE 설정)을 넘겨 지연되면 한 번의 전체 재계산으로 전환합니다. - 델타 버전 경로를 여전히 확보할 수 있어야 하며(컴팩션으로 병합되어 사라지지 않아야 함), DELETE 조건식이 없어야 합니다. 델타 내의 삭제는 이미 캐싱된 블록에 반영된 행을 논리적으로 제거하므로, 병합만으로는 이를 되돌릴 수 없기 때문입니다.
merge-on-write 테이블에서 delete bitmap 구간 확인은 다음과 같이 동작합니다.
컴퓨팅-스토리지 분리(클라우드) 클러스터에서는 두 세션 변수를 통해 버전의 정확성을 일부 양보하고 속도를 높일 수 있습니다. query_freshness_tolerance_ms는 스캔이 요청한 버전보다 낮은, 이미 준비된 버전에서 멈출 수 있게 하며, enable_prefer_cached_rowset은 이미 준비된 rowset 배치를 따라가도록 합니다. 어느 변수를 사용하든 탐색 경로가 요청한 버전을 넘어갈 수도 있습니다(이미 준비된 컴팩션 rowset이 해당 버전을 가로지르면 경로가 그 너머까지 확장됨). 따라서 이들 변수 중 하나라도 사용하는 쿼리는 요청한 버전과 정확히 일치하지 않는 뷰를 읽을 수 있으므로 증분 병합을 사용하지 않습니다. 델타 확보는 항상 정확히 요청한 버전을 대상으로 하므로 이러한 변수의 목적에 어긋나기 때문입니다. 증분 병합 여부와 별개로, 클라우드에서 BE는 이러한 쿼리의 Query Cache 쓰기 반영도 건너뜁니다. 따라서 내용과 버전 정보가 일치하지 않는 항목이 생성되지 않습니다. 다만 이 쿼리는 일반 실행으로 채워진 정확한 HIT 항목을 사용할 수 있습니다. 증분 병합 제외 조건 자체는 모든 배포 모드에 적용됩니다(의도적으로 모드와 무관하게 적용하는 조건). 로컬 스토리지에서는 이러한 변수가 아무 효과도 없으므로, 클라우드 전용 절충 옵션을 선택한 쿼리가 증분 최적화를 사용하지 못할 뿐이며 어느 경우든 결과는 정확합니다.
병합된 항목의 컴팩션
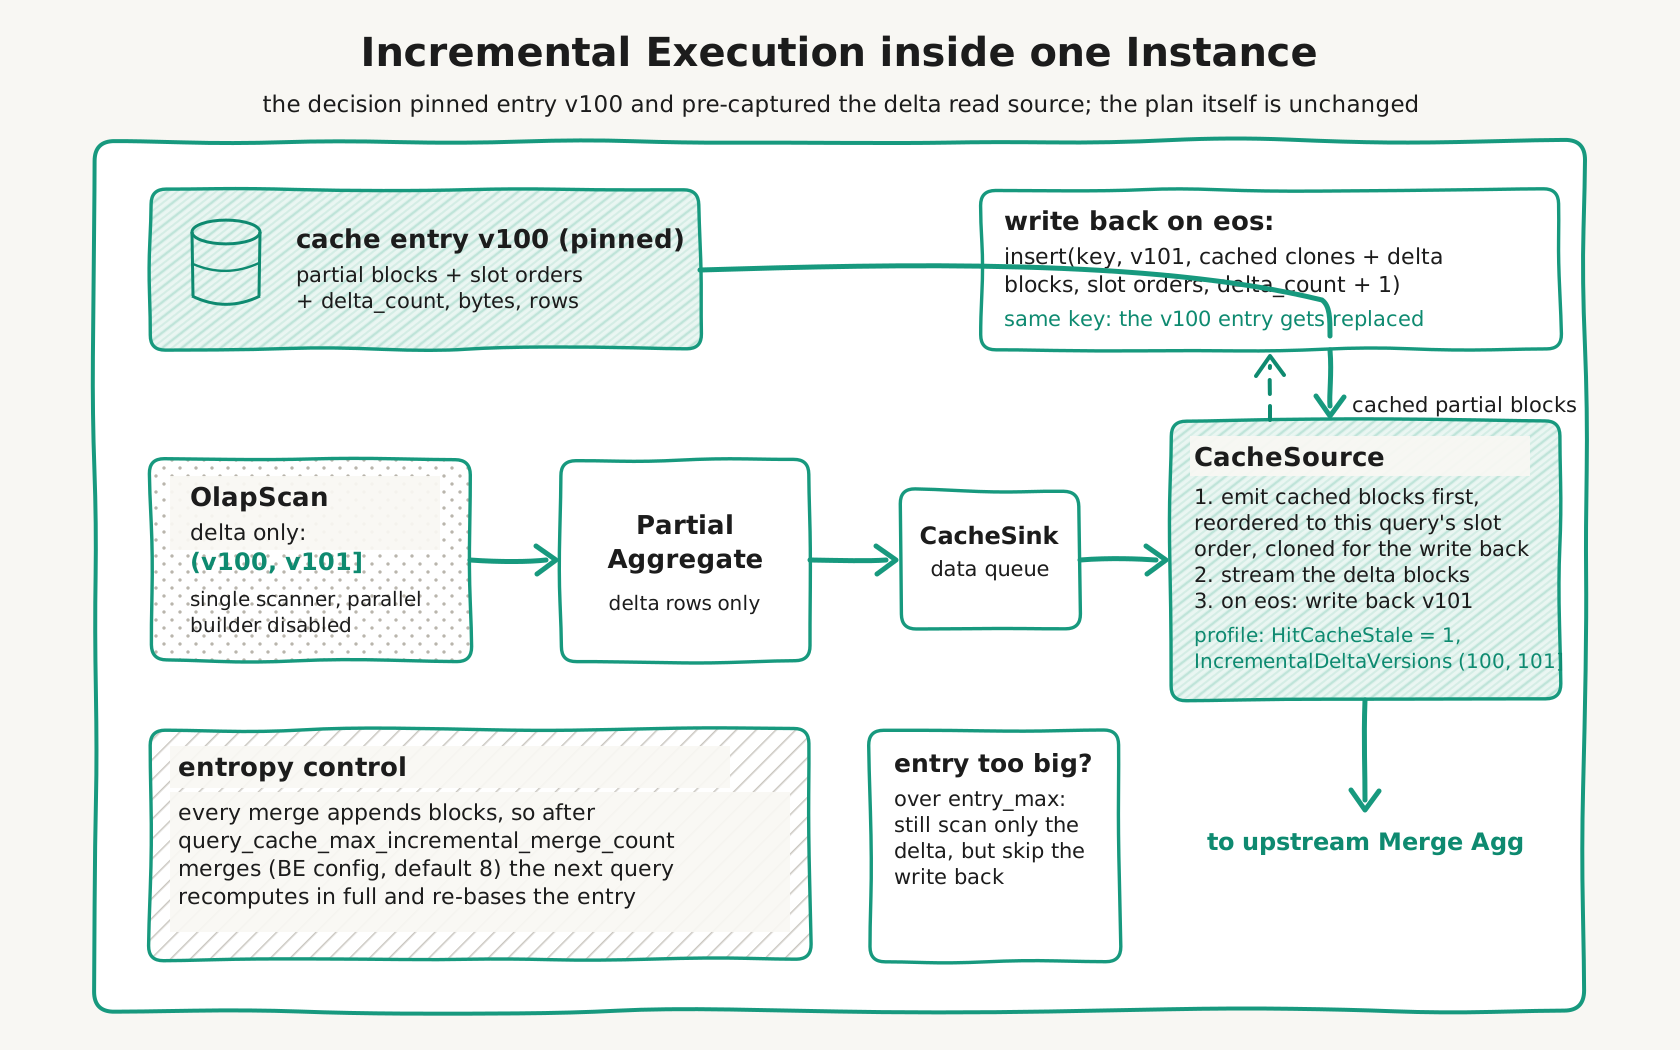
증분 병합을 수행할 때마다 델타 블록이 항목에 추가되므로 시간이 지날수록 항목이 단편화됩니다. 한 항목에 query_cache_max_incremental_merge_count번의 병합이 누적되면(BE 설정, 기본값 8, 런타임에 변경 가능), 다음 쿼리는 전체 스캔으로 이를 다시 계산하며 이 과정에서 항목이 자연스럽게 압축됩니다.
쓰기 반영과 두 가지 엔트로피 제어를 포함한 단일 인스턴스 내부의 데이터 흐름은 다음과 같습니다.
관측 가능성
- CACHE_SOURCE 연산자의 쿼리 프로파일에서
HitCacheStale = 1은 증분 병합이 수행되었음을 나타냅니다.IncrementalDeltaVersions는 델타 범위를 보여줍니다(예:(100, 114514]). 오래된 항목을 재사용하지 못한 경우에는IncrementalFallbackReason이 이유를 설명합니다(delta versions not capturable,delta contains delete predicates,delta rewrites history rows,keys type not append-only,cloud rowset sync failed,cloud rowset sync timed out등). - BE 메트릭:
doris_be_query_cache_stale_hit_total,doris_be_query_cache_incremental_fallback_total,doris_be_query_cache_write_back_total,doris_be_query_cache_decision_sync_time_ms(컴퓨팅-스토리지 분리 모드에서만 증가하며, 증분 사용 여부를 판단하면서 델타를 확보하기 전에 태블릿 뷰를 요청한 버전으로 동기화하는 데 걸린 누적 실제 시간).
BE가 HIT, INCREMENTAL, MISS 중 하나를 결정하는 과정과 각 폴백 사유가 발생하는 지점은 다음과 같습니다.
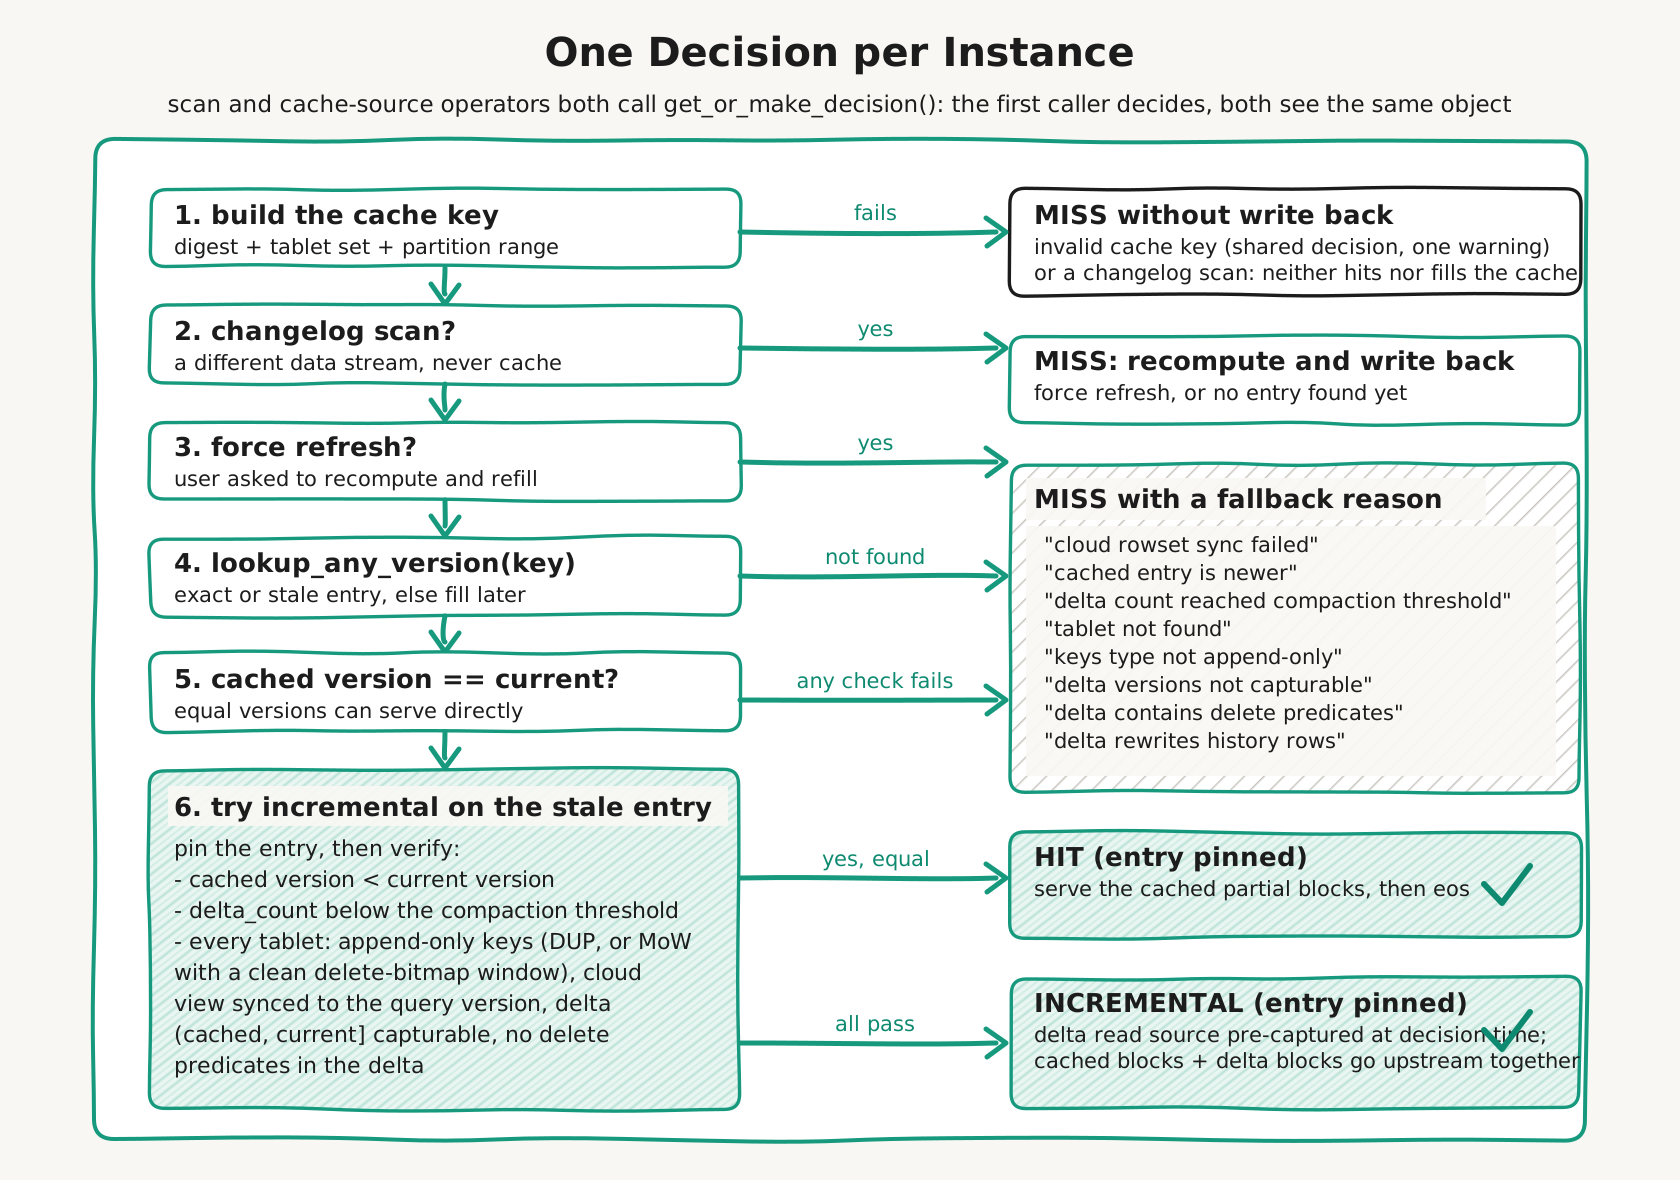
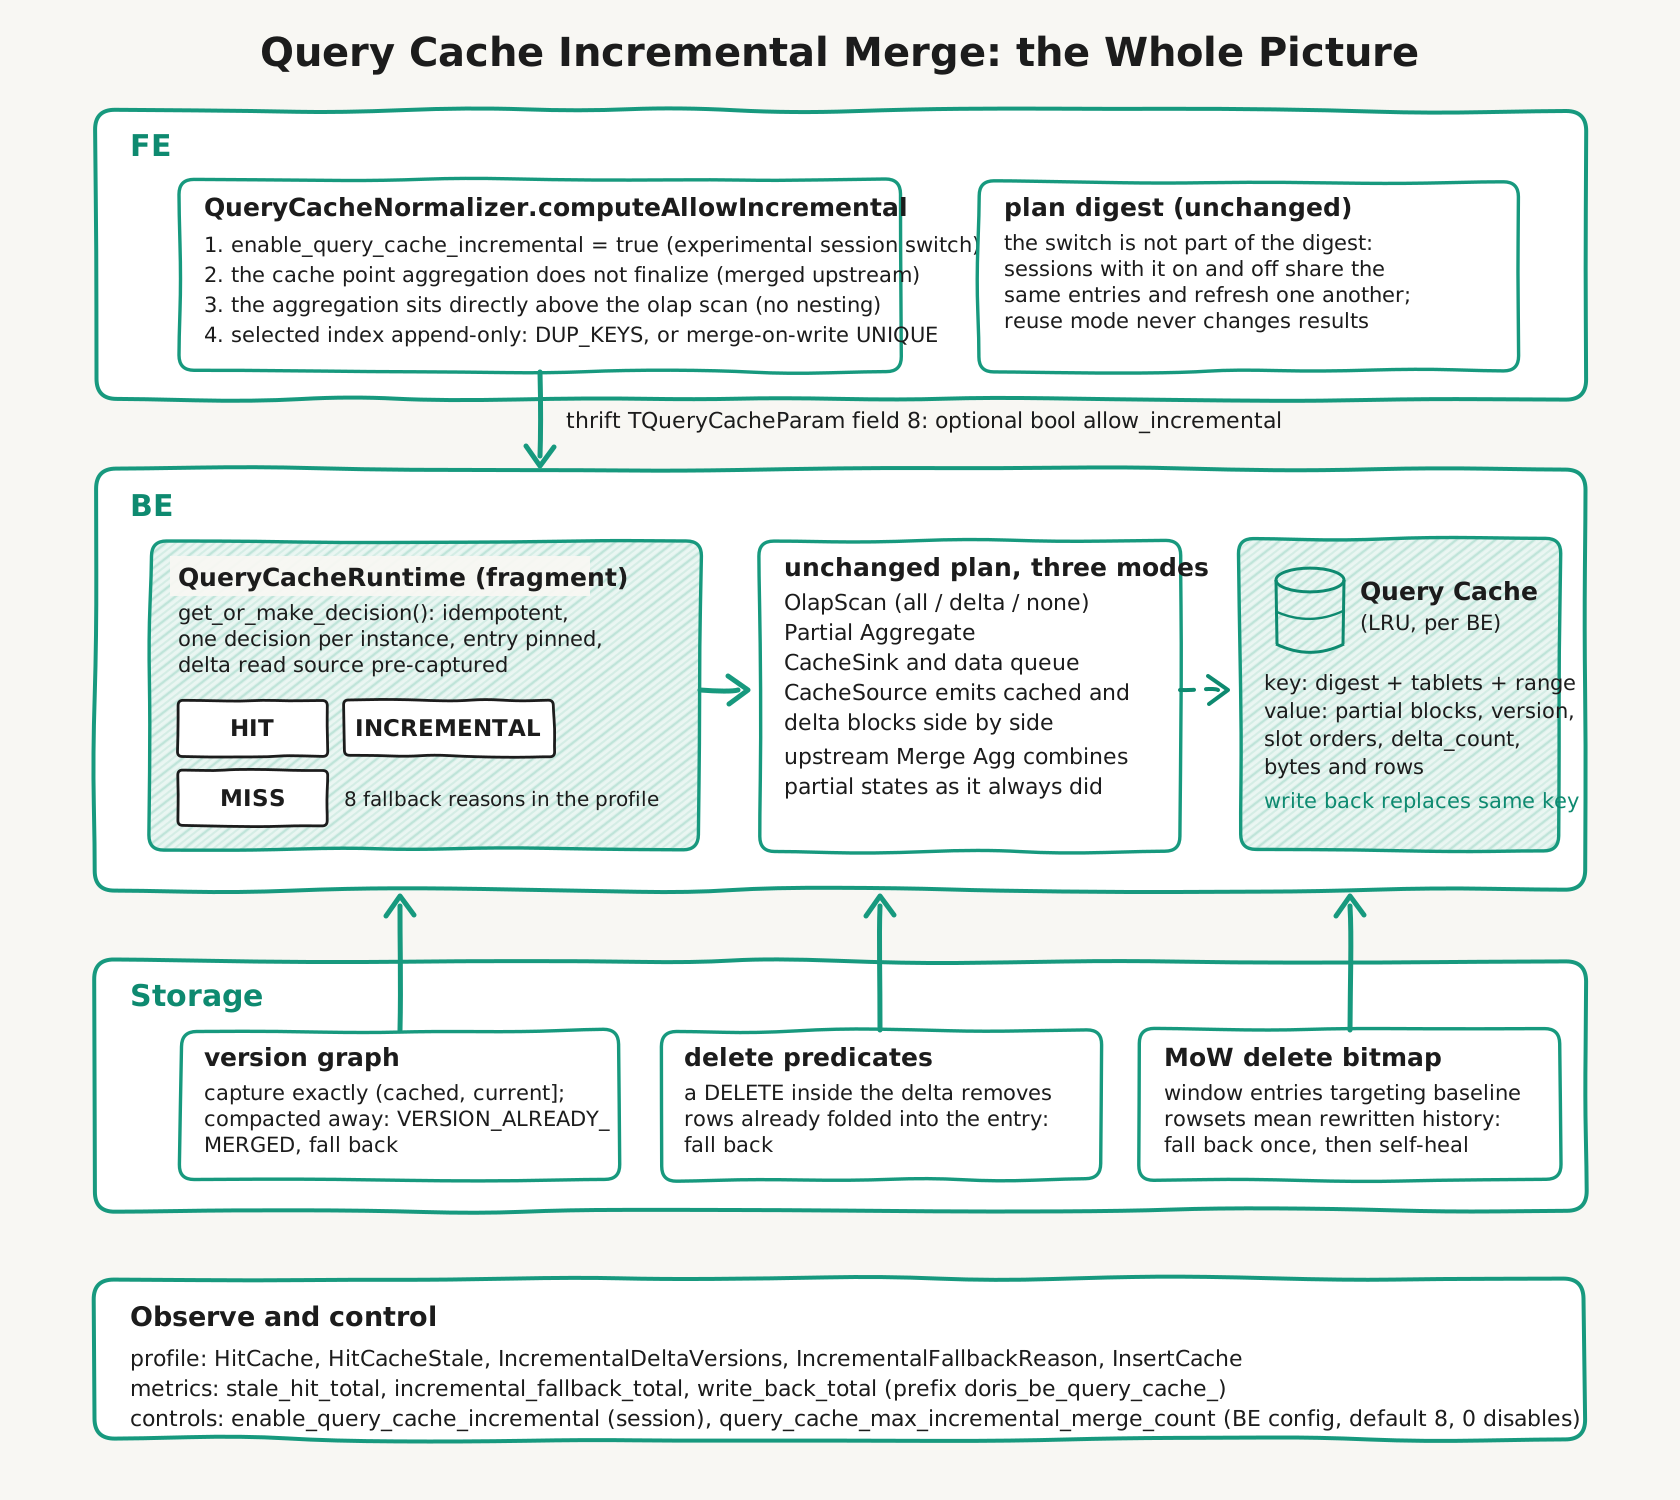
FE의 허용 여부 판단부터 스토리지 계층의 보호 조건까지 전체 과정을 종합하면 다음과 같습니다.
설정 매개변수
세션 변수(FE)
| 매개변수 | 설명 | 기본값 |
|---|---|---|
enable_query_cache | Query Cache를 활성화하거나 비활성화하는 마스터 스위치입니다. | false |
query_cache_force_refresh | true로 설정하면 캐싱된 결과를 무시하고 쿼리를 다시 실행합니다. 새 결과는 계속 캐시에 기록됩니다. | false |
query_cache_entry_max_bytes | 단일 캐시 항목의 최대 크기(바이트)입니다. 이 제한을 초과하는 프래그먼트 결과는 캐싱하지 않습니다. | 5242880 (5 MB) |
query_cache_entry_max_rows | 단일 캐시 항목의 최대 행 수입니다. 이 제한을 초과하는 프래그먼트 결과는 캐싱하지 않습니다. | 500000 |
enable_query_cache_incremental | (실험적 기능) BE가 캐싱된 버전 이후의 델타 rowset만 스캔하고 이를 캐싱된 부분 집계 블록과 병합하여 오래된 캐시 항목을 재사용할 수 있게 합니다. 증분 병합을 참조하세요. | false |
BE 설정(be.conf)
| 매개변수 | 설명 | 기본값 |
|---|---|---|
query_cache_size | 각 BE에 있는 Query Cache의 총 메모리 용량(MB)입니다. | 512 |
query_cache_max_incremental_merge_count | 항목을 압축하기 위해 전체 재계산을 강제하기 전까지 단일 캐시 항목에 누적할 수 있는 최대 증분 병합 횟수입니다. 0으로 설정하면 런타임에 증분 병합을 비활성화합니다. | 8 |
query_cache_decision_sync_timeout_ms | (클라우드 모드 전용) 증분 병합 사용 여부를 판단하면서 델타를 확보하기 전에 각 태블릿 뷰를 요청한 버전으로 동기화할 때 적용하는 빠른 실패 제한 시간(밀리초)입니다. 이 시간 안에 동기화가 완료되지 않으면 쿼리는 한 번의 전체 재계산으로 전환합니다. <= 0이면 클라우드 증분 병합을 비활성화합니다(대기 중인 동기화는 모두 폴백 처리됨). 런타임에 변경할 수 있습니다. | 2000 |
query_cache_max_size_mb와 query_cache_elasticity_size_mb는 be.conf에서 기존 SQL Result Cache를 제어하는 설정입니다. 이 문서에서 설명하는 파이프라인 수준의 Query Cache에 대한 설정이 아니므로 혼동하지 마세요.
사용 예시
1단계: Query Cache 활성화
목표: Query Cache 마스터 스위치를 켭니다.
SET enable_query_cache = true;
설명: 이 변수는 세션 범위에 적용되므로 각 연결에서 활성화해야 합니다. 전역 FE 변수로 기본값을 설정할 수도 있습니다.
2단계: 일반적인 집계 쿼리 실행
목표: 캐시 쓰기와 읽기를 유도합니다.
-- First execution: cache miss, compute the result and write it to the cache
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt = '2024-01-15' AND status = 'completed'
GROUP BY region;

-- Second execution: cache hit, return the result directly from the cache
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt = '2024-01-15' AND status = 'completed'
GROUP BY region;
설명: 두 번째 실행의 SQL 다이제스트, 태블릿 ID 목록, 태블릿 범위가 첫 번째 실행과 같으므로 캐시가 적중합니다.
3단계: 프로파일에서 캐시 적중 확인
목표: 쿼리가 실제로 캐시를 사용하는지 확인합니다.
쿼리를 실행한 후 프로파일에서 CacheSourceOperator 섹션을 찾으세요.
| 프로파일 필드 | 의미 |
|---|---|
HitCache: true | 쿼리가 캐시에서 결과를 가져왔습니다. |
HitCache: false, InsertCache: true | 캐시 미스가 발생했지만 결과가 캐시에 정상적으로 기록되었습니다. |
HitCache: false, InsertCache: false | 캐시 미스가 발생했으며 결과가 너무 커서 캐싱하지 못했습니다. |
CacheTabletId | 캐시 항목이 포함하는 태블릿 ID입니다. |
4단계: 캐시 강제 새로고침
목표: 기존 캐시를 무시하고 결과를 다시 계산합니다(예: 캐싱된 데이터가 잘못되었다고 의심되는 경우).
-- Force the next query to skip the cache and recompute the result
SET query_cache_force_refresh = true;

SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-15' GROUP BY region;

-- Reset
SET query_cache_force_refresh = false;
설명: 강제 새로고침 후에도 새 결과는 캐시에 기록됩니다.
사용 사례 비교
| 사용 사례 | 적용 가능 여부 | 이유 |
|---|---|---|
| 같은 집계 SQL을 반복 실행하는 대시보드 또는 BI 도구 | 예 | 다이제스트와 태블릿이 정확히 일치하여 높은 적중률을 얻을 수 있습니다. |
| T+1 보고서(하루에 한 번 데이터 적재) | 예 | 같은 날 이후에 실행되는 쿼리에서 캐시가 적중할 수 있습니다. |
| 날짜 범위가 겹치는 집계 쿼리 | 예 | 단일 컬럼 RANGE 파티셔닝을 사용하면 태블릿 단위로 항목을 공유할 수 있습니다. |
| 일반 SELECT 스캔, JOIN, 정렬, 윈도 함수 | 아니요 | "집계-스캔" 패턴만 지원합니다. |
| 외부 테이블(Hive, JDBC, Iceberg, Hudi, Paimon) | 아니요 | 태블릿 또는 버전 메커니즘이 없습니다. SQL Cache를 사용하세요. |
| 자주 갱신되는 테이블 | 아니요 | 태블릿 버전이 빠르게 바뀌므로 적중률이 낮습니다. |
now(), rand(), uuid() 또는 UDF가 포함된 쿼리 | 아니요 | 결과가 비결정적이면 캐시가 비활성화됩니다. |
| 런타임 필터에 의존하는 쿼리 | 아니요 | 계획 단계에서는 런타임 필터 값을 알 수 없습니다. |
유의 사항
- 캐시는 영구 저장되지 않음: Query Cache는 BE 메모리에 상주하며 BE가 다시 시작되면 지워집니다.
- 메모리 사용량: 캐싱된 데이터 블록은 BE 메모리를 사용합니다. 메모리 사용량을 모니터링하고 필요에 따라
query_cache_size를 조정하세요. - LRU-K 수용 정책: 캐시가 가득 차면 새 항목은 최소 두 번(K=2) 접근해야 수용됩니다. 이를 통해 실행 빈도가 낮은 쿼리가 캐시를 오염시키는 것을 방지합니다.
문제 해결
| 증상 | 가능한 원인 | 해결 방법 |
|---|---|---|
HitCache: false가 계속 나타남 | enable_query_cache가 활성화되지 않았습니다. | SET enable_query_cache = true를 실행하세요. |
HitCache: false, InsertCache: false | 단일 항목의 결과가 너무 커서 query_cache_entry_max_bytes 또는 _max_rows를 초과합니다. | 해당 임계값을 높이거나 필터를 추가하여 결과 크기를 줄이세요. |
계획에 CacheSourceOperator가 없음 | 계획에 JOIN/SORT/UNION/WINDOW가 포함되어 있거나 런타임 필터의 대상입니다. | SQL을 "집계-스캔" 패턴에 맞게 다시 작성하세요. |
| 테이블이 외부 테이블임 | Query Cache는 외부 테이블을 지원하지 않습니다. | SQL Cache를 사용하세요. |
| 데이터가 바뀌지 않았는데도 캐시 미스가 발생함 | 스키마 변경, 세션 변수 변경 또는 query_cache_force_refresh = true 설정이 원인입니다. | ALTER 이력을 검토하고 세션 변수를 비교한 후 query_cache_force_refresh를 재설정하세요. |
| 캐시 적중률이 매우 낮음 | 태블릿이 자주 갱신되거나 컴팩션됩니다. | 쓰기 빈도를 줄이거나 갱신 빈도가 낮은 테이블에만 캐시를 활성화하세요. |
| BE 메모리 압박이 커짐 | query_cache_size가 너무 높게 설정되어 있습니다. | query_cache_size를 낮추고 BE를 다시 시작하세요. |
FAQ
Q1: Query Cache와 SQL Cache는 어떻게 다른가요?
| 비교 항목 | Query Cache | SQL Cache |
|---|---|---|
| 캐시 단위 | 태블릿 단위의 중간 집계 결과입니다. | SQL 문 전체의 최종 결과입니다. |
| 적용 가능한 쿼리 | 내부 OLAP 테이블의 집계 쿼리만 지원합니다. | 외부 테이블 쿼리를 포함한 모든 쿼리를 지원합니다. |
| 공유 기능 | 서로 다른 SQL 문이 태블릿 단위로 캐시 항목을 공유할 수 있습니다. | SQL 텍스트가 정확히 일치해야만 캐시가 적중합니다. |
| 무효화 | 태블릿 버전이 바뀌면 즉시 무효화됩니다. | 파티션 버전 또는 시간을 기준으로 무효화됩니다. |
Q2: 활성화한 직후에 캐시가 적중하나요?
아니요. 첫 실행에서는 "캐시 미스 후 캐시 쓰기"가 발생하며, 두 번째 실행부터 캐시가 적중할 수 있습니다. 또한 LRU-K(K=2)는 새 항목이 실제로 수용되기 전에 최소 두 번 접근할 것을 요구합니다.
Q3: JOIN이 포함된 집계도 캐싱할 수 있나요?
집계가 JOIN을 기준으로 어디에 위치하는지에 따라 다릅니다. 집계가 JOIN 바로 위에 있으면(캐싱할 하위 트리에 JoinNode가 나타남) 런타임 필터와 관계없이 해당 프래그먼트는 캐싱하지 않습니다. 하지만 먼저 집계한 후 JOIN하도록 쿼리를 다시 작성하면(집계를 각 테이블의 스캔 쪽으로 내려보내면) 각 테이블의 태블릿별 집계를 독립적으로 캐싱할 수 있습니다. 이 경우에도 별도의 제약이 적용됩니다. JOIN은 프로브 측 스캔에 런타임 필터를 내려보내므로 해당 측의 프래그먼트는 캐싱할 수 없습니다. 따라서 런타임 필터가 켜져 있으면 빌드 측만 캐싱됩니다. JOIN에 포함된 모든 테이블을 캐싱하려면 runtime_filter_mode=OFF도 설정하세요. 또는 구체화된 뷰를 사용하세요.
Q4: BE를 다시 시작한 후 캐시 워밍업이 필요한가요?
예. Query Cache는 메모리 내 캐시이므로 다시 시작하면 지워집니다. 사용량이 적은 시간대에 주요 집계 SQL을 실행하여 캐시를 미리 채울 수 있습니다.
Q5: 캐시가 실제로 적중했는지 어떻게 확인하나요?
SQL을 실행한 후 프로파일의 HitCache 필드를 확인하세요. 이 필드는 CacheSourceOperator에 있습니다.
요약
Query Cache는 중간 집계 결과를 태블릿 단위로 캐싱하는 Doris의 파이프라인 수준 최적화 메커니즘입니다. 주요 특징은 다음과 같습니다.
- 내부 OLAP 테이블의 집계 쿼리에만 적용됩니다.
- 태블릿 버전을 기준으로 캐시를 자동으로 무효화합니다.
- 파티션 조건식을 다이제스트에서 분리하여 파티션 범위가 겹치는 쿼리끼리 캐시를 공유할 수 있게 합니다.
- 항목별 크기와 행 수 제한을 제공하여 지나치게 큰 결과가 캐시 메모리를 차지하지 않도록 합니다.
- LRU-K(K=2) 축출 정책을 사용하여 유용한 캐시 항목을 유지합니다.