Prefix Index와 Sort Key
Prefix Index는 Apache Doris에 내장되어 자동으로 유지 관리되는 희소 인덱스입니다. Sort Key의 처음 36바이트를 기준으로 데이터 블록을 빠르게 찾으며, 수동으로 생성할 필요가 없습니다. 테이블 스키마를 설계할 때 적절한 Sort Key를 선택하면 WHERE 조건의 동등 조건 쿼리와 범위 쿼리 속도를 크게 높일 수 있습니다.
작동 방식
Sort Key
Apache Doris는 SSTable(Sorted String Table)과 유사한 정렬 구조로 데이터를 저장하며, 지정된 하나 이상의 컬럼을 기준으로 데이터를 정렬하여 저장할 수 있습니다. 이러한 정렬 기준 컬럼을 Sort Key라고 합니다.
데이터 모델에 따라 Sort Key를 결정하는 기준이 다릅니다.
| 데이터 모델 | Sort Key의 출처 |
|---|---|
| Aggregate | CREATE TABLE 문의 Aggregate Key |
| Unique | CREATE TABLE 문의 Unique Key |
| Duplicate | CREATE TABLE 문의 Duplicate Key |
쿼리의 WHERE 조건이 정렬 컬럼과 일치하면, Doris는 Sort Key를 사용하여 조건에 맞는 데이터 범위로 빠르게 이동할 수 있습니다. 이를 통해 전체 테이블 스캔을 피하고 탐색 복잡도를 줄여 쿼리 속도를 높입니다.
Prefix Index
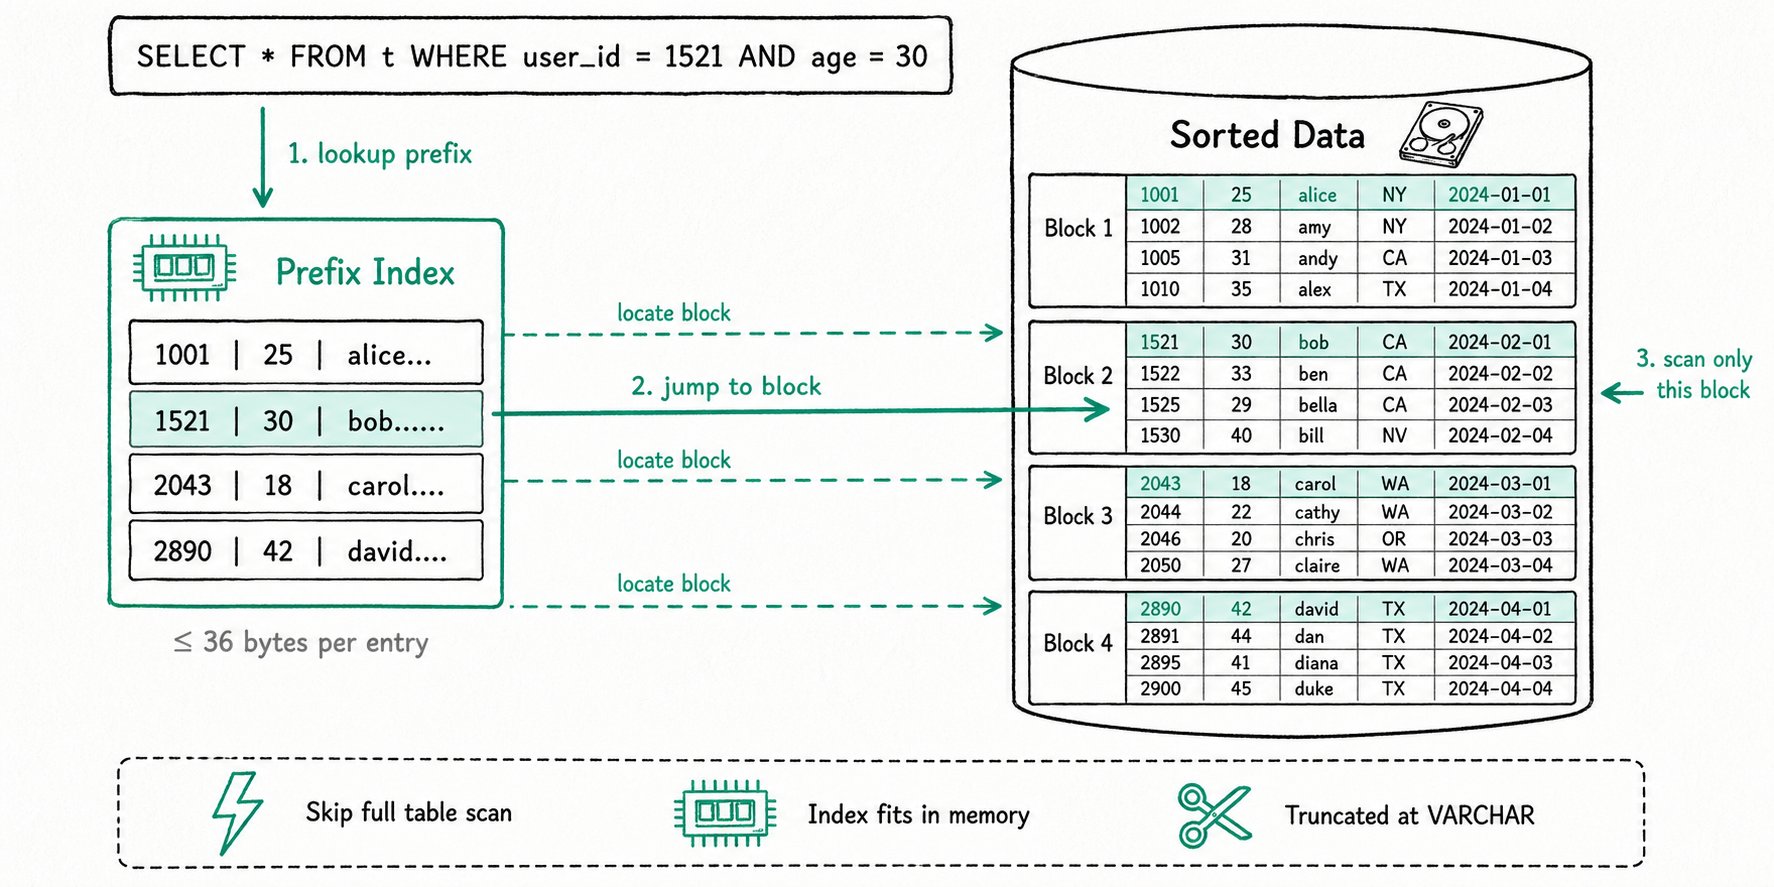
Apache Doris는 Sort Key를 기반으로 Prefix Index도 제공합니다.
- 테이블의 여러 행이 모여 하나의 논리적 데이터 블록(Data Block)을 구성합니다.
- 각 데이터 블록은 Prefix Index 테이블에 항목 하나만 저장합니다. 이 항목은 블록의 첫 번째 행에 있는 정렬 컬럼들을 이어 붙여 만든 접두사이며, 길이는 최대 36바이트입니다.
- Prefix Index는 크기가 작아 전체를 메모리에 캐시할 수 있습니다. 대상 데이터 블록의 시작 행 번호를 빠르게 찾아 쿼리 효율을 크게 높입니다.
36바이트 잘림 규칙
Prefix Index는 행의 정렬 컬럼에서 처음 36바이트를 인덱스 내용으로 사용하지만, VARCHAR 컬럼을 만나면 즉시 잘라냅니다.
- 정렬 컬럼들을 이어 붙이는 과정에서
VARCHAR컬럼에 도달하면, 36바이트를 채웠는지와 관계없이 해당 컬럼의 끝에서 잘라냅니다. - 첫 번째 컬럼 자체가
VARCHAR이면, 길이가 36바이트 미만이더라도 해당 컬럼의 끝에서 잘라내며 이후 컬럼은 Prefix Index에 추가하지 않습니다.
적용 시나리오
Prefix Index는 주로 다음과 같은 쿼리에 사용됩니다.
- 동등 조건 쿼리:
col = value,col IN (...) - 범위 쿼리:
col > value,BETWEEN ... AND ...등
WHERE 조건이 Sort Key의 접두사, 즉 첫 번째 컬럼부터 연속된 맨 왼쪽의 여러 컬럼과 일치하면 Prefix Index로 쿼리를 가속할 수 있습니다.
테이블 스키마 설계 권장 사항
테이블에는 Sort Key 정의가 하나뿐이므로, 테이블 하나에는 Prefix Index 집합도 하나만 있을 수 있습니다. 테이블을 생성할 때 선택한 Sort Key가 Prefix Index의 가속 효과를 직접 결정합니다. 다음 지침을 참고하세요.
WHERE필터 조건에 가장 자주 등장하는 컬럼을 Key 컬럼으로 우선 선택하세요.- 쿼리에서 더 자주 사용하는 컬럼을 앞에 배치하세요. Prefix Index는 맨 왼쪽 컬럼부터 연속해서 일치하는 조건에만 효과가 있습니다.
- Sort Key의 앞부분에
VARCHAR컬럼을 배치할 때는 주의하세요. 잘림 규칙이 적용되면 이후 컬럼이 Prefix Index에 포함되지 않습니다.
Sort Key를 조정해도 자주 사용하는 쿼리 조건이 Prefix Index를 활용할 수 없다면, 아래의 Prefix Index를 활용할 수 없을 때의 대안을 참고하세요.
사용 예제
예제 1: 잘림이 없는 Prefix Index
다음 Sort Key의 Prefix Index는 user_id (8 Bytes) + age (4 Bytes) + message (first 20 Bytes)이며, 총 32바이트입니다.
| 컬럼명 | 타입 |
|---|---|
| user_id | BIGINT |
| age | INT |
| message | VARCHAR(100) |
| max_dwell_time | DATETIME |
| min_dwell_time | DATETIME |
예제 2: 첫 번째 컬럼이 VARCHAR여서 잘림이 발생하는 경우
다음 Sort Key의 Prefix Index에는 user_name (20 Bytes)만 포함됩니다. 전체 길이가 36바이트에 도달하지 않았더라도 첫 번째 컬럼이 VARCHAR이므로 즉시 잘라내며, 이후 컬럼은 Prefix Index에 추가하지 않습니다.
| 컬럼명 | 타입 |
|---|---|
| user_name | VARCHAR(20) |
| age | INT |
| message | VARCHAR(100) |
| max_dwell_time | DATETIME |
| min_dwell_time | DATETIME |
예제 3: Prefix Index를 활용하는 쿼리와 활용하지 못하는 쿼리
예제 1의 테이블 스키마를 기준으로 살펴보겠습니다.
-
Prefix Index를 활용하는 경우(조건이 맨 왼쪽의 정렬 컬럼 두 개를 포함하므로 효율이 높습니다):
SELECT * FROM table WHERE user_id = 1829239 AND age = 20; -
Prefix Index를 활용하지 못하는 경우(조건에서
user_id를 건너뛰므로 접두사를 사용하여 데이터 위치를 찾을 수 없습니다):SELECT * FROM table WHERE age = 20;
따라서 테이블을 생성할 때 컬럼 순서를 올바르게 선택하면 쿼리 효율을 크게 높일 수 있습니다.
인덱스 효과 확인
Prefix Index는 쿼리를 가속할 수 있을 때 자동으로 적용되며, 별도의 구문이 필요하지 않습니다. 쿼리 프로파일의 다음 지표로 가속 효과를 확인할 수 있습니다.
| 지표 | 의미 |
|---|---|
RowsKeyRangeFiltered | Prefix Index로 걸러낸 행 수입니다. 다른 Rows* 지표와 비교하여 인덱스의 필터링 효과를 평가할 수 있습니다. |
Prefix Index를 활용할 수 없을 때의 대안
자주 사용하는 쿼리 조건이 Prefix Index를 활용할 수 없는 경우, 예를 들어 자주 사용하는 필터 컬럼이 Sort Key의 접두사에 해당하지 않는 경우에는 다음 두 가지 방법을 고려하세요.
- 역색인 생성: 테이블에는 여러 역색인을 생성할 수 있으므로, 서로 다른 쿼리 조건에서 사용하는 컬럼들을 유연하게 지원할 수 있습니다.
- 단일 테이블 구체화된 뷰(Duplicate 모델) 사용: 컬럼 순서가 다르고 강력한 일관성을 보장하는 단일 테이블 동기식 구체화된 뷰를 생성하면, 간접적으로 여러 Prefix Index 집합을 구성할 수 있습니다.
자주 묻는 질문
Q1: Prefix Index를 수동으로 생성해야 하나요?
아니요. 테이블을 생성하면 Doris가 자동으로 Sort Key의 처음 36바이트를 Prefix Index로 사용합니다. 이를 위한 전용 DDL 구문은 없습니다.
Q2: 하나의 테이블에 여러 Prefix Index 집합을 구성할 수 있나요?
아니요. Sort Key는 하나뿐이므로 테이블에는 Prefix Index 집합도 하나만 있을 수 있습니다. 여러 집합이 필요하다면 역색인이나 구체화된 뷰를 사용하세요.
Q3: Prefix Index가 예상보다 훨씬 짧은 이유는 무엇인가요?
가장 흔한 이유는 Sort Key의 앞부분에 VARCHAR 컬럼이 있어 잘림 규칙이 적용되기 때문입니다. Sort Key의 앞부분에는 고정 길이 타입(예: BIGINT, INT, DATETIME, TIMESTAMP_NS)을 배치하세요.
Q4: Prefix Index로 LIKE 쿼리나 텍스트 검색을 가속할 수 있나요?
아니요. LIKE 유사 일치 검색에는 NGram BloomFilter Index를, 전문 검색에는 역색인을 사용하세요.