성능 테스트를 뒷받침하는 최적화
개요
Apache Doris는 2.x의 역색인 기반 텍스트 검색에서 3.x의 스토리지와 컴퓨팅 분리를 거쳐, 이제 4.x의 벡터 인덱싱 기능으로 발전하며 본격적으로 AI 데이터 분석 시대에 진입했습니다. 이 글은 다음 독자를 대상으로 합니다.
- Doris 4.x 벡터 인덱싱이 업계 최고 수준의 성능을 달성하는 이유를 이해하려는 아키텍트와 개발자.
- 벡터 데이터베이스를 평가하면서 Doris와 전용 벡터 데이터베이스 간 성능 차이가 어디에서 비롯되는지 이해해야 하는 기술 의사결정자.
- Doris에서 ANN 검색을 튜닝하려는 운영 및 성능 엔지니어.
이 글은 벡터 검색의 두 가지 주요 단계를 중심으로 구성되어 있습니다.
| 단계 | 핵심 목표 | 주요 최적화 |
|---|---|---|
| 인덱싱 단계 | 품질을 유지하면서 인덱스 구축 속도 향상 | 다단계 샤딩, 이중 병렬화, SIMD 거리 계산 |
| 쿼리 단계 | 높은 동시성에서도 P99 지연 시간 제어 | Prepare Statement, Index Only Scan, 가상 컬럼, Scan 병렬화, 전역 TopN 지연 구체화 |
인덱싱 단계
인덱싱 단계의 성능은 인덱스 하이퍼파라미터와 밀접한 관계가 있습니다. 품질이 높을수록 구축 속도는 느려집니다. Doris는 데이터 적재 경로를 최적화하여 높은 인덱스 품질을 유지하면서도 적재 처리량을 크게 향상합니다.
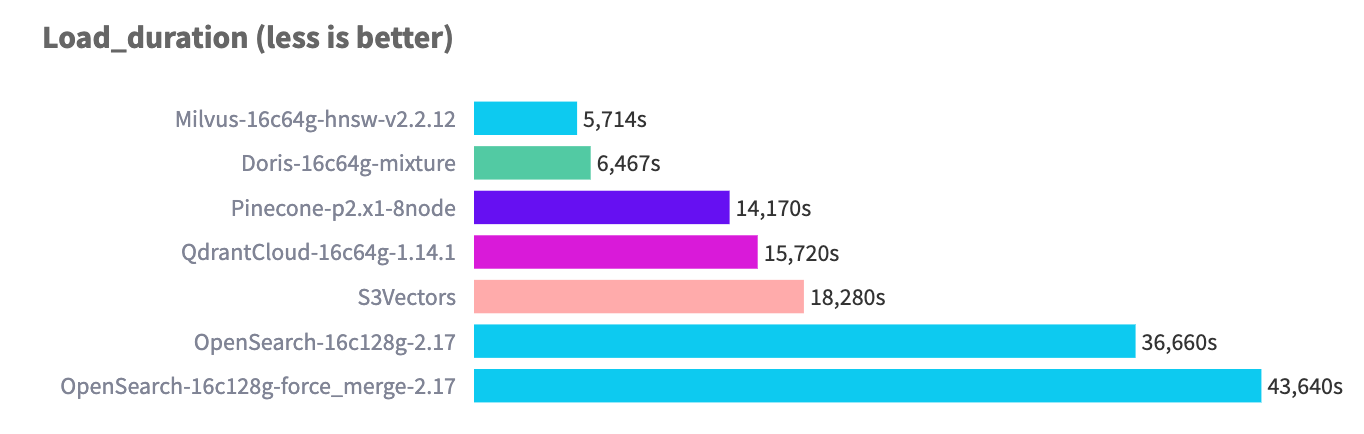
768차원, 10M행 규모에서 Doris의 적재 성능은 업계 최고 수준에 도달합니다.
다단계 샤딩
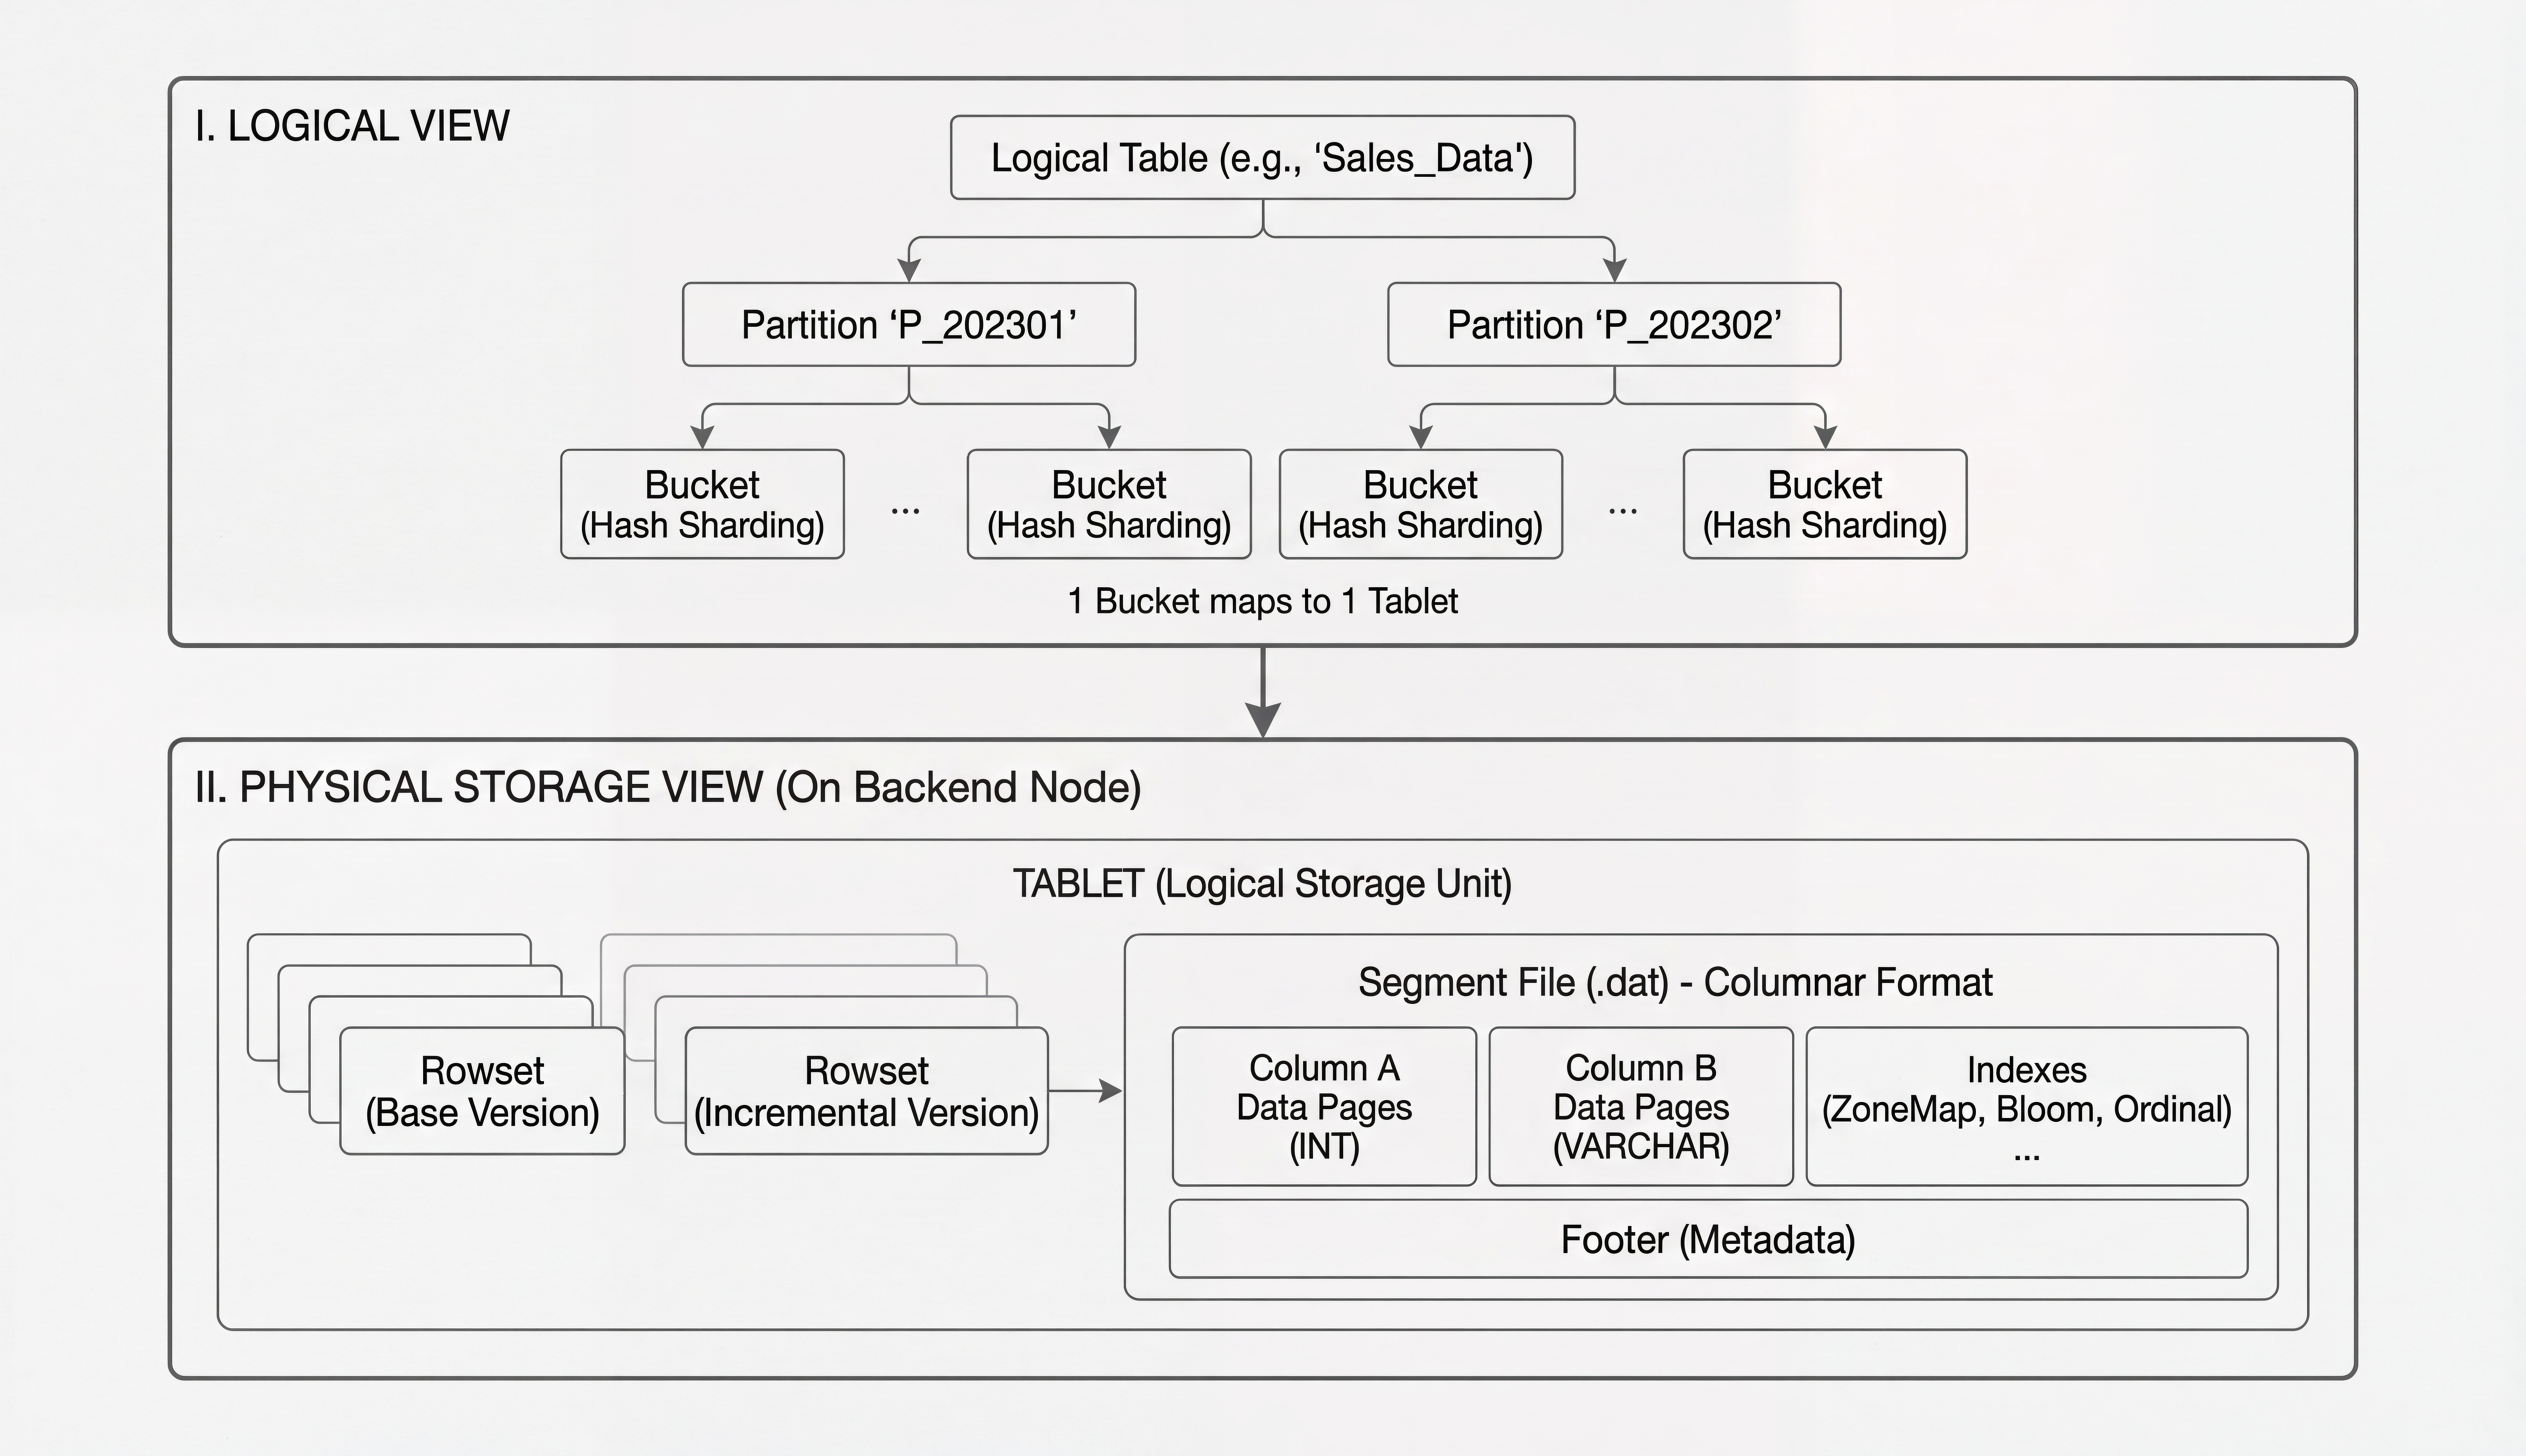
Doris 내부 테이블은 기본적으로 분산 구조입니다. 사용자는 쿼리하거나 데이터를 적재할 때 하나의 논리 테이블(Table)만 인식합니다. 반면 Doris 커널은 테이블 정의에 따라 물리 샤드를 자동으로 생성하고, 파티션 키와 버킷 키를 기준으로 BE의 해당 tablet으로 데이터를 라우팅합니다.
각 계층 간의 관계는 다음과 같습니다.
| 계층 | 역할 |
|---|---|
| Table | 사용자가 인식하는 논리 테이블 |
| Tablet | 수량 요건을 충족하는 물리 샤드 |
| Rowset | tablet에서 각 적재 트랜잭션이 생성하는 버전 관리 단위 |
| Segment | rowset 아래에서 실제 데이터를 담는 파일. ANN 인덱스는 segment 단위로 동작합니다 |
HNSW와 같은 벡터 인덱스는 몇 가지 핵심 하이퍼파라미터에 의존합니다. 이 매개변수들은 인덱스 품질과 쿼리 성능을 직접 결정하며, 일반적으로 일정한 데이터 규모에서만 이상적인 결과를 얻을 수 있습니다.
Doris의 다단계 샤딩은 "인덱스 매개변수"와 "테이블의 전체 데이터 규모"를 분리합니다. 사용자는 전체 데이터 양이 늘어났다는 이유로 인덱스를 다시 구축할 필요가 없습니다. 각 적재 배치의 크기와 그에 맞는 매개변수 설정에만 집중하면 됩니다.
측정 결과를 바탕으로, 배치 크기별 HNSW 인덱스의 경험적 매개변수는 다음과 같습니다.
| batch_size | max_degree | ef_construction | ef_search | recall@100 |
|---|---|---|---|---|
| 250000 | 100 | 200 | 50 | 89% |
| 250000 | 100 | 200 | 100 | 93% |
| 250000 | 100 | 200 | 150 | 95% |
| 250000 | 100 | 200 | 200 | 98% |
| 500000 | 120 | 240 | 50 | 91% |
| 500000 | 120 | 240 | 100 | 94% |
| 500000 | 120 | 240 | 150 | 96% |
| 500000 | 120 | 240 | 200 | 99% |
| 1000000 | 150 | 300 | 50 | 90% |
| 1000000 | 150 | 300 | 100 | 93% |
| 1000000 | 150 | 300 | 150 | 96% |
| 1000000 | 150 | 300 | 200 | 98% |
즉, 사용자는 "각 적재 배치의 데이터 양"에만 집중하고 그에 맞는 인덱스 매개변수를 선택하면, 인덱스 품질을 보장하면서 안정적인 쿼리 성능을 얻을 수 있습니다.
고성능 인덱스 구축
병렬 처리를 통한 고품질 인덱스 구축
Doris는 "이중 병렬화"로 인덱스 구축 속도를 높입니다.
- 클러스터 수준 병렬화: 여러 BE 노드에서 병렬로 구축합니다.
- 노드 내부 병렬화: 각 BE 내에서 동일 배치의 데이터를 그룹으로 묶고 멀티스레드로 거리를 계산하여 인덱스 자료구조의 구축 속도를 높입니다.
Doris는 속도를 높이는 동시에 메모리 내 배치 처리로 인덱스 품질도 개선합니다. 전체 벡터 수가 일정하더라도 배치가 너무 작아 인덱스에 데이터를 지나치게 자주 추가하면, 그래프 구조가 희소해지고 재현율이 떨어지는 경향이 있습니다.
예를 들어, 768D / 10M 벡터 데이터의 경우:
- 10개 배치로 인덱스를 구축하면 약 99%의 재현율을 얻습니다.
- 100개 배치로 인덱스를 구축하면 재현율이 약 95%로 떨어질 수 있습니다.
메모리 내 배치 처리를 통해 Doris는 동일한 하이퍼파라미터에서 메모리 사용량과 그래프 품질의 균형을 더 잘 맞추고, 지나치게 잘게 나눈 배치로 인한 품질 저하를 방지할 수 있습니다.
SIMD 거리 계산
ANN 인덱스 구축에서 가장 큰 비용은 대규모 거리 계산이며, 이는 전형적인 CPU 집약적 작업입니다. Doris는 이 계산을 BE 노드에 집중시킵니다. 관련 구현은 C++로 작성되었으며, Faiss의 자동 및 수동 벡터화 최적화를 최대한 활용합니다.
L2 거리를 예로 들면, Faiss는 컴파일러 지시문 매크로를 통해 자동 벡터화를 활성화합니다.
FAISS_PRAGMA_IMPRECISE_FUNCTION_BEGIN
float fvec_L2sqr(const float* x, const float* y, size_t d) {
    size_t i;
    float res = 0;
    FAISS_PRAGMA_IMPRECISE_LOOP
    for (i = 0; i < d; i++) {
        const float tmp = x[i] - y[i];
        res += tmp * tmp;
    }
    return res;
}
FAISS_PRAGMA_IMPRECISE_FUNCTION_END
FAISS_PRAGMA_IMPRECISE_* 매크로는 컴파일러가 자동 벡터화를 수행하도록 유도합니다.
#define FAISS_PRAGMA_IMPRECISE_LOOP \
    _Pragma("clang loop vectorize(enable) interleave(enable)")
동시에 Faiss는 _mm* / _mm256* / _mm512* 명령어를 #ifdef SSE3/AVX2/AVX512F 조건부 블록 안에서 사용하여 명시적 벡터화를 수행합니다. 여기에 L2와 내적의 원소별 연산을 각각 구현하는 ElementOpL2 / ElementOpIP 템플릿과 차원별 특수화인 fvec_op_ny_D{1,2,4,8,12}를 결합하여 다음을 구현합니다.
- 여러 샘플(예: 8개 또는 16개)을 배치 처리하고, 레지스터 내 행렬 전치(예:
transpose_8x2/16x4/...)를 통해 메모리 접근 지역성을 높입니다. - 곱셈과 덧셈을 융합하는 FMA 명령어(예:
_mm512_fmadd_ps)로 명령어 수를 줄입니다. - 수평 합산으로 스칼라 결과를 빠르게 산출합니다.
- 마스킹된 분기로 4/8/16 단위에 맞지 않는 나머지 원소를 처리합니다.
이러한 최적화는 거리 계산의 명령어 및 메모리 접근 오버헤드를 효과적으로 줄여 인덱스 구축 처리량을 크게 향상합니다.
쿼리 단계
검색 시나리오는 지연 시간에 매우 민감합니다. 수천만 행의 데이터와 높은 쿼리 동시성을 처리할 때는 일반적으로 P99 지연 시간을 500 ms 미만으로 유지해야 합니다. 따라서 Doris 옵티마이저, 실행 엔진, 인덱스 구현에 더 높은 요구사항이 적용됩니다.
기본 설정으로 수행한 테스트에서 Doris의 쿼리 성능은 업계의 주요 전용 벡터 데이터베이스 수준에 도달했습니다. 아래 그림은 Performance768D10M 데이터셋에서 Doris와 벡터 검색 기능을 갖춘 다른 데이터베이스를 비교한 것입니다. 다른 데이터베이스의 데이터는 Zilliz의 오픈 소스 VectorDBBench 프레임워크에서 가져왔습니다.
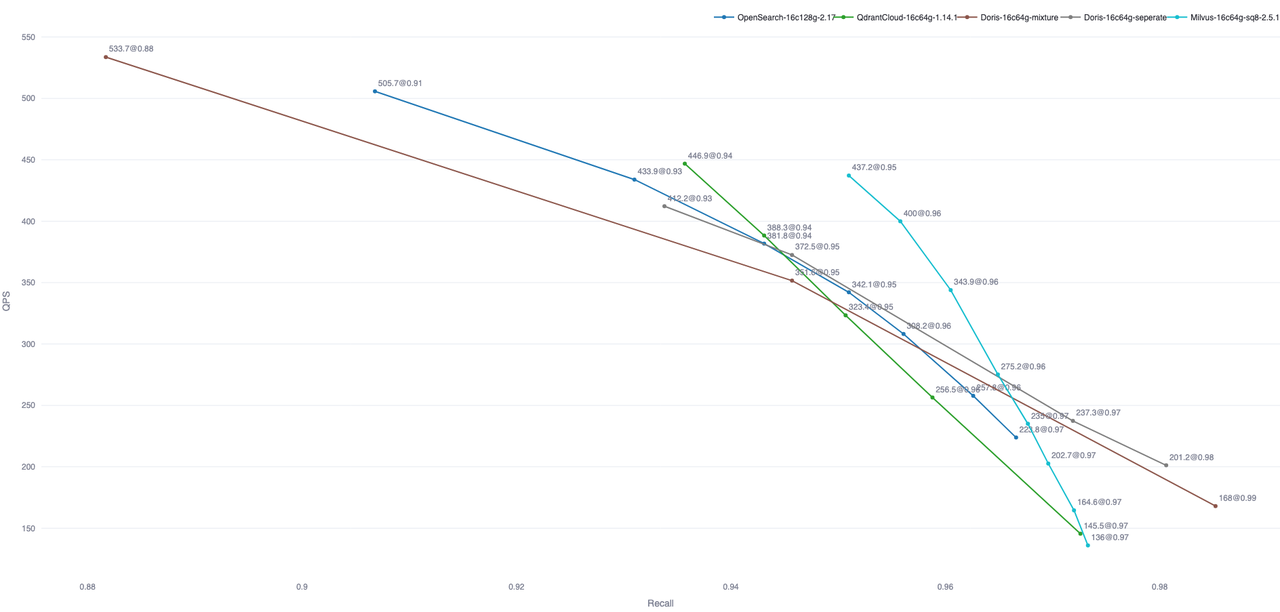
참고: 이 그림에는 일부 데이터베이스의 기본 설정 테스트 결과만 포함되어 있습니다. OpenSearch와 Elastic Cloud는 인덱스 파일 수를 최적화하여 쿼리 성능을 더 높일 수 있습니다.
쿼리 단계의 최적화는 중복 계산과 불필요한 디스크 IO를 제거하고 동시 처리 성능을 극대화한다는 핵심 목표를 중심으로 이루어집니다. 구체적인 기법은 다음과 같습니다.
Prepare Statement
기존 실행 경로에서 Doris는 모든 SQL 문에 대해 전체 최적화 과정(구문 분석, 의미 분석, RBO, CBO)을 수행합니다. 이는 일반적인 OLAP 시나리오에서는 필수적이지만, 검색처럼 단순하고 반복적인 쿼리 패턴에서는 상당한 추가 오버헤드를 발생시킵니다.
Doris 4.0은 Prepare Statement를 확장하여 포인트 쿼리뿐 아니라 벡터 검색을 포함한 모든 SQL 유형을 지원합니다. 핵심 아이디어는 다음과 같습니다.
- 컴파일과 실행 분리
- Prepare 단계에서 구문 분석, 의미 분석, 최적화를 한 번 수행하고 재사용 가능한 Logical Plan을 생성합니다.
- Execute 단계에서는 실제 매개변수만 바인딩하고 생성된 계획을 바로 실행하므로 옵티마이저를 완전히 건너뜁니다.
- Plan Cache
- 계획의 재사용 가능 여부는 SQL 지문(정규화된 SQL + 스키마 버전)으로 결정합니다.
- 매개변수 값이 달라도 구조가 같으면 계획을 바로 재사용할 수 있어 반복 최적화를 피할 수 있습니다.
- 스키마 버전 검증
- 실행 시 테이블 스키마 버전을 확인하여 계획의 정확성을 보장합니다.
- 스키마가 변경되지 않았으면 계획을 바로 재사용합니다. 변경되었으면 계획을 자동으로 무효화하고 다시 준비합니다.
- 옵티마이저를 건너뛰어 속도 대폭 향상
- Execute는 더 이상 RBO/CBO를 실행하지 않으므로 옵티마이저에 소요되는 시간이 거의 완전히 제거됩니다.
- 벡터 검색처럼 템플릿화된 쿼리에서는 Prepare가 종단 간 지연 시간을 크게 줄일 수 있습니다.
Index Only Scan
Doris의 벡터 인덱스는 부속 인덱스로 구현됩니다. 부속 인덱스는 관리하기 쉽고 비동기 구축도 용이하지만, 중복 계산과 불필요한 IO를 어떻게 피할 것인가라는 성능 과제도 수반합니다.
ANN 인덱스는 일치하는 행 ID뿐 아니라 벡터 간 거리도 반환할 수 있습니다. 실행 엔진은 이 추가 정보를 효율적으로 활용하기 위해 Scan 연산자의 거리 관련 표현식을 "조기에 단락 평가"합니다. Doris는 "가상 컬럼" 메커니즘으로 이 단락 평가를 자동으로 수행하고, Ann Index Only Scan을 사용하여 거리 계산과 관련된 읽기 IO를 완전히 제거합니다.
기본 처리 흐름: Scan이 조건자를 인덱스로 푸시다운하면 인덱스가 행 ID를 반환합니다. Scan은 행 ID로 데이터 페이지를 읽은 다음 표현식을 계산하고 N행의 결과를 상위 연산자에 반환합니다.
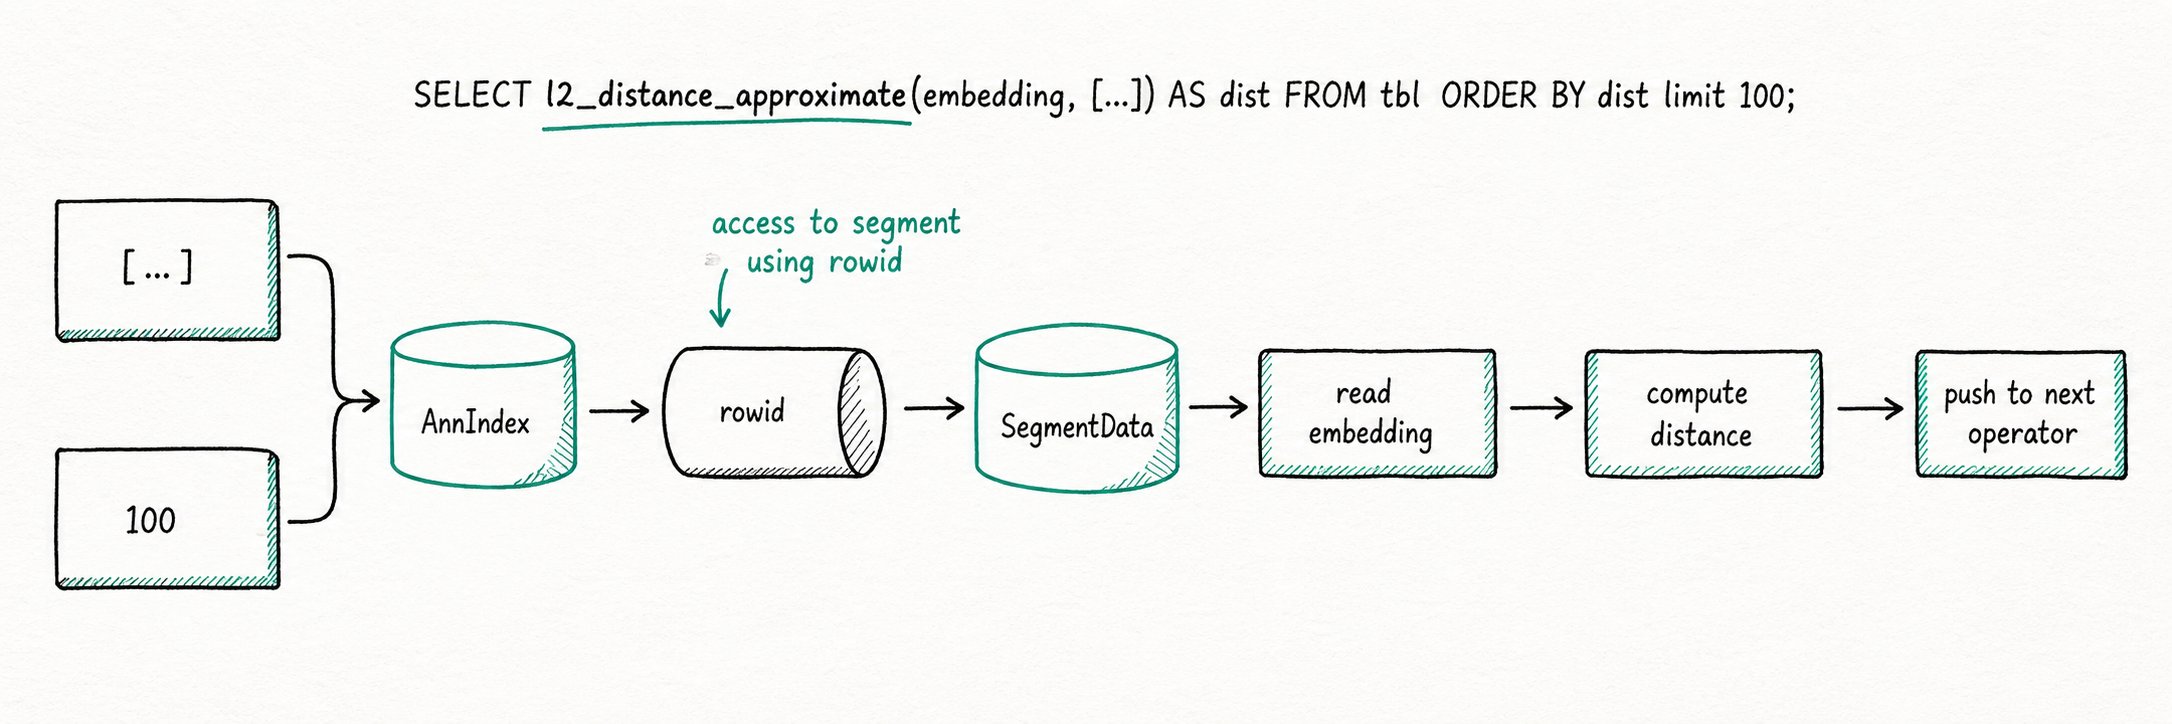
Index Only Scan 적용 후:
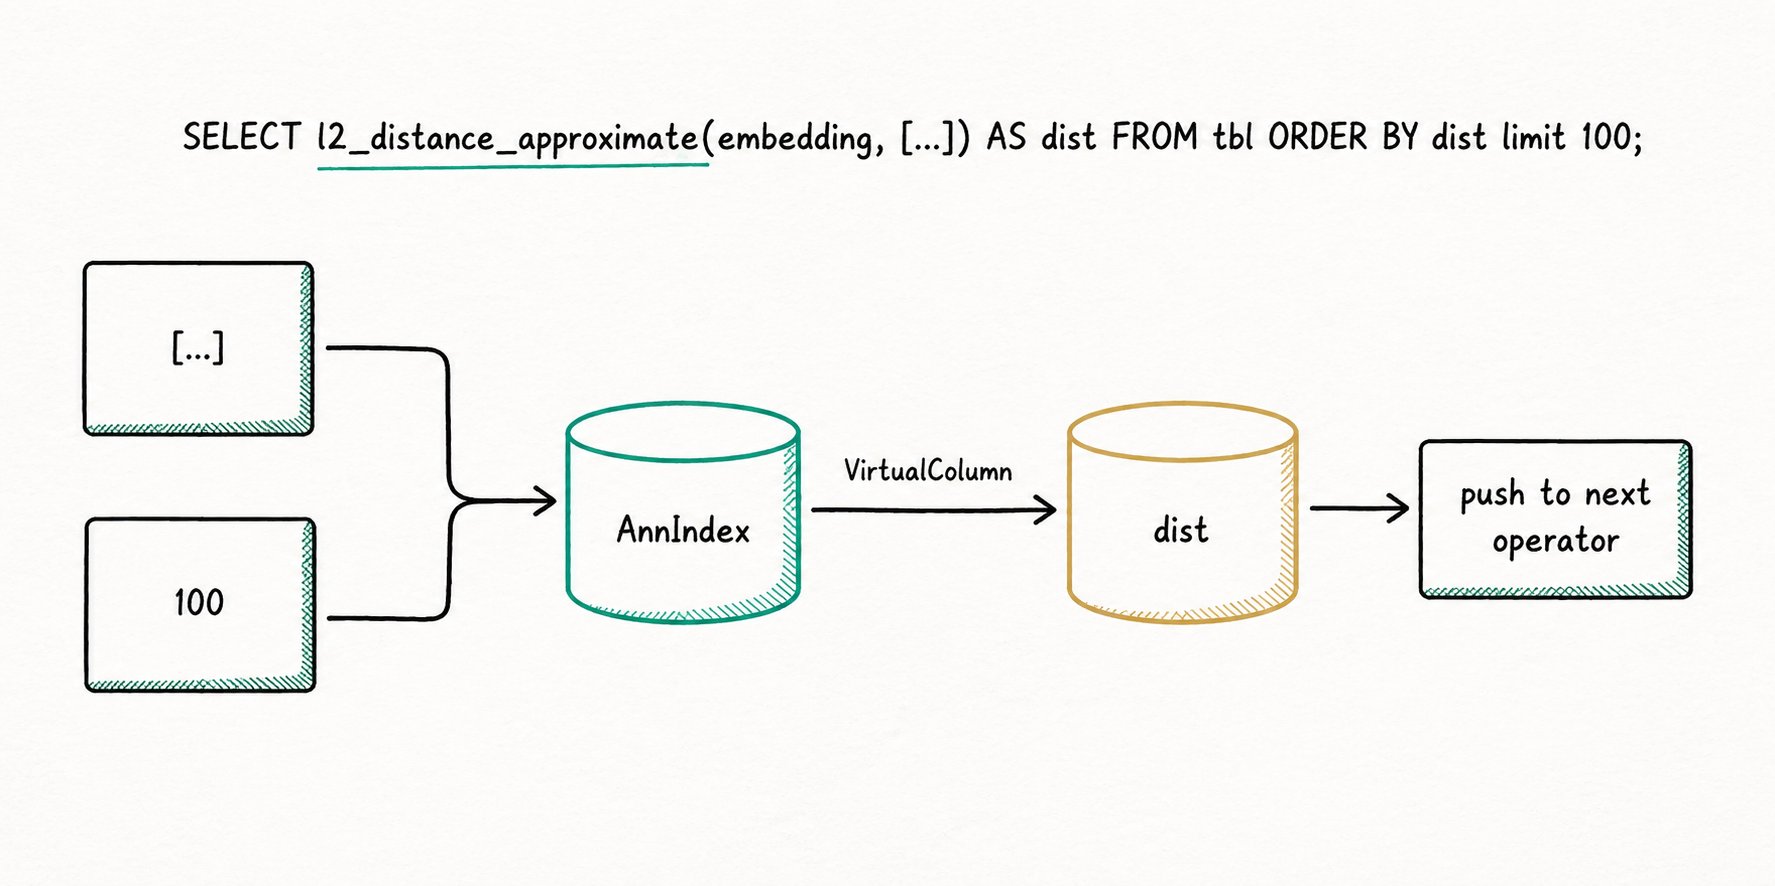
예를 들면 다음과 같습니다.
SELECT l2_distance_approximate(embedding, [...]) AS dist
FROM tbl
ORDER BY dist
LIMIT 100;
이 실행 과정에서는 더 이상 데이터 파일 IO가 발생하지 않습니다.
Index Only Scan이 지원하는 쿼리 유형
Ann TopN Search 외에도 인덱스 가속을 지원하는 Range Search와 Compound Search에 유사한 최적화가 적용됩니다. Range Search는 TopN보다 복잡합니다. 비교 방식에 따라 인덱스가 dist를 반환할 수 있는지가 달라집니다. 아래 표는 Ann Index Only Scan과 관련된 쿼리 유형을 정리한 것입니다.
| 번호 | 패턴 | IndexScan 사용 여부 | 핵심 이유 |
|---|---|---|---|
| Sql1 | Range + proj, dist <= 10 | True | 인덱스가 dist를 반환할 수 있으며, cse용 가상 컬럼이 proj에서 dist를 다시 계산하지 않도록 함 |
| Sql2 | Range + no-proj, dist <= 10 | True | 인덱스가 dist를 반환할 수 있음 |
| Sql3 | Range + proj, dist > 10 | False | 인덱스가 dist를 반환할 수 없고 proj에 dist가 필요하므로 embedding을 다시 읽어야 함 |
| Sql4 | Range + proj, dist > 10, proj에 dist가 필요하지 않음 | True | proj에 dist가 필요하지 않으므로 embedding을 다시 읽을 필요가 없음 |
| Sql5 | TopN | True | 인덱스가 dist를 반환하고 가상 슬롯이 proj로 전달됨 |
| Sql6 | TopN + IndexFilter | True | comment 컬럼은 이미 역색인 스캔으로 최적화되었으며 embedding을 읽지 않음 |
| Sql7 | TopN + Range | True | Sql1과 Sql5의 조합 |
| Sql8 | TopN + Range + IndexFilter | True | Sql6과 Sql7의 조합 |
| Sql9 | TopN + Range + CommonFilter (dist < 10) | False | 잔여 일반 필터로 인해 embedding이 여전히 구체화됨(ROI가 낮아 현재 최적화하지 않음) |
| Sql10 | Sql9의 변형 (dist > 10) | False | 인덱스가 embedding을 반환할 수 없으므로 abs를 계산하려면 embedding을 구체화해야 함 |
| Sql11 | Sql9의 변형 (array_size(embedding) > 10) | False | array_size로 인해 embedding을 반드시 구체화해야 함 |
자세한 주석을 포함한 전체 SQL은 다음과 같습니다.
-- Sql1
-- Range + proj
-- The Ann index can return dist, so dist does not need to be computed again.
-- At the same time, virtual column for cse avoids the dist computation in proj.
-- IndexScan: True
select id, dist(embedding, [...]) from tbl where dist <= 10;

-- Sql2
-- Range + no-proj
-- The Ann index can return dist, so dist does not need to be computed again.
-- IndexScan: True
select id from tbl where dist <= 10 order by id limit N;

-- Sql3
-- Range + proj + no-dist-from index
-- The Ann index cannot return dist (the index can only update the rowid map).
-- Since proj requires dist to be returned, embedding must be re-read.
-- IndexScan: False
select id, dist(embedding, [...]) from tbl where dist > 10;

-- Sql4
-- Range + proj + no-dist-from index
-- The Ann index cannot return dist (the index can only update the rowid map).
-- However, proj does not need dist, so embedding does not need to be re-read.
-- IndexScan: True
select id from tbl where dist > 10;

-- Sql5
-- TopN
-- AnnIndex returns dist, and virtual slot for cse ensures that the dist from the index is passed up to proj,
-- so the embedding column does not need to be read.
-- IndexScan: True
select id[, dist(embedding, [...])] from tbl order by dist(embedding, [...]) asc limit N;

-- Sql6
-- TopN + IndexFilter
-- 1. The comment column does not need to be read; the inverted index scan has already done this optimization.
-- 2. The embedding column does not need to be read, for the same reason as Sql5.
-- IndexScan: True
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql7
-- TopN + Range
-- IndexScan: True, because this is a combination of Sql1 and Sql5.
select id[, dist(embedding, [...])] from tbl where dist(embedding, [...]) > 10 order by dist(embedding, [...]) limit N;

-- Sql8
-- TopN + Range + IndexFilter
-- IndexScan: True, because this is a combination of Sql7 and Sql6.
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql9
-- TopN + Range + CommonFilter
-- The key points here: 1. dist < 10, not dist > 10; 2. the common filter does not read embedding directly, but reads dist.
-- The Ann index can return dist, and virtual slot ref for cse ensures that all reads of dist refer to the same column.
-- In this case, although Ann TopN cannot be applied, in theory the embedding column does not need to be materialized at any point.
-- However, in practice, embedding is still materialized, because whether a column can skip reading is currently judged by whether predicates on this column still have residuals;
-- the common filter itself cannot be eliminated, so the current code still considers it necessary to materialize the column.
-- The ROI of this optimization is low, so it is not done.
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) < 10 AND abs(dist(embedding) + 10) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql10
-- A variant of Sql9: dist < 10 becomes dist > 10. In this case the index cannot return embedding,
-- so embedding must be materialized in order to compute abs(dist(embedding, [...])).
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) > 10 AND abs(dist(embedding) + 10) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql11
-- A variant of Sql9: abs(dist(embedding) + 10) > 10 becomes array_size(embedding) > 10. The difference is that array_size forces embedding to be materialized.
-- To compute array_size(embedding, [...]), embedding must be materialized.
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) < 10 AND array_size(embedding) > 10 ORDER BY dist(embedding, [...]) LIMIT N;
공통 부분식 최적화를 위한 가상 컬럼
Index Only Scan은 주로 IO 문제를 해결하며 embedding에 대한 대량의 임의 읽기를 방지합니다. Doris는 중복 계산까지 제거하기 위해 계산 계층에 "가상 컬럼" 메커니즘을 도입하여, 인덱스가 반환한 dist를 컬럼 형태로 표현식 실행기에 전달합니다.
가상 컬럼의 핵심 설계 사항은 다음과 같습니다.
- 표현식 노드
VirtualSlotRef를 도입하여, 특정 표현식에 의해 구체화되고 여러 표현식이 공유할 수 있는 특수한 "런타임 계산" 컬럼을 나타냅니다. 이 컬럼은 처음 사용할 때 한 번만 계산되므로 Projection과 조건자 사이의 공통 부분식(CSE) 중복을 제거합니다. - 컬럼 반복자
VirtualColumnIterator를 도입하여 인덱스가 반환한 거리를 표현식에서 사용할 수 있도록 구체화하고, 중복된 거리 함수 계산을 방지합니다.
이 메커니즘은 처음에는 ANN 관련 쿼리의 CSE 제거에 사용되었으며, 이후 일반적인 Projection + Scan + Filter 조합으로 확장되었습니다.
측정 결과
ClickBench 데이터셋을 기반으로 Google에서 유입된 클릭 수가 가장 많은 상위 20개 웹사이트를 집계합니다.
set experimental_enable_virtual_slot_for_cse=true;

SELECT counterid,
       COUNT(*)               AS hit_count,
       COUNT(DISTINCT userid) AS unique_users
FROM   hits
WHERE  ( UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) = 'GOOGLE.COM'
         OR UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) = 'GOOGLE.RU'
         OR UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) LIKE '%GOOGLE%' )
       AND ( LENGTH(regexp_extract(referer, '^https?://([^/]+)', 1)) > 3
              OR regexp_extract(referer, '^https?://([^/]+)', 1) != ''
              OR regexp_extract(referer, '^https?://([^/]+)', 1) IS NOT NULL )
       AND eventdate = '2013-07-15'
GROUP  BY counterid
HAVING hit_count > 100
ORDER  BY hit_count DESC
LIMIT  20;
핵심 표현식인 regexp_extract(referer, '^https?://([^/]+)', 1)은 CPU 집약적이며 여러 곳에서 재사용됩니다. 가상 컬럼 최적화의 활성화 여부에 따른 비교 결과는 다음과 같습니다.
| 상태 | 소요 시간 |
|---|---|
| 최적화 비활성화 | 1.50 s |
최적화 활성화 (set experimental_enable_virtual_slot_for_cse=true) | 0.57 s |
종단 간 성능이 약 3배 향상됩니다.
Scan 병렬화 최적화
Doris는 Ann TopN Search에 맞춰 Scan 병렬화 전략을 재설계했습니다.
| 항목 | 기존 전략 | 새 전략 |
|---|---|---|
| 병렬화 기준 | 행 수(기본값: 2,097,152행 / Scan Task) | segment마다 정확히 하나의 Scan Task 생성 |
| 고차원 벡터 시나리오에서의 동작 | 단일 segment의 행 수가 임계값보다 훨씬 적어 여러 segment를 직렬로 스캔 | 인덱스 분석 단계에서 병렬성 향상 |
| 테이블 조회의 영향 | - | Ann TopN은 필터링 비율이 높으므로 직렬 테이블 조회가 전체 성능에 영향을 주지 않음 |
SIFT 1M을 예로 들면, set optimize_index_scan_parallelism=true;를 활성화한 후 직렬 TopN 쿼리의 소요 시간이 230 ms에서 50 ms로 줄어듭니다.
또한 4.0에서는 "동적 병렬성 조정"을 도입했습니다. 각 스케줄링 라운드 전에 Scan 스레드 풀의 부하를 기준으로 제출 가능한 작업 수를 동적으로 결정합니다. 부하가 높으면 병렬성을 낮추고, 리소스가 유휴 상태이면 병렬성을 높여 직렬 및 높은 동시성 시나리오 모두에서 리소스 활용도와 스케줄링 오버헤드의 균형을 맞춥니다.
전역 TopN 지연 구체화
일반적인 Ann TopN 쿼리는 두 단계로 구성됩니다.
- 첫 번째 단계: Scan 연산자가 인덱스를 통해 각 segment의 TopN 거리를 가져옵니다.
- 두 번째 단계: 전역 정렬 노드가 segment별 TopN을 병합하고 정렬하여 최종 TopN을 얻습니다.
프로젝션이 여러 컬럼을 반환하거나 String과 같은 큰 컬럼을 포함하면, 첫 번째 단계에서 각 segment로부터 읽은 N행이 많은 디스크 IO를 유발할 수 있습니다. 또한 이 행들은 최종 TopN에 포함되지 않아 두 번째 단계의 전역 정렬에서 버려질 수 있습니다. Doris는 "전역 TopN 지연 구체화"를 사용하여 첫 번째 단계의 읽기 양을 최소화합니다.
다음 예를 살펴보겠습니다.
SELECT id, l2_distance_approximate(embedding, [...]) AS dist
FROM tbl
ORDER BY dist
LIMIT 100;
실행 흐름:
- 첫 번째 단계: 각 segment가 Ann Index Only Scan + 가상 컬럼을 사용하여 100개의
dist값과 해당rowid만 출력합니다. - 두 번째 단계: 전체 segment 수가 M이면,
100 * M개의dist값을 전역 정렬하여 최종 TopN과 해당rowid를 얻습니다. - 마지막으로 Materialize 연산자가 이
rowid를 기반으로 해당 tablet/rowset/segment에서 필요한 컬럼을 구체화합니다.