성능 테스트 및 분석
이 문서는 Apache Doris 벡터 인덱스(ANN Index)의 쿼리 및 데이터 적재 성능 벤치마크 결과를 소개합니다. 모든 테스트는 VectorDBBench로 수행했으며, 결과는 다음과 같은 작업에 도움이 됩니다.
- Doris 벡터 검색이 비즈니스 요구 사항을 충족하는지 평가합니다.
- 재현율, 쿼리 성능, 데이터 적재 속도 사이의 절충 관계를 이해합니다.
- 로컬에서 테스트 결과를 재현하고 프로덕션 환경에서의 동작을 검증합니다.
단일 노드 및 분산 배포 환경에서 더 큰 데이터셋(10M / 100M 규모)을 대상으로 수행한 벤치마크 결과는 대규모 성능 벤치마크를 참조하세요.
테스트 환경
| 항목 | 구성 |
|---|---|
| 머신 사양 | 16C 64GB |
| CPU 모델 | Intel(R) Xeon(R) Platinum 8369B CPU @ 2.70GHz |
| 배포 방식 | FE와 BE를 동일한 머신에 배치 |
| Doris 버전 | Apache Doris 4.0.2 |
| 테스트 데이터셋 | VectorDBBench Performance768D1M (768차원 벡터, 1백만 행) |
FE와 BE를 동일한 머신에 배치하는 방식은 프로덕션 환경에서 권장되지 않습니다. 프로덕션 환경에서는 FE와 BE를 별도의 머신에 배포하세요.
테스트 결과
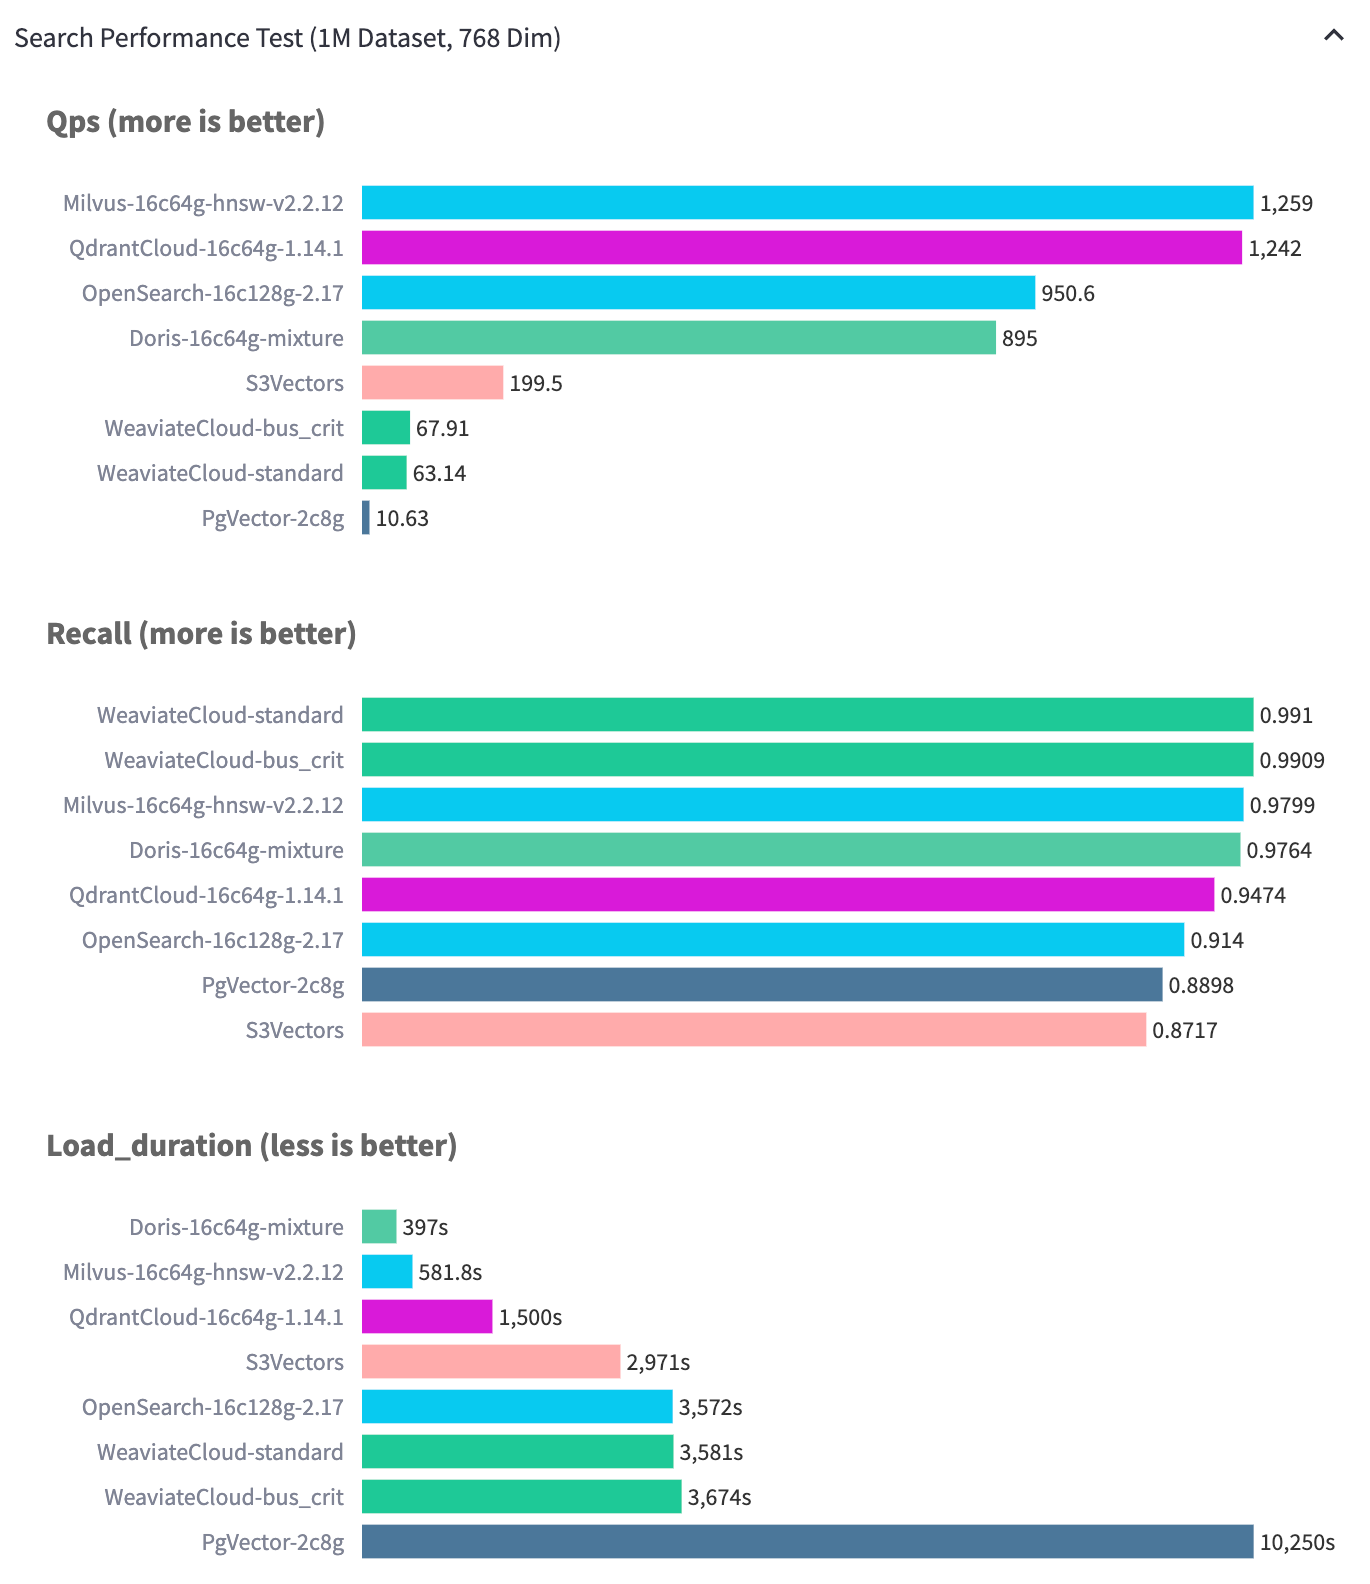
Performance768D1M 데이터셋에서 Apache Doris는 97%를 넘는 재현율을 유지하면서 989.1 QPS를 달성하며, 데이터 적재 성능도 유사한 시스템보다 훨씬 뛰어납니다.
결과 분석
벡터 데이터베이스의 "성능 삼각형"
벡터 검색 시나리오에서 프로덕션 환경에서 안정적으로 운영되는 성숙한 벡터 데이터베이스는 일반적으로 다음 세 가지 측면 사이에서 절충해야 합니다.
                    ┌──────────────────────┐
                    │      Recall          │
                    │  (Higher is Better)  │
                    └──────────▲───────────┘
                               / \
                              /   \
                             /     \
                            /       \
                           /         \
                          /           \
             ┌───────────┘             └───────────┐
             │                                     │
             │                                     │
             ▼                                     ▼
 ┌──────────────────────┐                 ┌────────────────────────┐
 │      Query QPS       │                 │     Indexing           │
 │   (Latency / QPS)    │                 │     Throughput         │
 │  (Lower Latency Better)│               │  (Higher is Better)    │
 └──────────────────────┘                 └────────────────────────┘
| 측면 | 지표 | 바람직한 방향 |
|---|---|---|
| 재현율 | Top-K 적중률 | 높을수록 좋음 |
| 쿼리 QPS / 지연 시간 | 초당 쿼리 수 / 쿼리당 지연 시간 | QPS는 높을수록, 지연 시간은 낮을수록 좋음 |
| 인덱스 생성 처리량 | 인덱스 생성 처리량 | 높을수록 좋음 |
일반적으로 이 세 가지를 동시에 극대화하기는 어렵기 때문에, 벡터 데이터베이스를 설계할 때는 이들 사이의 균형을 맞춰야 합니다.
주요 HNSW 파라미터와 절충 관계
업계에서 가장 널리 사용되는 벡터 인덱스인 HNSW(Hierarchical Navigable Small World)를 예로 들어 보겠습니다. HNSW는 그래프 구조를 활용해 검색을 최적화하며, 조정 가능한 주요 하이퍼파라미터는 세 가지입니다.
| 파라미터 | 역할 | 영향 |
|---|---|---|
max_degree | 그래프 내 각 노드의 최대 진출 차수 | 그래프 밀도와 전체 연결성을 결정 |
ef_construction | 인덱스 생성 중 후보 집합의 크기 | 값이 클수록 품질이 높은 그래프를 생성 |
hnsw_ef_search | 쿼리 시 탐색 윈도우의 크기 | 재현율과 쿼리 지연 시간에 직접적인 영향 |
일반적인 튜닝의 절충 관계는 다음과 같습니다.
max_degree와ef_construction을 높이면 그래프 연결성과 탐색 효율이 크게 개선되어 재현율이 높아집니다.- 그래프 품질이 높아지면 쿼리 시
hnsw_ef_search를 더 작게 설정할 수 있으므로, 검색 비용이 줄고 쿼리 성능이 향상됩니다. - 그 대가로 인덱스 생성에 더 많은 연산 자원과 메모리가 소모되어 데이터 적재 성능이 저하됩니다.
이것이 벡터 데이터베이스 설계에서 마주하는 전형적인 "트릴레마"입니다.
Apache Doris의 최적화 접근 방식
Apache Doris는 벡터 검색 기능을 설계할 때 다음과 같은 방법으로 더 균형 잡힌 성능 삼각형을 구현하는 것을 목표로 합니다.
- 기반 실행 엔진을 최적화합니다.
- 스토리지 형식을 개선합니다.
- HNSW 생성 파이프라인에 병렬 가속을 적용합니다.
그 결과 Doris는 인덱스 품질과 높은 재현율을 유지하면서 전체 인덱스 데이터 적재 속도를 크게 높입니다.
Performance768D1M 데이터셋의 벤치마크 결과는 이러한 설계 목표가 달성되었음을 보여 줍니다.
- 동일한 인덱스 품질에서 Doris의 데이터 적재 성능은 유사한 시스템보다 훨씬 뛰어납니다.
- 데이터 적재 속도를 높이기 위해 그래프 품질을 낮추지 않습니다.
- QPS는 989.1에 도달하고 재현율은 97%를 초과하며, 세 가지 측면 모두에서 균형 잡힌 결과를 보입니다.
재현 절차
다음 명령으로 로컬에서 테스트를 재현할 수 있습니다.
NUM_PER_BATCH=500000 vectordbbench doris \
    --host 127.0.0.1 \
    --port 9030 \
    --http-port 8030 \
    --case-type Performance768D1M \
    --db-name vdb \
    --num-concurrency 80 \
    --stream-load-rows-per-batch 500000 \
    --index-prop max_degree=128,ef_construction=256 \
    --session-var hnsw_ef_search=100
주요 파라미터:
| 파라미터 | 의미 |
|---|---|
--case-type | 테스트 케이스 선택(여기서는 768D1M 데이터셋) |
--num-concurrency | 쿼리 동시 실행 수 |
--stream-load-rows-per-batch | Stream Load의 배치당 행 수 |
--index-prop | 인덱스 생성 파라미터(max_degree, ef_construction) |
--session-var | 쿼리 시 세션 변수(hnsw_ef_search) |
관련 문서
- 대규모 성능 벤치마크: 단일 노드 및 분산 배포 환경에서 10M / 100M 규모의 데이터셋을 대상으로 수행한 테스트 결과.
- HNSW 인덱스 내부 구조
- 벡터 인덱스 개요
- 벡터 인덱스 실전 가이드