Workload Group: руководство по изоляции ресурсов внутри процесса Doris
Workload Group — механизм логической изоляции ресурсов внутри процесса Doris. Он позволяет детально распределять ресурсы CPU, памяти и IO внутри процесса BE, чтобы нагрузки разных бизнес-приложений не мешали друг другу.
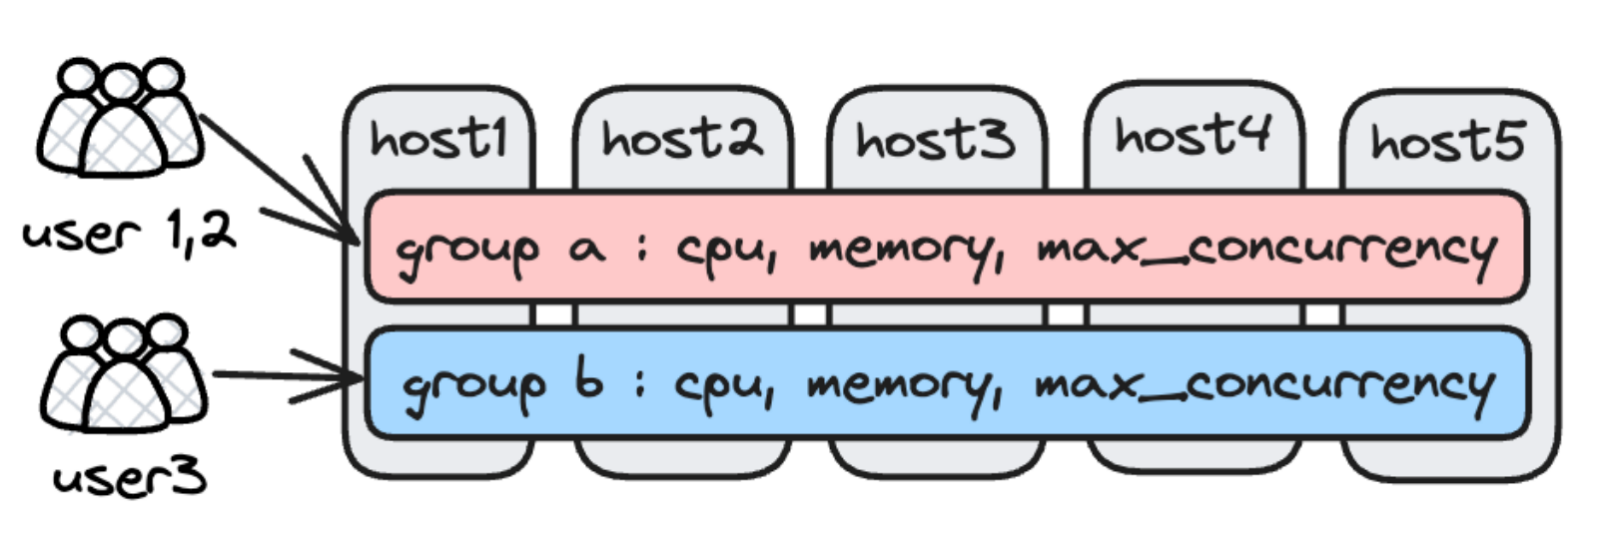
В настоящее время поддерживаются три типа изоляции ресурсов:
- Ресурсы CPU: поддерживаются мягкое ограничение CPU (гарантированный минимум) и жёсткое ограничение CPU (максимальный предел)
- Ресурсы памяти: поддерживаются мягкое и жёсткое ограничения памяти
- Ресурсы IO: поддерживается ограничение пропускной способности IO при чтении локальных и удалённых файлов
Workload Group обеспечивает изоляцию ресурсов внутри процесса, которая принципиально отличается от изоляции между процессами с помощью таких механизмов, как Resource Group и Compute Group:
- При изоляции внутри процесса остаются общие компоненты, например общие кеши и пулы потоков RPC, которые невозможно изолировать. Ресурсоёмкие задачи по-прежнему могут увеличивать задержку задач с небольшой нагрузкой, хотя это влияние значительно слабее, чем при полном отсутствии ограничений.
- Рекомендации по выбору: выбирайте Workload Group, если допустимо некоторое увеличение задержки и важно снизить затраты. Выбирайте Resource Group или Compute Group, если требуется полная изоляция и допустимы более высокие затраты: в этом случае приоритетные нагрузки размещаются на выделенных узлах BE.
Примечания к версиям
| Версия | Описание |
|---|---|
| Doris 2.0 | Появилась функция Workload Group, не зависящая от CGroup |
| Doris 2.1 | Для Workload Group требуется CGroup; система автоматически создаёт группу normal, которую нельзя удалить |
| Doris 4.0 | Понятия мягкого и жёсткого ограничений CPU унифицированы как min_cpu_percent / max_cpu_percent, а понятия мягкого и жёсткого ограничений памяти — как min_memory_percent / max_memory_percent |
Примечания по обновлению:
- 1.2 → 2.0: рекомендуется включать Workload Group только после завершения обновления всего кластера. Если обновить лишь часть узлов follower FE, на необновлённых узлах могут отсутствовать необходимые метаданные, что приведёт к сбоям запросов.
- 2.0 → 2.1: сначала настройте среду CGroup, затем обновитесь до версии 2.1.
Основные свойства
Параметры ресурсов CPU
| Параметр | Диапазон значений | Описание |
|---|---|---|
MIN_CPU_PERCENT | [0%, 100%] | Минимальная доля ресурсов CPU, зарезервированная для этой Workload Group. При конкуренции за CPU другие группы не могут занять эту долю; при наличии свободных ресурсов группа может использовать больше указанного значения. |
MAX_CPU_PERCENT | [0%, 100%] | Верхний предел доли ресурсов CPU для этой Workload Group. Потребление CPU группой не превышает это значение независимо от текущей загрузки CPU. |
Ограничения: сумма значений MIN_CPU_PERCENT для всех групп Workload Group не может превышать 100%, а значение MIN_CPU_PERCENT не может быть больше MAX_CPU_PERCENT.
Пример сценария: отдел продаж компании (высокая нагрузка на CPU, высокий приоритет) и отдел маркетинга (высокая нагрузка на CPU, низкий приоритет) используют один экземпляр Doris. Для Workload Group отдела продаж можно задать 40% в min_cpu_percent, а для Workload Group отдела маркетинга — 30% в max_cpu_percent, чтобы обеспечить отделу продаж стабильный доступ к ресурсам CPU.
Параметры ресурсов памяти
| Параметр | Диапазон значений | Описание |
|---|---|---|
MIN_MEMORY_PERCENT | [0%, 100%] | Минимальный объём памяти, зарезервированный для этой Workload Group. При нехватке памяти система распределяет её в соответствии с этим значением; при необходимости некоторые запросы принудительно завершаются для освобождения памяти, чтобы другим группам хватало доступной памяти. |
MAX_MEMORY_PERCENT | [0%, 100%] | Верхний предел памяти для этой Workload Group. Когда объём памяти, используемой запросами, превышает это значение, запускается сброс данных на диск или запросы принудительно завершаются. |
Ограничения: сумма значений MIN_MEMORY_PERCENT для всех групп Workload Group не может превышать 100%, а значение MIN_MEMORY_PERCENT не может быть больше MAX_MEMORY_PERCENT.
Другие свойства
| Имя свойства | Тип данных | Значение по умолчанию | Диапазон значений | Описание |
|---|---|---|---|---|
max_concurrency | Integer | 2147483647 | [0, 2147483647] | Максимальное число одновременно выполняемых запросов; по умолчанию не ограничено. Когда число выполняющихся запросов достигает верхнего предела, новые запросы обрабатываются механизмом очереди. |
max_queue_size | Integer | 0 | [0, 2147483647] | Длина очереди запросов. Значение по умолчанию — 0, то есть очередь не используется; если очередь заполнена, новые запросы сразу завершаются с ошибкой. |
queue_timeout | Integer | 0 | [0, 2147483647] | Максимальное время ожидания запроса в очереди в миллисекундах. Значение по умолчанию — 0, то есть очередь не используется; запрос возвращает ошибку сразу после попадания в очередь. |
scan_thread_num | Integer | -1 | [1, 2147483647] | Число потоков сканирования, используемых текущей Workload Group. Если задано -1, используется значение doris_scanner_thread_pool_thread_num из конфигурации BE. |
max_remote_scan_thread_num | Integer | -1 | [1, 2147483647] | Максимальное число потоков в пуле сканирования для чтения внешних источников данных. Если задано -1, BE определяет значение самостоятельно (обычно с учётом числа ядер). |
min_remote_scan_thread_num | Integer | -1 | [1, 2147483647] | Минимальное число потоков в пуле сканирования для чтения внешних источников данных. Если задано -1, BE определяет значение самостоятельно (обычно с учётом числа ядер). |
read_bytes_per_second | Integer | -1 | [1, 9223372036854775807] | Максимальная пропускная способность IO (байт/с) при чтении внутренних таблиц Doris. Значение по умолчанию — -1, то есть без ограничения. Значение привязано к каталогу, а не к диску; это ограничение также распространяется на каталог файлов, сброшенных на диск. |
remote_read_bytes_per_second | Integer | -1 | [1, 9223372036854775807] | Максимальная пропускная способность IO (байт/с) при чтении внешних таблиц Doris. Значение по умолчанию — -1, то есть без ограничения. |
Настройка Workload Group
Шаг 1: настройте среду CGroup
Управление CPU в Workload Group зависит от компонента CGroup. Если вам нужно управлять только ресурсами памяти и IO, этот шаг можно пропустить.
1. Проверьте версию CGroup
cat /proc/filesystems | grep cgroup
nodev	cgroup
nodev	cgroup2
nodev	cgroupfs
В выводе cgroup означает, что установлена CGroup V1, а cgroup2 — что установлена CGroup V2.
2. Проверьте, какая версия используется в данный момент
# If this path exists, the currently effective version is CGroup V1
/sys/fs/cgroup/cpu/

# If this path exists, the currently effective version is CGroup V2
/sys/fs/cgroup/cgroup.controllers
3. Создайте каталог doris в каталоге CGroup
# CGroup V1: create under the cpu directory
mkdir /sys/fs/cgroup/cpu/doris

# CGroup V2: create under the cgroup directory
mkdir /sys/fs/cgroup/doris
4. Предоставьте процессу BE права на чтение, запись и выполнение
# CGroup V1
chmod 770 /sys/fs/cgroup/cpu/doris
chown -R doris:doris /sys/fs/cgroup/cpu/doris

# CGroup V2
chmod 770 /sys/fs/cgroup/doris
chown -R doris:doris /sys/fs/cgroup/doris
5. Дополнительные действия для CGroup V2 (пропустите для V1)
Измените права доступа к файлу cgroup.procs в корневом каталоге, чтобы процессы можно было перемещать между каталогами CGroup:
chmod a+w /sys/fs/cgroup/cgroup.procs
Убедитесь, что для каталога doris включён контроллер cpu. Если doris/cgroup.controllers не содержит cpu, выполните следующую команду, чтобы включить его:
# After successful execution, a cpu.max file appears under the doris directory, and the output of cgroup.controllers includes cpu
# If it fails, the parent directory has not enabled the cpu controller either; enable it for the parent directory first
echo +cpu > ../cgroup.subtree_control
6. Укажите путь CGroup в конфигурации BE
# CGroup V1
doris_cgroup_cpu_path = /sys/fs/cgroup/cpu/doris

# CGroup V2
doris_cgroup_cpu_path = /sys/fs/cgroup/doris
7. Перезапустите BE
Если после перезапуска в журнале появляется add thread xxx to group, это означает, что настройка выполнена успешно; запись находится в журнале be.INFO.
- Рекомендуется развёртывать только один экземпляр BE на каждой машине. Текущая реализация Workload Group не поддерживает несколько экземпляров BE на одной машине.
- После перезагрузки машины конфигурация в каталоге CGroup удаляется. Чтобы восстанавливать её, используйте systemd: оформите создание каталогов и выдачу прав как системную службу, автоматически выполняемую при каждой перезагрузке.
- При использовании CGroup внутри контейнера контейнер должен иметь права для выполнения операций на хосте.
Использование Workload Group в контейнерах
Управление CPU в Workload Group реализовано на основе CGroup. При использовании в контейнере запускайте контейнер в привилегированном режиме, чтобы процесс Doris мог читать и изменять файлы CGroup на хосте.
Ресурсы CPU внутри контейнера дополнительно распределяются в пределах ресурсов, доступных контейнеру. Например, если хост имеет 64 ядра, контейнеру выделено 8 ядер, а для Workload Group задано жёсткое ограничение CPU в 50%, фактически доступно 4 ядра (8 ядер × 50%).
Управление памятью и IO в Workload Group реализовано внутри Doris и не зависит от внешних компонентов. Их использование в контейнере не отличается от использования на физической машине. Для работы Doris в Kubernetes рекомендуется развёртывание с помощью Doris Operator, который скрывает детали настройки прав доступа на нижележащем уровне.
Шаг 2: создайте Workload Group
CREATE WORKLOAD GROUP IF NOT EXISTS g1
PROPERTIES (
    "min_cpu_percent" = "10%"
);
В этом примере минимальная доля ресурсов CPU установлена в 10%. Начиная с версии 2.1 система автоматически создаёт группу normal, которую нельзя удалить.
Во всех примерах CREATE / ALTER / DROP WORKLOAD GROUP в этом документе предложение FOR <compute_group> опущено. Без изменений эти примеры работают только в необлачном режиме (с совмещением хранения и вычислений), где они применяются к группе ресурсов по умолчанию.
В облачном режиме (с разделением хранения и вычислений) предложение FOR <compute_group> необходимо указывать явно; иначе оператор завершится с ошибкой: Must specify compute group via 'FOR <compute_group>' in cloud mode. Подробнее см. в разделе Привязка Workload Group к Compute Group.
Полный синтаксис см. в разделе CREATE-WORKLOAD-GROUP
Шаг 3: предоставьте пользователю права и привяжите Workload Group
Проверка прав пользователя
Запросите системную таблицу information_schema.workload_groups, чтобы получить список групп Workload Group, доступных текущему пользователю:
SELECT name FROM information_schema.workload_groups;
+--------+
| name   |
+--------+
| normal |
| g1     |
+--------+
Предоставление прав
Если пользователь не видит нужную Workload Group, выполните оператор GRANT из учётной записи администратора:
GRANT USAGE_PRIV ON WORKLOAD GROUP 'g1' TO 'user_1'@'%';
Другие операции с правами доступа описаны в разделе GRANT-TO
Способы привязки
Поддерживаются два способа привязки. Сеансовая переменная имеет более высокий приоритет, чем свойство пользователя:
| Способ привязки | Команда | Описание |
|---|---|---|
| Свойство пользователя (постоянная привязка) | SET PROPERTY 'default_workload_group' = 'g1'; | Workload Group, которую пользователь использует по умолчанию; значение не может быть пустым |
| Сеансовая переменная (временная привязка) | SET workload_group = 'g1'; | Действует только в текущем сеансе; по умолчанию значение пустое |
Управление Workload Group
Просмотр Workload Group
Способ 1: оператор SHOW
SHOW WORKLOAD GROUPS;
Справка: SHOW-WORKLOAD-GROUPS
Способ 2: запрос к системной таблице
SELECT name, min_cpu_percent FROM information_schema.workload_groups WHERE name = 'g1';
+------+-----------------+
| name | min_cpu_percent |
+------+-----------------+
| g1   | 10%             |
+------+-----------------+
Изменение Workload Group
ALTER WORKLOAD GROUP g1 PROPERTIES('min_cpu_percent' = '20%');

SELECT min_cpu_percent FROM information_schema.workload_groups WHERE name = 'g1';
+-----------------+
| min_cpu_percent |
+-----------------+
| 20%             |
+-----------------+
Справка: ALTER-WORKLOAD-GROUP
Удаление Workload Group
DROP WORKLOAD GROUP g1;
Справка: DROP-WORKLOAD-GROUP
Проверка действия ограничений
Все следующие тесты проводились в среде с 1 FE + 1 BE (96 ядер, 375 ГБ памяти) с использованием набора данных ClickBench.
Проверка жёсткого ограничения памяти
Adhoc-запросы имеют заранее неизвестные входные данные и потребление памяти, поэтому есть риск, что несколько запросов займут всю память. Выделение таких нагрузок в отдельную группу с жёстким ограничением памяти предотвращает ситуации, когда внезапный большой запрос вызывает OOM или оставляет другие запросы без доступной памяти. Если потребление памяти этой Workload Group превышает жёсткий предел, память освобождается путём принудительного завершения запросов.
Без жёсткого ограничения памяти
Используйте jmeter, чтобы выполнять q29 с параллелизмом 3. Команда ps показывает, что процесс занимает около 7.7 ГБ памяти:
[ ~]$ ps -eo pid,comm,%mem,rss | grep 1407481
1407481 doris_be         2.0 7896792
[ ~]$ ps -eo pid,comm,%mem,rss | grep 1407481
1407481 doris_be         2.0 7929692
[ ~]$ ps -eo pid,comm,%mem,rss | grep 1407481
1407481 doris_be         2.0 8101232
Запрос к системной таблице показывает, что Workload Group использует около 5.8 ГБ памяти. (Потребление памяти процессом обычно значительно выше, чем потребление отдельной Workload Group, поскольку метаданные, Cache и другие компоненты не учитываются в статистике Workload Group.)
SELECT MEMORY_USAGE_BYTES / 1024 / 1024 AS wg_mem_used_mb FROM workload_group_resource_usage WHERE workload_group_id = 11201;
+-------------------+
| wg_mem_used_mb    |
+-------------------+
| 5797.524360656738 |
+-------------------+
1 row in set (0.01 sec)

SELECT MEMORY_USAGE_BYTES / 1024 / 1024 AS wg_mem_used_mb FROM workload_group_resource_usage WHERE workload_group_id = 11201;
+-------------------+
| wg_mem_used_mb    |
+-------------------+
| 5840.246627807617 |
+-------------------+
1 row in set (0.02 sec)

SELECT MEMORY_USAGE_BYTES / 1024 / 1024 AS wg_mem_used_mb FROM workload_group_resource_usage WHERE workload_group_id = 11201;
+-------------------+
| wg_mem_used_mb    |
+-------------------+
| 5878.394917488098 |
+-------------------+
1 row in set (0.02 sec)
С включённым жёстким ограничением памяти
-
Установите ограничение памяти в 1%:
ALTER WORKLOAD GROUP g2 PROPERTIES('memory_limit' = '1%'); -
Повторите тот же тест. Системная таблица показывает, что потребление памяти снизилось примерно до 1.5 ГБ:
SELECT MEMORY_USAGE_BYTES / 1024 / 1024 AS wg_mem_used_mb FROM workload_group_resource_usage WHERE workload_group_id = 11201;
+--------------------+
| wg_mem_used_mb     |
+--------------------+
| 1575.3877239227295 |
+--------------------+
1 row in set (0.02 sec)

SELECT MEMORY_USAGE_BYTES / 1024 / 1024 AS wg_mem_used_mb FROM workload_group_resource_usage WHERE workload_group_id = 11201;
+------------------+
| wg_mem_used_mb   |
+------------------+
| 1668.77405834198 |
+------------------+
1 row in set (0.01 sec)

SELECT MEMORY_USAGE_BYTES / 1024 / 1024 AS wg_mem_used_mb FROM workload_group_resource_usage WHERE workload_group_id = 11201;
+--------------------+
| wg_mem_used_mb     |
+--------------------+
| 499.96760272979736 |
+--------------------+
1 row in set (0.01 sec) -
Команда ps показывает, что потребление памяти процессом снизилось примерно до 3.8 ГБ:
[ ~]$ ps -eo pid,comm,%mem,rss | grep 1407481
1407481 doris_be         1.0 4071364
[ ~]$ ps -eo pid,comm,%mem,rss | grep 1407481
1407481 doris_be         1.0 4059012
[ ~]$ ps -eo pid,comm,%mem,rss | grep 1407481
1407481 doris_be 1.0 4057068 -
Клиент получает ошибки выполнения запросов из-за нехватки памяти:
1724074250162,14126,1c_sql,HY000 1105,"java.sql.SQLException: errCode = 2, detailMessage = (127.0.0.1)[MEM_LIMIT_EXCEEDED]GC wg for hard limit, wg id:11201, name:g2, used:1.71 GB, limit:1.69 GB, backend:10.16.10.8. cancel top memory used tracker <Query#Id=4a0689936c444ac8-a0d01a50b944f6e7> consumption 1.71 GB. details:process memory used 3.01 GB exceed soft limit 304.41 GB or sys available memory 101.16 GB less than warning water mark 12.80 GB., Execute again after enough memory, details see be.INFO.",concurrency 1-3,text,false,,444,0,3,3,null,0,0,0
Жёсткое ограничение памяти освобождает память путём принудительного завершения запросов, а в крайних случаях это может привести к сбою всех запросов. В производственной среде рекомендуется сочетать жёсткое ограничение памяти с механизмом очереди запросов, чтобы контролировать потребление памяти и при этом сохранять высокую долю успешно выполненных запросов.
Проверка жёсткого ограничения CPU
Типичные нагрузки Doris делятся на три категории, для которых рекомендуются следующие стратегии настройки:
| Тип нагрузки | Характеристики | Рекомендуемая настройка |
|---|---|---|
| Основные запросы отчётности | Высокая нагрузка на CPU, высокие требования к доступности | Мягкое ограничение CPU с более высоким приоритетом |
| Adhoc-запросы | Произвольный SQL, неизвестное потребление ресурсов | Жёсткое ограничение CPU с небольшим значением |
| ETL-запросы | Фиксированный SQL, периодические всплески потребления ресурсов | Жёсткое ограничение CPU для предотвращения влияния на онлайн-сервисы |
При полной загрузке CPU на BE общая доступность кластера заметно снижается (в том числе уменьшается доля CPU, доступная внутренним компонентам, например компонентам RPC). Поэтому в производственных средах рекомендуется использовать жёсткие ограничения CPU вместо мягких.
Тестовая среда: 1 FE, 1 BE, машина с 96 ядрами; набор данных — ClickBench, тестовый SQL — q29.
-
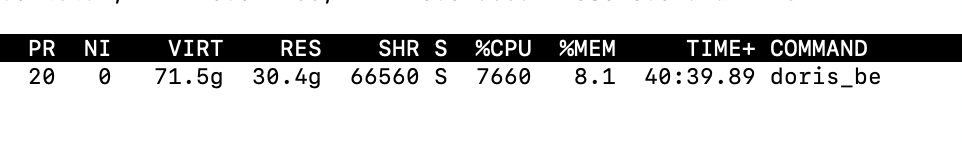
Используйте jmeter для выполнения 3 параллельных запросов, чтобы значительно загрузить CPU процесса BE. (Команда top показывает загрузку CPU в 7600%, то есть около 76 ядер.)
-
Измените жёсткое ограничение CPU для Workload Group на 10%:
ALTER WORKLOAD GROUP g2 PROPERTIES('max_cpu_percent' = '10%'); -
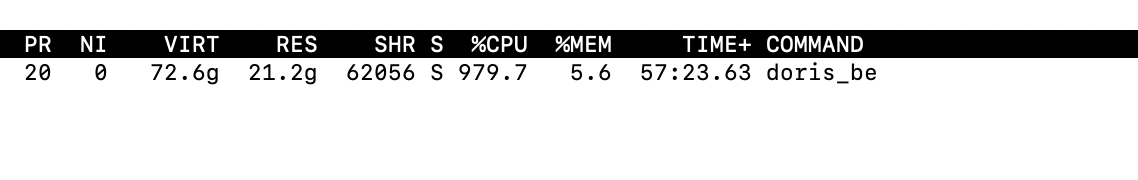
Повторите нагрузочный тест. Теперь процесс может использовать только около 9–10 ядер, что составляет 10% от общего числа ядер:
-
Проверьте по системной таблице, что потребление CPU ограничено примерно 10%:
SELECT CPU_USAGE_PERCENT FROM workload_group_resource_usage WHERE WORKLOAD_GROUP_ID = 11201;
+-------------------+
| CPU_USAGE_PERCENT |
+-------------------+
|              9.57 |
+-------------------+
1 row in set (0.02 sec)
- Рекомендуется не задавать суммарное значение ограничений CPU для всех групп Workload Group равным ровно 100%, оставляя часть ресурсов другим компонентам для обеспечения доступности в сценариях с низкой задержкой. Если задержка несущественна и требуется максимальное использование ресурсов, суммарное значение можно установить в 100%.
- FE синхронизирует метаданные Workload Group с BE каждые 30 секунд. Изменения могут вступать в силу в течение 30 секунд.
Проверка жёсткого ограничения CPU на запросной нагрузке даёт более точные результаты. Высокоскоростная загрузка данных может запускать Compaction, из-за чего наблюдаемое значение превышает настроенный предел Workload Group: нагрузка Compaction пока не управляется Workload Group.
Проверка жёсткого ограничения локального IO
Когда OLAP-система выполняет ETL или большие Adhoc-запросы, параллельное сканирование нескольких файлов на диске в нескольких потоках создаёт значительную нагрузку на дисковый IO и влияет на другие оперативные запросы. Ограничив пропускную способность IO для офлайн-задач ETL, можно уменьшить их влияние на оперативную отчётность и аналитику.
Тестовая среда: 1 FE, 1 BE, машина с 96 ядрами; набор данных — ClickBench.
Без жёсткого ограничения IO
-
Отключите кеш:
-- Clear the operating system cache
sync; echo 3 > /proc/sys/vm/drop_caches

-- Disable the BE page cache
disable_storage_page_cache = true -
Выполните полное сканирование таблицы ClickBench одним запросом:
SET dry_run_query = true;
SELECT * FROM hits.hits; -
Запрос к системной таблице показывает, что максимальная пропускная способность составляет около 3 ГБ/с:
SELECT LOCAL_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS mb_per_sec FROM workload_group_resource_usage WHERE WORKLOAD_GROUP_ID = 11201;
+--------------------+
| mb_per_sec         |
+--------------------+
| 1146.6208400726318 |
+--------------------+
1 row in set (0.03 sec)

SELECT LOCAL_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS mb_per_sec FROM workload_group_resource_usage WHERE WORKLOAD_GROUP_ID = 11201;
+--------------------+
| mb_per_sec         |
+--------------------+
| 3496.2762966156006 |
+--------------------+
1 row in set (0.04 sec)

SELECT LOCAL_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS mb_per_sec FROM workload_group_resource_usage WHERE WORKLOAD_GROUP_ID = 11201;
+--------------------+
| mb_per_sec         |
+--------------------+
| 2192.7690029144287 |
+--------------------+
1 row in set (0.02 sec) -
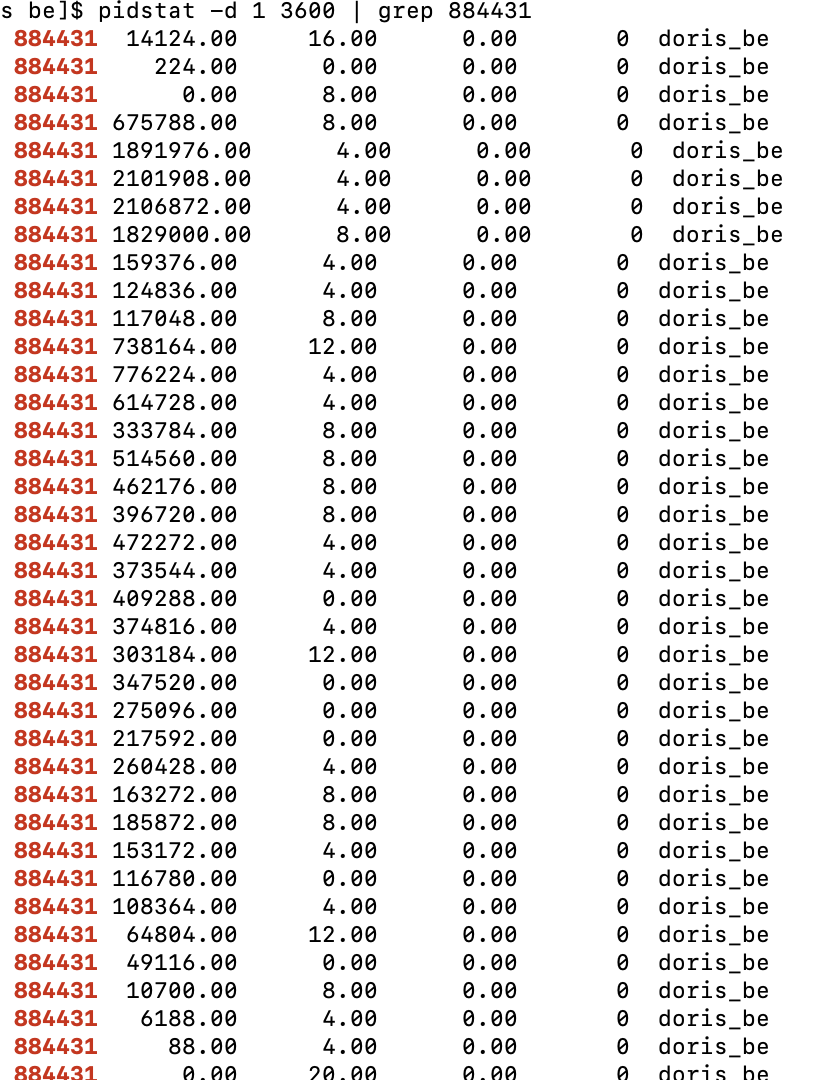
Используйте команду pidstat для просмотра IO процесса (первый столбец — идентификатор процесса, второй — пропускная способность IO при чтении в КБ/с). Без ограничений максимальная пропускная способность составляет около 2 ГБ/с:
С включённым жёстким ограничением IO
-
Отключите кеш:
-- Clear the operating system cache
sync; echo 3 > /proc/sys/vm/drop_caches

-- Disable the BE page cache
disable_storage_page_cache = true -
Ограничьте максимальную пропускную способность чтения значением 100 МБ/с:
ALTER WORKLOAD GROUP g2 PROPERTIES('read_bytes_per_second' = '104857600'); -
Системная таблица показывает, что максимальная пропускная способность IO ограничена примерно 98 МБ/с:
SELECT LOCAL_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS mb_per_sec FROM workload_group_resource_usage WHERE WORKLOAD_GROUP_ID = 11201;
+--------------------+
| mb_per_sec         |
+--------------------+
| 97.94296646118164  |
+--------------------+
1 row in set (0.03 sec)

SELECT LOCAL_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS mb_per_sec FROM workload_group_resource_usage WHERE WORKLOAD_GROUP_ID = 11201;
+--------------------+
| mb_per_sec         |
+--------------------+
| 98.37584781646729  |
+--------------------+
1 row in set (0.04 sec)

SELECT LOCAL_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS mb_per_sec FROM workload_group_resource_usage WHERE WORKLOAD_GROUP_ID = 11201;
+--------------------+
| mb_per_sec         |
+--------------------+
| 98.06641292572021  |
+--------------------+
1 row in set (0.02 sec) -
Используйте инструмент pidstat, чтобы увидеть максимальную пропускную способность IO процесса: она составляет около 131 МБ/с:
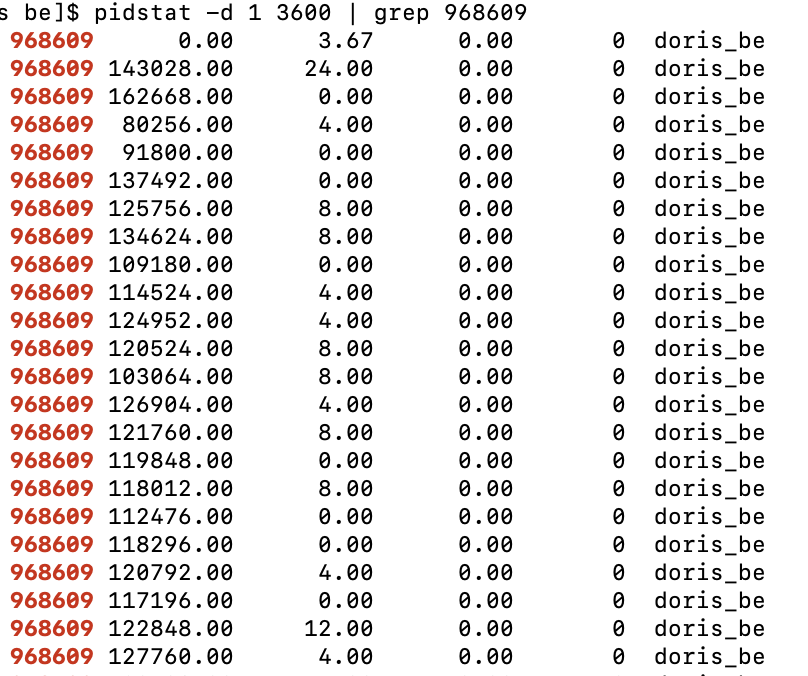
LOCAL_SCAN_BYTES_PER_SECONDв системной таблице — агрегированное значение на уровне процесса. Если настроено 12 путей к файлам, это значение равно максимальному IO среди 12 путей. Чтобы подробно просмотреть пропускную способность IO для каждого пути, обратитесь к мониторингу Grafana.- Из-за кеша операционной системы и Doris Page Cache значения IO, наблюдаемые с помощью скриптов мониторинга IO в Linux, обычно меньше значений в системной таблице.
Проверка жёсткого ограничения удалённого IO
BrokerLoad и S3Load — распространённые способы загрузки данных большими пакетами. Когда Doris параллельно получает данные из HDFS/S3 в нескольких потоках, это создаёт высокую нагрузку на внешнее хранилище и влияет на стабильность других задач. Ограничив пропускную способность удалённого IO, можно уменьшить влияние загрузки данных на другие бизнес-процессы.
Тестовая среда: 1 FE + 1 BE на одной машине, 16 ядер, 64 ГБ памяти; тестовые данные — 10 миллионов строк из набора данных ClickBench, загруженных в S3.
Просмотрите информацию о схеме:
DESC FUNCTION s3 (
    "URI" = "https://bucketname/1kw.tsv",
    "s3.access_key" = "ak",
    "s3.secret_key" = "sk",
    "format" = "csv",
    "use_path_style" = "true"
);
Без ограничения IO удалённого чтения
-
Выполните полное сканирование таблицы одним запросом:
-- Set to scan data only, do not return results
SET dry_run_query = true;

SELECT * FROM s3(
    "URI" = "https://bucketname/1kw.tsv",
    "s3.access_key" = "ak",
    "s3.secret_key" = "sk",
    "format" = "csv",
    "use_path_style" = "true"
); -
Системная таблица показывает, что пропускная способность удалённого IO составляет около 837 МБ/с. (Фактическая пропускная способность зависит от канала между BE и внешним хранилищем.)
SELECT CAST(REMOTE_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS INT) AS read_mb FROM information_schema.workload_group_resource_usage;
+---------+
| read_mb |
+---------+
|     837 |
+---------+
1 row in set (0.104 sec)

SELECT CAST(REMOTE_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS INT) AS read_mb FROM information_schema.workload_group_resource_usage;
+---------+
| read_mb |
+---------+
|     867 |
+---------+
1 row in set (0.070 sec)

SELECT CAST(REMOTE_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS INT) AS read_mb FROM information_schema.workload_group_resource_usage;
+---------+
| read_mb |
+---------+
|     867 |
+---------+
1 row in set (0.186 sec) -
Используйте
sar -n DEV 1 3600для просмотра сетевой пропускной способности машины (первый столбец — объём данных, получаемых за секунду, в КБ/с). Максимальная сетевая пропускная способность на уровне машины составляет около 1033 МБ/с: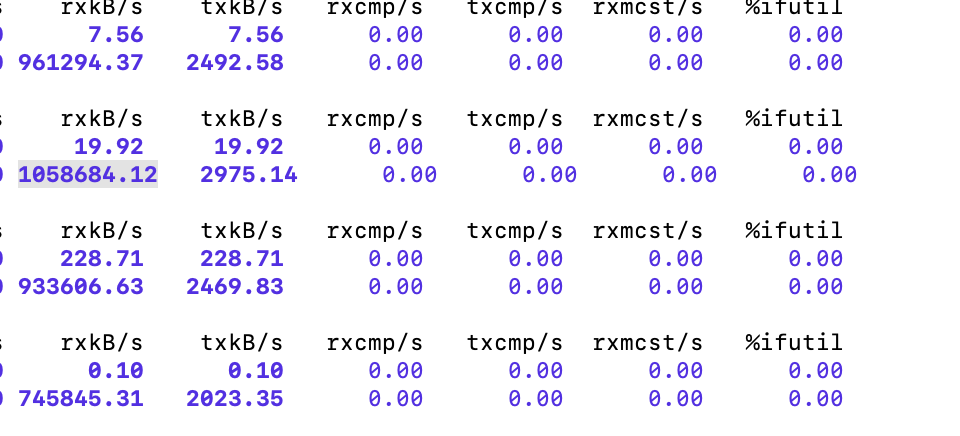
После ограничения IO удалённого чтения
-
Ограничьте пропускную способность IO удалённого чтения значением 100 МБ/с:
ALTER WORKLOAD GROUP normal PROPERTIES('remote_read_bytes_per_second' = '104857600'); -
Выполните полное сканирование таблицы одним запросом:
SET dry_run_query = true;

SELECT * FROM s3(
    "URI" = "https://bucketname/1kw.tsv",
    "s3.access_key" = "ak",
    "s3.secret_key" = "sk",
    "format" = "csv",
    "use_path_style" = "true"
); -
Системная таблица показывает, что пропускная способность IO удалённого чтения ограничена примерно 100 МБ/с. (Из-за особенностей алгоритма она колеблется; кратковременные пики нормальны.)
SELECT CAST(REMOTE_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS INT) AS read_mb FROM information_schema.workload_group_resource_usage;
+---------+
| read_mb |
+---------+
|      56 |
+---------+
1 row in set (0.010 sec)

SELECT CAST(REMOTE_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS INT) AS read_mb FROM information_schema.workload_group_resource_usage;
+---------+
| read_mb |
+---------+
|     131 |
+---------+
1 row in set (0.009 sec)

SELECT CAST(REMOTE_SCAN_BYTES_PER_SECOND / 1024 / 1024 AS INT) AS read_mb FROM information_schema.workload_group_resource_usage;
+---------+
| read_mb |
+---------+
|     111 |
+---------+
1 row in set (0.009 sec) -
Используйте
sar -n DEV 1 3600для просмотра входящего трафика сетевого интерфейса (первый столбец — объём данных, получаемых за секунду). Максимальное значение теперь составляет около 207 МБ/с: ограничение IO вступило в силу. (Команда sar показывает трафик на уровне машины, который обычно превышает статистическое значение Doris.)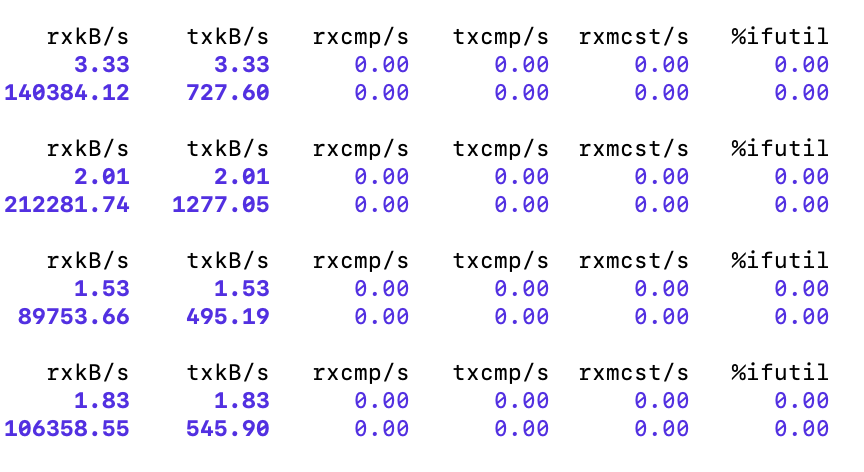
Часто задаваемые вопросы
Вопрос: жёсткое ограничение CPU настроено, но не действует
- Ошибка инициализации среды: проверьте, содержит ли файл
/sys/fs/cgroup/cpu/doris/query/1/tasksв каталоге CGroup V1 идентификаторы потоков соответствующей Workload Group (их можно получить с помощьюtop -H -b -n 1 -p pid), и равно ли значениеcpu.cfs_quota_us-1 (значение -1 означает, что жёсткое ограничение не действует). - Потребление CPU процессом BE превышает настроенное значение: Workload Group управляет потоками запросов и потоками сброса memtable при загрузке данных. Другие компоненты внутри BE, например Compaction, тоже потребляют CPU, поэтому загрузка CPU процесса обычно выше настроенного значения Workload Group. Можно создать тестовую Workload Group и проверить её собственное потребление CPU через
information_schema.workload_group_resource_usage(поддерживается начиная с версии 2.1.6). - Настроен параметр
cpu_resource_limit: выполнитеSHOW PROPERTY FOR jack LIKE 'cpu_resource_limit'иSHOW VARIABLES LIKE 'cpu_resource_limit', чтобы проверить, задан ли этот параметр (значение по умолчанию -1 означает, что он не задан). Если параметр настроен, запросы используют отдельный пул потоков и не управляются Workload Group. Рекомендация по миграции: выполняйте её поэтапно — установите для пользователяnum_scanner_threadsв 1, укажите Workload Group, затем изменитеcpu_resource_limitна -1, дождитесь стабильной работы и продолжайте миграцию.
Вопрос: по умолчанию число групп Workload Group ограничено 15
Workload Group распределяет ресурсы одной машины. Если групп слишком много, каждой из них достаётся слишком мало ресурсов. Если вашим приложениям действительно нужно больше групп, рассмотрите разделение кластера на несколько наборов узлов BE с созданием отдельных групп Workload Group для каждого набора; также можно изменить параметр конфигурации FE workload_group_max_num, чтобы временно обойти это ограничение.
Вопрос: после настройки большого числа групп Workload Group появляется ошибка "Resource temporarily unavailable"
Каждая Workload Group представляет собой отдельный набор пулов потоков. Если создать слишком много групп, число потоков, которые пытается запустить процесс BE, может превысить предел, разрешённый операционной системой. Решение: измените настройки операционной системы, чтобы процесс BE мог создавать больше потоков.