Обзор возможностей AI
Apache Doris — высокопроизводительная аналитическая база данных реального времени, в которой тесно интегрированы текстовый поиск, векторный поиск, функции AI и интеллектуальное взаимодействие на основе MCP. Она формирует полноценный стек работы с данными для AI, охватывающий хранение, поиск и аналитику, и предоставляет единую инфраструктуру данных для AI-приложений.
Следующая таблица содержит распространённые сценарии использования AI и соответствующие возможности Doris, помогая быстро выбрать подходящее решение.
| Что вы хотите сделать | Сценарий | Основные возможности |
|---|---|---|
| Дать AI-агентам возможность запрашивать бизнес-данные в реальном времени | Аналитика для AI-агентов | Архитектура MPP, запросы за миллисекунды, MCP Server |
| Выполнять поиск по ключевым словам, векторный поиск и агрегацию одних и тех же данных | Гибридный поиск и аналитика | Инвертированный индекс + векторный индекс + SQL |
| Ускорить подготовку данных для обучения AI и работу с признаками | Lakehouse для AI | Архитектура Lakehouse, открытые табличные форматы, быстрая обработка SQL |
| Создавать корпоративные базы знаний и интеллектуальные системы обслуживания клиентов | Приложения RAG | Векторный поиск с поддержкой большого числа одновременных запросов, гибридный поиск |
| Отслеживать обучение моделей и работу сервисов инференса | Наблюдаемость AI-систем | Высокая пропускная способность загрузки данных, инвертированный индекс, низкая стоимость хранения |
| Научить поиск понимать намерения пользователей | Семантический поиск | HNSW/IVF, квантование, мультимодальные расширения |
Аналитика для AI-агентов
По мере распространения технологии AI-агентов всё больше аналитических решений AI принимает автоматически. Это требует от платформы данных исключительно высокой скорости работы в реальном времени и поддержки большого числа одновременных запросов. В отличие от традиционной аналитики, выполняемой человеком, аналитика для AI-агентов должна обеспечивать выполнение запросов к данным и принятие решений за миллисекунды, а также поддерживать одновременный доступ огромного числа агентов. Типичные сценарии включают выявление мошенничества в реальном времени, интеллектуальный показ рекламы и персонализированные рекомендации.
Благодаря высокопроизводительной архитектуре MPP Doris предоставляет следующие преимущества для аналитики, ориентированной на AI-агентов:
| Возможность | Показатель | Значение |
|---|---|---|
| Задержка поступления данных | Менее секунды | Загрузка и обновление в реальном времени обеспечивают принятие решений агентами на основе самых свежих данных |
| Время отклика на запрос | В среднем < 100 мс | Отвечает потребностям агентов в принятии решений в реальном времени |
| Параллельная обработка запросов | 10,000+ QPS | Легко справляется с одновременными запросами огромного числа агентов |
| Интеграция | Встроенный MCP Server | Легко интегрируется с AI-агентами и упрощает разработку |
Гибридный поиск и аналитическая обработка
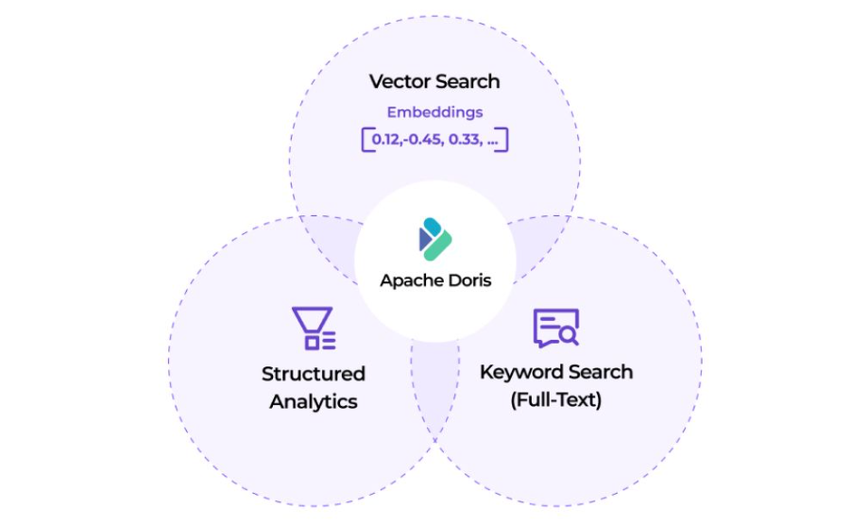
Полуструктурированные и неструктурированные данные становятся полноценными участниками аналитических процессов. Отзывы клиентов, история переписки, производственные журналы и сигналы автомобильной телеметрии теперь активно используются при принятии бизнес-решений. Традиционным решениям для анализа структурированных данных необходимо объединять возможности полнотекстового и векторного поиска, чтобы на единой платформе поддерживать и семантический поиск, и многомерный анализ с агрегацией. Типичные сценарии включают:
- Изучение клиентов: объединение поиска по текстам отзывов с анализом поведения пользователей для точного определения потребностей клиентов и тенденций изменения их удовлетворённости.
- Умное производство: объединение полнотекстового поиска по производственным журналам, распознавания изображений оборудования и анализа метрик IoT для прогнозирования сбоев и оптимизации качества.
- Подключённые автомобили: объединение анализа автомобильной телеметрии, анализа текстов отзывов пользователей и векторного поиска по данным о поведении водителей для улучшения взаимодействия с интеллектуальной кабиной автомобиля.
Преимущества создания приложений для гибридного поиска и аналитики на Doris:
- Единая архитектура: анализ структурированных данных, полнотекстовый и векторный поиск на одной платформе без переноса данных или интеграции разнородных систем.
- Производительность гибридных запросов: поиск по векторному сходству, фильтрация по ключевым словам и агрегация в одном SQL-операторе с высокой производительностью выполнения запросов.
- Поддержка гибкой схемы: тип VARIANT изначально поддерживает динамические структуры JSON, а Light Schema Change позволяет изменять поля и индексы за секунды.
- Оптимизация всех уровней: сквозная оптимизация от инвертированного и векторного индексов до механизма выполнения MPP обеспечивает баланс между точностью поиска и эффективностью аналитики.
Lakehouse для AI
Разработка моделей и приложений AI требует подготовки обучающих выборок, работы с признаками и оценки качества данных в огромных наборах данных. Традиционные архитектуры часто требуют регулярного переноса данных между озёрами данных и аналитическими движками. Архитектура Lakehouse тесно объединяет открытые хранилища озёр данных с аналитическими движками реального времени, поддерживая на единой платформе весь процесс подготовки данных, работы с признаками и оценки моделей. Это устраняет изолированность данных и ускоряет итерации разработки AI.
Особенности архитектуры:
- Интеграция Lakehouse: создание открытого Lakehouse на основе открытых табличных форматов озёр данных (таких как Iceberg и Paimon) и объектов Catalog для единого управления аналитическими данными и данными AI.
- Быстрый движок SQL: Doris служит аналитическим движком реального времени с поддержкой интерактивных запросов и облегчённых процессов ETL, обеспечивая эффективные вычисления SQL для подготовки данных и работы с признаками.
- Беспрепятственное движение данных: чтение из озёр данных и запись в них напрямую, без перемещения данных. Для уровня хранения используется единое управление, а вычислительный уровень позволяет гибко ускорять обработку.
Ускорение на всех этапах работы с AI:
- Масштабная подготовка данных: эффективная фильтрация, формирование выборок и очистка данных из озёр петабайтного масштаба для быстрого создания качественных обучающих наборов данных.
- Работа с признаками в реальном времени: извлечение, преобразование и агрегация признаков в режиме онлайн для предоставления признаков в реальном времени при обучении моделей и инференсе.
- Оценка качества: быстрый многомерный анализ тестовых наборов и производственных данных для постоянного отслеживания производительности моделей и дрейфа данных.
RAG (Retrieval-Augmented Generation)
RAG извлекает релевантную информацию из внешних баз знаний, чтобы предоставить контекст большим языковым моделям, эффективно решая проблемы галлюцинаций моделей и актуальности знаний. Векторный движок является ключевым компонентом системы RAG. Он должен быстро находить наиболее релевантные фрагменты документов в огромной базе знаний и при этом поддерживать большое число одновременных пользовательских запросов, чтобы приложение быстро отвечало пользователям.
Типичные приложения:
- Корпоративная база знаний: создание интеллектуальной системы вопросов и ответов на основе внутренних документов и руководств, чтобы сотрудники могли быстро получать точные ответы на естественном языке.
- Интеллектуальный помощник службы поддержки: объединение баз знаний о продуктах с историей обращений для предоставления точных рекомендаций по ответам сотрудникам службы поддержки или чат-ботам.
- Интеллектуальный помощник по работе с документами: быстрый поиск релевантного содержимого в больших коллекциях документов для исследований, подготовки текстов и принятия решений.
Преимущества создания RAG на Doris:
- Производительность при большом числе одновременных запросов: распределённая архитектура поддерживает параллельный векторный поиск и легко справляется с одновременным доступом большого числа пользователей.
- Возможности гибридного поиска: поиск по векторному сходству и фильтрация по ключевым словам в одном SQL-операторе обеспечивают баланс между полнотой семантического поиска и точным совпадением.
- Эластичное масштабирование: производительность поиска растёт линейно с увеличением кластера, обеспечивая плавный переход от миллионов к десяткам миллиардов векторов.
- Единое решение: единое управление векторными данными, исходными документами и бизнес-данными упрощает архитектуру данных приложений RAG.
Наблюдаемость AI-систем
Итерации обучения моделей AI и работа приложений порождают огромные объёмы журналов, метрик и данных трассировки. Системы наблюдаемости стали важнейшей частью инфраструктуры AI, позволяя точно выявлять проблемы и постоянно оптимизировать производительность. По мере роста масштабов бизнеса платформам наблюдаемости приходится одновременно решать задачи высокоскоростной загрузки данных петабайтного масштаба, поиска с откликом за миллисекунды и контроля затрат.
Типичные сценарии использования:
- Мониторинг обучения моделей: отслеживание метрик обучения и потребления ресурсов в реальном времени для быстрого выявления аномалий обучения и узких мест производительности.
- Трассировка сервисов инференса: запись полной цепочки вызовов каждого запроса на инференс для анализа источников задержек и закономерностей возникновения ошибок.
- Анализ журналов AI-приложений: полнотекстовый поиск и агрегация огромных объёмов журналов приложений для диагностики проблем и изучения поведения приложений.
Преимущества построения наблюдаемости AI-систем на Doris:
| Аспект | Показатели возможностей |
|---|---|
| Производительность загрузки данных | Поддерживает непрерывную загрузку со скоростью PB/day (10 GB/s); инвертированные индексы ускоряют поиск по журналам и обеспечивают отклик за секунды |
| Стоимость хранения | Коэффициент сжатия от 5:1 до 10:1 сокращает затраты на хранение на 50%-80%; для холодных данных доступно недорогое хранилище |
| Гибкость схемы | Light Schema Change позволяет изменять поля за секунды, а тип VARIANT изначально поддерживает динамический JSON |
| Совместимость с экосистемой | Совместимость с OpenTelemetry и экосистемой ELK, интеграция с инструментами визуализации, такими как Grafana и Kibana |
Семантический поиск
Семантический поиск использует векторизацию для выявления глубинного смысла текста и находит семантически связанное содержимое, даже когда слова запроса отличаются от формулировок в документах. Это критически важно для межъязыкового поиска, распознавания синонимов, понимания намерений и подобных задач, а также значительно повышает полноту поиска и удобство работы пользователей.
Типичные сценарии использования:
- Поиск по корпоративным документам: сотрудники формулируют вопросы на естественном языке, а система понимает намерения и находит семантически релевантные регламенты, описания процессов и знания в огромных хранилищах документов.
- Поиск товаров в электронной коммерции: пользователь вводит «дышащая обувь для лета», а система понимает потребность и находит подходящие товары, учитывая больше, чем совпадения ключевых слов.
- Платформы рекомендаций контента: интеллектуальные рекомендации на основе семантического сходства статей и видео помогают находить контент, который может заинтересовать пользователя, даже если в нём используются другие формулировки.
Преимущества создания семантического поиска на Doris:
- Высокопроизводительный векторный поиск: поддержка алгоритмов HNSW и IVF с откликом менее секунды на сотнях миллионов векторов позволяет легко справляться с задачами масштабного семантического поиска.
- Расширение возможностей гибридного поиска: один SQL-оператор объединяет семантический поиск с фильтрацией по ключевым словам, находя семантически связанное содержимое и обеспечивая совпадение обязательных ключевых слов.
- Мультимодальное расширение: поддержка семантического поиска как по тексту, так и по мультимодальному содержимому, например изображениям и аудио.
- Гибкая оптимизация с помощью квантования: методы квантования SQ/PQ значительно сокращают затраты на хранение и вычисления, сохраняя точность поиска.