Peer Cache Read: чтение из File Cache других BE и вычислительных групп (разделение вычислений и хранения)
Чтение из кеша других BE (peer cache read) используется для обработки промахов File Cache в режиме разделения вычислений и хранения. Если нужного блока нет в локальном File Cache, BE сначала запрашивает его из File Cache другого BE в той же или другой вычислительной группе. Чтение из объектного хранилища выполняется, только если блока нет и у других BE. Этот механизм влияет только на холодное чтение; чтение с попаданием в локальный кеш не меняется.
Чтение из кеша BE других вычислительных групп доступно как экспериментальная функция начиная с Doris 4.2.0 и по умолчанию отключено. Чтобы использовать его, явно задайте enable_cache_read_from_peer = true на соответствующих BE.
Сценарии использования
| Сценарий | Что делает peer read | Преимущество |
|---|---|---|
| Масштабирование внутри вычислительной группы | После расширения группы или перебалансировки таблетов первые чтения на новом BE получают закешированные блоки с BE, который раньше обслуживал этот таблет, вместо обращения к объектному хранилищу | Более короткий спад производительности после перебалансировки и меньше трафика к объектному хранилищу |
| Холодное чтение между вычислительными группами | Если в этой вычислительной группе кеш пуст, но другая группа уже читала те же данные, блок считывается с BE другой группы | Меньшая задержка запросов с холодным кешем и меньше чтений из объектного хранилища |
| Заполнение кеша другой вычислительной группы | Вы назначаете «вычислительную группу заполнения кеша». Если на её BE тоже нет блока, этот BE получает блок из объектного хранилища, записывает в собственный File Cache и возвращает запрашивающему BE | Назначенная группа берёт на себя затраты на обращение к объектному хранилищу и сохраняет копию в своём кеше |
Ориентировочная производительность
В тесте холодного чтения на наборе данных TPC-H объёмом 1 TB чтение из кеша других BE было примерно вдвое быстрее прямого чтения из объектного хранилища. Фактический выигрыш зависит от того, есть ли данные на других BE, и от соотношения задержки сети между BE и задержки объектного хранилища.
Предварительные требования
- Развёртывание с разделением вычислений и хранения. В совмещённом режиме peer read не действует.
- File Cache включён на каждом BE (
enable_file_cache = true). - Явно задано
enable_cache_read_from_peer = true(по умолчаниюfalse). - Для заполнения кеша другой группы нужен идентификатор вычислительной группы заполнения кеша (
compute_group_id). О том, как его найти, см. Назначение вычислительной группы заполнения кеша.
Ограничения
- Поддерживаются только внутренние таблицы Doris. Кеш данных внешних таблиц (Hive, Iceberg и других) не использует peer read.
- Peer read запускается только при промахе локального File Cache. Чтения, инициированные заданиями прогрева, и чтения из объектного хранилища, которые сервер заполнения кеша выполняет для собственных нужд, повторно через peer read не проходят.
enable_cache_read_from_peerуправляет peer read как внутри группы, так и между группами. Сейчас нельзя оставить peer read внутри группы и отключить его между группами. Список кандидатов поступает от FE и включает BE других вычислительных групп.- Сервер заполнения кеша пока не поддерживает файлы, созданные при объединении мелких файлов (Packed File). Такие запросы, как обычно, переходят к чтению из объектного хранилища.
- В развёртываниях с несколькими AZ чтение из кеша BE других групп создаёт сетевой трафик между AZ, за который может взиматься дополнительная плата.
- Peer read выполняется по возможности. Будет ли чтение направлено другому BE и какому именно, зависит от списка кандидатов, тайм-аутов и логики перехода к резервному источнику.
Как это работает
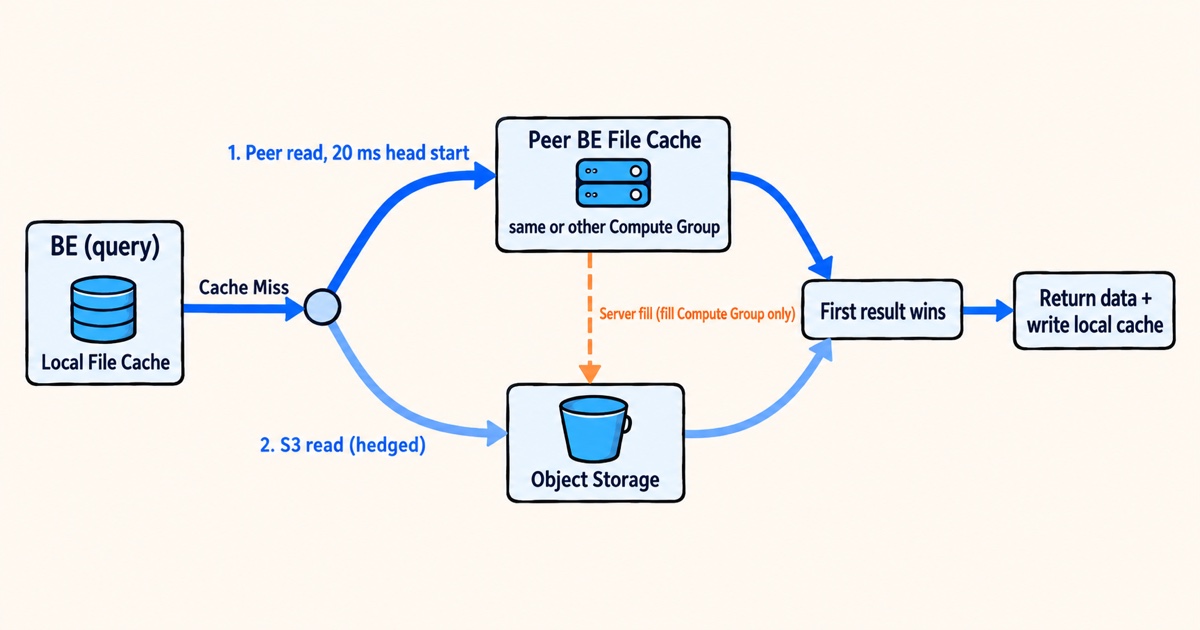
Путь чтения
- Запрос на чтение блока сначала проверяет локальный File Cache и при попадании возвращает данные.
- При промахе BE проверяет, есть ли у него кандидаты для чтения этого таблета с других BE. Если кандидатов нет, текущее чтение сразу направляется в объектное хранилище, а BE запрашивает кандидатов у FE в фоновом режиме. Текущий запрос не ждёт их получения.
- Если кандидаты есть, чтение с другого BE конкурирует с чтением из объектного хранилища (
enable_peer_s3_race, по умолчанию включено). BE сначала отправляет запрос peer read и даёт ему фору вpeer_race_hedge_delay_ms(по умолчанию 20 мс). Если другой BE отвечает за это время, запрос к объектному хранилищу вообще не отправляется. - Используется результат того чтения, которое завершится первым. В любом случае данные записываются в локальный File Cache, поэтому последующие чтения обслуживаются локально.
- Если чтение с другого BE не удаётся, выполняется чтение из объектного хранилища, а запрос не завершается ошибкой. К таким неудачам относятся отсутствие блока у кандидата, ошибка RPC, достижение лимита одновременных запросов или тайм-аут.
Если enable_peer_s3_race отключён или число одновременных гонок чтения превышает max_concurrent_peer_races (по умолчанию 64), BE выполняет чтения последовательно: пробует кандидатов по одному и обращается к объектному хранилищу, только если ни один из них не смог предоставить данные.
Запрос с холодным кешем обычно выполняет много чтений одновременно. Уже первое чтение завершающей части сегмента запускает получение кандидатов, поэтому последующие чтения того же таблета в рамках того же запроса могут использовать peer read. Обращение к объектному хранилищу при самом первом холодном чтении является ожидаемым поведением.
Откуда берутся кандидаты
| Источник | Описание | Приоритет |
|---|---|---|
| Исходный BE при перебалансировке | При расширении вычислительной группы или перебалансировке таблетов запрос прогрева, который FE отправляет целевому BE, сохраняет исходный BE как кандидата. Если balance_type задан как without_warmup, запрос прогрева не отправляется и кандидат не сохраняется | Наивысший |
| Распределение таблетов, возвращаемое FE | Если локальных кандидатов нет, BE в фоновом режиме запрашивает у FE список BE, содержащих таблет в каждой вычислительной группе, и добавляет их в конец списка | Более низкий |
| Ручная настройка | Записывается через HTTP-интерфейс /api/peer_cache?op=set (см. Просмотр и изменение сведений о кандидатах таблета), обычно только для тестирования и устранения неполадок | В порядке записи |
Выбор и ротация кандидатов
- BE запоминает вычислительную группу, которая последней успешно обслужила каждый таблет, и сначала пробует кандидатов из этой группы.
- Кандидат, у которого нет блока, перемещается в конец списка, чтобы при следующем чтении попробовать другого. Кандидат удаляется из списка после
peer_rpc_failure_eviction_threshold(по умолчанию 3) последовательных ошибок RPC. - После
peer_all_miss_cooldown_threshold(по умолчанию 5) последовательных чтений, при каждом из которых блок отсутствовал у всех кандидатов, таблет переходит в режим временного отключения peer read наpeer_all_miss_cooldown_duration_s(по умолчанию 300 секунд). В течение этого периода чтения таблета направляются сразу в объектное хранилище. - Записи кандидатов, которые не использовались в течение
peer_candidate_expiry_s(по умолчанию 3600 секунд), удаляются из памяти. При следующем промахе они снова запрашиваются у FE.
Начиная с версии 4.2.0 для чтений peer read используется общий для разных таблетов механизм circuit breaker на уровне адреса. После cache_peer_read_failure_threshold последовательных ошибок соединения или RPC для одного адреса (по умолчанию 3, фактический минимум 1) чтения с этого адреса приостанавливаются на cache_peer_read_circuit_open_seconds секунд (по умолчанию 30, отрицательные значения трактуются как 0). По окончании этого периода разрешается только один пробный запрос для проверки восстановления. Этот механизм работает независимо от удаления кандидатов таблета и временного отключения peer read после промахов у всех кандидатов.
Заполнение кеша другой вычислительной группы
Если на запрашивающем BE задан peer_cache_fill_compute_group_id и выбранный кандидат принадлежит этой вычислительной группе, запрос передаётся с флагом заполнения кеша. Если на принимающем BE нет блока и включён enable_peer_server_cache_fill (по умолчанию включён), этот BE считывает блок из объектного хранилища, записывает его в собственный File Cache и затем возвращает.
Заполнение кеша ограничивается параметрами max_concurrent_peer_server_fills (по умолчанию 32) и peer_server_cache_fill_timeout_ms (по умолчанию 6000 мс). Если лимит достигнут или время ожидания заполнения истекло, запрашивающий BE переходит к чтению из объектного хранилища.
Настройка
Все приведённые ниже параметры относятся к конфигурации BE. За исключением параметров пулов потоков, их можно менять во время работы; см. Изменение параметров во время работы.
Проверка и отключение peer read
По умолчанию peer read отключён. Чтобы использовать его, включите File Cache и задайте enable_cache_read_from_peer=true в файле be.conf на BE либо воспользуйтесь приведённым ниже интерфейсом динамической настройки. Чтение внутри группы и между группами включается одновременно, а FE автоматически предоставляет кандидатов. Проверьте текущее значение из клиента MySQL:
SHOW BACKEND CONFIG LIKE 'enable_cache_read_from_peer';
Чтобы отключить peer read, задайте следующее в be.conf на каждом BE:
enable_cache_read_from_peer = false
После отключения промахи локального кеша сразу приводят к чтению из объектного хранилища, а стратегии балансировки, зависящие от peer read, такие как peer_read_async_warmup, перестают действовать.
Назначение вычислительной группы заполнения кеша
Чтобы определённая вычислительная группа получала данные из объектного хранилища и заполняла собственный кеш при холодном чтении из других групп, выполните следующие три шага.
-
Найдите идентификатор целевой вычислительной группы. Значение
compute_group_idв столбцеTagвыводаSHOW BACKENDSявляется идентификатором вычислительной группы, а неcompute_group_name:SHOW BACKENDS\G*************************** 1. row ***************************
BackendId: 10001
Host: 10.0.0.1
...
Tag: {"cloud_unique_id" : "1:xxx:yyy", "compute_group_id" : "cg_write_01", "compute_group_name" : "write_group", "compute_group_status" : "NORMAL", "location" : "default"} -
На каждом BE вычислительной группы, которая выполняет запросы, задайте:
peer_cache_fill_compute_group_id = cg_write_01 -
Убедитесь, что
enable_peer_server_cache_fillимеет значениеtrue(по умолчанию) на BE вычислительной группы заполнения кеша.
Изменение параметров во время работы
За исключением параметров пулов потоков, каждый параметр на этой странице можно менять во время работы. Добавьте persist=true, чтобы сохранить изменение в be_custom.conf:
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?enable_cache_read_from_peer=false&persist=true"
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?peer_race_hedge_delay_ms=30"
Параметры
Включение и гонка чтений
| Параметр | По умолчанию | Описание |
|---|---|---|
enable_cache_read_from_peer | false | Главный переключатель peer read. Если включён, при промахе локального File Cache сначала выполняется попытка чтения с других BE как в той же вычислительной группе, так и в других группах |
enable_peer_s3_race | true | Определяет, конкурирует ли чтение с другого BE с чтением из объектного хранилища. Если отключён, чтения выполняются последовательно: кандидаты проверяются по одному, и чтение из объектного хранилища выполняется, только если ни один из них не смог предоставить данные |
peer_race_hedge_delay_ms | 20 | Фора для чтения с другого BE в миллисекундах. Если другой BE отвечает за это время, запрос к объектному хранилищу не отправляется; при 0 оба чтения запускаются одновременно |
max_concurrent_peer_races | 64 | Максимальное число одновременных гонок чтения на одном BE. Промахи сверх этого лимита обрабатываются последовательно |
Настройки заполнения кеша
| Параметр | По умолчанию | Описание |
|---|---|---|
peer_cache_fill_compute_group_id | "" | Задаётся на запрашивающей стороне. Идентификатор вычислительной группы, отвечающей за заполнение кеша (compute_group_id, а не имя). Если выбранный кандидат принадлежит этой группе, запрос передаётся с флагом заполнения кеша |
enable_peer_server_cache_fill | true | Задаётся на обслуживающей стороне. Определяет, принимать ли запросы с флагом заполнения кеша: если блок не закеширован локально, прочитать его из объектного хранилища, записать в локальный File Cache и вернуть |
peer_server_cache_fill_timeout_ms | 6000 | Максимальное время ожидания одной операции заполнения кеша на обслуживающей стороне в миллисекундах. При тайм-ауте запрашивающая сторона переходит к чтению из объектного хранилища |
max_concurrent_peer_server_fills | 32 | Максимальное число одновременных операций заполнения кеша на обслуживающей стороне. Запросы сверх лимита отклоняются, и запрашивающая сторона переходит к чтению из объектного хранилища |
Управление кандидатами
| Параметр | По умолчанию | Описание |
|---|---|---|
peer_rpc_failure_eviction_threshold | 3 | Кандидат удаляется из списка после указанного числа последовательных ошибок RPC |
peer_all_miss_cooldown_threshold | 5 | Число последовательных чтений с промахами у всех кандидатов, после которого peer read временно отключается для таблета |
peer_all_miss_cooldown_duration_s | 300 | Продолжительность временного отключения в секундах. В течение этого периода чтения таблета направляются сразу в объектное хранилище |
peer_candidate_expiry_s | 3600 | Срок действия записей кандидатов в секундах с момента последнего использования. Просроченные записи удаляются и при следующем промахе снова запрашиваются у FE |
peer_candidate_cleanup_interval_s | 3600 | Интервал в секундах между запусками фонового задания, удаляющего просроченных кандидатов |
Пулы потоков и очереди
| Параметр | По умолчанию | Описание |
|---|---|---|
peer_fetch_queue_timeout_ms | 100 | Обслуживающая сторона. Запрос peer read, ожидающий в очереди обработки дольше указанного времени в миллисекундах, отклоняется, чтобы запрашивающая сторона быстро перешла к чтению из объектного хранилища |
brpc_peer_fetch_pool_threads | -1 | Обслуживающая сторона. Число потоков, обрабатывающих запросы peer read отдельно от ресурсоёмких RPC, например загрузок данных. -1 означает max(64, 2 × CPU cores). Статический параметр; для изменения требуется перезапуск BE |
brpc_peer_fetch_pool_max_queue_size | -1 | Длина очереди этого пула потоков. -1 означает max(4096, 128 × CPU cores). Статический параметр |
min_peer_race_s3_thread_num / max_peer_race_s3_thread_num | 0 / 32 | Запрашивающая сторона. Размер пула потоков, выполняющего чтение из объектного хранилища во время гонки чтений. Статические параметры |
Побочные эффекты и особенности
Чтение из кеша BE других групп ослабляет изоляцию вычислительных групп. Запрос в одной группе использует сеть, диск и ресурсы чтения File Cache другой группы, а при настроенном заполнении кеша также расходует её пропускную способность для доступа к объектному хранилищу. Ресурсы, потребляемые запросом, больше не ограничиваются его собственной вычислительной группой.
При заполнении данные записываются в локальный File Cache обслуживающего BE, что может вытеснить собственные горячие данные этого BE.
При включённой гонке чтений некоторые промахи на короткое время порождают и RPC к другому BE, и чтение из объектного хранилища. Фора в 20 мс сокращает такое дублирование, но не устраняет его.
Попадание в кеш другого BE не гарантируется. Достижение лимита одновременных запросов или операций заполнения кеша на обслуживающей стороне, отсутствие блока и тайм-аут приводят к переходу на объектное хранилище. При включённой гонке чтений запрос с холодным кешем обычно выполняется не медленнее прямого чтения из объектного хранилища, но ускорение не гарантировано.
В развёртываниях с несколькими AZ чтение из кеша BE других групп приводит к расходам на трафик между AZ.
Наблюдаемость и устранение неполадок
Счётчики профиля запроса
Счётчики peer read находятся в узле SegmentIterator профиля рядом с другими счётчиками File Cache. О том, как получить и читать профиль, см. Профиль запроса.
| Счётчик | Значение | Что позволяет определить |
|---|---|---|
NumPeerIOTotal | Число чтений, обслуженных другим BE | Использовал ли запрос peer read вообще |
PeerIOUseTimer | Общее время, затраченное на путь peer read | Медленно ли работает сам путь чтения с других BE |
SameCGPeerIOTotal / SameCGPeerBytesRead / SameCGPeerIOTime | Число, объём в байтах и время чтений с других BE той же группы | Остаются ли чтения peer read преимущественно внутри вычислительной группы |
CrossCGPeerIOTotal / CrossCGPeerBytesRead / CrossCGPeerIOTime | Число, объём в байтах и время чтений с BE других групп | Выполнялись ли чтения между группами и какой объём трафика они создали |
PeerRaceWin / S3RaceWin | Число гонок чтения, выигранных другим BE / объектным хранилищем; имеет смысл только при enable_peer_s3_race = true | Значительно более высокое значение S3RaceWin означает, что в этой среде чтение с другого BE не является более быстрым путём |
PeerLazyFetch / PeerLazyFetchTime | Число и время фоновых запросов кандидатов у FE, запускаемых при отсутствии кандидатов для таблета | Объясняет, почему первое чтение не было направлено другому BE |
PeerCacheNodes | Узлы, с которых запрос фактически считывал данные через peer read | С каких BE поступили данные |
InvertedIndexNumPeerIOTotal / InvertedIndexPeerIOUseTimer и SegmentFooterIndexNumPeerIOTotal / SegmentFooterIndexPeerIOUseTimer учитывают число чтений peer read и затраченное время для файлов инвертированного индекса, а также для завершающих частей сегментов и внутренних индексов. Они позволяют определить, обслуживались ли чтения индексов также из кеша другого BE.
Метрики bvar на BE
Получить их можно командой curl http://<be_host>:<brpc_port>/vars (brpc_port по умолчанию равен 8060). Запрашивающая сторона (BE, инициирующий чтение):
| Метрика | Значение |
|---|---|
cached_remote_reader_peer_read | Число отправленных запросов peer read |
cached_remote_reader_s3_read | Число отправленных запросов чтения из объектного хранилища |
peer_race_peer_win / peer_race_s3_win | Число гонок чтения, выигранных другим BE / объектным хранилищем |
peer_same_compute_group_read / peer_cross_compute_group_read | Число успешных чтений peer read внутри группы / между группами |
peer_lazy_fetch_triggered | Число фоновых запросов кандидатов у FE |
peer_cache_reader_peer_latency | Задержка RPC к другому BE |
Обслуживающая сторона (BE, предоставляющий кеш):
| Метрика | Значение |
|---|---|
file_cache_get_by_peer_num / file_cache_get_by_peer_success_num / file_cache_get_by_peer_failed_num | Число полученных запросов peer read, а также число успешных и неудачных запросов |
file_cache_get_by_peer_queue_timeout_num | Запросы, отклонённые из-за ожидания в очереди дольше peer_fetch_queue_timeout_ms |
peer_server_fill_requested / peer_server_fill_success | Число запрошенных и завершённых операций заполнения кеша |
peer_server_fill_timeout / peer_server_fill_rejected | Операции заполнения кеша, завершившиеся по тайм-ауту, и операции, отклонённые из-за отсутствия свободного слота |
Как интерпретировать метрики:
cached_remote_reader_peer_readвысокое, аcached_remote_reader_s3_readнизкое: в целом peer read работает.peer_race_s3_winзаметно вышеpeer_race_peer_win: чтение с другого BE здесь не является более быстрым путём. Увеличьтеpeer_race_hedge_delay_msили отключите peer read.peer_cross_compute_group_readвысокое: выполняется передача данных между группами, поэтому следите за изоляцией.peer_server_fill_requestedвысокое, ноpeer_server_fill_successнизкое иpeer_server_fill_timeoutвысокое: вычислительная группа заполнения кеша перегружена или настроена неверно.
Просмотр и изменение сведений о кандидатах таблета
BE предоставляет интерфейс /api/peer_cache на своём webserver_port (по умолчанию 8040) для просмотра и изменения кандидатов отдельного таблета. Он предназначен главным образом для устранения неполадок.
Просмотр кандидатов, последней успешно обслужившей вычислительной группы, числа последовательных промахов и состояния временного отключения peer read для одного таблета:
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show&tablet_id=<tablet_id>"
{
    "tablet_id": 10086,
    "candidates": [
        {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01", "last_access_time_ms": 1758441600000, "consecutive_rpc_failures": 0}
    ],
    "last_successful_compute_group_id": "cg_write_01",
    "fetching_from_fe": false,
    "consecutive_all_miss": 0,
    "cooldown_until_ms": 0
}
Вывод списка всех таблетов на этом BE, для которых есть кандидаты. По умолчанию limit равен 1000:
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show_all&limit=100"
Принудительная установка кандидатов таблета (тело запроса в формате JSON):
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=set&tablet_id=<tablet_id>" \
    -H "Content-Type: application/json" \
    -d '{
        "candidates": [
            {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01"}
        ],
        "last_successful_compute_group_id": "cg_write_01",
        "consecutive_all_miss": 0,
        "cooldown_until_ms": 0
    }'
Удаление кандидатов таблета или сброс временного отключения peer read:
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=remove&tablet_id=<tablet_id>"
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=reset_cooldown&tablet_id=<tablet_id>"
Рекомендации
- Используйте вместе с прогревом кеша. Прогрев заранее получает данные из объектного хранилища; peer read получает их с других BE во время выполнения запроса. Прогрев охватывает известные вам горячие данные, а peer read обслуживает холодные чтения, не охваченные прогревом.
- Включайте peer read до масштабирования. После расширения группы или перебалансировки таблетов peer read позволяет новому BE повторно использовать кеш исходного BE. В сочетании с
balance_type = peer_read_async_warmupпривязка переключается сразу, а peer read сглаживает переход; см. Масштабирование вычислительных групп. - При разделении чтения и записи назначайте вычислительную группу записи группой заполнения кеша. Тогда при холодном чтении в группе только для чтения группа записи получает данные из объектного хранилища и сохраняет копию; см. Рекомендации по оптимизации File Cache при разделении чтения и записи.
- Отключайте peer read (
enable_cache_read_from_peer = false), если требуется строгая изоляция вычислительных групп или кластер охватывает несколько AZ и расходы на трафик между AZ существенны. - Перед настройкой изучите метрики. Используйте
PeerRaceWin/S3RaceWinи метрики bvar, чтобы понять, выигрывает ли чтение с другого BE, а затем решите, стоит ли менятьpeer_race_hedge_delay_msили отключить гонку чтений.
Часто задаваемые вопросы
Вопрос: Почему первое холодное чтение всё равно обращается к объектному хранилищу?
Если у BE ещё нет кандидатов для таблета, текущий запрос не ждёт FE. Данные читаются из объектного хранилища, а кандидаты запрашиваются в фоновом режиме. Последующие чтения того же таблета в рамках того же запроса и все последующие запросы используют peer read. На этот случай указывает значение PeerLazyFetch выше 0 в профиле.
Вопрос: Как убедиться, что запрос использовал peer read?
Проверьте NumPeerIOTotal, SameCGPeerIOTotal, CrossCGPeerIOTotal и PeerCacheNodes в профиле. На BE также должно расти значение cached_remote_reader_peer_read.
Вопрос: Можно ли разрешить peer read внутри вычислительной группы, но запретить между группами?
Пока нет. enable_cache_read_from_peer управляет обоими видами peer read, а кандидаты, возвращаемые FE, включают BE из всех вычислительных групп.
Вопрос: Как отключить peer read?
Задайте enable_cache_read_from_peer = false на каждом BE. Изменение можно применить во время работы. После этого при промахах локального кеша данные будут считываться напрямую из объектного хранилища.
Вопрос: S3RaceWin значительно выше PeerRaceWin. Что делать?
В вашей среде чтение с другого BE не быстрее чтения из объектного хранилища, обычно из-за сетевой задержки между BE или высокой нагрузки на обслуживающий BE. Попробуйте увеличить peer_race_hedge_delay_ms и понаблюдать за счётчиками либо отключите peer read.
Вопрос: Таблет никогда не использует peer read.
Выполните /api/peer_cache?op=show&tablet_id=<tablet_id>. Пустой список candidates означает, что кандидаты ещё не были получены. Ненулевое значение cooldown_until_ms означает, что peer read для таблета временно отключён; op=reset_cooldown сбрасывает это состояние.
Вопрос: Заполнение кеша другой вычислительной группы не работает.
Последовательно проверьте: peer_cache_fill_compute_group_id на запрашивающей стороне содержит идентификатор вычислительной группы, а не её имя; выбранный кандидат действительно принадлежит этой группе (compute_group_id в выводе op=show); enable_peer_server_cache_fill имеет значение true на стороне заполнения кеша; растут ли значения peer_server_fill_rejected или peer_server_fill_timeout.