Высокоскоростной канал передачи данных на основе Arrow Flight SQL
Описанная в этом документе возможность высокоскоростной передачи данных через Arrow Flight SQL сейчас является экспериментальной. Использовать её в рабочей среде не рекомендуется. Если при использовании возникнут проблемы, сообщите о них через список рассылки или задачу GitHub.
Начиная с Doris 2.1 реализован высокоскоростной канал передачи данных на основе протокола Arrow Flight SQL. Он позволяет быстро читать большие объёмы данных из Doris с помощью SQL на разных языках программирования. В некоторых сценариях производительность повышается в десятки и сотни раз по сравнению с MySQL Client или драйверами JDBC/ODBC. Arrow Flight SQL также предоставляет универсальный драйвер JDBC для взаимодействия с базами данных, поддерживающими этот протокол.
Сценарии использования
- Массовый экспорт больших объёмов данных из Doris для анализа с повышением производительности в десятки и сотни раз по сравнению с протоколом MySQL/JDBC.
- Последующий анализ данных в столбцовых форматах, таких как Apache Arrow или Pandas, когда нужно избежать затрат на преобразование строкового формата в столбцовый.
- Доступ к Doris из BI-инструментов, таких как DBeaver, по протоколу Arrow Flight SQL.
- Высокоскоростное чтение данных Doris в формате Arrow из компонентов обработки больших данных, таких как Spark и Flink.
Принцип работы
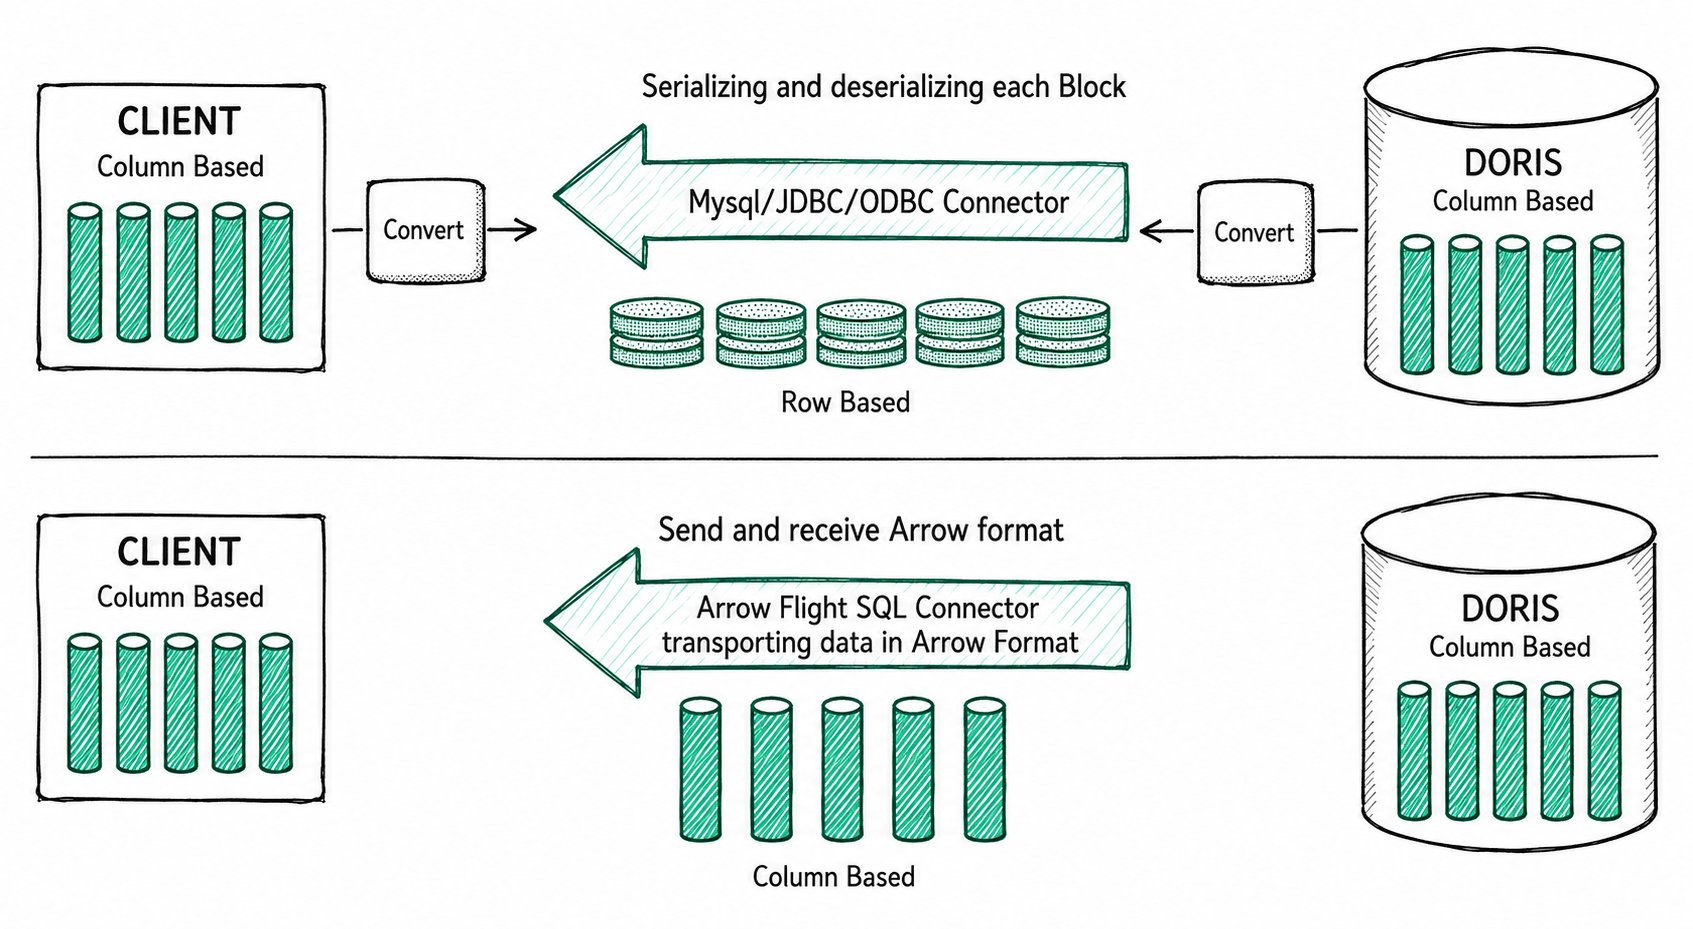
В Doris результаты запросов организованы в виде блоков Blocks в столбцовом формате. В версиях до 2.1 при передаче результатов запроса клиенту через MySQL Client или драйвер JDBC/ODBC столбцовые блоки Blocks необходимо сериализовать в строковое представление Bytes, а затем на стороне клиента десериализовать обратно в столбцовый формат.
Если клиент также поддерживает столбцовый формат Arrow, высокоскоростной канал передачи данных на основе Arrow Flight SQL позволяет полностью избежать сериализации и десериализации при передаче, устраняя связанные с ними затраты времени и ресурсов.
Дополнительные материалы:
- Официальное руководство по установке Apache Arrow: Apache Arrow
- Реализация протокола Arrow Flight в Doris: Поддержка протокола Arrow Flight SQL в Doris
Настройка на стороне сервера
Перед использованием Arrow Flight SQL необходимо включить службу Arrow Flight SQL на FE и BE Doris:
- Измените
arrow_flight_sql_portвfe/conf/fe.conf, указав свободный порт, например8070. - Измените
arrow_flight_sql_portвbe/conf/be.conf, указав свободный порт, например8050. - Перезапустите кластер.
Значения arrow_flight_sql_port в fe.conf и be.conf должны различаться.
Как проверить успешный запуск:
| Роль | Файл журнала | Ключевая строка |
|---|---|---|
| FE | fe/log/fe.log | Arrow Flight SQL service is started |
| BE | be/log/be.INFO | Arrow Flight Service bind to host |
Сопоставление типов и освобождение ресурсов начиная с 4.1.5
Начиная с версии 4.1.5 схемы Arrow сохраняют метаданные логических типов дочерних полей и сведения о допустимости NULL во вложенных значениях ARRAY / MAP / STRUCT. Для DATETIME используется метка времени без часового пояса; для TIMESTAMPTZ используется метка времени с указанием часового пояса сеанса (Z нормализуется в UTC). Разбирайте эти типы с учётом различий в семантике часовых поясов. Метки времени за пределами поддерживаемого диапазона вызывают ошибку, а не усекаются и не переходят циклически через границу диапазона.
Закрытие потока результатов до завершения чтения отменяет соответствующий запрос и освобождает ресурсы. Клиенты должны корректно закрывать Readers / Statements. Для пакетного сканирования внешних таблиц, при котором необходимо сохранять Coordinator, параметр FE arrow_flight_deferred_query_idle_timeout_second по умолчанию равен 3600 секундам. Этот срок никогда не бывает короче тайм-аута выполнения запроса, а освобождение Coordinator не закрывает сеанс.
Начиная с версии 4.1.5 запросы Arrow Flight явно обходят кэш результатов SQL протокола MySQL и сокращённый путь выполнения точечных запросов MySQL. Сами запросы выполняются в обычном режиме.
Использование в Python
Подключение к Doris через драйвер ADBC для Python позволяет читать данные с очень высокой скоростью. Требуется версия Python >= 3.9. Ниже показаны распространённые операции с базой данных через драйвер ADBC, включая DDL, DML, настройку переменных сеанса и операторы Show.
1. Установка зависимостей
Драйвер ADBC опубликован в PyPI и устанавливается через pip:
pip install adbc_driver_manager
pip install adbc_driver_flightsql
Для его использования импортируйте в код следующие модули:
import adbc_driver_manager
import adbc_driver_flightsql.dbapi as flight_sql

>>> print(adbc_driver_manager.__version__)
1.1.0
>>> print(adbc_driver_flightsql.__version__)
1.1.0
2. Установка соединения
При создании клиента для взаимодействия со службой Doris Arrow Flight SQL необходимо указать адрес FE, порт Arrow Flight, имя пользователя и пароль.
Предположим, что службы Arrow Flight SQL на FE и BE работают на портах 8070 и 8050 соответственно, а имя пользователя и пароль заданы как user/pass. Подключение выполняется следующим образом:
conn = flight_sql.connect(uri="grpc://{FE_HOST}:{fe.conf:arrow_flight_sql_port}", db_kwargs={
            adbc_driver_manager.DatabaseOptions.USERNAME.value: "user",
            adbc_driver_manager.DatabaseOptions.PASSWORD.value: "pass",
        })
cursor = conn.cursor()
После установки соединения возвращённый объект Cursor позволяет взаимодействовать с Doris через SQL: создавать таблицы, получать метаданные, загружать данные и выполнять запросы.
3. Выполнение DDL и получение метаданных
Передайте SQL функции cursor.execute(), чтобы создать таблицу и получить метаданные:
cursor.execute("DROP DATABASE IF EXISTS arrow_flight_sql FORCE;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("create database arrow_flight_sql;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show databases;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("use arrow_flight_sql;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("""CREATE TABLE arrow_flight_sql_test
    (
         k0 INT,
         k1 DOUBLE,
         K2 varchar(32) NULL DEFAULT "" COMMENT "",
         k3 DECIMAL(27,9) DEFAULT "0",
         k4 BIGINT NULL DEFAULT '10',
         k5 DATE,
    )
    DISTRIBUTED BY HASH(k5) BUCKETS 5
    PROPERTIES("replication_num" = "1");""")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show create table arrow_flight_sql_test;")
print(cursor.fetchallarrow().to_pandas())
Если StatusResult возвращает 0, запрос выполнен успешно. Такое поведение предусмотрено для совместимости с JDBC:
  StatusResult
0            0

  StatusResult
0            0

                   Database
0         __internal_schema
1          arrow_flight_sql
..                      ...
507             udf_auth_db

[508 rows x 1 columns]

  StatusResult
0            0

  StatusResult
0            0
                   Table                                       Create Table
0  arrow_flight_sql_test  CREATE TABLE `arrow_flight_sql_test` (\n  `k0`...
4. Загрузка данных
Выполните INSERT INTO, чтобы загрузить небольшой объём тестовых данных в созданную таблицу:
cursor.execute("""INSERT INTO arrow_flight_sql_test VALUES
        ('0', 0.1, "ID", 0.0001, 9999999999, '2023-10-21'),
        ('1', 0.20, "ID_1", 1.00000001, 0, '2023-10-21'),
        ('2', 3.4, "ID_1", 3.1, 123456, '2023-10-22'),
        ('3', 4, "ID", 4, 4, '2023-10-22'),
        ('4', 122345.54321, "ID", 122345.54321, 5, '2023-10-22');""")
print(cursor.fetchallarrow().to_pandas())
Следующий вывод означает, что загрузка прошла успешно:
  StatusResult
0            0
Для загрузки больших объёмов данных в Doris рекомендуется выполнять Stream Load с помощью pydoris.
5. Выполнение запросов
Выполните запросы к таблице, в которую только что загрузили данные, включая агрегацию, сортировку и установку переменной сеанса:
cursor.execute("select * from arrow_flight_sql_test order by k0;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("set exec_mem_limit=2000;")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("show variables like \"%exec_mem_limit%\";")
print(cursor.fetchallarrow().to_pandas())

cursor.execute("select k5, sum(k1), count(1), avg(k3) from arrow_flight_sql_test group by k5;")
print(cursor.fetch_df())
Вывод:
   k0            k1    K2                k3          k4          k5
0   0       0.10000    ID       0.000100000  9999999999  2023-10-21
1   1       0.20000  ID_1       1.000000010           0  2023-10-21
2   2       3.40000  ID_1       3.100000000      123456  2023-10-22
3   3       4.00000    ID       4.000000000           4  2023-10-22
4   4  122345.54321    ID  122345.543210000           5  2023-10-22

[5 rows x 6 columns]

  StatusResult
0            0

    Variable_name Value Default_Value Changed
0  exec_mem_limit  2000    2147483648       1

           k5  Nullable(Float64)_1  Int64_2 Nullable(Decimal(38, 9))_3
0  2023-10-22         122352.94321        3            40784.214403333
1  2023-10-21              0.30000        2                0.500050005

[2 rows x 5 columns]
Используйте один из следующих двух методов получения результатов запроса, чтобы сохранить данные в столбцовом формате:
cursor.fetchallarrow(): возвращает данные в формате Arrowcursor.fetch_df(): возвращает непосредственно Pandas DataFrame
Не используйте cursor.fetchall(). Этот метод преобразует столбцовые данные обратно в строковый формат, что по сути аналогично использованию mysql-client. Производительность может оказаться даже ниже, чем у mysql-client, из-за дополнительного преобразования столбцов в строки на стороне клиента.
6. Полный пример
# Doris Arrow Flight SQL Test

# step 1, library is released on PyPI and can be easily installed.
# pip install adbc_driver_manager
# pip install adbc_driver_flightsql
import adbc_driver_manager
import adbc_driver_flightsql.dbapi as flight_sql

# step 2, create a client that interacts with the Doris Arrow Flight SQL service.
# Modify arrow_flight_sql_port in fe/conf/fe.conf to an available port, such as 8070.
# Modify arrow_flight_sql_port in be/conf/be.conf to an available port, such as 8050.
conn = flight_sql.connect(uri="grpc://{FE_HOST}:{fe.conf:arrow_flight_sql_port}", db_kwargs={
            adbc_driver_manager.DatabaseOptions.USERNAME.value: "root",
            adbc_driver_manager.DatabaseOptions.PASSWORD.value: "",
        })
cursor = conn.cursor()

# interacting with Doris via SQL using Cursor
def execute(sql):
    print("\n### execute query: ###\n " + sql)
    cursor.execute(sql)
    print("### result: ###")
    print(cursor.fetchallarrow().to_pandas())

# step3, execute DDL statements, create database/table, show stmt.
execute("DROP DATABASE IF EXISTS arrow_flight_sql FORCE;")
execute("show databases;")
execute("create database arrow_flight_sql;")
execute("show databases;")
execute("use arrow_flight_sql;")
execute("""CREATE TABLE arrow_flight_sql_test
    (
         k0 INT,
         k1 DOUBLE,
         K2 varchar(32) NULL DEFAULT "" COMMENT "",
         k3 DECIMAL(27,9) DEFAULT "0",
         k4 BIGINT NULL DEFAULT '10',
         k5 DATE,
    )
    DISTRIBUTED BY HASH(k5) BUCKETS 5
    PROPERTIES("replication_num" = "1");""")
execute("show create table arrow_flight_sql_test;")


# step4, insert into
execute("""INSERT INTO arrow_flight_sql_test VALUES
        ('0', 0.1, "ID", 0.0001, 9999999999, '2023-10-21'),
        ('1', 0.20, "ID_1", 1.00000001, 0, '2023-10-21'),
        ('2', 3.4, "ID_1", 3.1, 123456, '2023-10-22'),
        ('3', 4, "ID", 4, 4, '2023-10-22'),
        ('4', 122345.54321, "ID", 122345.54321, 5, '2023-10-22');""")


# step5, execute queries, aggregation, sort, set session variable
execute("select * from arrow_flight_sql_test order by k0;")
execute("set exec_mem_limit=2000;")
execute("show variables like \"%exec_mem_limit%\";")
execute("select k5, sum(k1), count(1), avg(k3) from arrow_flight_sql_test group by k5;")

# step6, close cursor
cursor.close()
Использование в Java
В Java доступны три варианта подключения. Их особенности и рекомендации по выбору приведены ниже:
| Способ подключения | Формат URL | Формат результата | Рекомендуемый сценарий |
|---|---|---|---|
JDBC (jdbc:arrow-flight-sql) | jdbc:arrow-flight-sql://... | JDBC ResultSet (строки) | Для последующего анализа нужен строковый формат либо требуется совместимость с BI-инструментами или существующим кодом JDBC |
| Flight ADBC Driver | grpc://... | Arrow (столбцовый) | Для последующего анализа используется Arrow / столбцовый формат, приоритетом является максимальная производительность |
| Flight JDBC Driver (обёртка ADBC) | jdbc:arrow-flight-sql://... | Arrow (столбцовый) | То же, что для Flight ADBC Driver, но в проекте необходимо сохранить формат URL jdbc:arrow-flight-sql |
Чтобы проверить производительность разных способов подключения, воспользуйтесь примером JDBC/Java Arrow Flight SQL. Ожидаемые результаты описаны в Добавление примера Arrow Flight SQL для Java. Сравнение производительности способов подключения Java Arrow Flight SQL и традиционного jdbc:mysql приведено в задаче GitHub 25514 (раздел 6.2).
Дополнительные рекомендации:
- Как для JDBC
ResultSet, так и для данных Arrow разбор занимает больше времени, чем само чтение данных. Если Arrow Flight SQL даёт лишь небольшой прирост по сравнению сjdbc:mysql://, сначала проверьте, не занимает ли этап разбора данных слишком много времени. - При любом способе подключения JDK 17 читает данные быстрее, чем JDK 1.8.
- При очень больших объёмах данных Arrow Flight SQL использует меньше памяти, чем
jdbc:mysql://. При ограниченной памяти сначала попробуйте Arrow Flight SQL. - Помимо трёх способов выше, можно использовать нативный
FlightClientдля прямого подключения к серверу Arrow Flight. Он более гибок и поддерживает параллельное чтение из нескольких Endpoints. Сам Flight ADBC Driver создаёт подключения на основеFlightClient, и работать с ним проще, чем напрямую сFlightClient.
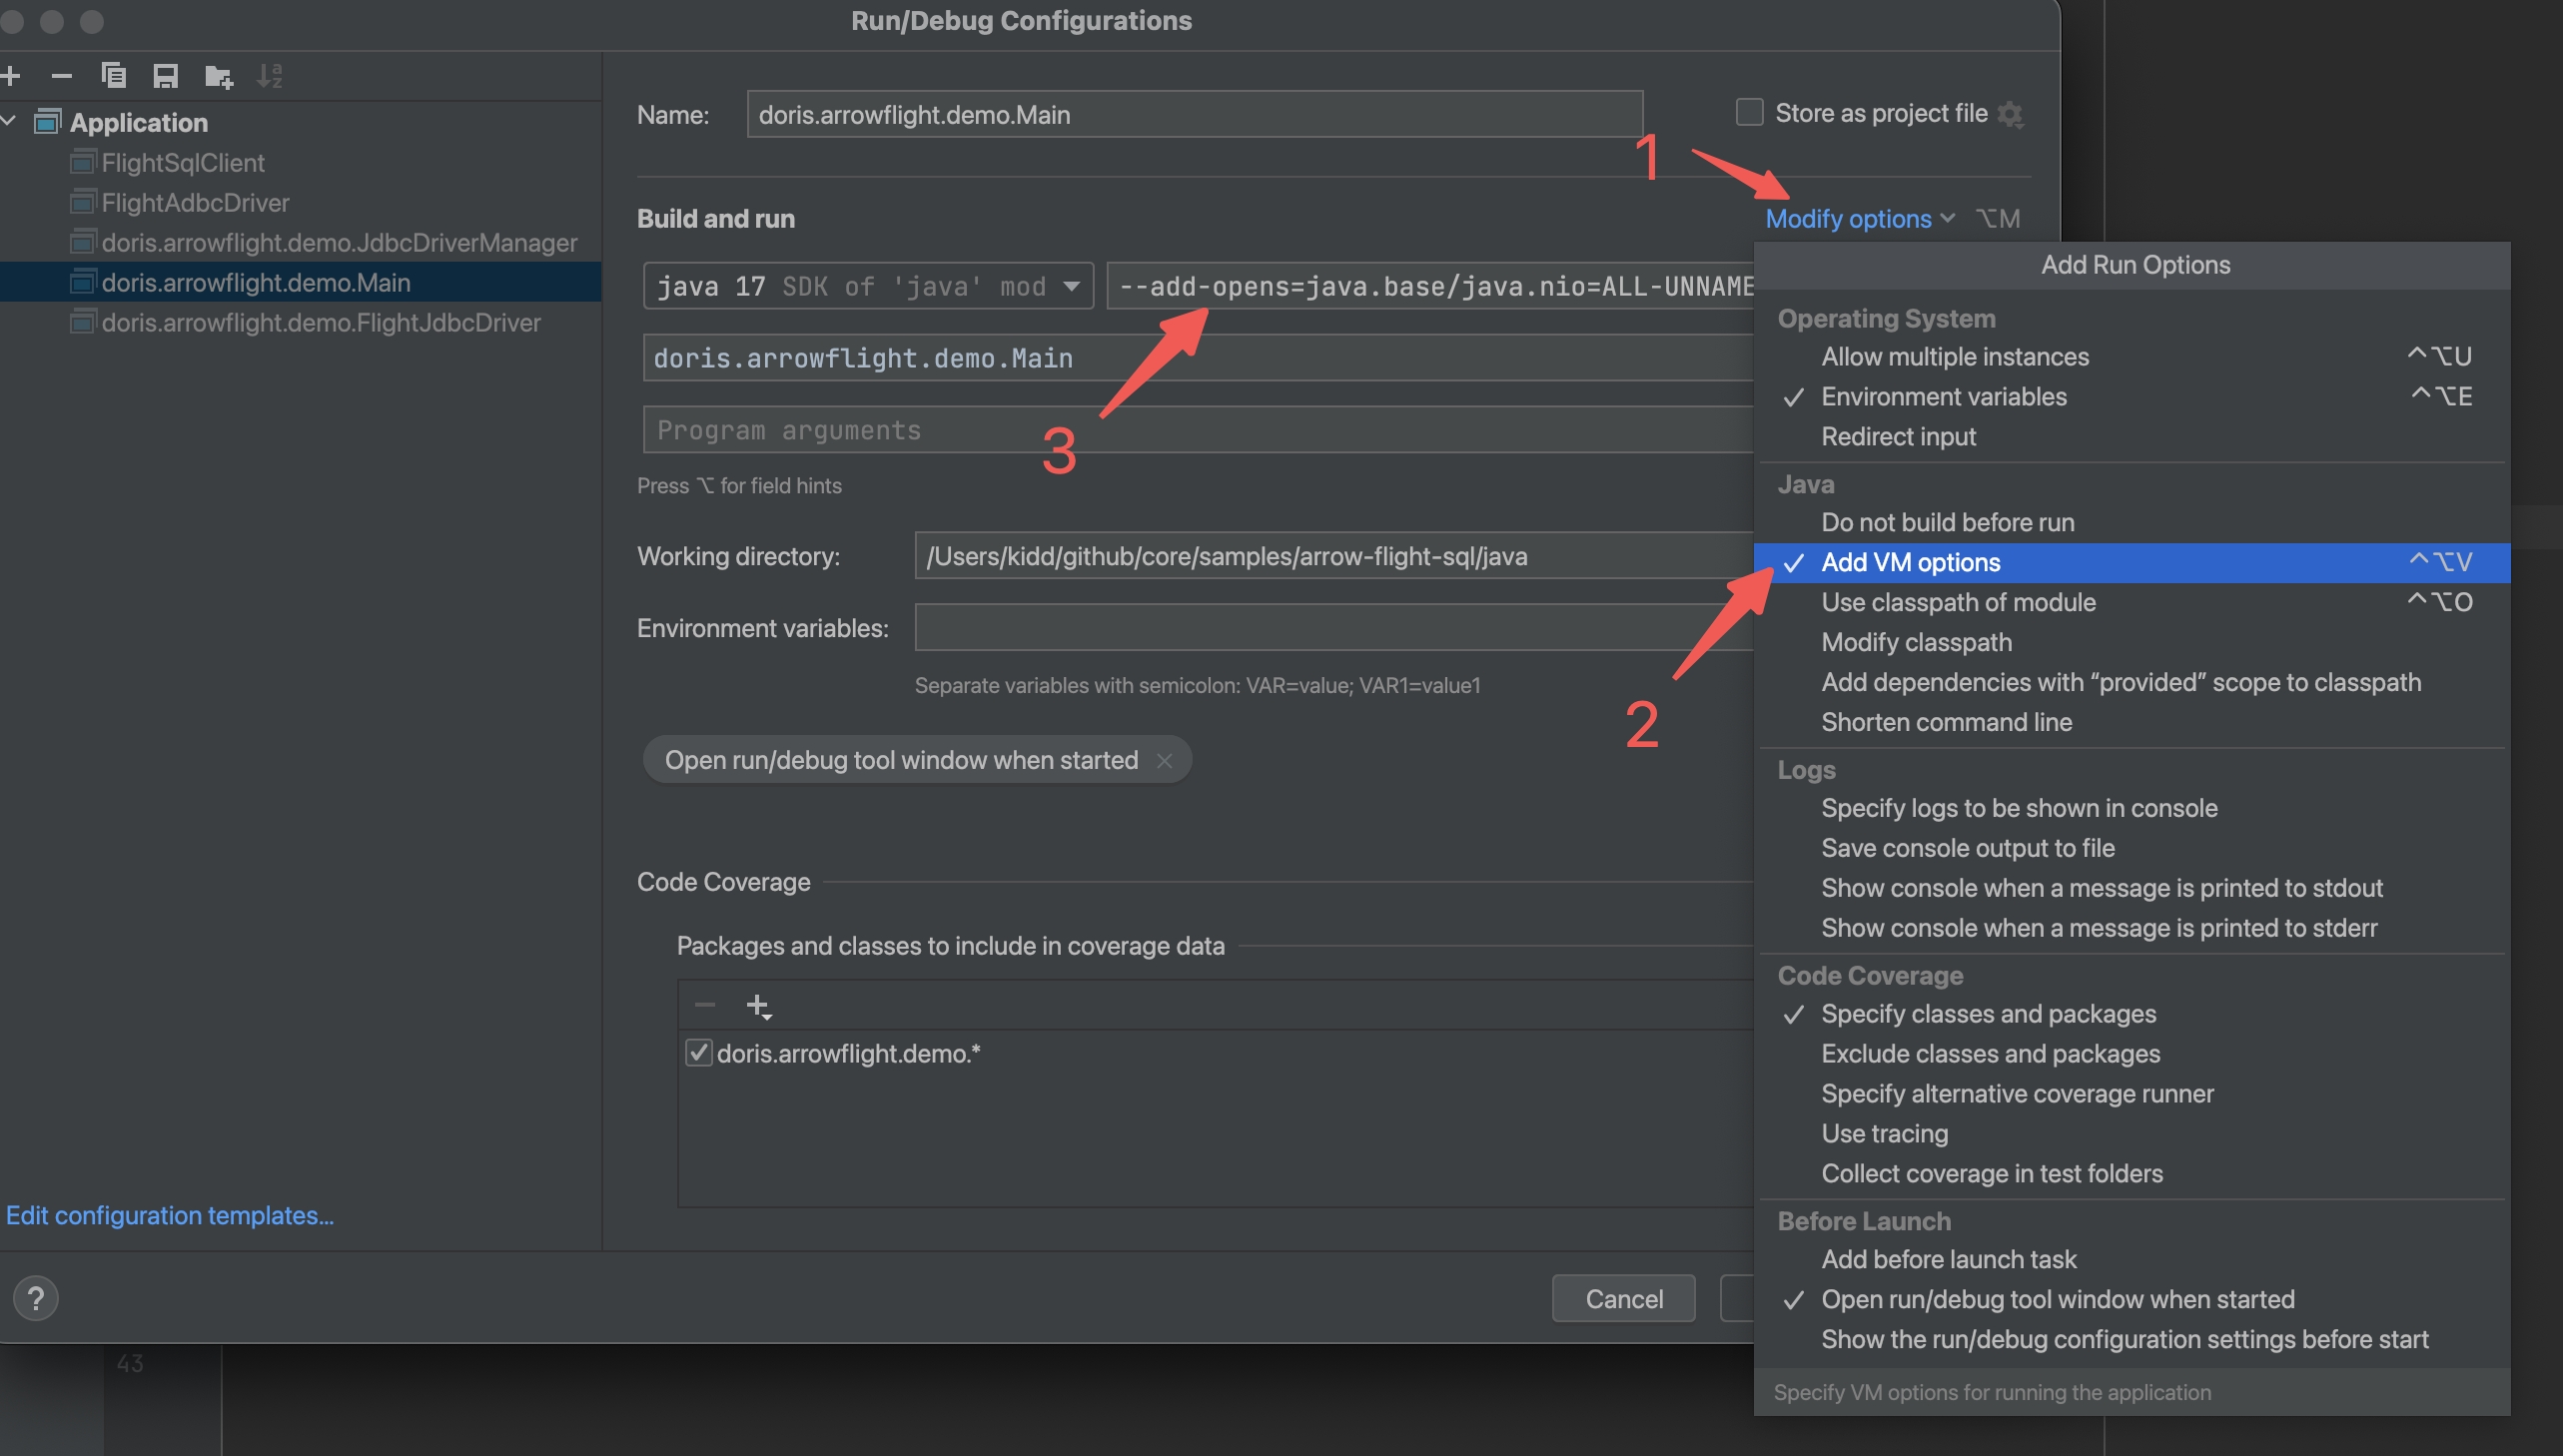
При использовании Java 9 или более поздней версии необходимо добавить --add-opens=java.base/java.nio=ALL-UNNAMED в команду Java, чтобы открыть доступ к некоторым внутренним компонентам JDK. Иначе возникнет одна из следующих ошибок:
module java.base does not "opens java.nio" to unnamed modulemodule java.base does not "opens java.nio" to org.apache.arrow.memory.corejava.lang.NoClassDefFoundError: Could not initialize class org.apache.arrow.memory.util.MemoryUtil (Internal; Prepare)
Добавить этот параметр можно двумя способами:
# Option 1: Add via command-line argument directly
$ java --add-opens=java.base/java.nio=ALL-UNNAMED -jar ...

# Option 2: Add via environment variable
$ env _JAVA_OPTIONS="--add-opens=java.base/java.nio=ALL-UNNAMED" java -jar ...
При отладке в IntelliJ IDEA добавьте этот аргумент в разделе Build and run окна Run/Debug Configurations. См. рисунок ниже:
Вариант 1: jdbc:arrow-flight-sql
Драйвер JDBC с открытым исходным кодом для протокола Arrow Flight SQL совместим со стандартным JDBC API. Он позволяет большинству BI-инструментов обращаться к Doris через JDBC и поддерживает высокоскоростную передачу данных Apache Arrow. Используется он аналогично драйверу MySQL JDBC: достаточно заменить протокол jdbc:mysql в URL подключения на jdbc:arrow-flight-sql. Результаты запросов по-прежнему возвращаются в виде структуры данных JDBC ResultSet.
Зависимости POM:
<properties>
    <arrow.version>17.0.0</arrow.version>
</properties>
<dependencies>
    <dependency>
        <groupId>org.apache.arrow</groupId>
        <artifactId>flight-sql-jdbc-core</artifactId>
        <version>${arrow.version}</version>
    </dependency>
</dependencies>
Пример кода подключения:
import java.sql.Connection;
import java.sql.DriverManager;
import java.sql.ResultSet;
import java.sql.Statement;

Class.forName("org.apache.arrow.driver.jdbc.ArrowFlightJdbcDriver");
String DB_URL = "jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}?useServerPrepStmts=false"
        + "&cachePrepStmts=true&useSSL=false&useEncryption=false";
String USER = "root";
String PASS = "";

Connection conn = DriverManager.getConnection(DB_URL, USER, PASS);
Statement stmt = conn.createStatement();
ResultSet resultSet = stmt.executeQuery("select * from information_schema.tables;");
while (resultSet.next()) {
    System.out.println(resultSet.toString());
}

resultSet.close();
stmt.close();
conn.close();
Вариант 2: Flight ADBC Driver / Flight JDBC Driver
Помимо использования JDBC, в Java можно создать драйвер для прямого чтения из Doris с возвратом данных в формате Arrow. Следующие примеры показывают подключение к серверу Doris Arrow Flight через драйвер ADBC и драйвер JDBC (обёртку ADBC).
Зависимости POM:
<properties>
    <adbc.version>0.15.0</adbc.version>
</properties>

<dependencies>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-jdbc</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-core</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-manager</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-sql</artifactId>
        <version>${adbc.version}</version>
    </dependency>
    <dependency>
        <groupId>org.apache.arrow.adbc</groupId>
        <artifactId>adbc-driver-flight-sql</artifactId>
        <version>${adbc.version}</version>
    </dependency>
</dependencies>
Flight ADBC Driver
Пример кода подключения:
// 1. new driver
final BufferAllocator allocator = new RootAllocator();
FlightSqlDriver driver = new FlightSqlDriver(allocator);
Map<String, Object> parameters = new HashMap<>();
AdbcDriver.PARAM_URI.set(parameters, Location.forGrpcInsecure("{FE_HOST}", {fe.conf:arrow_flight_sql_port}).getUri().toString());
AdbcDriver.PARAM_USERNAME.set(parameters, "root");
AdbcDriver.PARAM_PASSWORD.set(parameters, "");
AdbcDatabase adbcDatabase = driver.open(parameters);

// 2. new connection
AdbcConnection connection = adbcDatabase.connect();
AdbcStatement stmt = connection.createStatement();

// 3. execute query
stmt.setSqlQuery("select * from information_schema.tables;");
QueryResult queryResult = stmt.executeQuery();
ArrowReader reader = queryResult.getReader();

// 4. load result
List<String> result = new ArrayList<>();
while (reader.loadNextBatch()) {
    VectorSchemaRoot root = reader.getVectorSchemaRoot();
    String tsvString = root.contentToTSVString();
    result.add(tsvString);
}
System.out.printf("batchs %d\n", result.size());

// 5. close
reader.close();
queryResult.close();
stmt.close();
connection.close();
Flight JDBC Driver (обёртка ADBC)
Пример кода подключения:
final Map<String, Object> parameters = new HashMap<>();
AdbcDriver.PARAM_URI.set(
        parameters,"jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}?useServerPrepStmts=false&cachePrepStmts=true&useSSL=false&useEncryption=false");
AdbcDriver.PARAM_USERNAME.set(parameters, "root");
AdbcDriver.PARAM_PASSWORD.set(parameters, "");
try (
        BufferAllocator allocator = new RootAllocator();
        AdbcDatabase db = new JdbcDriver(allocator).open(parameters);
        AdbcConnection connection = db.connect();
        AdbcStatement stmt = connection.createStatement()
) {
    stmt.setSqlQuery("select * from information_schema.tables;");
    AdbcStatement.QueryResult queryResult = stmt.executeQuery();
    ArrowReader reader = queryResult.getReader();
    List<String> result = new ArrayList<>();
    while (reader.loadNextBatch()) {
        VectorSchemaRoot root = reader.getVectorSchemaRoot();
        String tsvString = root.contentToTSVString();
        result.add(tsvString);
    }
    long etime = System.currentTimeMillis();
    System.out.printf("batchs %d\n", result.size());

    reader.close();
    queryResult.close();
    stmt.close();
}  catch (Exception e) {
    e.printStackTrace();
}
Сопоставление типов
Начиная с версии 4.1.4 значения DATETIME / DATETIMEV2, возвращаемые Arrow Flight SQL, являются метками времени Arrow без часового пояса, а TIMESTAMPTZ по-прежнему возвращается как метка времени с часовым поясом.
До 4.1.4 тип DATETIME помечался как учитывающий часовой пояс, поэтому клиент при разборе в своём локальном часовом поясе применял дополнительное смещение. После обновления разбирайте столбцы DATETIME как значения местного времени без часового пояса.
В этой же версии исправлены следующие метаданные типов:
- В конечной точке метаданных
GetTablesтип Arrow дляDATEV2исправлен сDate(MILLISECOND)наDate(DAY). - Метаданные
ARRAY/MAP/STRUCTтеперь содержат реальные типы дочерних полей вместо типов-заглушек.
Интеграция со сторонними компонентами
BI-инструменты (DBeaver и другие)
Начиная с Doris v2.1.8 BI-инструменты, такие как DBeaver, могут подключаться к Doris по протоколу arrow-flight-sql. Инструкции по настройке:
Spark и Flink
У Arrow Flight официально нет планов по поддержке Spark и Flink (см. задачу GitHub). Однако начиная с версии 24.0.0 следующие коннекторы поддерживают доступ к Doris через Arrow Flight SQL, что, как ожидается, увеличит производительность чтения в несколько раз:
Ранее сообщество использовало Spark-Flight-Connector для проверки подключения к Doris через FlightClient в Spark. Выводы:
- Преобразование между Arrow и Doris Block в 10 раз быстрее, чем преобразование между CSV и Doris Block.
- Arrow лучше поддерживает сложные типы, такие как Map и Array.
- Данные Arrow хорошо сжимаются, что снижает сетевые затраты при передаче.
Однако в Doris Arrow Flight пока не реализовано параллельное чтение с нескольких узлов. Перед возвратом результаты запроса по-прежнему собираются на одном узле BE. При простом массовом экспорте данных производительность может быть ниже, чем у Doris Spark Connector, который поддерживает параллельное чтение на уровне Tablet.
Если вы хотите подключаться к Doris через Arrow Flight SQL в Spark, для самостоятельной реализации можно использовать следующие проекты с открытым исходным кодом:
Расширенная настройка
Параллельный возврат результатов с нескольких BE
По умолчанию Doris собирает результаты запроса со всех узлов BE на одном узле BE. Поведение при разных протоколах:
- Запрос MySQL/JDBC: FE запрашивает результат у узла BE, на котором собраны данные.
- Запрос Arrow Flight SQL: FE включает IP-адрес и порт этого узла BE в Endpoint и возвращает его клиенту ADBC. Затем клиент ADBC запрашивает данные из этого Endpoint.
Сценарий 1: простое чтение SELECT (без Join/Sort/оконных функций)
Если запрос представляет собой простой SELECT, который читает данные из Doris без операторов перераспределения данных, таких как Join, Sort или оконные функции, запрос можно разделить на уровне Tablet. Doris Spark/Flink Connector реализует параллельное чтение по этому принципу в два этапа:
-
Выполните
EXPLAIN SQL. План запроса, возвращённый FE, содержит полный список идентификаторов Tablet в ScanOperator. -
На основе этого списка идентификаторов Tablet разделите исходный SQL на несколько операторов SQL, каждый из которых читает только часть Tablet, например:
SELECT * FROM t1 TABLET(10001,10002) limit 1000;Полученные операторы SQL можно выполнять параллельно. Подробнее см. Поддержка выборки из таблицы.
Сценарий 2: запросы с агрегацией на внешнем уровне
Для запроса вида select k1, sum(k2) from xxx group by k1 начиная с Doris v3.0.4 можно использовать следующую настройку, чтобы каждый узел BE возвращал свой результат независимо:
set enable_parallel_result_sink=true;
Получив список Endpoints от FE, клиент ADBC параллельно забирает результаты с нескольких узлов BE. Подробности реализации см. в Поддержка параллельного возврата результатов.
Если результат агрегации невелик, возврат данных с нескольких BE увеличивает нагрузку RPC.
Теоретически параллельный возврат результатов с отдельных узлов BE можно поддержать для любого запроса, кроме запросов с сортировкой на внешнем уровне. Эта возможность пока не реализована.
Несколько BE с общим внешним IP-адресом
Возможна топология развёртывания, при которой узел FE доступен извне кластера, а все узлы BE доступны только внутри него.
- Подключение к Doris через MySQL Client или JDBC и выполнение запросов работают, поскольку результаты возвращает FE.
- При подключении к Doris через Arrow Flight SQL запросы не выполняются, поскольку клиенту ADBC необходимо напрямую подключаться к узлам BE для получения результатов.
В рабочей среде открывать узлы BE для доступа извне кластера обычно неудобно. Перед всеми узлами BE можно разместить обратный прокси, например Nginx: внешние клиенты будут подключаться к Nginx, который направит их на случайный узел BE. Однако по умолчанию результаты запроса Arrow Flight SQL хранятся на случайно выбранном узле BE. Если Nginx направит запрос на другой узел BE, потребуется дополнительная внутренняя пересылка данных между BE.
Начиная с Doris v2.1.8 в public_host и arrow_flight_sql_proxy_port файла be.conf на всех узлах BE можно указать внешний IP-адрес и порт, общие для нескольких узлов BE. Результаты запроса будут корректно перенаправлены и возвращены клиенту ADBC:
public_host={nginx ip}
arrow_flight_sql_proxy_port={nginx port}
Часто задаваемые вопросы
1. Ошибка i/o timeout
Вопрос: Полное сообщение об ошибке: connection error: desc = "transport: Error while dialing: dial tcp <ip:arrow_flight_port>: i/o timeout".
Ответ: Порядок диагностики зависит от того, какому узлу соответствует <ip:arrow_flight_port> в сообщении об ошибке. Возможны два случая.
Случай 1: <ip:arrow_flight_port> соответствует IP-адресу и arrow_flight_port узла FE
- Проверьте, успешно ли запустился сервер Arrow Flight на узле FE. Наличие строки
Arrow Flight SQL service is startedвfe/log/fe.logозначает успешный запуск. - Если сервер Arrow Flight на FE запустился нормально, проверьте, доступен ли этот IP-адрес с клиентской машины с помощью
ping. Если нет, необходимо предоставить узлу FE внешний доступный IP-адрес и повторно развернуть кластер.
Случай 2: <ip:arrow_flight_port> соответствует IP-адресу и arrow_flight_port узла BE
- Проверьте, успешно ли запустился сервер Arrow Flight на узле BE. Наличие строки
Arrow Flight Service bind to hostвbe/log/be.INFOозначает успешный запуск. - Если сервер Arrow Flight на BE запустился нормально, проверьте, доступен ли этот IP-адрес с клиентской машины с помощью
ping.
Если известно, что узел BE находится во внутренней сети кластера, используйте один из следующих двух способов:
- Предоставьте каждому узлу BE внешний доступный IP-адрес. Начиная с Doris v2.1.8 укажите этот IP-адрес в
public_hostфайлаbe.confсоответствующего узла BE. Аналогично настройтеpublic_hostна всех узлах BE, указав для каждого доступный клиенту IP-адрес. - Добавьте обратный прокси перед всеми узлами BE, как описано в разделе Несколько BE с общим внешним IP-адресом.
Если вы не уверены, что BE полностью находится во внутренней сети, выполните следующие проверки:
- На машине узла BE выполните
ifconfig, чтобы получить все IP-адреса. Один из них должен совпадать с IP-адресом в<ip:arrow_flight_port>и IP-адресом, который выводитshow backends. - С помощью
pingпо очереди проверьте каждый из остальных IP-адресов, возвращённыхifconfig. - Если какой-либо IP-адрес доступен клиенту, укажите его в
public_host. Если ни один адрес недоступен, узел BE полностью находится во внутренней сети.
2. Ошибка module java.base does not "opens java.nio"... при подключении к Arrow Flight SQL через JDBC или Java
Вопрос: Полное сообщение об ошибке может быть одним из следующих:
module java.base does not "opens java.nio" to unnamed modulemodule java.base does not "opens java.nio" to org.apache.arrow.memory.corejava.lang.NoClassDefFoundError: Could not initialize class org.apache.arrow.memory.util.MemoryUtil (Internal; Prepare)
Ответ: Выполните следующие действия:
- Проверьте, содержит ли
JAVA_OPTS_FOR_JDK_17вfe/conf/fe.confпараметр--add-opens=java.base/java.nio=ALL-UNNAMED. Если нет, добавьте его. - Следуя примечаниям в разделе Использование в Java, добавьте
--add-opens=java.base/java.nio=ALL-UNNAMEDв команду Java. - При отладке в IntelliJ IDEA добавьте
--add-opens=java.base/java.nio=ALL-UNNAMEDв разделеBuild and runокнаRun/Debug Configurations.
3. Ошибка arrow flight schema timeout в средах ARM
Вопрос: Полное сообщение об ошибке: get flight info statement failed, arrow flight schema timeout, TimeoutException: Waited 5000 milliseconds for io.grpc.stub.Client.
Ответ: Если версия ядра Linux <= 4.19.90, необходимо обновить её до 4.19.279 или более поздней версии либо пересобрать Doris BE в среде со старой версией ядра Linux. Конкретный способ сборки описан в документе docs/dev/install/source-install/compilation-arm.
Причина: Старые ядра Linux имеют проблемы совместимости с Arrow. Вызов cpp: arrow::RecordBatch::MakeEmpty() зависает при создании Arrow Record Batch, поэтому сервер Arrow Flight на BE не отвечает на RPC-запрос FE в течение 5000 мс. В результате FE возвращает клиенту ошибку тайм-аута RPC. При чтении из Doris Spark и Flink также преобразуют результаты запросов в Arrow Record Batches перед возвратом, поэтому эта проблема затрагивает и их.
На KylinV10 SP2 и SP3 максимальная доступная версия ядра Linux составляет 4.19.90-24.4.v2101.ky10.aarch64, и дальнейшее обновление невозможно. Единственный вариант: пересобрать Doris BE на KylinV10. Если проблема сохраняется после сборки с новым ldb_toolchain, попробуйте сборку со старым ldb_toolchain v0.17. Если ваша среда ARM не имеет доступа к интернету, Huawei Cloud предоставляет ARM + KylinV10, а Alibaba Cloud предоставляет x86 + KylinV10.
4. Как изменить размер пакета при чтении через jdbc:arrow-flight-sql
Вопрос: В некоторых сценариях для повышения производительности необходимо изменить размер пакета.
Ответ: Измените setTargetBatchSize в методе makeJdbcConfig класса org.apache.arrow.adbc.driver.jdbc.JdbcArrowReader (по умолчанию 1024), затем сохраните изменённый файл в локальном каталоге с тем же путём. Он заменит исходный файл, и изменение вступит в силу.
5. ADBC v0.10 не поддерживает параллельное чтение
Вопрос: Поддерживают ли JDBC и Java ADBC/JDBC Driver в ADBC v0.10 параллельное чтение?
Ответ: Нет, поскольку метод stmt.executePartitioned() не реализован. Единственный вариант: использовать нативный FlightClient для реализации параллельного чтения из нескольких Endpoints. Последовательность вызовов выглядит так:
sqlClient = new FlightSqlClient
execute   = sqlClient.execute(sql)
endpoints = execute.getEndpoints()
for (FlightEndpoint endpoint : endpoints) { ... }
Кроме того, стандартный AdbcStatement в ADBC v0.10 фактически является JdbcStatement. После executeQuery строковый JDBC ResultSet преобразуется обратно в столбцовый формат Arrow. Ожидается, что в ADBC 1.0.0 функциональность Java ADBC будет более полной. Подробнее см. задачу GitHub.
6. Указание имени базы данных в URL
Вопрос: Можно ли указать имя базы данных в URL?
Ответ: В Arrow v15.0 коннектор Arrow JDBC Connector не поддерживает указание имени базы данных в URL. Например, указание базы данных test в jdbc:arrow-flight-sql://{FE_HOST}:{fe.conf:arrow_flight_sql_port}/test?useServerPrepStmts=false не даёт эффекта. Необходимо вручную выполнить SQL use database. Arrow v18.0 поддерживает указание имени базы данных в URL, но на практике ошибки пока сохраняются.
7. Python ADBC выводит предупреждение Cannot disable autocommit
Вопрос: Полный текст предупреждения: Warning: Cannot disable autocommit; conn will not be DB-API 2.0 compliant.
Ответ: При использовании Python это предупреждение можно игнорировать. Оно связано с проблемой клиента Python ADBC и не влияет на запросы.
8. Ошибка Python grpc: received message larger than max
Вопрос: Полное сообщение об ошибке: grpc: received message larger than max (20748753 vs. 16777216).
Ответ: См. Python: ошибка grpc: received message larger than max #2078 и добавьте adbc_driver_flightsql.DatabaseOptions.WITH_MAX_MSG_SIZE.value в параметры базы данных.
9. Ошибка invalid bearer token
Вопрос: Клиент сообщает об ошибке invalid bearer token.
Ответ: Можно выполнить следующие действия:
-
Измените максимальное число соединений для текущего пользователя:
SET PROPERTY FOR 'root' 'max_user_connections' = '10000'; -
Добавьте следующие два параметра в
fe.confи перезапустите FE:qe_max_connection=30000
arrow_flight_token_cache_size=8000
Причина: механизм сохранения долгоживущих соединений
Соединение между клиентом ADBC и сервером Arrow Flight по сути является долгоживущим. Токен аутентификации, соединение и сеанс необходимо кэшировать на сервере. Созданное соединение не закрывается сразу после завершения отдельного запроса. Для его очистки клиент должен отправить запрос close(). На практике клиент часто не отправляет close(), поэтому токен аутентификации, соединение и сеанс долго остаются на сервере. По умолчанию срок их действия истекает через 3 дня, либо они вытесняются по алгоритму LRU, когда число соединений превышает ограничение arrow_flight_token_cache_size.
Причина: слишком низкое ограничение числа соединений по умолчанию
В Doris v2.1.8 соединения Arrow Flight и MySQL/JDBC используют общие ограничения числа соединений, в том числе:
- Общее число соединений всех пользователей на FE:
qe_max_connection, по умолчанию1024. - Число соединений на пользователя:
max_user_connectionsвUserProperty, по умолчанию100.
Arrow Flight SQL часто используется вместо JDBC, однако соединения JDBC освобождаются сразу после завершения запроса. Поэтому при использовании Arrow Flight SQL стандартные ограничения числа соединений в Doris оказываются слишком низкими. Число соединений часто превышает arrow_flight_token_cache_size, что приводит к вытеснению соединений, которые ещё используются.
10. Чтение типа Datetime через JDBC или Java возвращает метку времени
Вопрос: При чтении типа Datetime через JDBC или Java с подключением к Arrow Flight SQL возвращается метка времени (например, 1740993808) вместо времени в отформатированном виде (например, 2025-03-03 17:23:28Z).
Ответ: При чтении типа Datetime через JDBC или Java с подключением к Arrow Flight SQL метку времени необходимо преобразовать самостоятельно. См. Добавление разбора типа datetime в пример Arrow Flight SQL для Java #48578. Для типа Datetime Python Arrow Flight SQL возвращает 2025-03-03 17:23:28Z, а JDBC или Java возвращает 1740993808.
11. Ошибка JDBC или клиента Java JDBC при чтении вложенных типов Array
Вопрос: Полное сообщение об ошибке: Configuration does not provide a mapping for array column 2.
Ответ: Рекомендуется перейти на клиент Java ADBC, используя пример sample/arrow-flight-sql.
Клиент Python ADBC, клиент Java ADBC и Java JDBC DriverManager читают вложенные типы Array без проблем. Ошибка возникает только при подключении к Arrow Flight SQL через JDBC или клиент Java JDBC. Arrow Flight JDBC разрабатывается не самим проектом Arrow, а сторонней компанией Dremio, занимающейся базами данных, и имеет более слабую совместимость. Ранее обнаруживались и другие проблемы совместимости, поэтому предпочтительно использовать клиент Java ADBC.