BigQuery
В этом документе описана миграция данных из Google BigQuery в Apache Doris. В процессе миграции объектное хранилище используется для промежуточного хранения данных:
- С помощью оператора Export в BigQuery экспортируйте данные в GCS (Google Cloud Storage).
- Создайте соответствующую целевую таблицу в Doris.
- С помощью функции S3 Load в Doris загрузите данные из GCS в Doris. Подробнее о механизме загрузки см. в разделе S3 Load.
Примечания
Перед началом миграции обратите внимание на следующие моменты, чтобы избежать распространённых проблем:
- Проектирование схемы таблицы: выберите подходящую модель данных Doris, а также стратегии секционирования и бакетирования с учётом схемы таблицы BigQuery. Дополнительные рекомендации по созданию таблиц см. в разделе Рекомендации по загрузке.
- Экспорт типа JSON: BigQuery не поддерживает экспорт типов JSON в формате Parquet. Используйте для экспорта формат JSON.
- Экспорт типа Time: при экспорте типа Time из BigQuery сначала преобразуйте его в String.
- Импорт сложных типов: для файлов Parquet/ORC, содержащих сложные типы (Struct/Array/Map), в настоящее время необходимо использовать TVF Load.
Сопоставление типов данных
Перед миграцией создайте в Doris столбцы, соответствующие полям BigQuery, по следующим правилам:
| BigQuery | Doris | Примечания |
|---|---|---|
| Array | Array | |
| BOOLEAN | BOOLEAN | |
| DATE | DATE | |
| DATETIME/TIMESTAMP | DATETIME | |
| JSON | JSON | |
| INT64 | BIGINT | |
| NUMERIC | DECIMAL | |
| FLOAT64 | DOUBLE | |
| STRING | VARCHAR/STRING | Максимальная длина VARCHAR — 65535 |
| STRUCT | STRUCT | |
| TIME | STRING | Перед экспортом преобразуйте в String |
| OTHER | UNSUPPORTED | Типы, которые пока не поддерживаются |
Этапы миграции
Шаг 1: создание целевой таблицы в Doris
Перед миграцией таблицы BigQuery в Doris создайте в Doris таблицу с соответствующей схемой.
Предположим, что в BigQuery уже существуют следующая таблица и тестовые данные:
CREATE OR REPLACE TABLE test.sales_data (
    order_id      INT64,
    customer_name STRING,
    order_date    DATE,
    amount        NUMERIC(10,2),
    country       STRING
)
PARTITION BY  order_date;


INSERT INTO test.sales_data (order_id, customer_name, order_date, amount, country) VALUES
(1, 'Alice', '2025-04-08', 99.99, 'USA'),
(2, 'Bob', '2025-04-08', 149.50, 'Canada'),
(3, 'Charlie', '2025-04-09', 75.00, 'UK'),
(4, 'Diana', '2025-04-10', 200.00, 'Australia');
На основе этой схемы можно создать в Doris секционированную таблицу с уникальным ключом. Столбец секционирования совпадает со столбцом секционирования в BigQuery, а таблица разбивается на секции по дням:
CREATE TABLE `sales_data` (
  order_id      INT,
  order_date    DATE NOT NULL,
  customer_name VARCHAR(128),
  amount        DECIMAL(10,2),
  country       VARCHAR(48)
) ENGINE=OLAP
UNIQUE KEY(`order_id`,`order_date`)
PARTITION BY RANGE(`order_date`) (
PARTITION p20250408 VALUES [('2025-04-08'), ('2025-04-09')),
PARTITION p20250409 VALUES [('2025-04-09'), ('2025-04-10')),
PARTITION p20250410 VALUES [('2025-04-10'), ('2025-04-11'))
)
DISTRIBUTED BY HASH(`order_id`) BUCKETS 16
PROPERTIES (
 "dynamic_partition.enable" = "true",
 "dynamic_partition.time_unit" = "DAY",
 "dynamic_partition.end" = "5",
 "dynamic_partition.prefix" = "p",
 "dynamic_partition.buckets" = "16",
 "replication_num" = "1"
);
Шаг 2: экспорт данных BigQuery в GCS
2.1 Экспорт файлов Parquet с помощью оператора Export
С помощью оператора EXPORT DATA в BigQuery экспортируйте целевую таблицу в GCS:
EXPORT DATA
  OPTIONS (
    uri = 'gs://mybucket/export/sales_data/*.parquet',
    format = 'PARQUET')
AS (
  SELECT *
  FROM test.sales_data
);
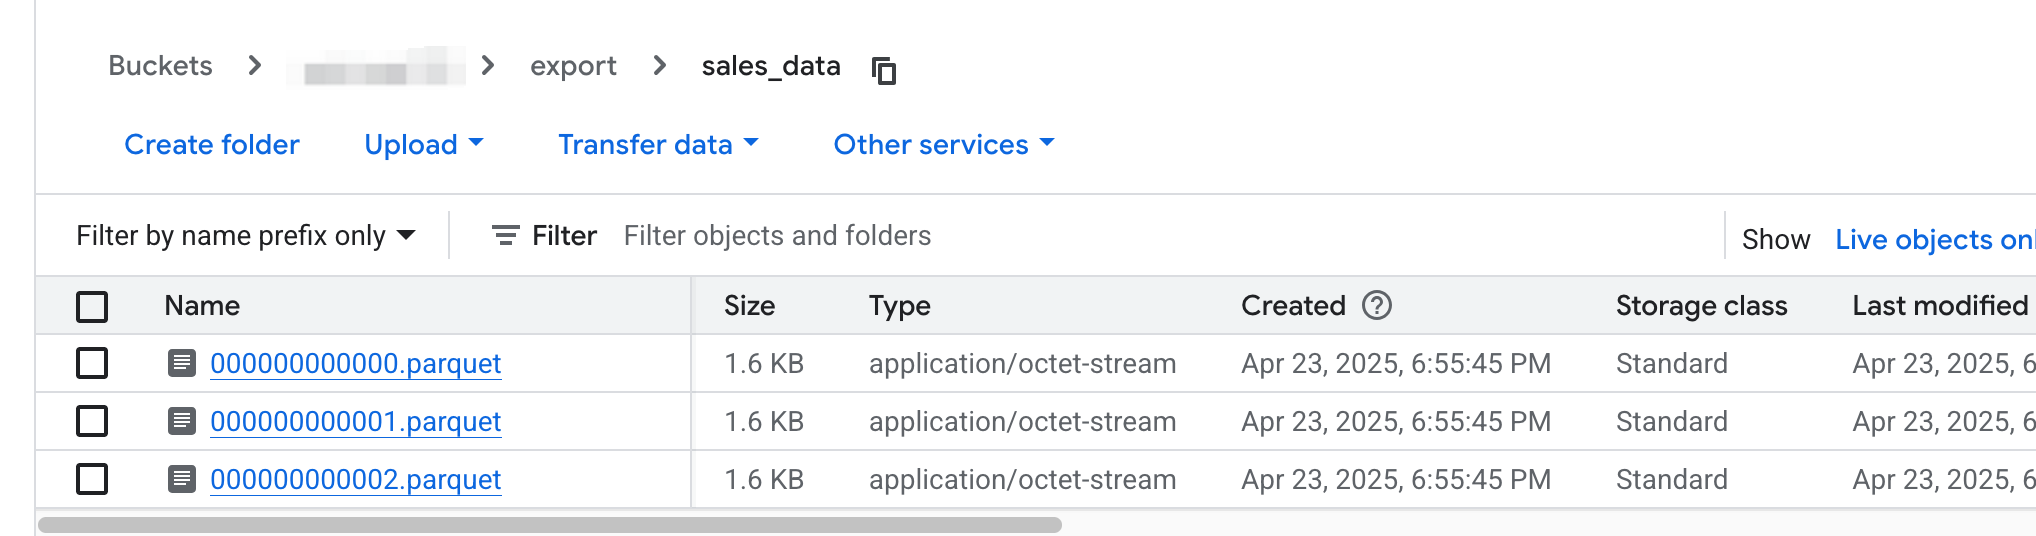
2.2 Проверка экспортированных файлов в GCS
Приведённая выше команда экспортирует sales_data в GCS. Для каждой секции создаётся один или несколько файлов с последовательно возрастающими номерами в именах. Подробнее см. в разделе Экспорт данных.
Шаг 3: импорт данных в Doris с помощью S3 Load
Для импорта используется S3 Load. S3 Load — асинхронный способ импорта данных. После отправки задания Doris самостоятельно получает данные из источника. В качестве источника можно использовать объектное хранилище, совместимое с протоколом S3, в том числе AWS S3, GCS и Azure.
Этот способ подходит для больших объёмов данных, требующих асинхронной обработки в фоновом режиме. Если при импорте нужна синхронная обработка, см. раздел TVF Load.
Примечание: для файлов Parquet/ORC, содержащих сложные типы (Struct/Array/Map), в настоящее время необходимо использовать TVF Load.
3.1 Импорт данных из одного файла
Используйте следующий оператор LOAD LABEL для импорта одного файла Parquet из GCS:
LOAD LABEL sales_data_2025_04_08
(
    DATA INFILE("s3://mybucket/export/sales_data/000000000000.parquet")
    INTO TABLE sales_data
    FORMAT AS "parquet"
    (order_id, order_date, customer_name, amount, country)
)
WITH S3
(
    "provider" = "GCP",
    "s3.endpoint" = "storage.asia-southeast1.rep.googleapis.com",
    "s3.region" = "asia-southeast1",
    "s3.access_key" = "<ak>",
    "s3.secret_key" = "<sk>"
);
3.2 Проверка состояния задания с помощью Show Load
Поскольку задания S3 Load отправляются асинхронно, используйте SHOW LOAD, чтобы запросить состояние импорта для заданной метки:
mysql> show load where label = "sales_data_2025_04_08"\G
*************************** 1. row ***************************
        JobId: 17956078
        Label: sales_data_2025_04_08
        State: FINISHED
      Progress: 100.00% (1/1)
          Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=0; dpp.norm.ALL=2
      TaskInfo: cluster:storage.asia-southeast1.rep.googleapis.com; timeout(s):3600; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: NULL
    CreateTime: 2025-04-10 17:50:53
  EtlStartTime: 2025-04-10 17:50:54
EtlFinishTime: 2025-04-10 17:50:54
LoadStartTime: 2025-04-10 17:50:54
LoadFinishTime: 2025-04-10 17:50:54
          URL: NULL
    JobDetails: {"Unfinished backends":{"5eec1be8612d4872-91040ff1e7208a4f":[]},"ScannedRows":2,"TaskNumber":1,"LoadBytes":91,"All backends":{"5eec1be8612d4872-91040ff1e7208a4f":[10022]},"FileNumber":1,"FileSize":1620}
TransactionId: 766228
  ErrorTablets: {}
          User: root
      Comment:
1 row in set (0.00 sec)
3.3 Обработка ошибок при импорте
Если заданий импорта несколько, используйте следующий запрос, чтобы найти задания, завершившиеся с ошибкой, и узнать причины:
mysql> show load where state='CANCELLED' and label like "label_test%"\G
*************************** 1. row ***************************
        JobId: 18312384
        Label: label_test123
        State: CANCELLED
      Progress: 100.00% (3/3)
          Type: BROKER
      EtlInfo: unselected.rows=0; dpp.abnorm.ALL=4; dpp.norm.ALL=0
      TaskInfo: cluster:storage.asia-southeast1.rep.googleapis.com; timeout(s):14400; max_filter_ratio:0.0; priority:NORMAL
      ErrorMsg: type:ETL_QUALITY_UNSATISFIED; msg:quality not good enough to cancel
    CreateTime: 2025-04-15 17:32:59
  EtlStartTime: 2025-04-15 17:33:02
EtlFinishTime: 2025-04-15 17:33:02
LoadStartTime: 2025-04-15 17:33:02
LoadFinishTime: 2025-04-15 17:33:02
          URL: http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342
    JobDetails: {"Unfinished backends":{"7602ccd7c3a4854-95307efca7bfe341":[]},"ScannedRows":4,"TaskNumber":1,"LoadBytes":188,"All backends":{"7602ccd7c3a4854-95307efca7bfe341":[10022]},"FileNumber":3,"FileSize":4839}
TransactionId: 769213
  ErrorTablets: {}
          User: root
      Comment:
В примере выше показана ошибка качества данных (ETL_QUALITY_UNSATISFIED). Чтобы узнать конкретную причину, перейдите по адресу из возвращённого поля URL. Например, приведённая ниже ошибка указывает, что длина данных превышает длину, заданную для столбца country в схеме таблицы:
[root@VM-10-6-centos ~]$ curl "http://10.16.10.6:28747/api/_load_error_log?file=__shard_2/error_log_insert_stmt_7602ccd7c3a4854-95307efca7bfe342_7602ccd7c3a4854_95307efca7bfe342"
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [USA] schema length: 1; actual length: 3; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Canada] schema length: 1; actual length: 6; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [UK] schema length: 1; actual length: 2; . src line [];
Reason: column_name[country], the length of input is too long than schema. first 32 bytes of input str: [Australia] schema length: 1; actual length: 9; . src line [];
Если при ошибках качества данных допустимо пропустить часть ошибочных строк, задайте допустимую долю ошибок в PROPERTIES задания S3 Load. Подробнее о параметрах см. в разделе Параметры настройки загрузки.
3.4 Импорт данных из нескольких файлов
При миграции больших объёмов исторических данных используйте пакетный импорт:
- Разделение на пакеты: каждый пакет соответствует одной секции Doris или небольшому числу секций.
- Объём данных в пакете: рекомендуется ограничить объём каждого пакета до 100 ГБ, чтобы снизить нагрузку на систему и затраты на повторные попытки после неудачного импорта.
- Скрипт пакетного импорта: см. s3_load_file_demo.sh. Этот скрипт разбивает список файлов в указанном каталоге объектного хранилища на пакеты и отправляет в Doris несколько заданий S3 Load для пакетного импорта.
Часто задаваемые вопросы
Вопрос 1: почему типы JSON в BigQuery нельзя экспортировать напрямую в Parquet?
BigQuery пока не поддерживает экспорт типов JSON в формате Parquet. Для экспорта задайте параметру format значение JSON и используйте соответствующий столбец JSON в Doris для приёма данных.
Вопрос 2: как тип Time из BigQuery сопоставляется с типом в Doris?
При экспорте тип Time из BigQuery необходимо преобразовать в String, а в Doris хранить эти данные в столбце STRING.
Вопрос 3: что делать, если импорт завершается с ошибкой ETL_QUALITY_UNSATISFIED?
Эта ошибка означает, что данные не соответствуют требованиям к качеству. Выполните следующие действия:
- Найдите поле
URLв результатеSHOW LOADи используйтеcurl, чтобы получить подробный журнал ошибок. - Определите причину по журналу. Частые причины — превышение допустимой длины столбца и несоответствие типов.
- Измените схему целевой таблицы или задайте
max_filter_ratioвPROPERTIESзадания S3 Load, чтобы пропустить часть ошибочных строк.
Вопрос 4: можно ли импортировать файлы Parquet/ORC, содержащие Struct/Array/Map, с помощью S3 Load?
Нет. Файлы с этими сложными типами в настоящее время необходимо импортировать с помощью TVF Load.
Вопрос 5: как избежать затрат на повторные попытки из-за сбоев отдельных заданий при миграции больших объёмов исторических данных?
Импортируйте данные пакетами по секциям, ограничив объём каждого пакета до 100 ГБ, и используйте скрипт s3_load_file_demo.sh для разделения данных на пакеты и их отправки.