Системная архитектура
В этом документе описана системная архитектура Apache Doris, включая основные компоненты и логику их взаимодействия в двух режимах развёртывания:
- Архитектура с совмещением хранения и вычислений: классическая архитектура FE + BE, в которой хранение данных и вычисления объединены.
- Архитектура с разделением хранения и вычислений: трёхуровневая архитектура с отдельными уровнями метаданных, вычислений и хранения.
Сценарии использования: выбор архитектуры, изучение её устройства и принципов эксплуатации.
Архитектура с совмещением хранения и вычислений
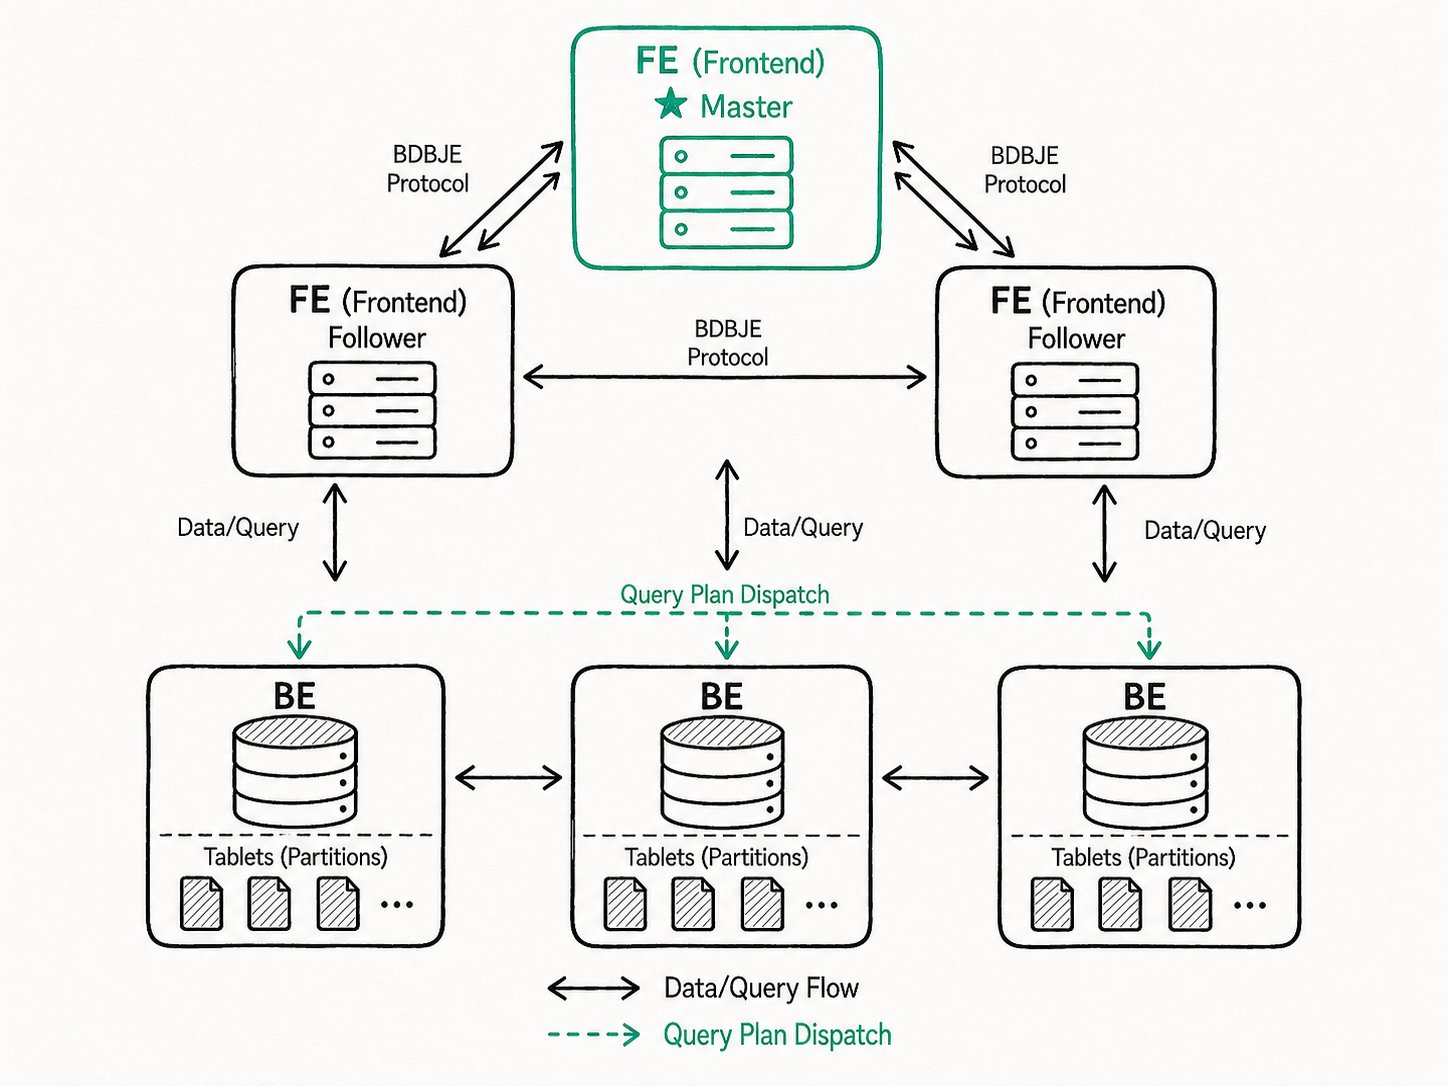
Архитектура с совмещением хранения и вычислений представляет собой классический режим развёртывания Apache Doris. Она состоит из двух типов процессов: Frontend (FE) и Backend (BE).
Основные компоненты
Узел Frontend (FE)
FE служит точкой входа в Apache Doris и отвечает за координацию и управление:
| Обязанность | Описание |
|---|---|
| Обработка пользовательских запросов | Совместимость с протоколом MySQL и поддержка стандартного SQL |
| Разбор и планирование запросов | Лексический анализ -> семантический анализ -> построение логического плана -> оптимизация CBO -> передача на выполнение |
| Управление метаданными | Схемы баз данных и таблиц, распределение реплик, права пользователей, топология кластера и состояние загрузки данных |
| Управление узлами | Проверка сигналов heartbeat, балансировка нагрузки, восстановление реплик, управление расширением и сокращением кластера |
FE использует BDB JE в качестве движка хранения метаданных и поддерживает транзакции. Он не зависит от внешних компонентов, таких как ZooKeeper, что упрощает развёртывание и обслуживание.
Узел Backend (BE)
BE отвечает за вычисления и хранение данных:
| Возможность | Описание |
|---|---|
| Колоночное хранение | Данные организованы по столбцам; кодирование и сжатие повышают эффективность I/O |
| Шардирование данных (Tablet) | Данные разделяются по горизонтали; tablet является минимальной единицей планирования размещения реплик |
| Несколько реплик | По умолчанию каждый tablet имеет 3 реплики, размещённые на разных узлах BE |
| Векторизованное выполнение | Колоночное размещение данных в памяти в сочетании с ускорением SIMD повышает производительность агрегаций по широким таблицам в 5–10 раз |
| Движок Pipeline | Параллельная работа на нескольких ядрах с ограничением числа потоков предотвращает их чрезмерное разрастание |
Высокая доступность FE
В производственных средах развёртывается несколько узлов FE. Они могут выполнять следующие роли:
| Роль | Обязанность | Участвует в выборах |
|---|---|---|
| Master | Читает и записывает метаданные, синхронизирует их с узлами Follower и Observer | Да |
| Follower | Читает метаданные и участвует в выборах при отказе Master | Да |
| Observer | Читает метаданные, увеличивая только число одновременно обрабатываемых запросов | Нет |
Для обеспечения согласованности изменения метаданных требуют подтверждения большинства узлов.
Особенности архитектуры
- Простота и удобство обслуживания: всего два типа процессов, FE и BE.
- Высокая производительность: вычислительные узлы напрямую обращаются к локальному хранилищу, что снижает сетевые накладные расходы.
- Высокая доступность: несколько реплик в сочетании с автоматической изоляцией сбоев.
- Горизонтальное масштабирование: FE и BE поддерживают добавление узлов без остановки работы.
Архитектура с разделением хранения и вычислений
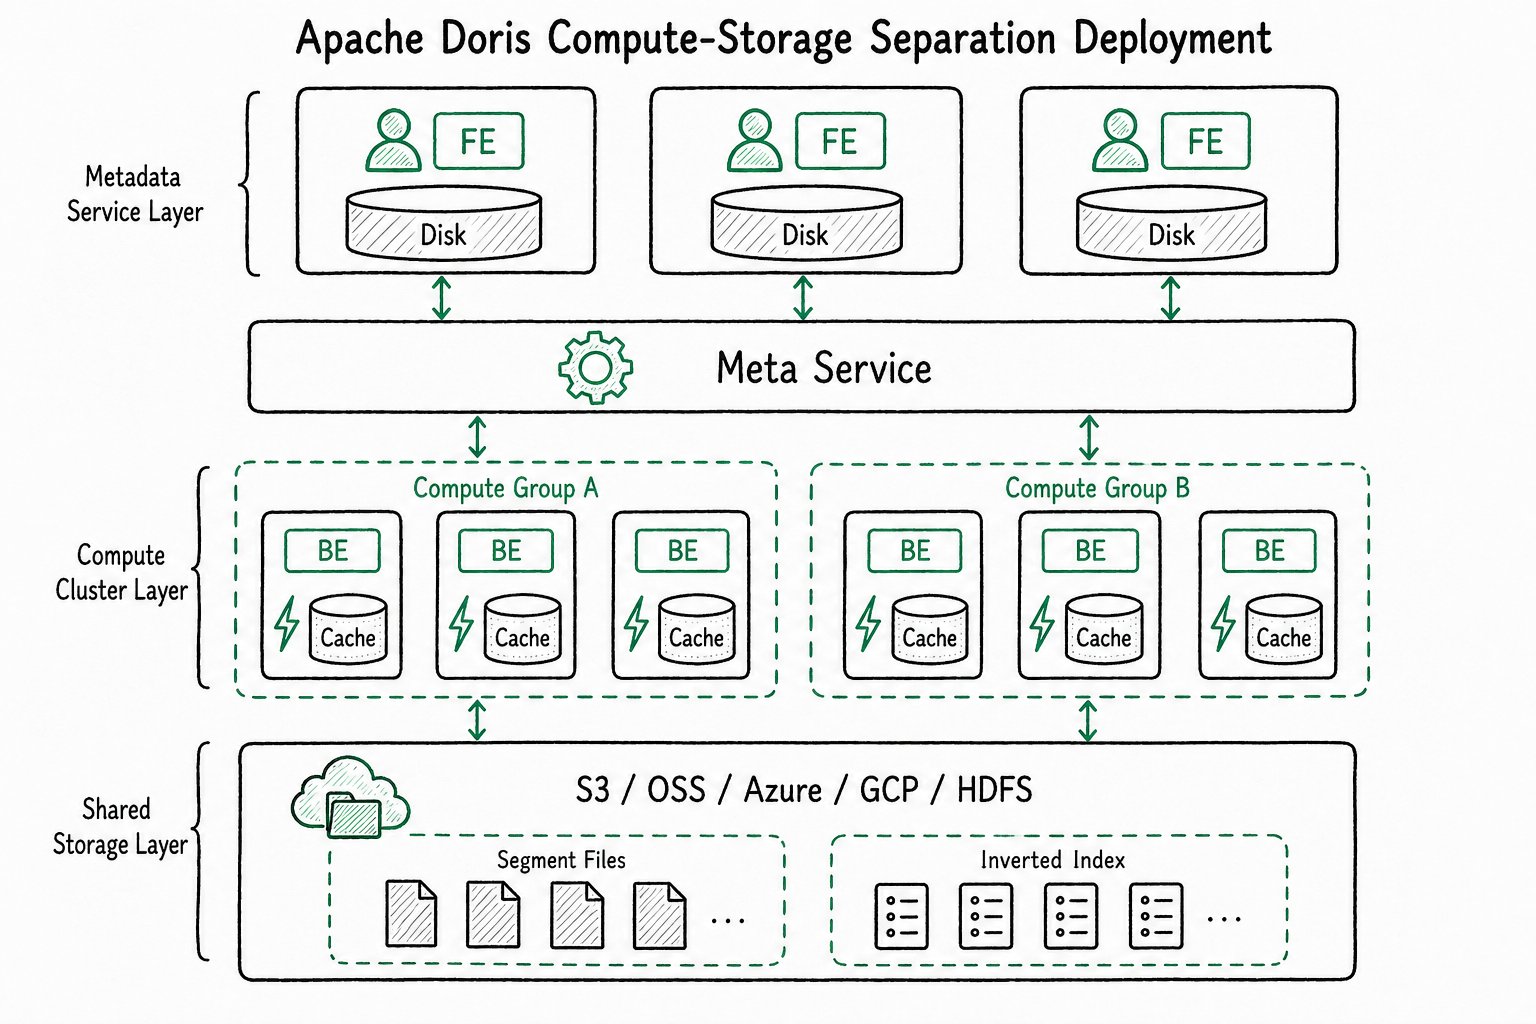
Эта архитектура появилась в версии 3.0. Она полностью отделяет вычислительный уровень от уровня хранения, позволяя независимо и эластично масштабировать их.
Основные компоненты
В архитектуре с разделением хранения и вычислений узел FE сохраняется и по-прежнему принимает пользовательские запросы и выполняет их разбор. Для управления метаданными на уровне данных добавлен новый компонент Meta Service.
Узел FE Frontend
Обязанности FE в архитектуре с разделением хранения и вычислений остаются прежними:
| Обязанность | Описание |
|---|---|
| Обработка пользовательских запросов | Совместимость с протоколом MySQL, поддержка стандартного SQL, аутентификация и проверка прав доступа |
| Разбор и планирование запросов | Лексический анализ -> семантический анализ -> логический план -> оптимизация CBO -> передача на выполнение |
| Метаданные уровня SQL | Схемы баз данных и таблиц, права пользователей и топология кластера |
Уровень метаданных (Meta Service)
Сервис без состояния, поддерживающий горизонтальное масштабирование.
| Обязанность | Описание |
|---|---|
| Транзакции загрузки данных | Управление версиями и обнаружение конфликтов |
| Метаданные tablet | Версии данных и списки файлов |
| Метаданные rowset | Информация об инкрементальных данных, используемая для восстановления и сборки мусора |
| Ресурсы кластера | Выделение ресурсов и планирование для вычислительных групп |
Вычислительный уровень
Вычислительный уровень состоит из нескольких вычислительных кластеров, каждый из которых содержит несколько узлов BE без состояния. Вычислительные кластеры используют общие данные, но располагают независимыми вычислительными ресурсами.
| Возможность | Описание |
|---|---|
| Независимые ресурсы | Каждый вычислительный кластер независимо обслуживает свою бизнес-нагрузку |
| BE без состояния | Не хранит данные постоянно, а только кэширует часто используемые данные |
| Эластичное масштабирование | Добавление или удаление узлов не влияет на другие вычислительные кластеры |
| Локальный кэш | Часто используемые данные кэшируются по политике LRU для снижения задержки доступа |
Уровень общего хранилища
Уровень хранения обеспечивает постоянное хранение всех файлов данных, включая файлы сегментов и инвертированных индексов.
| Поддерживаемый тип | Примеры |
|---|---|
| Объектное хранилище | S3, OSS, COS, OBS, MinIO |
| Распределённая файловая система | HDFS |
| Ceph | RGW, CephFS |
Особенности архитектуры
- Эластичные вычисления: ресурсы масштабируются по потребности, что подходит для нагрузок с пиками и спадами.
- Изоляция нагрузок: разные бизнес-команды используют общие данные, сохраняя независимость вычислительных ресурсов.
- Низкая стоимость хранения: доступны недорогие варианты, такие как объектные хранилища.
- Масштабирование за минуты: объём вычислительных ресурсов можно быстро изменить.
Сравнение и выбор
Сравнение функций компонентов
Обязанности компонентов в двух архитектурах различаются следующим образом:
| Критерий сравнения | Совмещение хранения и вычислений | Разделение хранения и вычислений |
|---|---|---|
| Узел FE | Сохраняется, хранит все метаданные | Сохраняется, хранит только метаданные уровня SQL |
| Узел BE | С состоянием (хранит данные) | Без состояния (только кэширует часто используемые данные) |
| Расположение данных | Локальный диск BE | Уровень общего хранилища; локальный диск BE используется как кэш |
| Особенности масштабирования | Хранение и вычисления масштабируются вместе | Вычисления и хранение могут масштабироваться независимо |
| Стоимость хранения | Выше (SSD) | Ниже (объектное хранилище) |
| Сложность эксплуатации | Ниже | Выше (зависит от внешнего хранилища) |
| Задержка запросов | Ниже (локальные операции I/O) | Немного выше (при промахе кэша). При попадании в кэш задержка такая же, как в архитектуре с совмещением хранения и вычислений. |
Рекомендации по выбору
Выбирайте подходящую архитектуру исходя из своего сценария:
| Сценарий | Совмещение хранения и вычислений | Разделение хранения и вычислений |
|---|---|---|
| Среды разработки и тестирования, быстрые эксперименты | ✓ | |
| Нет доступного общего хранилища (HDFS / Ceph / объектное хранилище) | ✓ | |
| Нет выделенного DBA, несколько команд самостоятельно занимаются обслуживанием | ✓ | |
| Не нужны эластичное масштабирование или контейнеризация в Kubernetes | ✓ | |
| Система уже развёрнута в публичном облаке | ✓ | |
| Доступна надёжная система общего хранения | ✓ | |
| Требуются контейнеризация в Kubernetes или эластичность частного облака | ✓ | |
| Несколько вычислительных кластеров должны использовать общие данные | ✓ | |
| Есть выделенная платформенная команда для обслуживания | ✓ |
Основные технические модули
Движок хранения
Колоночное хранение и сжатие
Данные организованы по столбцам, поэтому считываются только столбцы, участвующие в запросе, что сокращает объём I/O. В сочетании с такими алгоритмами, как словарное кодирование, сжатие битовых карт и RLE, это обеспечивает высокую степень сжатия.
Индексные структуры
| Тип индекса | Сценарий использования |
|---|---|
| Сортированный составной ключ (до 3 столбцов) | Отсечение данных при одновременном выполнении большого числа отчётных запросов |
| Min/Max | Фильтрация по равенству и диапазону для числовых типов |
| BloomFilter | Фильтрация по равенству для столбцов с высокой кардинальностью |
| Инвертированный индекс | Быстрый и полнотекстовый поиск по произвольным полям |
Модели данных
| Модель | Особенности | Сценарий использования |
|---|---|---|
| Модель Duplicate | Сохраняет детальные данные | Хранение детальных данных таблиц фактов |
| Модель Primary Key | Уникальный первичный ключ; строки с одинаковым первичным ключом перезаписываются | Обновления на уровне строк |
| Модель Aggregate | Строки с одинаковым первичным ключом автоматически агрегируются | Ускорение за счёт предварительной агрегации |
Движок запросов
Распределённые запросы MPP
Сложные запросы разбиваются на несколько этапов и обрабатываются параллельно на нескольких узлах BE. Поддерживаются распределённые соединения shuffle join для эффективного соединения больших таблиц.
Векторизованное выполнение
Колоночное размещение данных в памяти в сочетании с инструкциями SIMD повышает производительность агрегаций по широким таблицам в 5–10 раз.
Движок выполнения Pipeline
Параллельная работа на нескольких ядрах с ограничением числа потоков предотвращает их чрезмерное разрастание. Сокращаются копирование данных между операторами и накладные расходы на выделение памяти.
Оптимизатор запросов
| Оптимизатор | Стратегия |
|---|---|
| RBO | Свёртка констант, переписывание подзапросов и проталкивание предикатов |
| CBO | Оценка стоимости и изменение порядка соединений |
| HBO | Использует историю запросов для ускорения повторных запросов |
Runtime Filter
Фильтры динамически создаются во время выполнения и передаются узлам сканирования, чтобы сократить объём обрабатываемых данных. Поддерживаются типы In, Min/Max и BloomFilter.
Механизм высокой доступности
Несколько реплик и кворумный протокол
- По умолчанию хранятся 3 реплики.
- Для успешной записи требуется подтверждение большинства реплик (например, 2 реплик).
- Сбои части узлов не приводят к потере данных, и кластер остаётся доступным.
Автоматическая изоляция сбоев
- Обнаружение превышения времени ожидания heartbeat узла или повреждения реплики.
- Пометка узла как недоступного и прекращение отправки ему задач.
- Автоматическое восстановление недостающих реплик на основе исправных.
- Автоматическая синхронизация инкрементальных данных после восстановления.
Высокая доступность FE
Протокол консенсуса, подобный Paxos, обеспечивает согласованность метаданных. При отказе Master узлы Follower автоматически выбирают новый Master; этот процесс прозрачен для пользователя.
Часто задаваемые вопросы
Вопрос: в чём основное различие между архитектурами с совмещением и разделением хранения и вычислений?
В архитектуре с совмещением хранения и вычислений узлы BE отвечают и за хранение данных, и за вычисления, а данные хранятся на локальных дисках. В архитектуре с разделением хранения и вычислений данные находятся на уровне общего хранилища (например, S3 или HDFS), а узлы BE работают как вычислительные узлы без состояния, ускоряя запросы за счёт локального кэша. Архитектура с разделением поддерживает независимое эластичное масштабирование вычислительных ресурсов и ресурсов хранения.
Вопрос: когда следует выбирать архитектуру с разделением хранения и вычислений?
Архитектура с разделением хранения и вычислений подходит для следующих сценариев: система уже развёрнута в публичном облаке, требуется контейнеризация в Kubernetes, доступна надёжная система общего хранения (HDFS, Ceph или объектное хранилище), нескольким вычислительным кластерам нужен доступ к общим данным, а обслуживанием занимается выделенная платформенная команда. Для простых сценариев, а также сред разработки и тестирования больше подходит архитектура с совмещением хранения и вычислений.
Вопрос: хранят ли узлы BE данные в архитектуре с разделением хранения и вычислений?
В архитектуре с разделением хранения и вычислений узлы BE не имеют состояния и сами не обеспечивают постоянное хранение данных. Однако они используют локальный SSD для кэширования часто используемых данных с политикой вытеснения LRU. Это позволяет компенсировать задержки, вызванные относительно низкой производительностью случайного чтения из объектного хранилища и накладными расходами на передачу данных по сети.
Вопрос: какова роль FE в архитектуре с разделением хранения и вычислений?
FE сохраняется в архитектуре с разделением хранения и вычислений и в основном отвечает за приём пользовательских запросов, разбор и планирование SQL, а также управление метаданными уровня SQL (схемами баз данных и таблиц, правами пользователей и топологией кластера). Управление метаданными на уровне данных (например, метаданными tablet и rowset) выполняет новый компонент Meta Service.
Вопрос: как реализована высокая доступность в Doris?
Doris обеспечивает высокую доступность с помощью нескольких реплик и кворумного протокола: по умолчанию каждый tablet имеет 3 реплики, а запись требует подтверждения большинства. При отказе части узлов они автоматически изолируются, а реплики восстанавливаются на основе исправных. FE использует протокол консенсуса, подобный Paxos, для обеспечения согласованности метаданных; при отказе текущего Master автоматически выбирается новый Master.
Вопрос: какова роль Meta Service в архитектуре с разделением хранения и вычислений?
Meta Service представляет собой сервис без состояния в архитектуре с разделением хранения и вычислений, предназначенный для управления метаданными на уровне данных. В его обязанности входят обработка транзакций загрузки данных (управление версиями и обнаружение конфликтов), управление метаданными tablet и rowset, а также выделение ресурсов и планирование для вычислительных кластеров. Отсутствие состояния позволяет ему масштабироваться горизонтально и увеличивать производительность обработки метаданных.
Итоги
Apache Doris предлагает две архитектуры для разных потребностей:
| Архитектура | Сценарий использования |
|---|---|
| Совмещение хранения и вычислений | Приоритет производительности, ограниченные ресурсы на эксплуатацию и управляемый масштаб |
| Разделение хранения и вычислений | Облачная среда, эластичное масштабирование и общие данные для нескольких команд |
Обе архитектуры предоставляют полноценный механизм высокой доступности, обеспечивающий надёжность данных и стабильность работы сервиса.