Полнотекстовый поиск
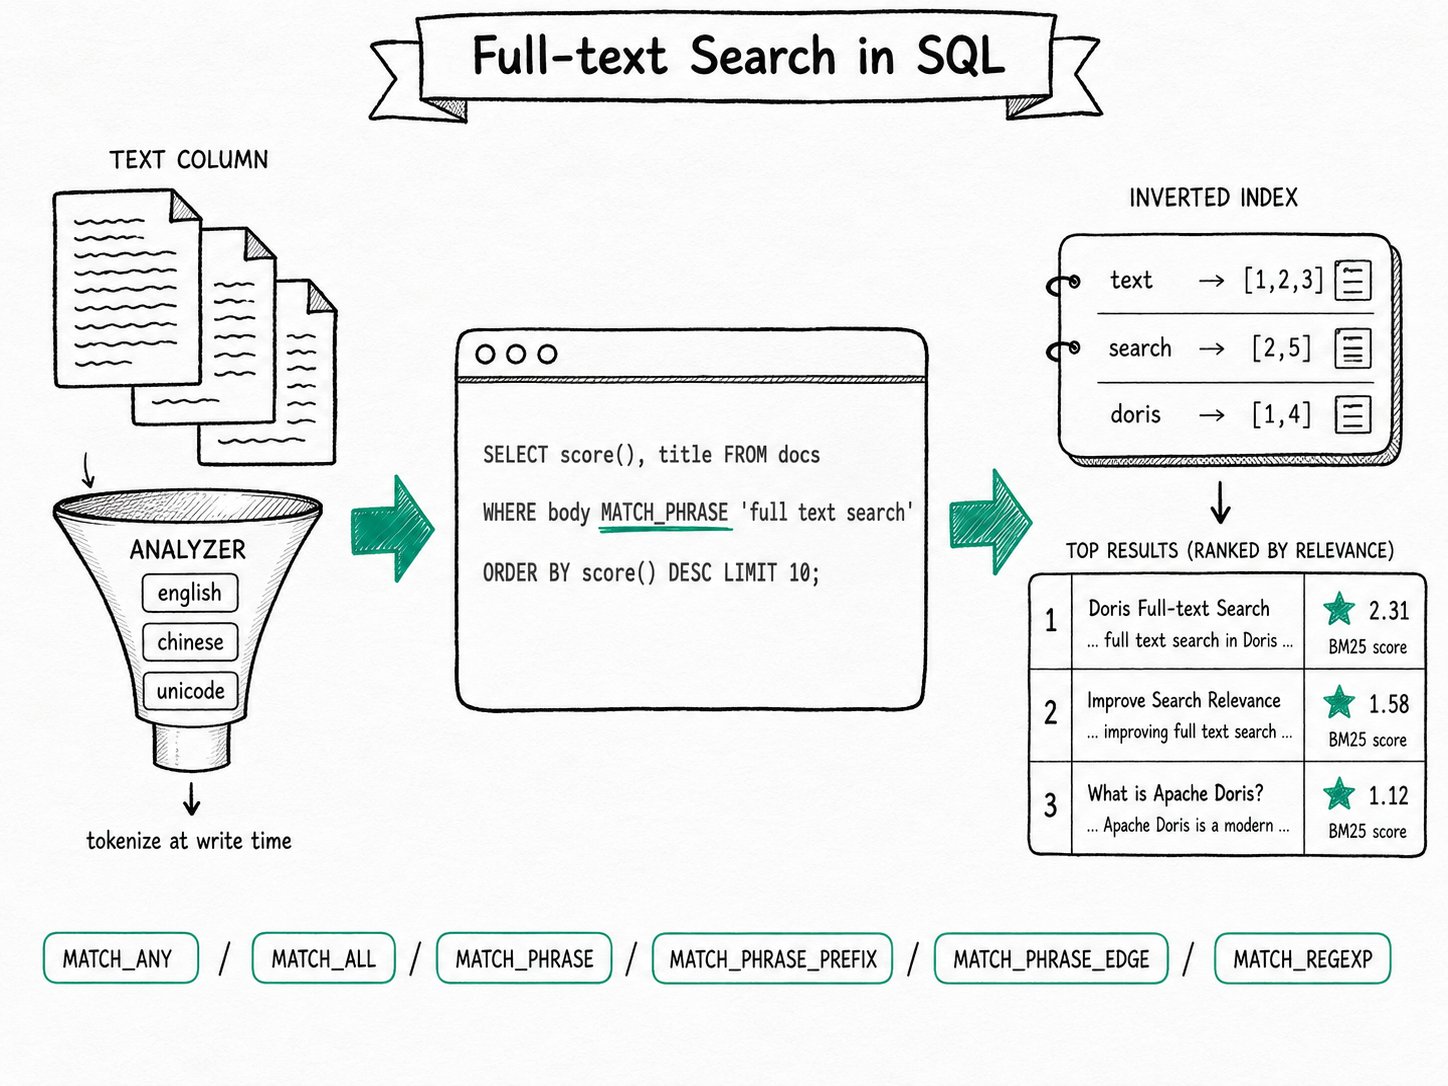
Кратко Полнотекстовый поиск в Apache Doris преобразует текстовые столбцы в доступные для поиска термы с помощью инвертированного индекса и предоставляет шесть операторов
MATCH_*в SQL:MATCH_ANY,MATCH_ALL,MATCH_PHRASE,MATCH_PHRASE_PREFIX,MATCH_PHRASE_EDGEиMATCH_REGEXP. Вы выбираете токенизатор при создании индекса и пишете обычный SQL-запрос. Планировщик Apache Doris проталкивает предикат в индекс, поэтому отдельный поисковый кластер не требуется.
Зачем использовать полнотекстовый поиск в Apache Doris?
Полнотекстовый поиск в Apache Doris объединяет полноценный текстовый поиск и аналитику хранилища данных в одном движке. Его операторы учитывают токены и предлагают гораздо больше возможностей, чем поиск подстрок с LIKE. Большинство хранилищ данных предоставляют LIKE '%foo%' и называют это текстовым поиском. Такой подход работает для одной строки из десяти тысяч. Он перестаёт справляться, как только нужно найти все комментарии к заказам с упоминанием «battery» или «batteries», все строки журнала с фразой «connection refused» или все товары, описание которых начинается с «wireless».
LIKE читает каждое значение целиком, байт за байтом. Оператор не знает, что «Running» и «running» — одно и то же слово, а «search engine optimization» — три терма в определённом порядке, а не просто подстрока. Обычный обходной путь — подключить Elasticsearch, оплачивать второй кластер и создавать ненадёжные конвейеры синхронизации.
Apache Doris объединяет всё это в одном движке. Та же таблица, которая обслуживает агрегации, обслуживает и текстовые запросы, а имена операторов выглядят привычно для SQL.
- Поиск подстрок с
LIKEприводит к полному сканированию. Инвертированный индекс превращает текстовые предикаты в поиск по спискам вхождений. - Поиск по мере ввода, поиск фраз и регулярные выражения по токенам требуют семантики сопоставления, которую
LIKEне может выразить. - Смешанные предикаты по структурированным данным и тексту (
category = 'A' AND content MATCH_ANY 'doris') планируются и выполняются в рамках одного запроса.
Что такое полнотекстовый поиск в Apache Doris?
Полнотекстовый поиск в Apache Doris — это возможность выполнения запросов на основе инвертированного индекса. Вы объявляете индекс INVERTED для столбца типа STRING, TEXT, VARCHAR или ARRAY<STRING>, выбираете анализатор, после чего операторы MATCH_* в предложениях WHERE проталкиваются в индекс. Базовая таблица остаётся обычной таблицей Apache Doris, к которой уже обращаются ваши дашборды.
Основные термины
- Анализатор (парсер): конвейер, который преобразует исходный текст в доступные для поиска термы. Встроенные варианты:
none(точное совпадение),english,chinese,unicode,standardиicu. Пользовательские анализаторы могут последовательно объединятьchar_filter,tokenizerи один или несколько этаповtoken_filter. - Запрос по термам: сопоставляет отдельные токены.
MATCH_ANYобъединяет термы по OR, аMATCH_ALL— по AND. - Запрос по фразе: сопоставляет токены, расположенные рядом и в заданном порядке. Для парсеров без токенизации требует настройки индекса
"support_phrase" = "true". score(): оценка релевантности BM25, доступная при наличии индекса с токенизацией, предикатаMATCH_*иORDER BY score() LIMIT N.
Как работает полнотекстовый поиск в Apache Doris?
Полнотекстовый поиск в Apache Doris токенизирует текст при записи, распознаёт каждый предикат MATCH_* в оптимизаторе Nereids и проталкивает его в инвертированный индекс, благодаря чему строки, не удовлетворяющие условию, вообще не декодируются. Описанный ниже жизненный цикл из пяти этапов охватывает разбор запроса, проталкивание предикатов, оценку релевантности и объединение с предикатами по структурированным данным.
- Токенизация при записи. Когда строка попадает в tablet, анализатор разбивает каждое текстовое значение на термы. Инвертированный индекс фиксирует для каждого терма, какие строки его содержат и в каких позициях.
- Разбор запроса. Оператор
MATCH_*распознаётся в Nereids какMatch,MatchAny,MatchAll,MatchPhrase,MatchPhrasePrefix,MatchPhraseEdgeилиMatchRegexp. Каждый из них содержит подсказку анализатора, которая определяет, как токенизируется сама строка запроса. - Проталкивание в индекс. BE находит соответствующие списки вхождений, пересекает или объединяет их в зависимости от оператора и возвращает битовую карту строк. Строки, не удовлетворяющие условию, вообще не декодируются.
- Оценка релевантности по запросу. Если запрос содержит
SELECT score() ... ORDER BY score() DESC LIMIT N, Doris вычисляет BM25 (частота терма, обратная частота документа, нормализация по длине) и возвращает N лучших результатов. Без этих трёх составляющих предикат работает как обычный фильтр. - Свободное комбинирование. В одном запросе можно сочетать
MATCH_*с=,IN, фильтрами по диапазону, соединениями и агрегациями. Оптимизатор обрабатывает текстовые предикаты как ещё один вид проталкиваемых предикатов.
Быстрый старт
CREATE TABLE articles (
  id INT,
  title  STRING,
  body   STRING,
  INDEX idx_body (body) USING INVERTED
    PROPERTIES("parser" = "english", "support_phrase" = "true")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO articles VALUES
  (1, 'Doris 4.0 release', 'Apache Doris adds BM25 scoring for full-text search'),
  (2, 'Storage notes',     'Inverted indexes accelerate text and structured filters'),
  (3, 'Vector primer',     'Approximate nearest neighbor search complements text search');

SELECT id, title, score() AS rel
FROM articles
WHERE body MATCH_ANY 'text search'
ORDER BY rel DESC LIMIT 3;
Ожидаемый результат
+------+-------------------+-----------+
| id   | title             | rel       |
+------+-------------------+-----------+
|    3 | Vector primer     | 0.8009131 |
|    1 | Doris 4.0 release | 0.5634479 |
|    2 | Storage notes     | 0.1384567 |
+------+-------------------+-----------+
MATCH_ANY 'text search' разбивает запрос на токены text и search, находит оба списка вхождений и возвращает строки, содержащие хотя бы один из термов. score() ранжирует их по BM25, когда ORDER BY rel LIMIT 3 заставляет оптимизатор обрабатывать запрос как Top-N: строка 3 содержит оба терма (search — дважды), строка 1 содержит оба по одному разу, а строка 2 содержит только text.
Краткий обзор операторов
| Оператор | Для чего используется |
|---|---|
MATCH / MATCH_ANY | Поиск по любому из указанных ключевых слов (OR) |
MATCH_ALL | Поиск с обязательным присутствием каждого ключевого слова (AND) |
MATCH_PHRASE 'a b' | Соседние термы в заданном порядке; поддерживает ~slop и ~slop+ со строгим порядком |
MATCH_PHRASE_PREFIX 'a b' | Фраза, в которой последний терм является префиксом; используется для подсказок при вводе |
MATCH_PHRASE_EDGE 'a b c' | Суффикс первого терма, точное совпадение средних термов, префикс последнего терма |
MATCH_REGEXP '^abc.*' | Регулярное выражение применяется к токенам, а не к исходным байтам |
Если для одного столбца существует несколько инвертированных индексов с разными анализаторами, добавьте USING ANALYZER <name>, чтобы выбрать анализатор при выполнении запроса.
Когда стоит использовать полнотекстовый поиск в Apache Doris?
Используйте полнотекстовый поиск в Apache Doris для поиска по журналам и трассировкам, поиска по каталогам (Catalog) интернет-магазинов, работы со смешанным содержимым CJK и латиницей, поиска по мере ввода и конвейеров RAG, сочетающих текстовые совпадения с векторным сходством. Используйте LIKE или n-граммные индексы, когда нужен поиск подстрок внутри токенов, нечёткое сопоставление по расстоянию редактирования или подсветка результатов.
Подходящие сценарии
- Поиск по журналам и трассировкам, при котором пользователи сочетают произвольный текст с фильтрами по структурированным данным (
level = 'ERROR' AND message MATCH_ANY 'timeout disconnect'). - Поиск в электронной торговле и каталогах, где одна строка содержит цену, категорию и описание.
- Смешанное содержимое CJK и латиницей; парсеры
chinese,unicodeиicuобрабатывают оба вида текста в одном столбце. - Поиск по мере ввода, при котором
MATCH_PHRASE_PREFIXвозвращает варианты завершения без отдельного сервиса автодополнения. - Конвейеры RAG, сочетающие текстовые совпадения со сходством эмбеддингов. См. Гибридный поиск, где описано объединение
MATCH_*с векторным расстоянием в одном SQL-запросе.
Неподходящие сценарии
- Поиск подстроки внутри отдельного токена (например, всех строк, где столбец содержит «ear» внутри «year»). Токенизация не сохраняет такое представление данных. Используйте
LIKE, индекс N-Gram BloomFilter или инвертированный индекс без токенизации. - Нечёткое сопоставление по расстоянию редактирования («возможно, вы имели в виду...»). Сейчас в Doris нет встроенного оператора нечёткого поиска. Выполняйте предварительную обработку при записи с помощью фонетического или n-граммного анализатора либо формируйте варианты запроса в приложении.
- Подсветка результатов (возврат совпавшего фрагмента с разметкой). Сейчас Doris вычисляет оценки релевантности, но не возвращает фрагменты с подсветкой. Формируйте подсветку в приложении на основе совпавших термов.
- Ранжирование по релевантности между полями, подобное
dis_maxв Elasticsearch.score()вычисляется для каждого предиката отдельно. Если нужны более сложные стратегии оценки релевантности, используйтеSEARCH('title:foo OR body:foo')и настраивайте их на уровне приложения.
Выбор токенизатора
Выбор анализатора имеет решающее значение. Он определяет, какие запросы смогут находить совпадения, а индексируемые термы фиксируются при записи.
none: без токенизации. Всё значение считается одним термом. Подходит для идентификаторов, тегов, перечислений статусов и фильтров по точному совпадению.english: разбиение на слова по правилам ASCII с лёгкой нормализацией. Подходит для текстов на английском языке.chinese: разбиение китайского текста на слова со значениемparser_mode, равнымfine_grainedилиcoarse_grained. Подходит для содержимого CJK.unicode: не зависящее от языка разбиение на слова с учётом CJK и пунктуации. Разумный вариант по умолчанию для смешанного содержимого.standard: токенизатор на основе сегментации текста Unicode; работает для большинства языков.icu: токенизатор на основе ICU для языков, которым нужны полные правила сегментации Unicode (тайский, кхмерский, смешанные системы письма).- Пользовательские анализаторы (3.1+): последовательно объединяйте
edge_ngramдля автодополнения по префиксу,word_delimiterдля camelCase и термов с дефисами,lowercaseиasciifoldingдля поиска без учёта регистра и диакритики и другие компоненты.
Изменение анализатора требует перестроения индекса с помощью BUILD INDEX.
Дополнительные материалы
- Инвертированный индекс: структура индекса, обеспечивающая работу этих операторов, включая организацию хранения, построение и поведение при компактации.
- Оценка релевантности BM25: как вычисляется
score(), когда включается эта функция и как настраиватьk1иb. - Гибридный поиск: объединение
MATCH_*и векторного расстояния ANN в одном SQL-запросе с учётом семантики предварительной фильтрации и резервного выполнения. - Справочник операторов поиска: полный каталог операторов с синтаксисом slop, правилами префиксов и
USING ANALYZER. - Руководство по пользовательским анализаторам: подробное описание символьных фильтров, токенизаторов и фильтров токенов.
- Функция SEARCH: DSL в виде одной строки, объединяющий несколько операторов для разных столбцов.
- Слияние рангов Reciprocal Rank Fusion: шаблон SQL для объединения рангов BM25 с векторными рангами, когда одного способа оценки релевантности недостаточно.