Инвертированный индекс
Кратко Инвертированный индекс Apache Doris представляет собой вторичный индекс на основе CLucene, который можно объявить для любого столбца с помощью
INDEX ... USING INVERTED. Индекс ускоряет проверку предикатов равенства, диапазона,IN,IS NULL, вхождения в массив и полнотекстовых предикатовMATCH_*за счёт чтения списка вхождений вместо сканирования строк. Доступен начиная с Apache Doris 2.0.
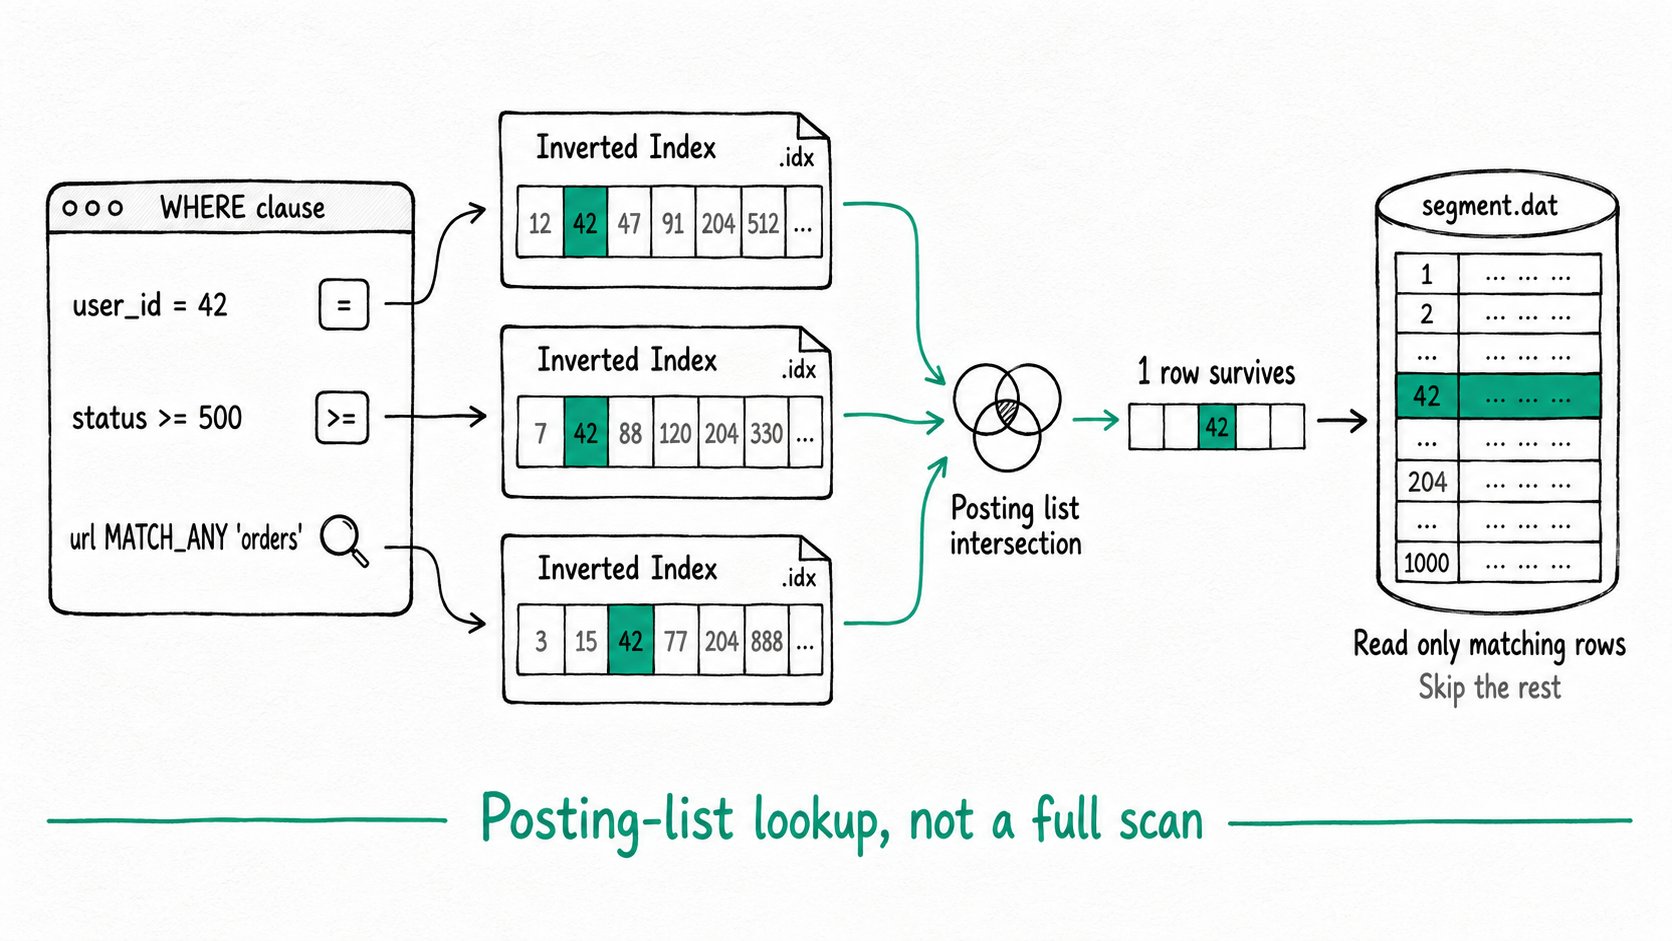
Зачем использовать инвертированный индекс в Apache Doris?
Инвертированный индекс Apache Doris позволяет выполнять самую затратную часть OLAP-запросов, проверку предикатов WHERE, через поиск по спискам вхождений вместо полного сканирования. Для таблицы событий объёмом 2 TB с предикатом по user_id, диапазоном по request_time и поиском ключевого слова по url без такого индекса пришлось бы декодировать все столбцы каждой строки в каждом сегменте, оставшемся после отсечения. Обычный обходной путь, инкрементальное материализованное представление или отдельный поисковый кластер, удваивает объём хранения и эксплуатационные затраты.
Проблемные сценарии:
- Поиск по равенству в столбцах с высокой кардинальностью (
WHERE order_id = ?) требует сканирования целых таблетов, поскольку нет способа быстро исключить сегменты. - Фильтры по диапазону для числовых столбцов или столбцов даты и времени (
WHERE event_time BETWEEN ...) ограничиваются лишь минимумом и максимумом ZoneMap и всё равно затрагивают каждую страницу в диапазоне. - Базовый SQL-движок не предоставляет эффективного способа поиска ключевых слов в текстовых столбцах.
LIKE '%term%'приводит к сканированию, а передача данных в Elasticsearch требует второго конвейера, который нужно поддерживать в синхронизированном состоянии.
Инвертированный индекс Apache Doris решает все три задачи с помощью одного и того же DDL.
Что такое инвертированный индекс Apache Doris?
Инвертированный индекс Apache Doris представляет собой вторичный индекс на уровне столбца, который сопоставляет каждому значению, а для текстовых столбцов каждому терму после токенизации, множество идентификаторов строк, содержащих это значение или терм. Он построен на основе CLucene, порта Lucene на C++, и полностью интегрирован со столбцовым хранилищем и векторизованным выполнением Apache Doris.
Инвертированный индекс объявляется в DDL с помощью INDEX <name>(<col>) USING INVERTED [PROPERTIES(...)]. Поддерживаются целочисленные типы, DECIMAL, DATE, DATETIME, IPV4, IPV6, CHAR/VARCHAR/STRING, а также ARRAY<T> для перечисленных типов. Для текстовых столбцов можно задать parser, чтобы управлять токенизацией.
Основные термины
Posting list: множество идентификаторов строк, связанных со значением или термом. Проверка предиката сводится к поиску списка вхождений и операции над множествами (AND/OR/NOT).Parser: токенизатор для текстовых столбцов. Встроенные варианты:none(строка целиком, по умолчанию),english,chinese,unicode,standard, а начиная с 3.1 также пользовательские анализаторы.MATCH operators:MATCH_ANY(любой терм),MATCH_ALL(все термы),MATCH_PHRASE(термы, стоящие рядом),MATCH_PHRASE_PREFIX,MATCH_REGEXP. Для них требуется инвертированный индекс с парсером; для обычных=иLIKEон не требуется..idx file: данные индекса на диске. Рядом с каждым файлом сегмента в каталоге таблета хранится один файл.idx, поэтому индекс привязан к сегменту и сопровождает rowset при compaction.
Как работает инвертированный индекс Apache Doris?
Инвертированный индекс Apache Doris строится один раз, а затем многократно используется для поиска. Он размещается рядом с индексируемым сегментом.
- Построение при записи. При сбросе rowset на диск BE записывает индекс в формате CLucene в соседний файл
.idx. Строки сегмента сопоставлены 1:1 с идентификаторами CLuceneDocID, поэтому индексу не нужна отдельная таблица соответствий между строками и документами. - Выбор пути при выполнении запроса. Для предиката, который планировщик проталкивает на уровень хранения, BE сначала обращается к инвертированному индексу: разбивает литерал на токены тем же парсером, который использовался при построении индекса, проходит по словарю термов и читает список вхождений.
- Объединение с помощью операций над множествами.
AND,ORиNOTмежду предикатами превращаются в пересечения, объединения и дополнения списков вхождений без обращения к данным столбцов. - Передача сканеру битовой карты строк. Сканер читает из столбцового хранилища только строки, оставшиеся после фильтрации. Результаты ZoneMap, BloomFilter и инвертированного индекса применяются совместно: каждый из них уменьшает объём работы следующего уровня.
- Привязка к сегменту. Поскольку индексы находятся рядом с сегментами, compaction объединяет их вместе с данными, а при переносе данных на удалённый уровень хранения индексы переносятся вместе с ними. Глобального индекса, который нужно было бы перестраивать, нет.
Быстрый старт
CREATE TABLE access_log (
  ts        DATETIME    NOT NULL,
  user_id   BIGINT      NOT NULL,
  status    INT         NOT NULL,
  url       STRING      NOT NULL,
  INDEX idx_user(user_id)  USING INVERTED,
  INDEX idx_status(status) USING INVERTED,
  INDEX idx_url(url) USING INVERTED PROPERTIES("parser"="english")
) DUPLICATE KEY(ts) DISTRIBUTED BY HASH(user_id) BUCKETS 4;

INSERT INTO access_log VALUES
  ('2026-05-01 10:00:00', 42, 200, '/api/orders/list'),
  ('2026-05-01 10:01:00', 42, 500, '/api/orders/create'),
  ('2026-05-01 10:02:00', 99, 200, '/api/users/profile');

SELECT user_id, status, url FROM access_log
WHERE user_id = 42 AND status >= 500 AND url MATCH_ANY 'orders';
Ожидаемый результат
+---------+--------+---------------------+
| user_id | status | url                 |
+---------+--------+---------------------+
|      42 |    500 | /api/orders/create  |
+---------+--------+---------------------+
Каждый предикат обрабатывается с помощью поиска по индексу. user_id = 42 и status >= 500 используют инвертированный индекс для проверки равенства и диапазона. url MATCH_ANY 'orders' разбивает значения столбца на токены парсером english и находит список вхождений для orders. Сканер читает только единственную строку, которая остаётся после применения AND к трём спискам вхождений.
Когда стоит использовать инвертированный индекс Apache Doris?
Инвертированный индекс Apache Doris эффективен для предикатов с высокой кардинальностью, поиска по тексту и массивам, а также для любых столбцов, где отсечение с помощью ZoneMap слишком грубое.
Подходит
- Проверки равенства и
INдля неключевых столбцов с высокой кардинальностью:order_id,trace_id,device_id. - Фильтры по диапазону и
BETWEENдля числовых столбцов или столбцовDATETIME, где одного ZoneMap недостаточно для точного отсечения. IS NULL/IS NOT NULLдля разреженных столбцов; индекс хранит сведения о значениях NULL и находит их за O(1).- Поиск ключевых слов и фраз в столбцах с журналами, документами и другим содержимым. Набор операторов описан в разделе Полнотекстовый поиск, а ранжирование по релевантности в разделе Оценка релевантности BM25.
- Предикаты вхождения в массив:
array_contains(tags, 'x')иarray_overlaps(tags, ['a','b']).
Не подходит
LIKE '%abc%'с подстановочным символом в начале. Инвертированный индекс не ускоряет поиск подстроки черезLIKE; используйте индекс NGram BloomFilter.- Столбец таблицы, который чаще всего используется в фильтрах. Сделайте его столбцом Key, чтобы его обрабатывал префиксный индекс; префиксный индекс плотнее и не требует дополнительных затрат.
- Небольшие таблицы (несколько миллионов строк), полное сканирование которых завершается за миллисекунды. Индекс окупается только тогда, когда объём пропускаемых данных значительно перевешивает затраты на поиск по индексу.
- Столбцы, для которых предикат уже соответствует большинству строк. Списки вхождений дают преимущество, когда они короткие; если после фильтрации остаётся 80% строк, сканер в любом случае выполняет ту же работу.
- Таблицы с ограничениями по объёму хранения: инвертированный индекс широкого текстового столбца может быть сопоставим по размеру с самим столбцом. Если объём хранения важнее текстового поиска, используйте индекс BloomFilter.
Дополнительные материалы
- Руководство пользователя по инвертированному индексу: полный синтаксис DDL, параметры парсера и команды управления.
- Справочник операторов поиска: все операторы
MATCH_*с примерами. - Обзор индексов: сравнение инвертированного индекса с префиксным индексом, ZoneMap, BloomFilter и NGram BloomFilter.
- Полнотекстовый поиск: токенизаторы, фразовые запросы и язык
SEARCH()DSL, построенный на основе этого индекса. - Оценка релевантности BM25: ранжирование результатов с помощью
score(), доступное начиная с 4.0. - Гибридный поиск: объединение инвертированного индекса с векторным индексом ANN в одном SQL-запросе.
- Как работает инвертированный индекс в Apache Doris: подробный разбор внутреннего устройства и результатов тестов производительности.