Хранение и анализ логов
Логи представляют собой подробные записи о работе системы и содержат ключевые сведения: объект события, время, место и содержание. Для обеспечения наблюдаемости систем, мониторинга сетевой безопасности и бизнес-анализа компаниям обычно требуется централизованно собирать, хранить и анализировать разрозненные логи, чтобы извлекать полезную информацию из их огромных объёмов.
Для этих задач Apache Doris дополняет свои основные возможности OLAP инвертированными индексами и высокоскоростным полнотекстовым поиском, а также обеспечивает высокую производительность записи и минимальный объём хранения. С помощью Apache Doris можно создать открытую, высокопроизводительную и экономичную единую платформу для хранения и анализа логов.
В статье рассматриваются следующие аспекты решения:
- Общая архитектура: основные компоненты и базовая архитектура платформы для работы с логами на Apache Doris.
- Возможности и преимущества: отличительные возможности по сравнению с Elasticsearch.
- Практическое руководство: все этапы от оценки ресурсов до выполнения запросов к логам.
1. Общая архитектура
Ниже показана архитектура платформы хранения и анализа логов на Apache Doris:
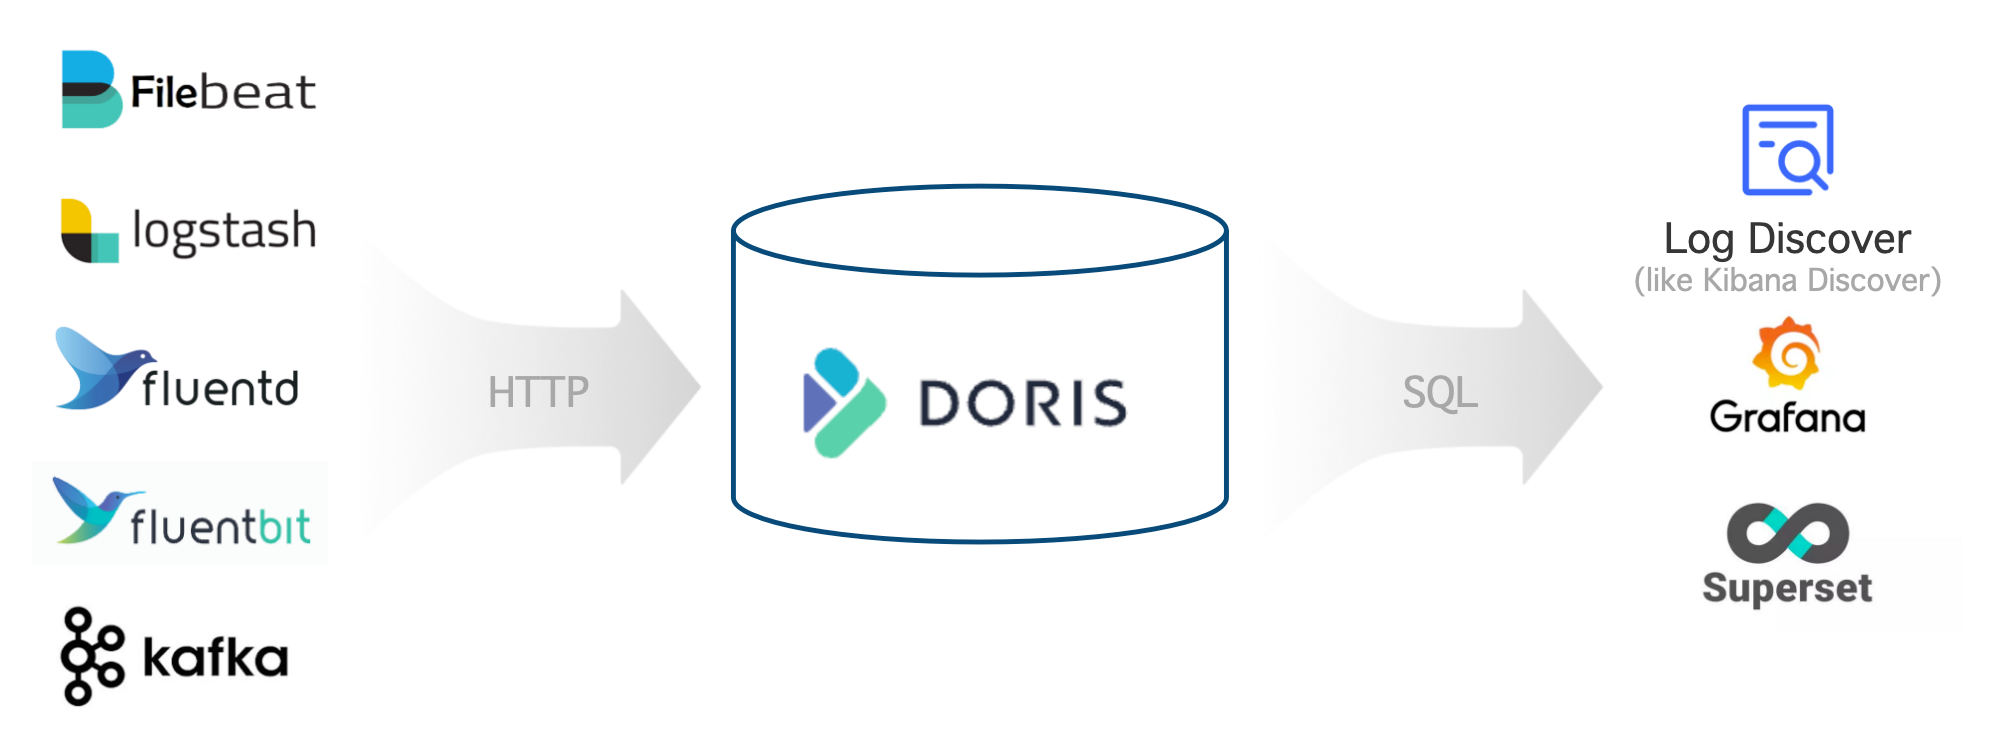
Архитектура состоит из трёх частей:
| Уровень | Компоненты | Описание |
|---|---|---|
| Сбор и предварительная обработка логов | Logstash, Filebeat, Fluentbit, Kafka и др. | Записывает данные логов в Apache Doris через HTTP API |
| Хранение и анализ логов | Apache Doris | Обеспечивает высокопроизводительное и экономичное единое хранилище, а также широкие возможности поиска и анализа через интерфейс SQL |
| Анализ логов и оповещения | Grafana, Superset, Doris WebUI и др. | Выполняет запросы к Doris по стандартному протоколу MySQL и предоставляет удобные визуальные интерфейсы |
2. Возможности и преимущества
Платформа для работы с логами на Apache Doris предоставляет следующие основные возможности:
| Возможность | Описание |
|---|---|
| Загрузка данных с высокой пропускной способностью и низкой задержкой | Поддерживает стабильную непрерывную загрузку сотен TB в день со скоростью GB/s и задержкой менее 1 секунды |
| Экономичное хранение больших объёмов данных | Поддерживает хранение данных в масштабе PB, снижая затраты на хранение на 60%–80% по сравнению с Elasticsearch и ещё на 50% после переноса холодных данных в S3/HDFS |
| Высокопроизводительный полнотекстовый поиск и анализ | Поддерживает инвертированные индексы и полнотекстовый поиск; запросы, например поиск записей по ключевому слову и анализ тенденций, выполняются за секунды |
| Открытая и удобная экосистема | Принимает данные из Logstash, Filebeat, Fluentbit, Kafka и других систем; передаёт данные в Grafana, Superset и Doris WebUI по стандартному протоколу MySQL |
2.1 Высокая производительность и низкая стоимость
Тесты производительности и проверка в промышленной эксплуатации показывают, что соотношение производительности и стоимости платформы для работы с логами на Apache Doris в 5–10 раз лучше, чем у Elasticsearch. Эти преимущества достигаются прежде всего за счёт высокопроизводительного движка хранения и выполнения запросов, а также оптимизаций специально для работы с логами:
- Более высокая пропускная способность записи: узким местом при записи в Elasticsearch становится нагрузка на CPU, связанная с разбором данных и построением инвертированных индексов. Apache Doris использует векторные инструкции CPU, такие как SIMD, для ускорения разбора JSON и построения индексов, а также упрощает структуру инвертированного индекса, исключая прямые индексы и другие структуры данных, не нужные при работе с логами. При одинаковых ресурсах производительность записи Doris в 3–5 раз выше, чем у Elasticsearch.
- Меньшие затраты на хранение: Elasticsearch хранит несколько копий данных в разных структурах (прямой индекс, инвертированный индекс, столбцовое хранилище doc values) и имеет относительно низкий общий коэффициент сжатия. Doris исключает прямой индекс, сокращая объём индексных данных на 30%; благодаря столбцовому хранению с алгоритмом сжатия Zstandard коэффициент сжатия достигает 5–10, что значительно выше показателя Elasticsearch, равного 1.5. Многоуровневое хранение горячих и холодных данных позволяет автоматически перемещать исторические логи в объектное хранилище, снижая затраты на хранение холодных данных более чем на 70%. Общие затраты на хранение составляют лишь около 20% от затрат при использовании Elasticsearch.
- Более высокая производительность запросов: Doris упрощает процесс полнотекстового поиска и пропускает алгоритмы, не нужные при работе с логами, например оценку релевантности. Для типичных запросов, таких как «последние 100 записей логов, содержащих заданное ключевое слово», Doris применяет специальные оптимизации на этапах планирования и выполнения, в том числе динамическое отсечение TopN.
2.2 Широкие аналитические возможности
Apache Doris поддерживает стандартный SQL и совместим с протоколом и синтаксисом MySQL, поэтому система работы с логами на Doris имеет следующие преимущества:
- Простота использования: инженеры и аналитики данных хорошо знакомы с SQL и могут быстро начать работу без изучения нового технологического стека.
- Развитая экосистема: легко интегрируется с командной строкой MySQL, различными инструментами GUI / BI и экосистемой больших данных, удовлетворяя сложные и разнообразные потребности в обработке и анализе данных.
- Широкие возможности анализа: SQL является фактическим стандартом анализа данных и поддерживает поиск, агрегацию, JOIN нескольких таблиц, подзапросы, UDF, логические представления, материализованные представления и многое другое.
2.3 Гибкая схема
Ниже приведён типичный пример полуструктурированной записи лога в формате JSON. Поля верхнего уровня относительно стабильны (timestamp, source, node, component, level, clientRequestId, message, properties), а вложенные поля внутри атрибута расширения properties (например, properties.size и properties.format) более динамичны и могут различаться от записи к записи.
{
  "timestamp": "2014-03-08T00:50:03.8432810Z",
  "source": "ADOPTIONCUSTOMERS81",
  "node": "Engine000000000405",
  "level": "Information",
  "component": "DOWNLOADER",
  "clientRequestId": "671db15d-abad-94f6-dd93-b3a2e6000672",
  "message": "Downloading file path: benchmark/2014/ADOPTIONCUSTOMERS81_94_0.parquet.gz",
  "properties": {
    "size": 1495636750,
    "format": "parquet",
    "rowCount": 855138,
    "downloadDuration": "00:01:58.3520561"
  }
}
Apache Doris поддерживает гибкие схемы с помощью следующих двух механизмов:
- Light Schema Change: если поля верхнего уровня меняются лишь время от времени, изменения схемы, такие как
ADD/DROP COLUMNиADD/DROP INDEX, выполняются за секунды. На этапе проектирования достаточно определить, каким полям сейчас нужны индексы. - Полуструктурированный тип VARIANT: в поля расширения, такие как
properties, можно записывать произвольные данные JSON; имена и типы полей определяются автоматически, а часто встречающиеся поля выделяются в отдельные столбцы. Также можно создавать инвертированные индексы дляVARIANT, чтобы ускорить запросы и поиск по внутренним полям.
По сравнению с динамическим сопоставлением полей Elasticsearch гибкая схема Apache Doris имеет следующие преимущества:
- Допускает несколько типов для одного поля.
VARIANTавтоматически разрешает конфликты и повышает типы, лучше адаптируясь к постепенным изменениям данных логов. VARIANTавтоматически объединяет редко встречающиеся поля в один столбец, предотвращая проблемы с производительностью из-за чрезмерного количества полей, метаданных или столбцов.- Поддерживает динамическое добавление и удаление столбцов и индексов, поэтому создавать индексы для всех полей заранее не требуется, что сокращает ненужные затраты.
3. Практическое руководство
В следующей таблице приведён полный процесс создания платформы для работы с логами на Apache Doris, состоящий из шести этапов:
| Этап | Цель |
|---|---|
| Этап 1: Оценка ресурсов | Оценить количество узлов FE/BE, ёмкость дисков и объём объектного хранилища |
| Этап 2: Развёртывание кластера | Развернуть Apache Doris на физических или виртуальных машинах |
| Этап 3: Настройка конфигураций FE и BE | Настроить ключевые параметры для работы с логами |
| Этап 4: Создание таблицы | Спроектировать партиционирование и бакетирование, настроить сжатие, компактацию, индексы и политики многоуровневого хранения |
| Этап 5: Сбор логов | Настроить интеграцию с Logstash, Filebeat, Kafka или собственной программой |
| Этап 6: Запросы и анализ логов | Выполнять поиск и анализ логов с помощью SQL и инструментов визуализации |
3.1 Оценка ресурсов
Перед развёртыванием кластера необходимо оценить аппаратные ресурсы серверов. Основные шаги:
-
Оцените ресурсы для записи по следующим формулам:
Average write throughput = Daily incremental data / 86400 sPeak write throughput = Average write throughput * Peak-to-average write ratioCPU cores required for peak writes = Peak write throughput / Per-core write throughput
-
Оцените ресурсы хранения по следующей формуле:
Required storage = Daily incremental data / Compression ratio * Replica count * Data retention period
-
Оцените ресурсы для запросов: потребление ресурсов зависит от количества и сложности запросов. Для первоначальной оценки зарезервируйте 50% ресурсов CPU для запросов, затем скорректируйте это значение по результатам тестирования.
-
Сведите оценки ресурсов: оцените необходимое количество ядер CPU по шагам 1 и 3, затем разделите его на количество ядер CPU одной машины, чтобы получить число серверов BE. Используя результат шага 2, оцените требуемый объём хранения на каждом сервере BE и распределите его между 4–12 дисками данных, чтобы рассчитать ёмкость каждого диска.
Пример: оценка ресурсов для 100 TB новых логов в день
Рассмотрим следующие условия: 100 TB новых данных в день (до сжатия), коэффициент сжатия 5, 1 реплика, срок хранения горячих данных 3 дня, холодных данных 30 дней, отношение пиковой пропускной способности записи к средней 200%, пропускная способность записи на одно ядро 10 MB/s и резервирование 50% ресурсов CPU для запросов. Оценки будут следующими:
- FE: 3 сервера, каждый с 16 ядрами CPU, 64 GB памяти и одним SSD на 100 GB
- BE: 15 серверов, каждый с 32 ядрами CPU, 256 GB памяти и десятью SSD по 600 GB
- Объектное хранилище S3: объём хранения холодных данных 600 TB
Значения и расчёты основных показателей приведены ниже:
| Основной показатель (единица измерения) | Значение | Описание |
|---|---|---|
| Ежедневный прирост данных (TB) | 100 | Укажите в соответствии с фактическими потребностями |
| Коэффициент сжатия | 5 | Обычно от 3 до 10 (включая индексы); укажите в соответствии с фактическими потребностями |
| Количество реплик | 1 | Укажите в соответствии с фактическими потребностями; по умолчанию 1; возможные значения: 1, 2, 3 |
| Срок хранения горячих данных (дни) | 3 | Укажите в соответствии с фактическими потребностями |
| Срок хранения холодных данных (дни) | 30 | Укажите в соответствии с фактическими потребностями |
| Общий срок хранения (дни) | 33 | Формула: Hot data retention + Cold data retention |
| Оценка объёма хранения горячих данных (TB) | 60 | Формула: Daily incremental data / Compression ratio * Replica count * Hot data retention |
| Оценка объёма хранения холодных данных (TB) | 600 | Формула: Daily incremental data / Compression ratio * Replica count * Cold data retention |
| Отношение пиковой пропускной способности записи к средней | 200% | Укажите в соответствии с фактическими потребностями; по умолчанию 200% |
| Количество ядер CPU на машину | 32 | Укажите в соответствии с фактическими потребностями; по умолчанию 32 ядра |
| Средняя пропускная способность записи (MB/s) | 1214 | Формула: Daily incremental data / 86400 s |
| Пиковая пропускная способность записи (MB/s) | 2427 | Формула: Average write throughput * Peak-to-average write ratio |
| Количество ядер CPU для пиковой записи | 242.7 | Формула: Peak write throughput / Per-core write throughput |
| Резерв CPU для запросов | 50% | Укажите в соответствии с фактическими потребностями; по умолчанию 50% |
| Оценочное количество серверов BE | 15.2 | Формула: CPU cores required for peak writes / CPU cores per machine / (1 - CPU reserved for queries) |
| Оценочное количество серверов BE (округлённое) | 15 | Формула: MAX(Replica count, rounded estimated number of BE servers) |
| Оценочный объём хранения на сервер BE (TB) | 5.7 | Формула: Estimated hot-data storage / Estimated number of BE servers / (1 - 30%), где 30% составляет резерв хранилища. Для повышения пропускной способности ввода-вывода рекомендуется подключать от 4 до 12 дисков данных на каждый BE |
3.2 Развёртывание кластера
После оценки ресурсов можно развернуть кластер Apache Doris. Рекомендуется развёртывание на физических или виртуальных машинах; пошаговые инструкции приведены в разделе Развёртывание вручную.
3.3 Настройка конфигураций FE и BE
После развёртывания кластера настройте параметры FE и BE по отдельности, чтобы лучше адаптировать их к хранению и анализу логов.
3.3.1 Настройка конфигурации FE
В файле fe/conf/fe.conf настройте параметры FE в соответствии со следующей таблицей:
| Параметр для настройки | Описание |
|---|---|
max_running_txn_num_per_db = 10000 | При загрузке с высокой степенью параллелизма выполняется много транзакций, поэтому значение параметра увеличивается |
streaming_label_keep_max_second = 3600label_keep_max_second = 7200 | При частой загрузке метки транзакций занимают больше памяти, поэтому срок их хранения сокращается |
enable_round_robin_create_tablet = true | Использовать round-robin при создании таблетов для максимально равномерного распределения |
tablet_rebalancer_type = partition | При балансировке использовать стратегию максимально равномерного распределения таблетов внутри каждой партиции |
autobucket_min_buckets = 10 | Увеличить минимальное количество бакетов при автоматическом бакетировании с 1 до 10, чтобы при росте объёма логов бакетов было достаточно |
max_backend_heartbeat_failure_tolerance_count = 10 | При работе с логами серверы BE испытывают высокую нагрузку и могут ненадолго пропускать сигналы heartbeat; увеличить допустимое число пропусков с 1 до 10 |
Дополнительные сведения о параметрах см. в разделе Конфигурация FE.
3.3.2 Настройка конфигурации BE
В файле be/conf/be.conf настройте параметры BE в соответствии со следующей таблицей:
| Модуль | Параметр для настройки | Описание |
|---|---|---|
| Хранение | storage_root_path = /path/to/dir1;/path/to/dir2;...;/path/to/dir12 | Настроить пути хранения горячих данных в каталогах на дисках |
| Хранение | enable_file_cache = true | Включить файловый кеш |
| Хранение | file_cache_path = [{"path": "/mnt/datadisk0/file_cache", "total_size":53687091200, "query_limit": "10737418240"},{"path": "/mnt/datadisk1/file_cache", "total_size":53687091200,"query_limit": "10737418240"}] | Настроить пути и параметры кеширования холодных данных:path: путь к кешуtotal_size: общий размер кеша по этому пути в байтах; 53687091200 байт = 50 GBquery_limit: максимальный объём данных, который один запрос может прочитать из кеша по этому пути, в байтах; 10737418240 байт = 10 GB |
| Запись | write_buffer_size = 1073741824 | Увеличить размер файла буфера записи, чтобы сократить количество мелких файлов и случайных операций ввода-вывода, повысив производительность |
| Компактация | max_cumu_compaction_threads = 8 | Установить значение, равное числу ядер CPU / 4: тогда 1/4 ресурсов CPU отводится на запись, 1/4 на фоновую компактацию, а 1/2 резервируется для запросов и других операций |
| Компактация | inverted_index_compaction_enable = true | Включить компактацию индексов, чтобы снизить потребление CPU при компактации |
| Компактация | enable_segcompaction = falseenable_ordered_data_compaction = false | Отключить две функции компактации, которые не нужны при работе с логами |
| Компактация | enable_compaction_priority_scheduling = false | Компактация с низким приоритетом ограничена 2 задачами на диск, что замедляет её выполнение |
| Компактация | total_permits_for_compaction_score = 200000 | Используется для контроля потребления памяти; политика временных рядов сама может контролировать потребление памяти |
| Кеш | disable_storage_page_cache = trueinverted_index_searcher_cache_limit = 30% | Объём логов велик, поэтому кеш данных приносит ограниченную пользу; отключить кеш данных и использовать вместо него кеш индексов |
| Кеш | inverted_index_cache_stale_sweep_time_sec = 3600index_cache_entry_stay_time_after_lookup_s = 3600 | Хранить кеш индексов в памяти до одного часа |
| Кеш | enable_inverted_index_cache_on_cooldown = trueenable_write_index_searcher_cache = false | Включить автоматическое кеширование индексов при их загрузке в холодное хранилище |
| Кеш | tablet_schema_cache_recycle_interval = 3600segment_cache_capacity = 20000 | Сократить потребление памяти другими кешами |
| Кеш | inverted_index_ram_dir_enable = true | Сократить накладные расходы на ввод-вывод, связанные с временными файлами индексов при записи |
| Потоки | pipeline_executor_size = 24doris_scanner_thread_pool_thread_num = 48 | Настройки вычислительных потоков и потоков ввода-вывода для CPU с 32 ядрами; увеличивать или уменьшать пропорционально количеству ядер |
| Потоки | scan_thread_nice_value = 5 | Снизить приоритет потоков ввода-вывода запросов, чтобы обеспечить производительность и своевременность записи |
| Прочее | string_type_length_soft_limit_bytes = 10485760 | Увеличить ограничение длины данных типа String до 10 MB |
| Прочее | trash_file_expire_time_sec = 300path_gc_check_interval_second = 900path_scan_interval_second = 900 | Ускорить очистку файлов из корзины |
Дополнительные сведения о параметрах см. в разделе Конфигурация BE.
3.4 Создание таблицы
Запись логов и запросы к ним имеют свои особенности. Чтобы повысить производительность, при создании таблицы используйте специальные настройки из следующих разделов.
3.4.1 Настройка параметров партиционирования и бакетирования
Партиционирование:
- Используйте партиционирование по диапазонам по полю времени (
PARTITION BY RANGE(ts)) и включите динамическое партиционирование ("dynamic_partition.enable" = "true") для автоматического управления ежедневными партициями. - Используйте поле времени типа
Datetimeв качестве ключа (DUPLICATE KEY(ts)); это многократно ускоряет запросы последних N записей логов.
Бакетирование:
- Задайте количество бакетов примерно в 3 раза больше общего количества дисков в кластере, ориентируясь на объём около 5 GB сжатых данных на бакет.
- Используйте случайное распределение (
DISTRIBUTED BY RANDOM BUCKETS 60) в сочетании с загрузкой в один таблет при записи, чтобы повысить эффективность пакетной записи.
Дополнительные сведения о партиционировании и бакетировании см. в разделе Партиционирование данных.
3.4.2 Настройка параметров сжатия
- Используйте алгоритм сжатия Zstd (
"compression" = "zstd"), чтобы повысить коэффициент сжатия данных.
3.4.3 Настройка параметров компактации
- Используйте политику временных рядов (
"compaction_policy" = "time_series"), чтобы уменьшить усиление записи, которое существенно влияет на потребление ресурсов при высокопроизводительной записи логов.
3.4.4 Создание и настройка индексов
- Создавайте индексы для полей, часто используемых в запросах (
USING INVERTED). - Для полей, по которым нужен полнотекстовый поиск, задайте параметру токенизатора (
parser) значениеunicode, подходящее для большинства задач. Для поддержки фразовых запросов задайтеsupport_phraseзначениеtrue; если они не нужны, задайте значениеfalse, чтобы сократить объём хранения.
3.4.5 Настройка политик хранения
- Хранение горячих данных: при использовании облачных дисков можно настроить 1 реплику; при использовании физических дисков настройте не менее 2 реплик (
"replication_num" = "2"). - Многоуровневое хранение горячих и холодных данных: настройте место хранения
log_s3(CREATE RESOURCE "log_s3") и задайте политику многоуровневого храненияlog_policy_3day(CREATE STORAGE POLICY log_policy_3day), чтобы данные старше 3 дней автоматически переносились на холодный уровень в хранилище, указанное вlog_s3.
3.4.6 Полный пример создания таблицы
CREATE DATABASE log_db;
USE log_db;

CREATE RESOURCE "log_s3"
PROPERTIES
(
    "type" = "s3",
    "s3.endpoint" = "your_endpoint_url",
    "s3.region" = "your_region",
    "s3.bucket" = "your_bucket",
    "s3.root.path" = "your_path",
    "s3.access_key" = "your_ak",
    "s3.secret_key" = "your_sk"
);

CREATE STORAGE POLICY log_policy_3day
PROPERTIES(
    "storage_resource" = "log_s3",
    "cooldown_ttl" = "259200"
);

CREATE TABLE log_table
(
  `ts` DATETIME,
  `host` TEXT,
  `path` TEXT,
  `message` TEXT,
  INDEX idx_host (`host`) USING INVERTED,
  INDEX idx_path (`path`) USING INVERTED,
  INDEX idx_message (`message`) USING INVERTED PROPERTIES("parser" = "unicode", "support_phrase" = "true")
)
ENGINE = OLAP
DUPLICATE KEY(`ts`)
PARTITION BY RANGE(`ts`) ()
DISTRIBUTED BY RANDOM BUCKETS 60
PROPERTIES (
  "compression" = "zstd",
  "compaction_policy" = "time_series",
  "dynamic_partition.enable" = "true",
  "dynamic_partition.create_history_partition" = "true",
  "dynamic_partition.time_unit" = "DAY",
  "dynamic_partition.start" = "-30",
  "dynamic_partition.end" = "1",
  "dynamic_partition.prefix" = "p",
  "dynamic_partition.buckets" = "60",
  "dynamic_partition.replication_num" = "2", -- Not needed in compute-storage separation
  "replication_num" = "2",                    -- Not needed in compute-storage separation
  "storage_policy" = "log_policy_3day"        -- Not needed in compute-storage separation
);
3.5 Сбор логов
После создания таблицы можно начать сбор логов. Apache Doris предоставляет открытый универсальный Stream HTTP API, который интегрируется с распространёнными сборщиками логов (Logstash, Filebeat, Kafka и др.). В следующей таблице приведены сценарии применения каждого способа сбора:
| Способ сбора | Сценарий применения |
|---|---|
| Logstash | Существующие конвейеры Logstash, которым нужна развитая экосистема фильтров и плагинов |
| Filebeat | Легковесный сбор файлов при ограниченных ресурсах |
| Kafka Routine Load | Логи уже находятся в Kafka, откуда Doris самостоятельно забирает их |
| Собственная программа (Stream Load) | Собственные программы сбора и интеграция со специализированными источниками данных |
3.5.1 Интеграция с Logstash
Выполните следующие шаги:
-
Скачайте и установите плагин Logstash Doris Output. Выберите один из следующих способов:
-
Прямое скачивание: нажмите здесь, чтобы скачать.
-
Соберите из исходного кода, затем установите следующей командой:
./bin/logstash-plugin install logstash-output-doris-1.2.0.gem
-
-
Настройте Logstash. Потребуются следующие два файла:
-
logstash.yml: настройте размер пакета и задержку, которые Logstash использует для группировки логов, чтобы повысить производительность записи.pipeline.batch.size: 1000000
pipeline.batch.delay: 10000 -
logstash_demo.conf: настройте путь к собираемым логам и параметры отправки в Apache Doris.input {
file {
path => "/path/to/your/log"
}
}
output {
doris {
http_hosts => [ "<http://fehost1:http_port>", "<http://fehost2:http_port>", "<http://fehost3:http_port>" ]
user => "your_username"
password => "your_password"
db => "your_db"
table => "your_table"
# doris stream load http headers
headers => {
"format" => "json"
"read_json_by_line" => "true"
"load_to_single_tablet" => "true"
}
# field mapping: doris fileld name => logstash field name
# %{} to get a logstash field, [] for nested field such as [host][name] for host.name
mapping => {
"ts" => "%{@timestamp}"
"host" => "%{[host][name]}"
"path" => "%{[log][file][path]}"
"message" => "%{message}"
}
log_request => true
log_speed_interval => 10
}
}
-
-
Запустите Logstash для сбора логов и отправки их в Apache Doris:
./bin/logstash -f logstash_demo.conf
Дополнительные сведения о настройке см. в разделе Плагин Logstash Doris Output.
3.5.2 Интеграция с Filebeat
Выполните следующие шаги:
-
Получите исполняемый файл Filebeat с поддержкой отправки данных в Apache Doris. Его можно скачать здесь или собрать из исходного кода Apache Doris.
-
Настройте Filebeat. Основной файл конфигурации
filebeat_demo.ymlзадаёт путь к собираемым логам и параметры отправки в Apache Doris:# input
filebeat.inputs:
- type: log
enabled: true
paths:
- /path/to/your/log
# multiline can join lines that span multiple lines (such as Java stack traces) into a single log
multiline:
type: pattern
# Behavior: lines starting with yyyy-mm-dd HH:MM:SS are treated as a new log; others are appended to the previous log
pattern: '^[0-9]{4}-[0-9]{2}-[0-9]{2} [0-9]{2}:[0-9]{2}:[0-9]{2}'
negate: true
match: after
skip_newline: true
processors:
# Use the js script plugin to replace \t in the log with spaces, to avoid JSON parsing errors
- script:
lang: javascript
source: >
function process(event) {
var msg = event.Get("message");
msg = msg.replace(/\t/g, " ");
event.Put("message", msg);
}
# Use the dissect plugin for simple log parsing
- dissect:
# 2024-06-08 18:26:25,481 INFO (report-thread|199) [ReportHandler.cpuReport():617] begin to handle
tokenizer: "%{day} %{time} %{log_level} (%{thread}) [%{position}] %{content}"
target_prefix: ""
ignore_failure: true
overwrite_keys: true
# queue and batch
queue.mem:
events: 1000000
flush.min_events: 100000
flush.timeout: 10s
# output
output.doris:
fenodes: [ "http://fehost1:http_port", "http://fehost2:http_port", "http://fehost3:http_port" ]
user: "your_username"
password: "your_password"
database: "your_db"
table: "your_table"
# output string format
## %{[agent][hostname]} %{[log][file][path]} are metadata that come with filebeat
## Another commonly used filebeat metadata is the collection timestamp %{[@timestamp]}
## %{[day]} %{[time]} are the fields parsed by the dissect step above
codec_format_string: '{"ts": "%{[day]} %{[time]}", "host": "%{[agent][hostname]}", "path": "%{[log][file][path]}", "message": "%{[message]}"}'
headers:
format: "json"
read_json_by_line: "true"
load_to_single_tablet: "true" -
Запустите Filebeat для сбора логов и отправки их в Apache Doris:
chmod +x filebeat-doris-2.1.1
./filebeat-doris-2.1.1 -c filebeat_demo.yml
Дополнительные сведения о настройке см. в разделе Плагин Beats Doris Output.
3.5.3 Интеграция с Kafka
Запишите логи в формате JSON в очередь сообщений Kafka, затем создайте задачу Kafka Routine Load, чтобы Apache Doris самостоятельно забирал данные из Kafka.
См. пример ниже: параметры property.* относятся к клиенту Librdkafka; настройте их в соответствии с конфигурацией своего кластера Kafka:
-- Prepare the kafka cluster and topic log__topic_
-- Create a routine load that imports data from kafka log__topic_ into the log_table table
CREATE ROUTINE LOAD load_log_kafka ON log_db.log_table
COLUMNS(ts, host, path, message)
PROPERTIES (
"max_batch_interval" = "60",
"max_batch_rows" = "20000000",
"max_batch_size" = "1073741824",
"load_to_single_tablet" = "true",
"format" = "json"
)
FROM KAFKA (
"kafka_broker_list" = "host:port",
"kafka_topic" = "log__topic_",
"property.group.id" = "your_group_id",
"property.security.protocol"="SASL_PLAINTEXT",
"property.sasl.mechanism"="GSSAPI",
"property.sasl.kerberos.service.name"="kafka",
"property.sasl.kerberos.keytab"="/path/to/xxx.keytab",
"property.sasl.kerberos.principal"="<xxx@yyy.com>"
);
-- Check the status of the routine load
SHOW ROUTINE LOAD;
Дополнительные сведения о настройке Kafka см. в разделе Routine Load.
3.5.4 Сбор логов с помощью собственной программы
Помимо интеграции с распространёнными сборщиками логов, можно импортировать логи собственной программой через HTTP API Stream Load:
curl
--location-trusted
-u username:password
-H "format:json"
-H "read_json_by_line:true"
-H "load_to_single_tablet:true"
-H "timeout:600"
-T logfile.json
http://fe_host:fe_http_port/api/log_db/log_table/_stream_load
При использовании собственной программы учитывайте следующие ключевые моменты:
- Используйте Basic Auth для аутентификации HTTP. Значение можно вычислить командой
echo -n 'username:password' | base64. - Задайте HTTP-заголовок
format:json, чтобы указать формат данных JSON. - Задайте HTTP-заголовок
read_json_by_line:true, чтобы указать, что каждая строка содержит отдельный объект JSON. - Задайте HTTP-заголовок
load_to_single_tablet:true, чтобы каждая загрузка записывалась в один бакет, сокращая количество мелких файлов. - Рекомендуется отправлять с клиента пакеты размером от 100 MB до 1 GB. В Apache Doris 2.1 и более поздних версиях серверная функция Group Commit позволяет уменьшить размер пакета на стороне клиента.
3.6 Запросы и анализ логов
3.6.1 Запросы к логам
Apache Doris поддерживает стандартный SQL. Для выполнения SQL-запросов можно подключиться к кластеру через клиент MySQL, JDBC или другие инструменты:
mysql -h fe_host -P fe_mysql_port -u your_username -Dyour_db_name
Ниже для справки приведены 5 распространённых SQL-запросов:
-
Просмотреть последние 10 записей:
SELECT * FROM your_table_name ORDER BY ts DESC LIMIT 10; -
Получить последние 10 записей, в которых
hostравен8.8.8.8:SELECT * FROM your_table_name WHERE host = '8.8.8.8' ORDER BY ts DESC LIMIT 10; -
Найти последние 10 записей, в которых поле
messageсодержитerrorили404.MATCH_ANYпредставляет собой синтаксис SQL для полнотекстового поиска в Apache Doris и находит совпадения с любым из ключевых слов в аргументе:SELECT * FROM your_table_name WHERE message MATCH_ANY 'error 404'
ORDER BY ts DESC LIMIT 10; -
Найти последние 10 записей, в которых поле
messageсодержит иimage, иfaq.MATCH_ALLпредставляет собой синтаксис SQL для полнотекстового поиска в Apache Doris и находит совпадения со всеми ключевыми словами в аргументе:SELECT * FROM your_table_name WHERE message MATCH_ALL 'image faq'
ORDER BY ts DESC LIMIT 10; -
Найти последние 10 записей, в которых поле
messageсодержит иimage, иfaq.MATCH_PHRASEпредставляет собой синтаксис SQL для полнотекстового поиска в Apache Doris и находит совпадения со всеми ключевыми словами в аргументе в том же порядке. Например,a image faq bподходит, аa faq image bнет:SELECT * FROM your_table_name WHERE message MATCH_PHRASE 'image faq'
ORDER BY ts DESC LIMIT 10;
3.6.2 Визуальный анализ логов
Некоторые сторонние поставщики предлагают платформы визуального анализа логов на базе Apache Doris, включая интерфейс поиска и анализа, похожий на Kibana Discover. Такой интерфейс позволяет удобно и наглядно исследовать логи:
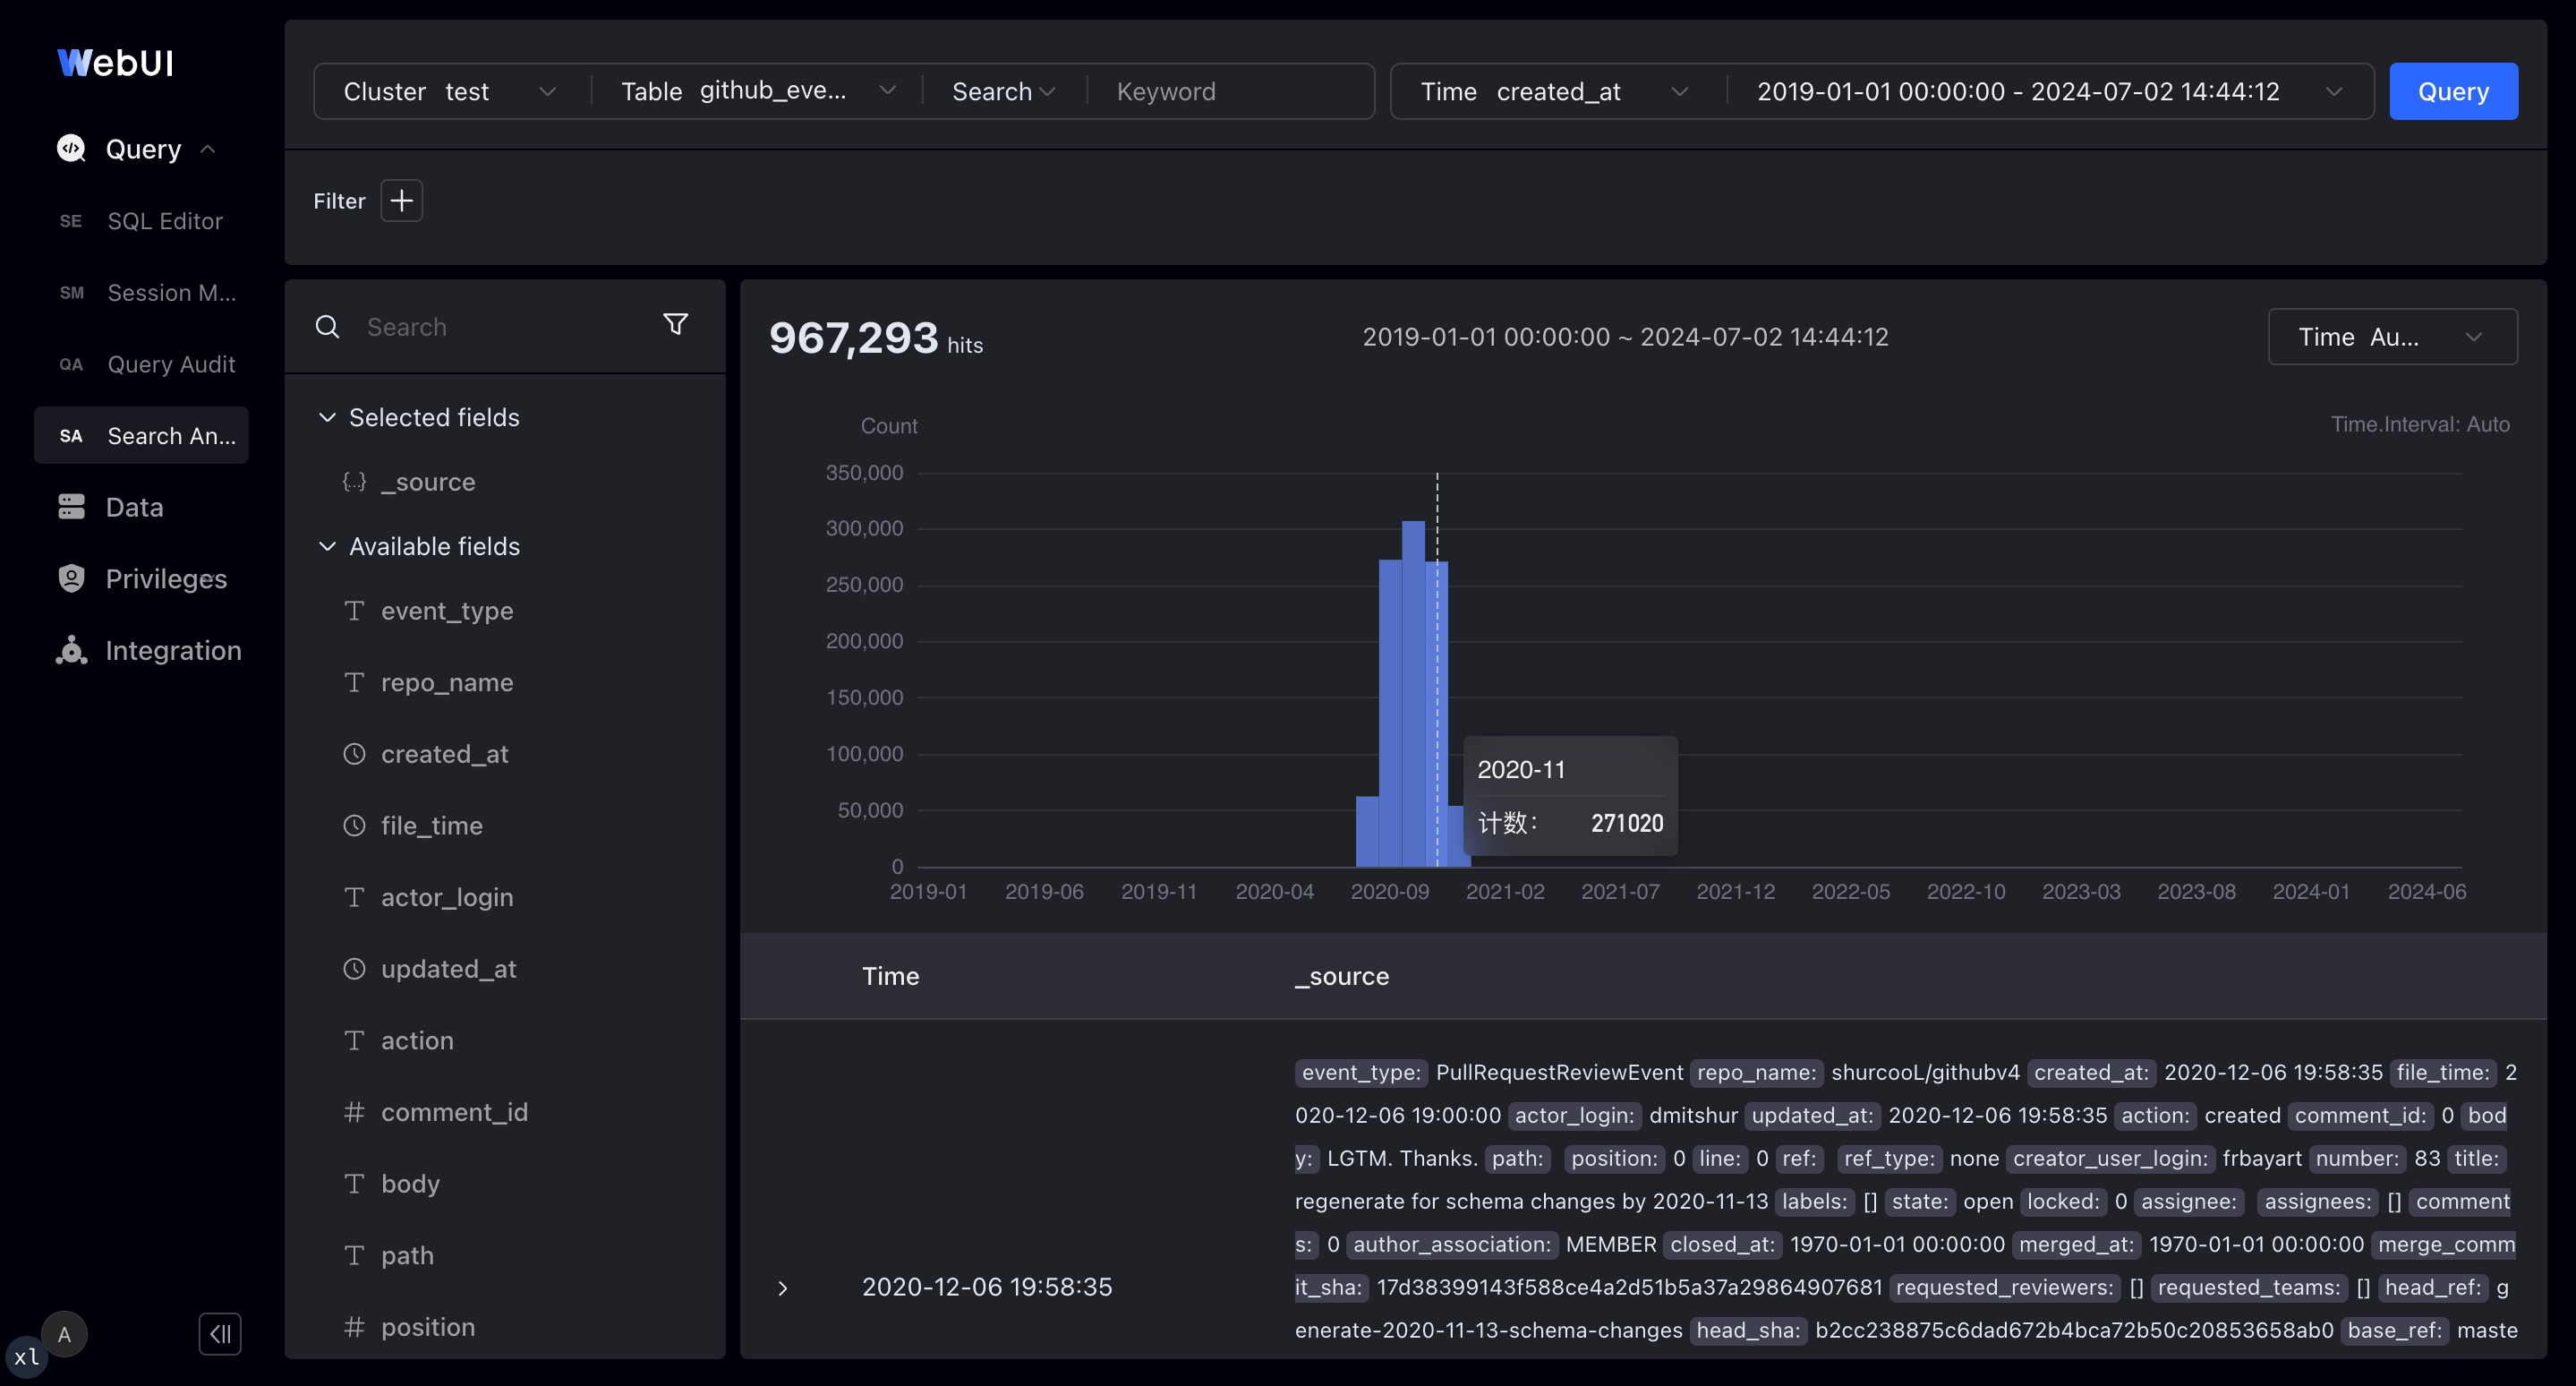
- Поддерживает как полнотекстовый поиск, так и режим SQL
- Позволяет выбирать временной диапазон запросов к логам с помощью элемента выбора времени и гистограммы
- Предоставляет подробное представление записей логов с возможностью раскрытия в виде JSON или таблиц
- Позволяет интерактивно добавлять и удалять фильтры щелчком по данным логов
- Показывает наиболее частые значения полей в результатах поиска, помогая обнаруживать аномалии и продолжать детальный анализ
Если вам нужна дополнительная помощь, напишите на dev@doris.apache.org.
4. Часто задаваемые вопросы
Вопрос 1: Каковы основные различия между Apache Doris и Elasticsearch при работе с логами?
Ответ: пропускная способность записи Doris в 3–5 раз выше, чем у Elasticsearch, а затраты на хранение составляют лишь около 20% от затрат при использовании Elasticsearch. Doris также поддерживает стандартный SQL и протокол MySQL, предоставляя более широкие аналитические возможности. Многоуровневое хранение позволяет перемещать холодные данные в S3/HDFS, дополнительно сокращая затраты на хранение.
Вопрос 2: Поля логов часто меняются. Как с этим работать?
Ответ: используйте Light Schema Change для выполнения ADD/DROP COLUMN и ADD/DROP INDEX над полями верхнего уровня за секунды. Для динамических вложенных полей используйте тип VARIANT, который автоматически определяет имена и типы полей и поддерживает инвертированные индексы для VARIANT.
Вопрос 3: Как выбрать количество бакетов?
Ответ: задайте количество бакетов примерно в 3 раза больше общего количества дисков в кластере, ориентируясь на объём около 5 GB сжатых данных на бакет. Используйте это вместе с DISTRIBUTED BY RANDOM и записью в один таблет, чтобы повысить эффективность пакетной записи.
Вопрос 4: В каких единицах задаётся cooldown_ttl в политике многоуровневого хранения горячих и холодных данных?
Ответ: в секундах. Например, 259200 означает 3 дня, после чего данные автоматически переносятся на холодный уровень в объектное хранилище, указанное в политике хранения.
Вопрос 5: Как выбрать размер пакета на стороне записи?
Ответ: рекомендуется размер пакета от 100 MB до 1 GB на запрос. В Apache Doris 2.1 и более поздних версиях можно включить серверную функцию Group Commit и использовать меньший размер пакета на клиенте.
5. Устранение неполадок
| Проблема | Возможная причина | Рекомендуемое действие |
|---|---|---|
| Загрузка с высокой степенью параллелизма превышает лимит транзакций | Значение max_running_txn_num_per_db по умолчанию слишком мало | Увеличьте max_running_txn_num_per_db = 10000 |
| Часто истекает время ожидания heartbeat от BE | Высокая нагрузка при записи логов вызывает кратковременную недоступность BE | Увеличьте max_backend_heartbeat_failure_tolerance_count = 10 |
| Запись создаёт много мелких файлов / случайных операций ввода-вывода | Буфер записи слишком мал или не используется загрузка в один таблет | Увеличьте write_buffer_size = 1073741824 и задайте load_to_single_tablet:true |
| Компактация выполняется медленно и влияет на запись | Недостаточно потоков компактации или действует ограничение планирования с низким приоритетом | Задайте max_cumu_compaction_threads равным числу ядер CPU / 4 и отключите enable_compaction_priority_scheduling |
| Индексы занимают слишком много памяти | Кеш данных и кеш индексов конкурируют за память | Отключите disable_storage_page_cache и ограничьте inverted_index_searcher_cache_limit = 30% |
| Фразовые запросы при полнотекстовом поиске не работают | Для индекса не включён support_phrase | Задайте "support_phrase" = "true" при создании индекса |
| Автоматическое бакетирование создаёт слишком мало бакетов, вызывая неравномерную нагрузку | Значение autobucket_min_buckets слишком мало | Увеличьте autobucket_min_buckets = 10 |