Соединения (JOIN)
При анализе данных бизнес-данные часто распределены по нескольким таблицам (например, таблице заказов, таблице пользователей и таблице товаров). Когда нужно связать эти таблицы и получить полный результат анализа, используется JOIN. В этой статье описаны типы JOIN, поддерживаемые Apache Doris, а также физические реализации и стратегии Shuffle для JOIN в архитектуре MPP. Это поможет выбрать подходящий способ выполнения JOIN для вашей задачи.
Что такое JOIN
В реляционной базе данных данные распределены по нескольким таблицам, связанным друг с другом определёнными отношениями. Операция SQL JOIN позволяет объединять разные таблицы в более полный результирующий набор на основе условий, определяющих эти связи.
Типы JOIN, поддерживаемые Doris
Doris поддерживает следующие типы JOIN, охватывающие различные сценарии: от обычных соединений до антисоединений и полусоединений:
| Тип JOIN | Описание |
|---|---|
| INNER JOIN | Сравнивает каждую строку левой таблицы со всеми строками правой таблицы по условию JOIN и возвращает строки обеих таблиц, удовлетворяющие этому условию. |
| LEFT JOIN | Дополняет результирующий набор INNER JOIN: если для строки левой таблицы нет соответствия в правой таблице, строка левой таблицы всё равно возвращается, а соответствующие столбцы правой таблицы заполняются значениями NULL. |
| RIGHT JOIN | Работает противоположно LEFT JOIN: если для строки правой таблицы нет соответствия в левой таблице, строка правой таблицы всё равно возвращается, а соответствующие столбцы левой таблицы заполняются значениями NULL. |
| FULL JOIN | Дополняет результирующий набор INNER JOIN, возвращая все строки обеих таблиц. Если для строки нет соответствия в другой таблице, соответствующие столбцы другой таблицы заполняются значениями NULL. |
| CROSS JOIN | Не содержит условия JOIN и возвращает декартово произведение двух таблиц: каждая строка левой таблицы объединяется с каждой строкой правой таблицы. |
| LEFT SEMI JOIN | Сравнивает каждую строку левой таблицы со всеми строками правой таблицы по условию JOIN и, если соответствие найдено, возвращает эту строку левой таблицы. |
| RIGHT SEMI JOIN | Работает противоположно LEFT SEMI JOIN: сравнивает каждую строку правой таблицы со всеми строками левой таблицы по условию JOIN и, если соответствие найдено, возвращает эту строку правой таблицы. |
| LEFT ANTI JOIN | Сравнивает каждую строку левой таблицы со всеми строками правой таблицы по условию JOIN и, если соответствие не найдено, возвращает эту строку левой таблицы. |
| RIGHT ANTI JOIN | Работает противоположно LEFT ANTI JOIN: сравнивает каждую строку правой таблицы со всеми строками левой таблицы по условию JOIN и возвращает те строки, для которых соответствие не найдено. |
| NULL AWARE LEFT ANTI JOIN | Разновидность LEFT ANTI JOIN с особой обработкой значений NULL. Работает аналогично LEFT ANTI JOIN, но игнорирует строки левой таблицы, в которых столбец сопоставления содержит NULL. |
Полный синтаксис SQL для JOIN приведён в разделе SELECT.
Физические реализации JOIN
Doris поддерживает две физические реализации JOIN: Hash Join и Nest Loop Join. Они применяются в следующих сценариях:
-
Hash Join: строит хеш-таблицу для правой таблицы на основе столбцов equi-JOIN и пропускает через неё поток данных левой таблицы для вычисления JOIN. Ограничение этого подхода заключается в том, что он применим только к условиям equi-JOIN.
-
Nest Loop Join: использует два вложенных цикла, где внешний цикл проходит по левой таблице. Для каждой строки левой таблицы перебираются все строки правой таблицы и проверяется условие JOIN. Этот способ применим ко всем сценариям JOIN, включая те, с которыми Hash Join не справляется, например к запросам со сравнениями «больше» или «меньше», а также к запросам, требующим вычисления декартова произведения. Однако Nest Loop Join может уступать Hash Join по производительности.
Стратегии Shuffle для Hash Join
Как распределённая база данных с архитектурой MPP, Apache Doris должна перераспределять данные при выполнении Hash Join, чтобы надлежащим образом направлять и разделять их, обеспечивая корректность результатов JOIN. Doris предоставляет четыре стратегии Shuffle, перечисленные в порядке возрастания требований к распределению данных и потенциальной производительности: Broadcast Join, Partition Shuffle Join, Bucket Shuffle Join и Colocate Join.
Broadcast Join
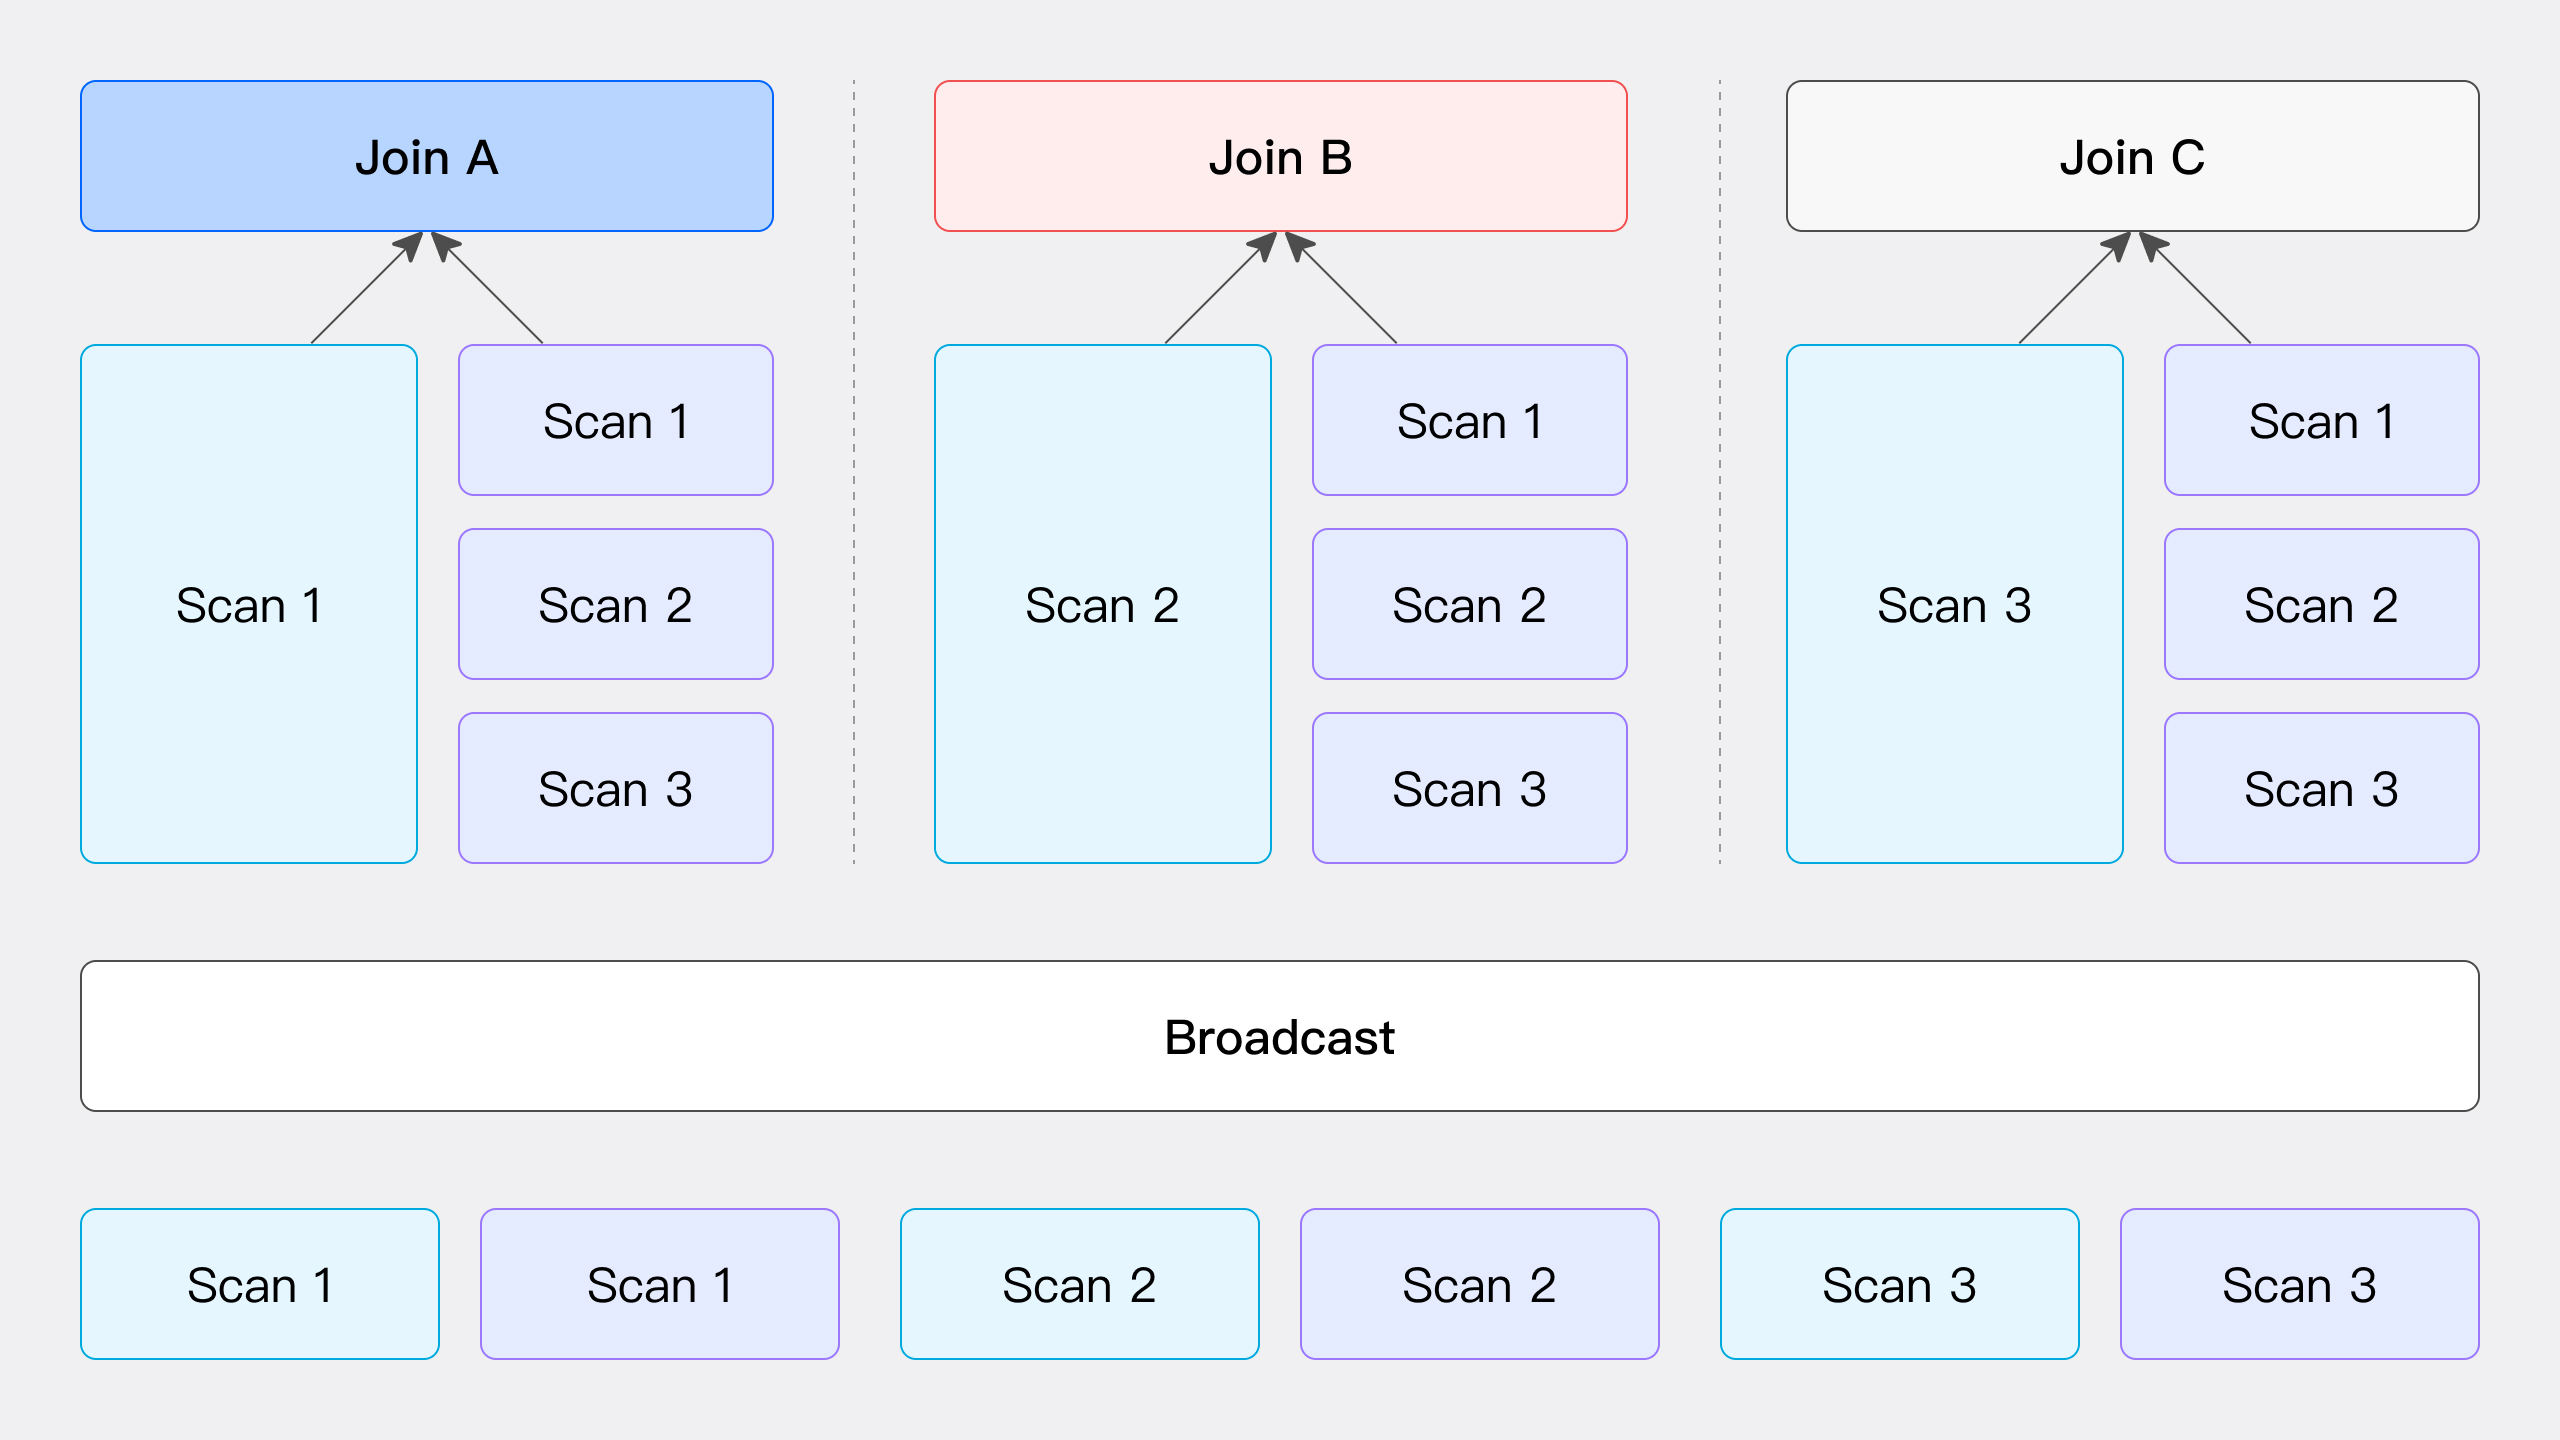
Как показано на рисунке, при Broadcast Join все данные правой таблицы отправляются на каждый узел, участвующий в вычислении JOIN, включая узлы сканирования данных левой таблицы, а данные левой таблицы остаются на месте. При этом каждый узел получает полную копию данных правой таблицы (объёмом T(R)), чтобы у всех узлов были данные, необходимые для выполнения JOIN.
Этот метод подходит для многих типовых сценариев, но неприменим к Hash Join типов RIGHT OUTER, RIGHT ANTI и RIGHT SEMI. Его сетевые затраты равны числу узлов JOIN N, умноженному на объём данных правой таблицы T(R).
Partition Shuffle Join
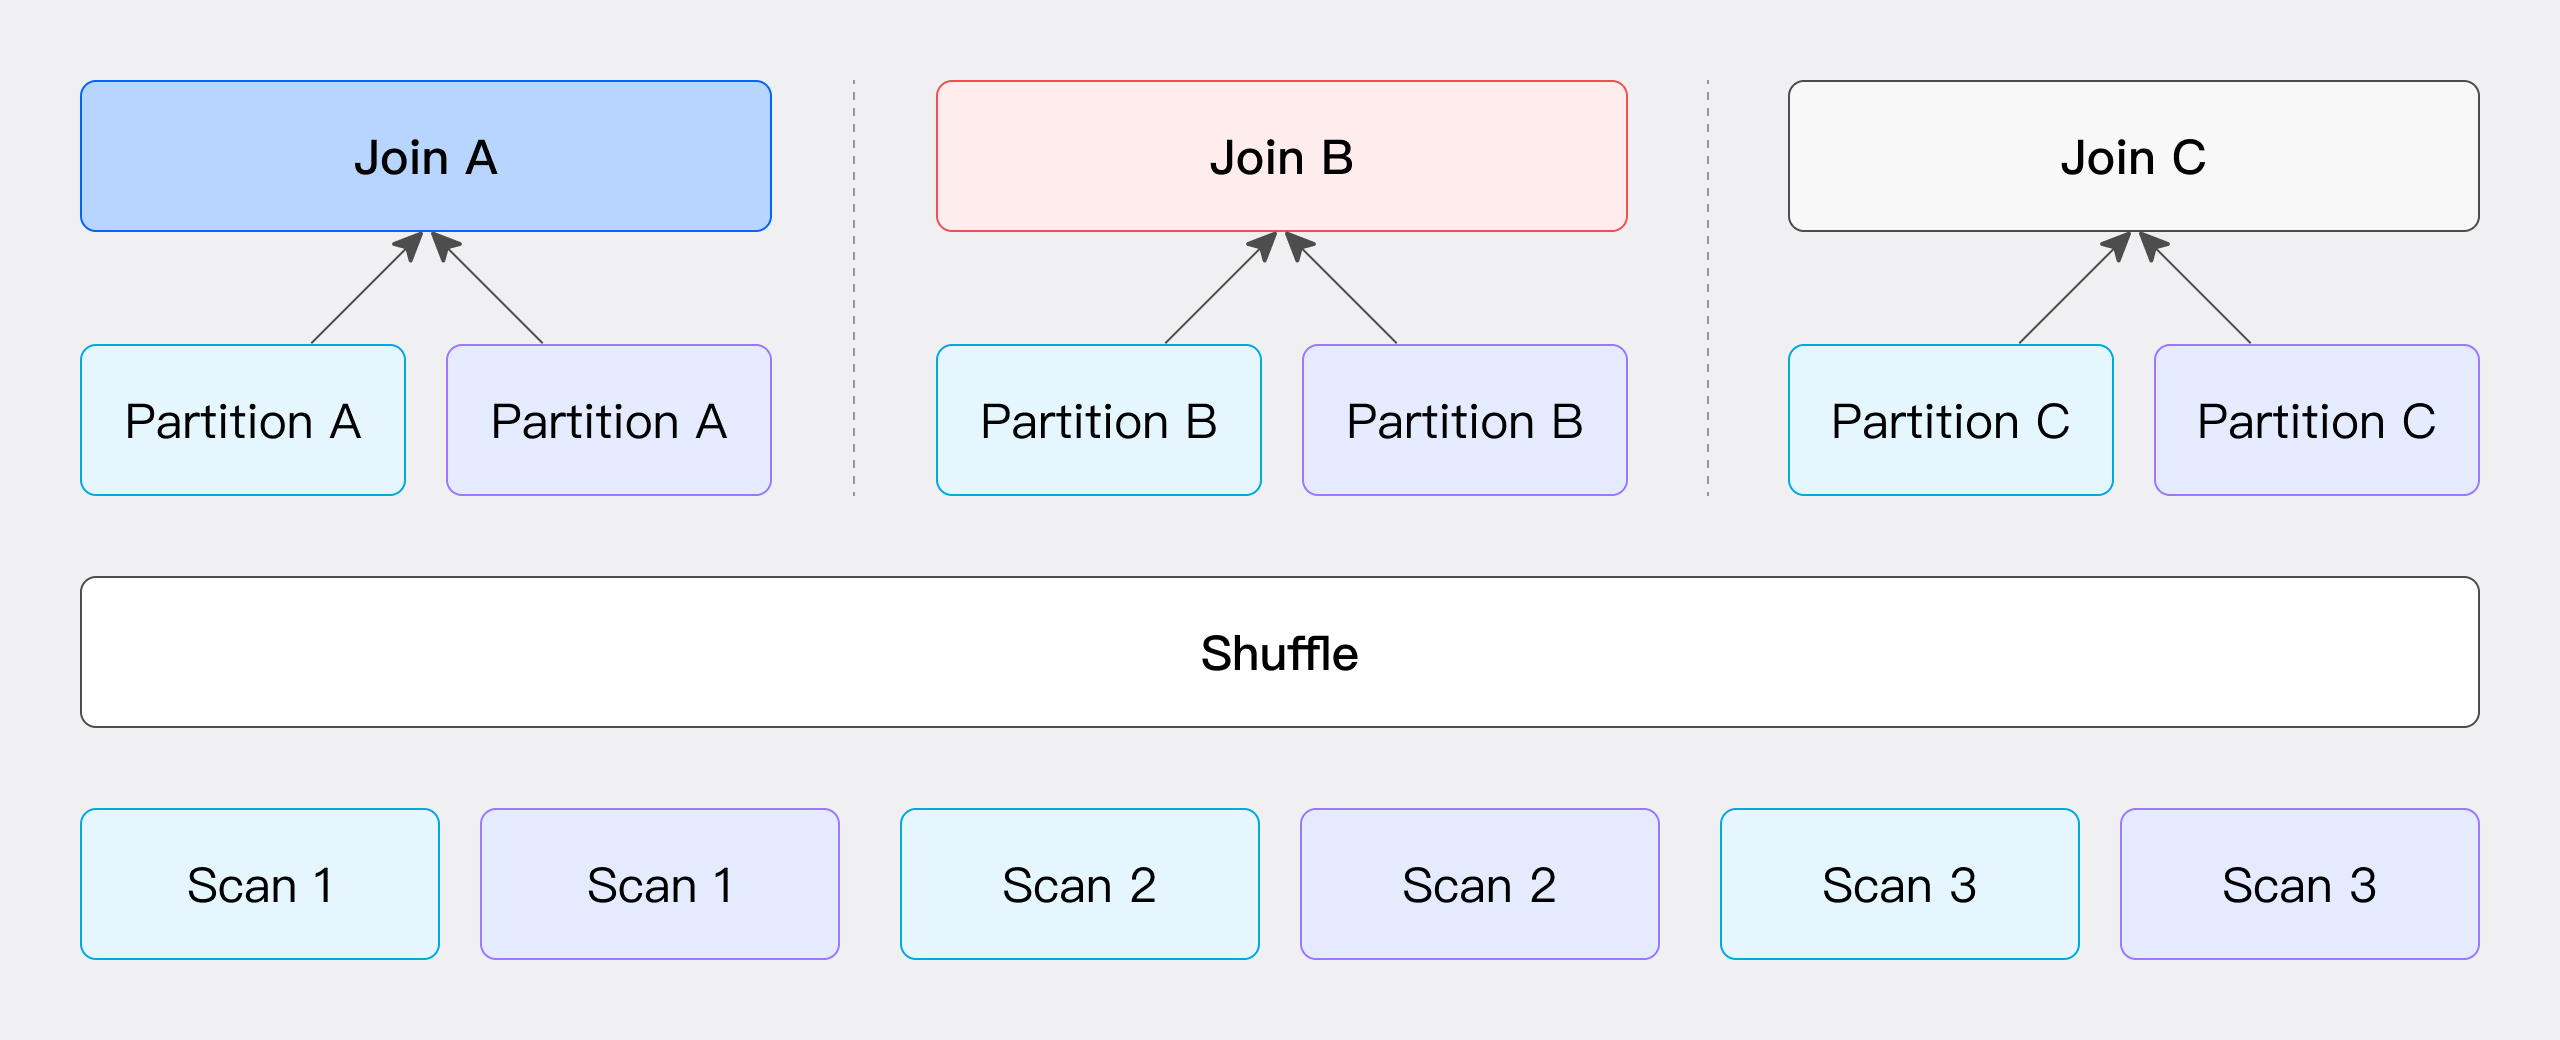
Этот метод вычисляет хеш-значение на основе условия JOIN и разделяет данные в соответствии с ним. Данные как левой, так и правой таблицы разделяются по хеш-значению, вычисленному на основе условия JOIN, после чего полученные части отправляются на соответствующие узлы (как показано на рисунке).
Сетевые затраты этого метода состоят из двух частей: затрат на передачу данных левой таблицы T(S) и затрат на передачу данных правой таблицы T(R). Этот метод поддерживает только Hash Join, поскольку для распределения данных по бакетам он использует условие JOIN.
Bucket Shuffle Join
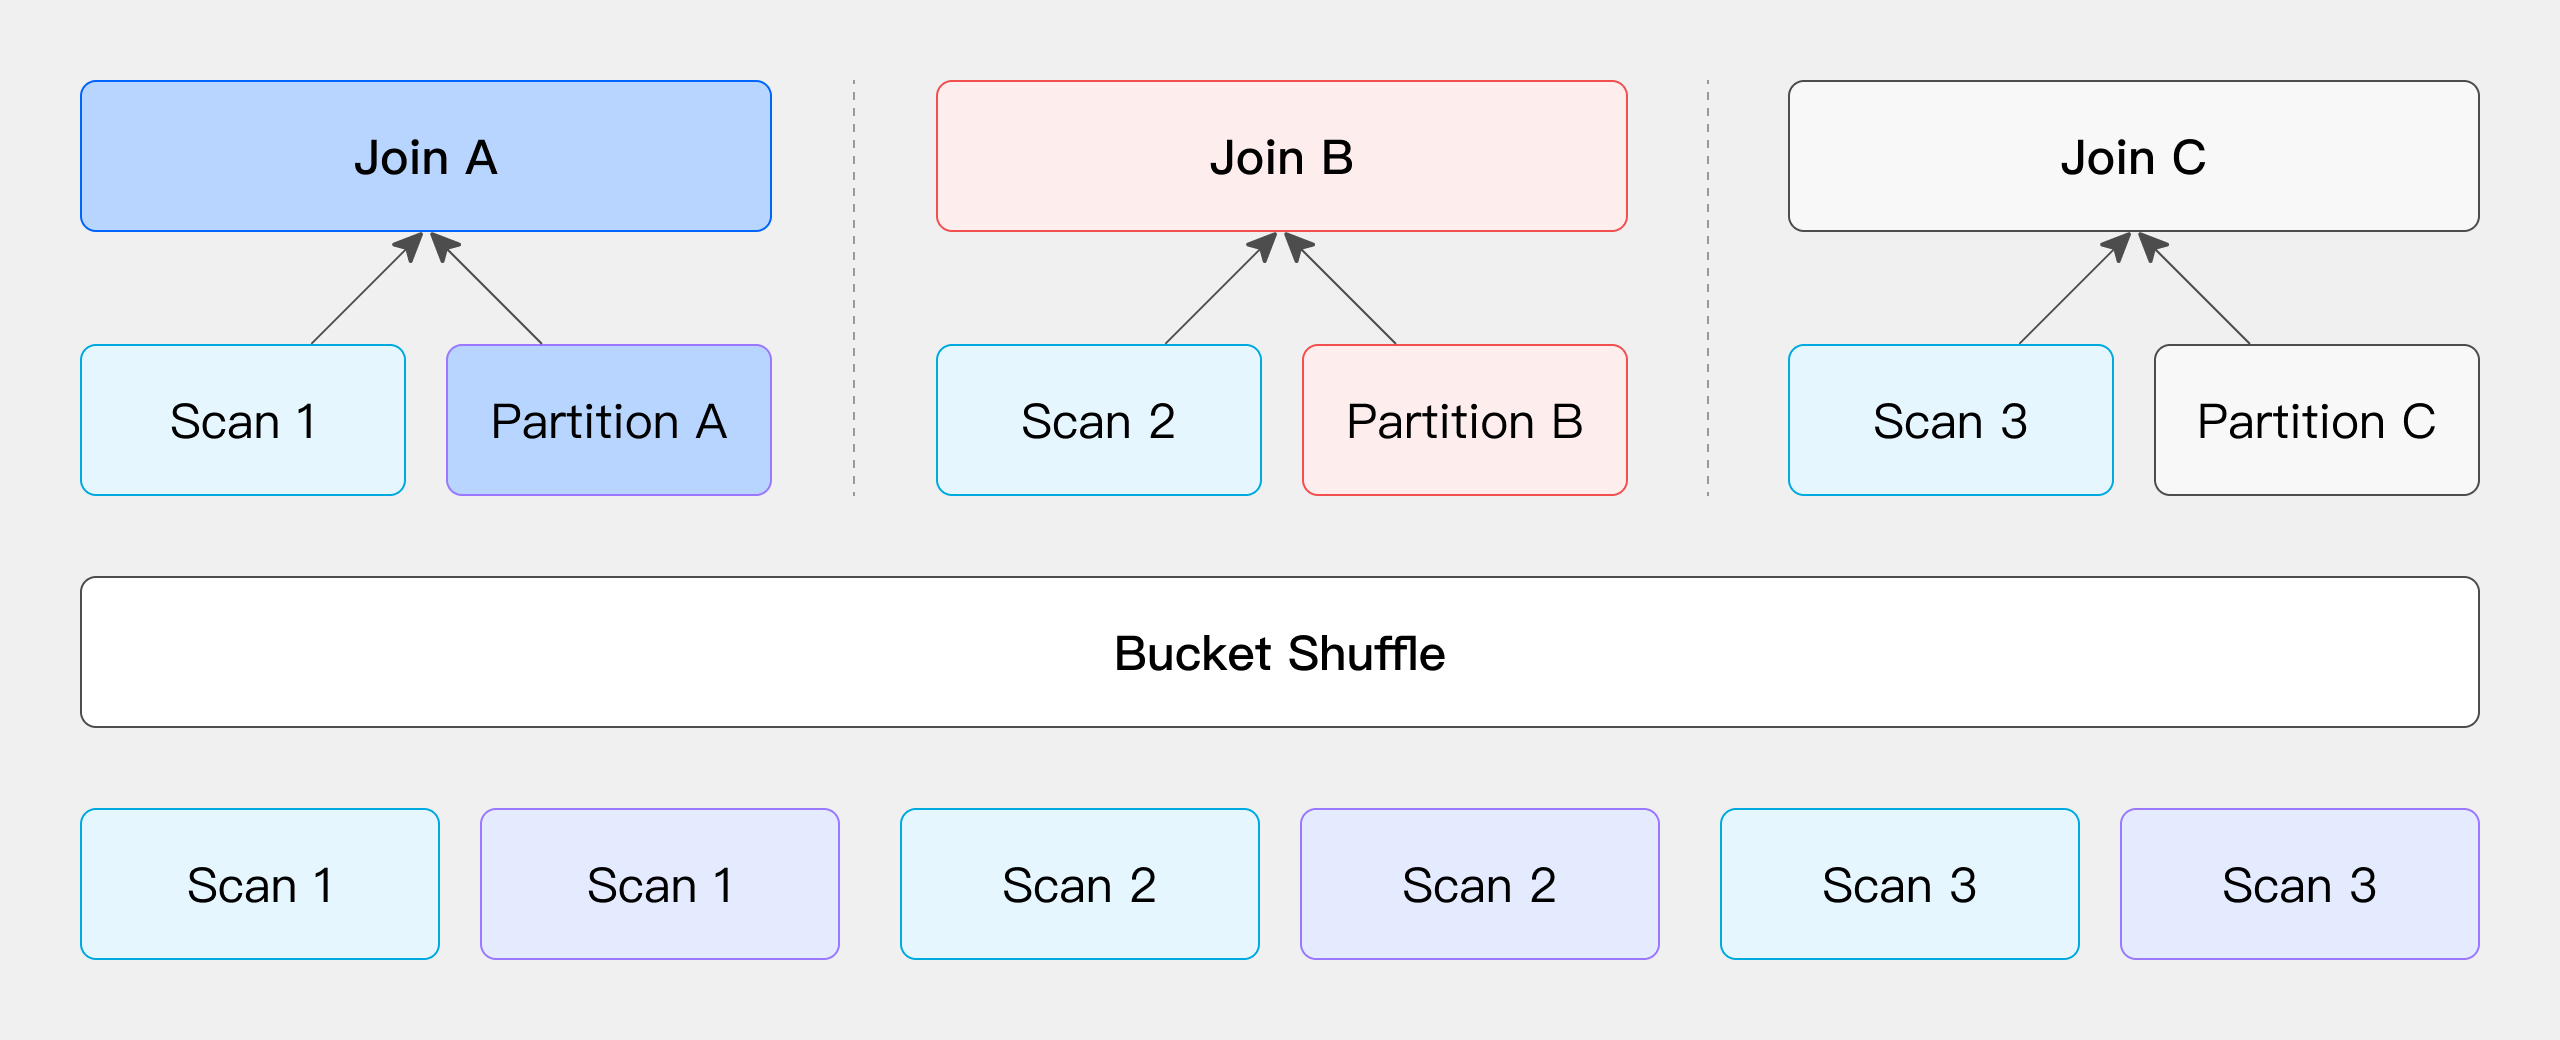
Если условие JOIN включает столбец бакетирования левой таблицы, данные левой таблицы остаются на месте, а данные правой таблицы распределяются по узлам левой таблицы для выполнения JOIN, что снижает сетевые затраты.
Если данные одной из сторон JOIN уже распределены по хешу столбца из условия JOIN, их можно оставить на месте, а данные другой стороны распределить по тому же столбцу из условия JOIN, используя тот же способ вычисления хеша. (Под «таблицей» здесь понимается не только физически хранимая таблица, но и результат любого оператора в SQL-запросе. Можно оставить на месте данные как левой, так и правой таблицы, перемещая и распределяя данные другой стороны.)
Рассмотрим в качестве примера физическую таблицу Doris. Поскольку её данные уже хранятся в бакетах, определяемых вычислением хеша, это свойство можно напрямую использовать для оптимизации перераспределения данных при выполнении JOIN. Предположим, нужно соединить две таблицы, а столбец JOIN является столбцом бакетирования левой таблицы. В этом случае перемещать данные левой таблицы не нужно: для вычисления JOIN достаточно распределить данные правой таблицы по соответствующим местам на основе информации о бакетах левой таблицы (как показано на рисунке).
Сетевые затраты этого процесса в основном связаны с перемещением данных правой таблицы и составляют T(R).
Colocate Join
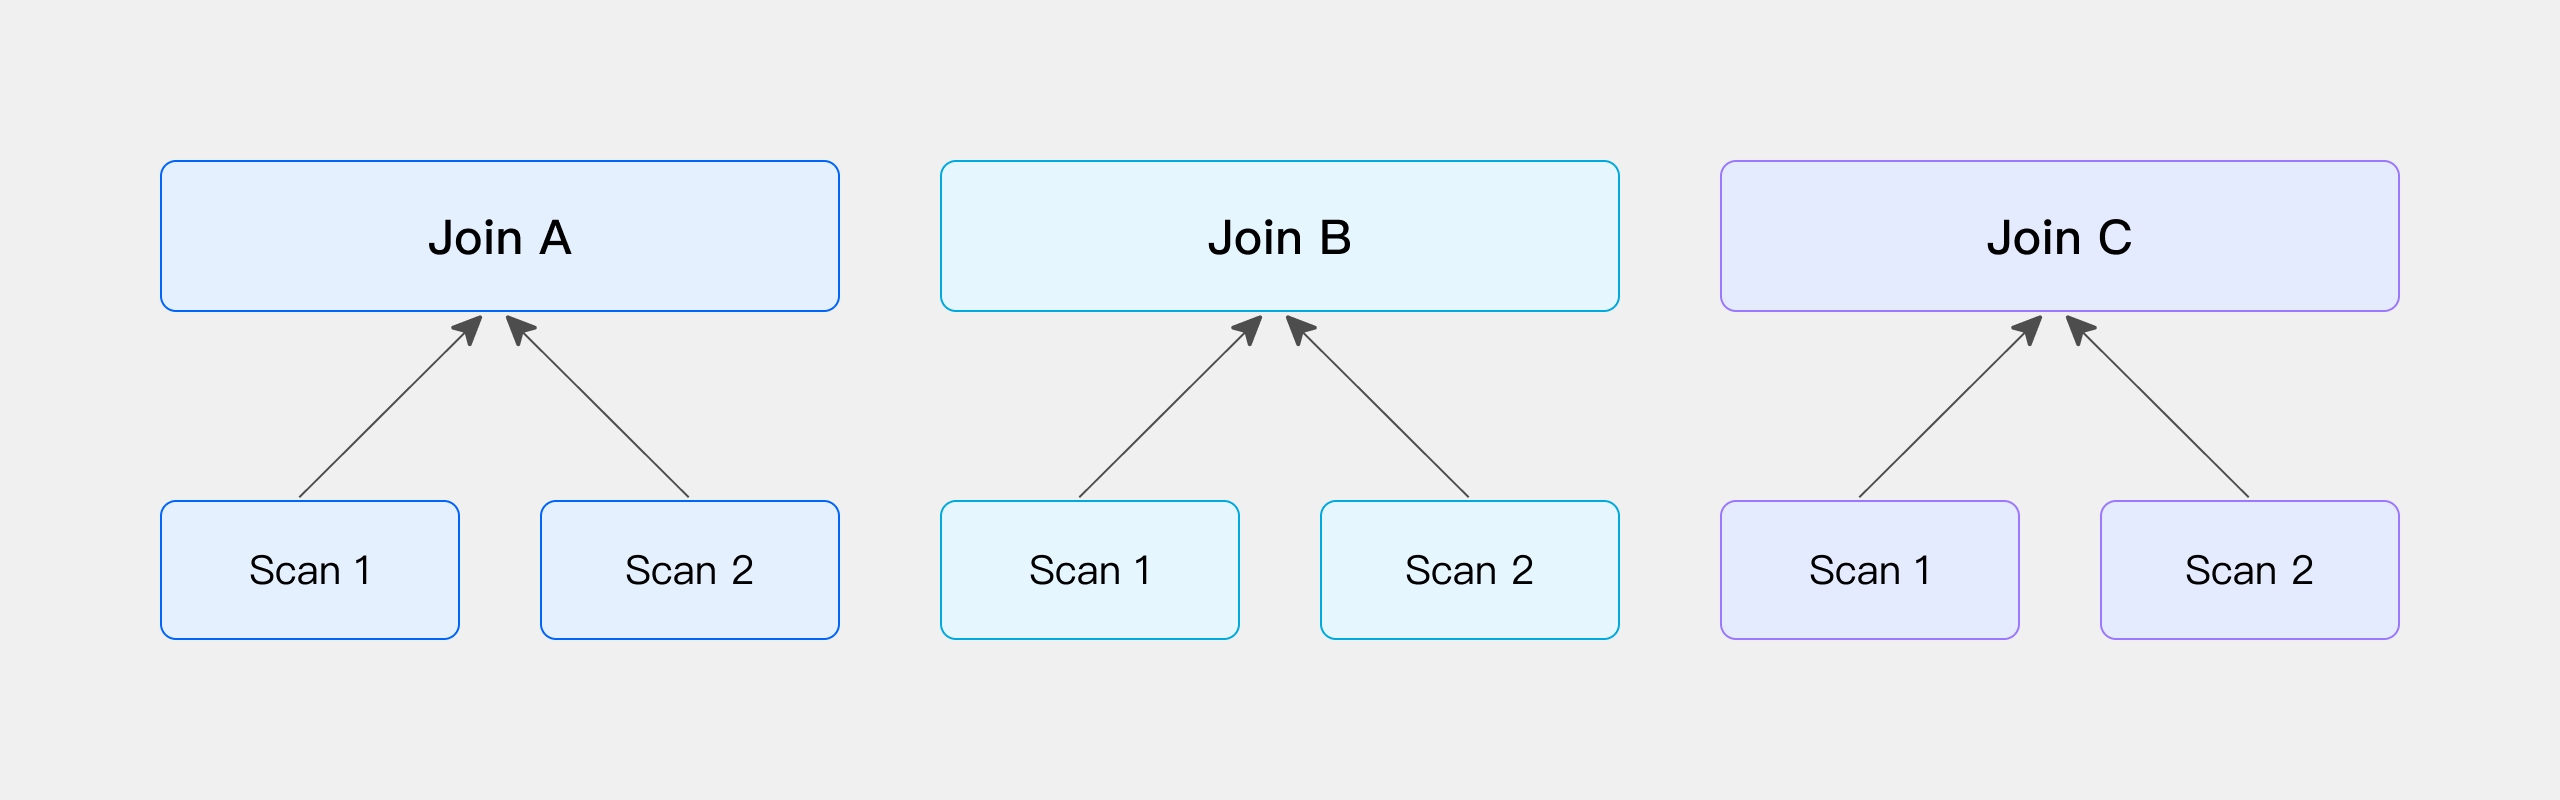
Как и в случае Bucket Shuffle Join, если обе таблицы, участвующие в JOIN, распределены по хешу столбца из условия JOIN, операцию Shuffle можно пропустить и вычислить JOIN непосредственно на локальном узле. Кратко рассмотрим это на примере физических таблиц:
Когда таблица Doris создаётся с DISTRIBUTED BY HASH, при загрузке система распределяет данные на основе ключа хеш-распределения. Если ключи хеш-распределения двух таблиц совпадают со столбцами из условия JOIN, данные этих таблиц можно считать заранее распределёнными в соответствии с требованиями JOIN, поэтому дополнительная операция Shuffle не требуется. Таким образом, при выполнении запросов JOIN можно вычислять непосредственно на этих двух таблицах.
Для сценариев, в которых JOIN выполняется сразу после сканирования данных, при создании таблиц необходимо соблюсти определённые условия. Подробнее см. в разделе Ограничения Colocate Join для двух физических таблиц ниже.
Сравнение четырёх методов Shuffle
В следующей таблице приведены сетевые затраты, поддерживаемые физические операторы и сценарии применения четырёх методов Shuffle:
| Метод Shuffle | Сетевые затраты | Физический оператор | Сценарий применения |
|---|---|---|---|
| Broadcast | N * T(R) | Hash Join / Nest Loop Join | Общий случай |
| Shuffle | T(S) + T(R) | Hash Join | Общий случай |
| Bucket Shuffle | T(R) | Hash Join | Условие JOIN включает столбец бакетирования левой таблицы, а левая таблица содержит единственную партицию. |
| Colocate | 0 | Hash Join | Условие JOIN включает столбец бакетирования левой таблицы, и обе таблицы принадлежат одной группе Colocate Group. |
- N: число экземпляров (Instances), участвующих в вычислении JOIN.
- T(relation): число кортежей в отношении.
Гибкость перечисленных выше четырёх методов Shuffle последовательно снижается, а требования к распределению данных становятся всё строже. В большинстве сценариев с повышением требований к распределению данных производительность JOIN обычно растёт. Обратите внимание: при небольшом числе бакетов в таблице Bucket Shuffle Join или Colocate Join могут иметь низкую степень параллелизма, что снижает производительность. В результате они могут работать даже медленнее, чем Shuffle Join. Причина в том, что операция Shuffle позволяет более равномерно распределить данные и обеспечить более высокую степень параллелизма при последующей обработке.
Практические примеры Bucket Shuffle Join и Colocate Join
Как отмечалось ранее, Bucket Shuffle Join и Colocate Join можно выполнить, если распределение данных с обеих сторон JOIN удовлетворяет определённым условиям (здесь «таблица» понимается в широком смысле: результат любого оператора в SQL-запросе можно рассматривать как «таблицу»).
Далее на примере двух таблиц t1 и t2 и связанных с ними SQL-запросов рассматриваются Bucket Shuffle Join и Colocate Join в этом более широком смысле. Сначала приведём инструкции CREATE TABLE для этих двух таблиц:
create table t1
(
    c1 bigint,
    c2 bigint
)
DISTRIBUTED BY HASH(c1) BUCKETS 3
PROPERTIES ("replication_num" = "1");

create table t2
(
    c1 bigint,
    c2 bigint
)
DISTRIBUTED BY HASH(c1) BUCKETS 3
PROPERTIES ("replication_num" = "1");
Пример Bucket Shuffle Join
В следующем примере обе таблицы t1 и t2 обрабатываются оператором GROUP BY, в результате чего получаются новые таблицы (на этом этапе tx распределена по хешу c1, а ty — по хешу c2). Условие последующего JOIN — tx.c1 = ty.c2, что в точности соответствует условиям для Bucket Shuffle Join.
explain select *
from
    (
        -- Table t1 is hash-distributed by c1, and after the group by operator, it remains hash-distributed by c1.
        select c1 as c1, sum(c2) as c2
        from t1
        group by c1
    ) tx
join
    (
        -- Table t2 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t2
        group by c2
    ) ty
on tx.c1 = ty.c2;
В приведённом ниже выводе Explain видно, что левым дочерним узлом узла Hash Join 7 является узел агрегации 6, а правым — узел Exchange 4. Это означает, что данные левого дочернего узла после агрегации остаются на месте, а данные правого дочернего узла распределяются по узлам левого с помощью Bucket Shuffle, что позволяет выполнить последующий Hash Join.
+------------------------------------------------------------+
| Explain String(Nereids Planner)                            |
+------------------------------------------------------------+
| PLAN FRAGMENT 0                                            |
|   OUTPUT EXPRS:                                            |
|     c1[#18]                                                |
|     c2[#19]                                                |
|     c2[#20]                                                |
|     c1[#21]                                                |
|   PARTITION: HASH_PARTITIONED: c1[#8]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   VRESULT SINK                                             |
|      MYSQL_PROTOCAL                                        |
|                                                            |
|   7:VHASH JOIN(364)                                        |
|   |  join op: INNER JOIN(BUCKET_SHUFFLE)[]                 |
|   |  equal join conjunct: (c1[#12] = c2[#6])               |
|   |  cardinality=10                                        |
|   |  vec output tuple id: 8                                |
|   |  output tuple id: 8                                    |
|   |  vIntermediate tuple ids: 7                            |
|   |  hash output slot ids: 6 7 12 13                       |
|   |  final projections: c1[#14], c2[#15], c2[#16], c1[#17] |
|   |  final project output tuple id: 8                      |
|   |  distribute expr lists: c1[#12]                        |
|   |  distribute expr lists: c2[#6]                         |
|   |                                                        |
|   |----4:VEXCHANGE                                         |
|   |       offset: 0                                        |
|   |       distribute expr lists: c2[#6]                    |
|   |                                                        |
|   6:VAGGREGATE (update finalize)(342)                      |
|   |  output: sum(c2[#9])[#11]                              |
|   |  group by: c1[#8]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  final projections: c1[#10], c2[#11]                   |
|   |  final project output tuple id: 6                      |
|   |  distribute expr lists: c1[#8]                         |
|   |                                                        |
|   5:VOlapScanNode(339)                                     |
|      TABLE: tt.t1(t1), PREAGGREGATION: ON                  |
|      partitions=1/1 (t1)                                   |
|      tablets=1/1, tabletList=491188                        |
|      cardinality=21, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
| PLAN FRAGMENT 1                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c2[#2]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 04                                        |
|     BUCKET_SHFFULE_HASH_PARTITIONED: c2[#6]                |
|                                                            |
|   3:VAGGREGATE (merge finalize)(355)                       |
|   |  output: sum(partial_sum(c1)[#3])[#5]                  |
|   |  group by: c2[#2]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  final projections: c2[#4], c1[#5]                     |
|   |  final project output tuple id: 3                      |
|   |  distribute expr lists: c2[#2]                         |
|   |                                                        |
|   2:VEXCHANGE                                              |
|      offset: 0                                             |
|      distribute expr lists:                                |
|                                                            |
| PLAN FRAGMENT 2                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#0]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 02                                        |
|     HASH_PARTITIONED: c2[#2]                               |
|                                                            |
|   1:VAGGREGATE (update serialize)(349)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#0])[#3]                       |
|   |  group by: c2[#1]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  distribute expr lists: c1[#0]                         |
|   |                                                        |
|   0:VOlapScanNode(346)                                     |
|      TABLE: tt.t2(t2), PREAGGREGATION: ON                  |
|      partitions=1/1 (t2)                                   |
|      tablets=1/1, tabletList=491198                        |
|      cardinality=10, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
|                                                            |
| Statistics                                                 |
|  planed with unknown column statistics                     |
+------------------------------------------------------------+
97 rows in set (0.01 sec)
Пример Colocate Join
В следующем примере обе таблицы t1 и t2 обрабатываются оператором GROUP BY, в результате чего получаются новые таблицы (на этом этапе и tx, и ty распределены по хешу c2). Условие последующего JOIN — tx.c2 = ty.c2, что в точности соответствует условиям для Colocate Join.
explain select *
from
    (
        -- Table t1 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t1
        group by c2
    ) tx
join
    (
        -- Table t2 is hash-distributed by c1, and after the group by operator, the data distribution becomes hash-distributed by c2.
        select c2 as c2, sum(c1) as c1
        from t2
        group by c2
    ) ty
on tx.c2 = ty.c2;
В приведённом ниже выводе Explain видно, что левым дочерним узлом узла Hash Join 8 является узел агрегации 7, а правым — узел агрегации 3, причём между ними нет узла Exchange. Это означает, что после агрегации данные обоих дочерних узлов остаются на месте, перемещение данных не требуется и последующий Hash Join можно выполнить локально.
+------------------------------------------------------------+
| Explain String(Nereids Planner)                            |
+------------------------------------------------------------+
| PLAN FRAGMENT 0                                            |
|   OUTPUT EXPRS:                                            |
|     c2[#20]                                                |
|     c1[#21]                                                |
|     c2[#22]                                                |
|     c1[#23]                                                |
|   PARTITION: HASH_PARTITIONED: c2[#10]                     |
|                                                            |
|   HAS_COLO_PLAN_NODE: true                                 |
|                                                            |
|   VRESULT SINK                                             |
|      MYSQL_PROTOCAL                                        |
|                                                            |
|   8:VHASH JOIN(373)                                        |
|   |  join op: INNER JOIN(PARTITIONED)[]                    |
|   |  equal join conjunct: (c2[#14] = c2[#6])               |
|   |  cardinality=10                                        |
|   |  vec output tuple id: 9                                |
|   |  output tuple id: 9                                    |
|   |  vIntermediate tuple ids: 8                            |
|   |  hash output slot ids: 6 7 14 15                       |
|   |  final projections: c2[#16], c1[#17], c2[#18], c1[#19] |
|   |  final project output tuple id: 9                      |
|   |  distribute expr lists: c2[#14]                        |
|   |  distribute expr lists: c2[#6]                         |
|   |                                                        |
|   |----3:VAGGREGATE (merge finalize)(367)                  |
|   |    |  output: sum(partial_sum(c1)[#3])[#5]             |
|   |    |  group by: c2[#2]                                 |
|   |    |  sortByGroupKey:false                             |
|   |    |  cardinality=5                                    |
|   |    |  final projections: c2[#4], c1[#5]                |
|   |    |  final project output tuple id: 3                 |
|   |    |  distribute expr lists: c2[#2]                    |
|   |    |                                                   |
|   |    2:VEXCHANGE                                         |
|   |       offset: 0                                        |
|   |       distribute expr lists:                           |
|   |                                                        |
|   7:VAGGREGATE (merge finalize)(354)                       |
|   |  output: sum(partial_sum(c1)[#11])[#13]                |
|   |  group by: c2[#10]                                     |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  final projections: c2[#12], c1[#13]                   |
|   |  final project output tuple id: 7                      |
|   |  distribute expr lists: c2[#10]                        |
|   |                                                        |
|   6:VEXCHANGE                                              |
|      offset: 0                                             |
|      distribute expr lists:                                |
|                                                            |
| PLAN FRAGMENT 1                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#8]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 06                                        |
|     HASH_PARTITIONED: c2[#10]                              |
|                                                            |
|   5:VAGGREGATE (update serialize)(348)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#8])[#11]                      |
|   |  group by: c2[#9]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=10                                        |
|   |  distribute expr lists: c1[#8]                         |
|   |                                                        |
|   4:VOlapScanNode(345)                                     |
|      TABLE: tt.t1(t1), PREAGGREGATION: ON                  |
|      partitions=1/1 (t1)                                   |
|      tablets=1/1, tabletList=491188                        |
|      cardinality=21, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
| PLAN FRAGMENT 2                                            |
|                                                            |
|   PARTITION: HASH_PARTITIONED: c1[#0]                      |
|                                                            |
|   HAS_COLO_PLAN_NODE: false                                |
|                                                            |
|   STREAM DATA SINK                                         |
|     EXCHANGE ID: 02                                        |
|     HASH_PARTITIONED: c2[#2]                               |
|                                                            |
|   1:VAGGREGATE (update serialize)(361)                     |
|   |  STREAMING                                             |
|   |  output: partial_sum(c1[#0])[#3]                       |
|   |  group by: c2[#1]                                      |
|   |  sortByGroupKey:false                                  |
|   |  cardinality=5                                         |
|   |  distribute expr lists: c1[#0]                         |
|   |                                                        |
|   0:VOlapScanNode(358)                                     |
|      TABLE: tt.t2(t2), PREAGGREGATION: ON                  |
|      partitions=1/1 (t2)                                   |
|      tablets=1/1, tabletList=491198                        |
|      cardinality=10, avgRowSize=0.0, numNodes=1            |
|      pushAggOp=NONE                                        |
|                                                            |
|                                                            |
| Statistics                                                 |
|  planed with unknown column statistics                     |
+------------------------------------------------------------+
105 rows in set (0.06 sec)
Часто задаваемые вопросы
Bucket Shuffle Join и Colocate Join имеют определённые ограничения на распределение данных и условия JOIN. В следующих разделах подробно описаны ограничения каждого из этих методов.
Ограничения Bucket Shuffle Join
При выполнении Bucket Shuffle Join непосредственно после сканирования двух физических таблиц должны соблюдаться следующие условия:
- Условие equi-JOIN: Bucket Shuffle Join применим только к сценариям с условиями equi-JOIN, поскольку для определения распределения данных используется вычисление хеша.
- Условие равенства, включающее столбец бакетирования: условие equi-JOIN должно включать столбцы бакетирования обеих таблиц. Если столбец бакетирования левой таблицы присутствует в условии equi-JOIN, вероятность выбора Bucket Shuffle Join при построении плана запроса выше.
- Ограничение по типу таблиц: Bucket Shuffle Join применим только к собственным OLAP-таблицам Doris. Если в качестве левой таблицы используются внешние таблицы, например ODBC, MySQL или ES, Bucket Shuffle Join не применяется.
- Требование единственной партиции: поскольку распределение данных может различаться между партициями, для партиционированных таблиц работа Bucket Shuffle Join гарантируется только тогда, когда левая таблица содержит единственную партицию. Поэтому при выполнении SQL по возможности используйте условия
WHERE, чтобы задействовать стратегию отсечения партиций.
Ограничения Colocate Join
При непосредственном сканировании двух физических таблиц Colocate Join имеет более строгие ограничения, чем Bucket Shuffle Join. Помимо всех условий Bucket Shuffle Join, необходимо также выполнить следующие требования:
- Одинаковые столбцы бакетирования: типы и количество столбцов бакетирования должны совпадать, чтобы обеспечить одинаковое распределение данных.
- Одна группа Colocation Group: необходимо явно указать Colocation Group; Colocate Join могут выполнять только таблицы из одной группы Colocation Group.
- Стабильное состояние группы: во время таких операций, как восстановление или балансировка реплик, Colocation Group может находиться в состоянии Unstable. В этом случае вместо Colocate Join выполняется обычная операция JOIN.