Аналитические функции (оконные функции)
Аналитические функции, также известные как оконные функции, — это функции SQL, которые выполняют сложные вычисления по строкам набора результатов. Отличительная особенность оконной функции заключается в том, что она не уменьшает количество строк, возвращаемых запросом. Вместо этого она добавляет новое вычисленное значение в каждую строку.
Оконные функции полезны во многих сценариях анализа данных: для расчёта накопительных итогов, ранжирования, вычисления скользящих средних и сравнения с аналогичным периодом прошлого года или предыдущим периодом. Подробное описание синтаксиса см. в разделе Обзор оконных функций.
Сценарии применения
Оконные функции в основном используются в следующих сценариях анализа данных:
| Сценарий | Типичная задача | Рекомендуемые функции |
|---|---|---|
| Ранжирование и группировка | «Ранжировать магазины в каждом регионе по объёму продаж». | RANK / DENSE_RANK / ROW_NUMBER / NTILE |
| Накопительная статистика | «Вычислить накопительный итог продаж по месяцам для каждой товарной категории». | SUM() OVER (... ROWS UNBOUNDED PRECEDING) |
| Скользящее среднее | «Вычислить скользящее среднее продаж магазина за три дня до и три дня после текущего дня». | AVG() OVER (... ROWS BETWEEN n PRECEDING AND n FOLLOWING) |
| Анализ отчётности | «Найти товарную категорию с наибольшим объёмом продаж за каждый год». | MAX() / SUM() OVER (PARTITION BY ...) |
| Сравнение строк | «Вычислить разницу продаж по сравнению с предыдущим годом для каждой категории». | LAG / LEAD |
Быстрый старт: пример расчёта скользящего среднего
Следующий сквозной пример показывает, как с помощью оконной функции вычислить скользящее среднее продаж каждого магазина в окне, охватывающем три дня до и три дня после текущего дня.
1. Создание таблицы и загрузка данных
CREATE TABLE daily_sales (
    store_id INT,
    sales_date DATE,
    sales_amount DECIMAL(10, 2)
) PROPERTIES ("replication_num" = "1");

INSERT INTO daily_sales (store_id, sales_date, sales_amount) VALUES
(1, '2023-01-01', 100.00), (1, '2023-01-02', 150.00), (1, '2023-01-03', 200.00),
(1, '2023-01-04', 250.00), (1, '2023-01-05', 300.00), (1, '2023-01-06', 350.00),
(1, '2023-01-07', 400.00), (1, '2023-01-08', 450.00), (1, '2023-01-09', 500.00),
(2, '2023-01-01', 110.00), (2, '2023-01-02', 160.00), (2, '2023-01-03', 210.00),
(2, '2023-01-04', 260.00), (2, '2023-01-05', 310.00), (2, '2023-01-06', 360.00),
(2, '2023-01-07', 410.00), (2, '2023-01-08', 460.00), (2, '2023-01-09', 510.00);
2. Написание запроса
SELECT
    store_id,
    sales_date,
    sales_amount,
    AVG(sales_amount) OVER (
        PARTITION BY store_id
        ORDER BY sales_date
        ROWS BETWEEN 3 PRECEDING AND 3 FOLLOWING
    ) AS moving_avg_sales
FROM daily_sales;
3. Результат запроса
+----------+------------+--------------+------------------+
| store_id | sales_date | sales_amount | moving_avg_sales |
+----------+------------+--------------+------------------+
|        1 | 2023-01-01 |       100.00 |         175.0000 |
|        1 | 2023-01-02 |       150.00 |         200.0000 |
|        1 | 2023-01-03 |       200.00 |         225.0000 |
|        1 | 2023-01-04 |       250.00 |         250.0000 |
|        1 | 2023-01-05 |       300.00 |         300.0000 |
|        1 | 2023-01-06 |       350.00 |         350.0000 |
|        1 | 2023-01-07 |       400.00 |         375.0000 |
|        1 | 2023-01-08 |       450.00 |         400.0000 |
|        1 | 2023-01-09 |       500.00 |         425.0000 |
|        2 | 2023-01-01 |       110.00 |         185.0000 |
|        2 | 2023-01-02 |       160.00 |         210.0000 |
|        2 | 2023-01-03 |       210.00 |         235.0000 |
|        2 | 2023-01-04 |       260.00 |         260.0000 |
|        2 | 2023-01-05 |       310.00 |         310.0000 |
|        2 | 2023-01-06 |       360.00 |         360.0000 |
|        2 | 2023-01-07 |       410.00 |         385.0000 |
|        2 | 2023-01-08 |       460.00 |         410.0000 |
|        2 | 2023-01-09 |       510.00 |         435.0000 |
+----------+------------+--------------+------------------+
18 rows in set (0.09 sec)
Основные понятия
Прежде чем использовать оконные функции, следует разобраться в нескольких основных понятиях: порядке выполнения, разделах, рамках окна и текущей строке.
Порядок обработки
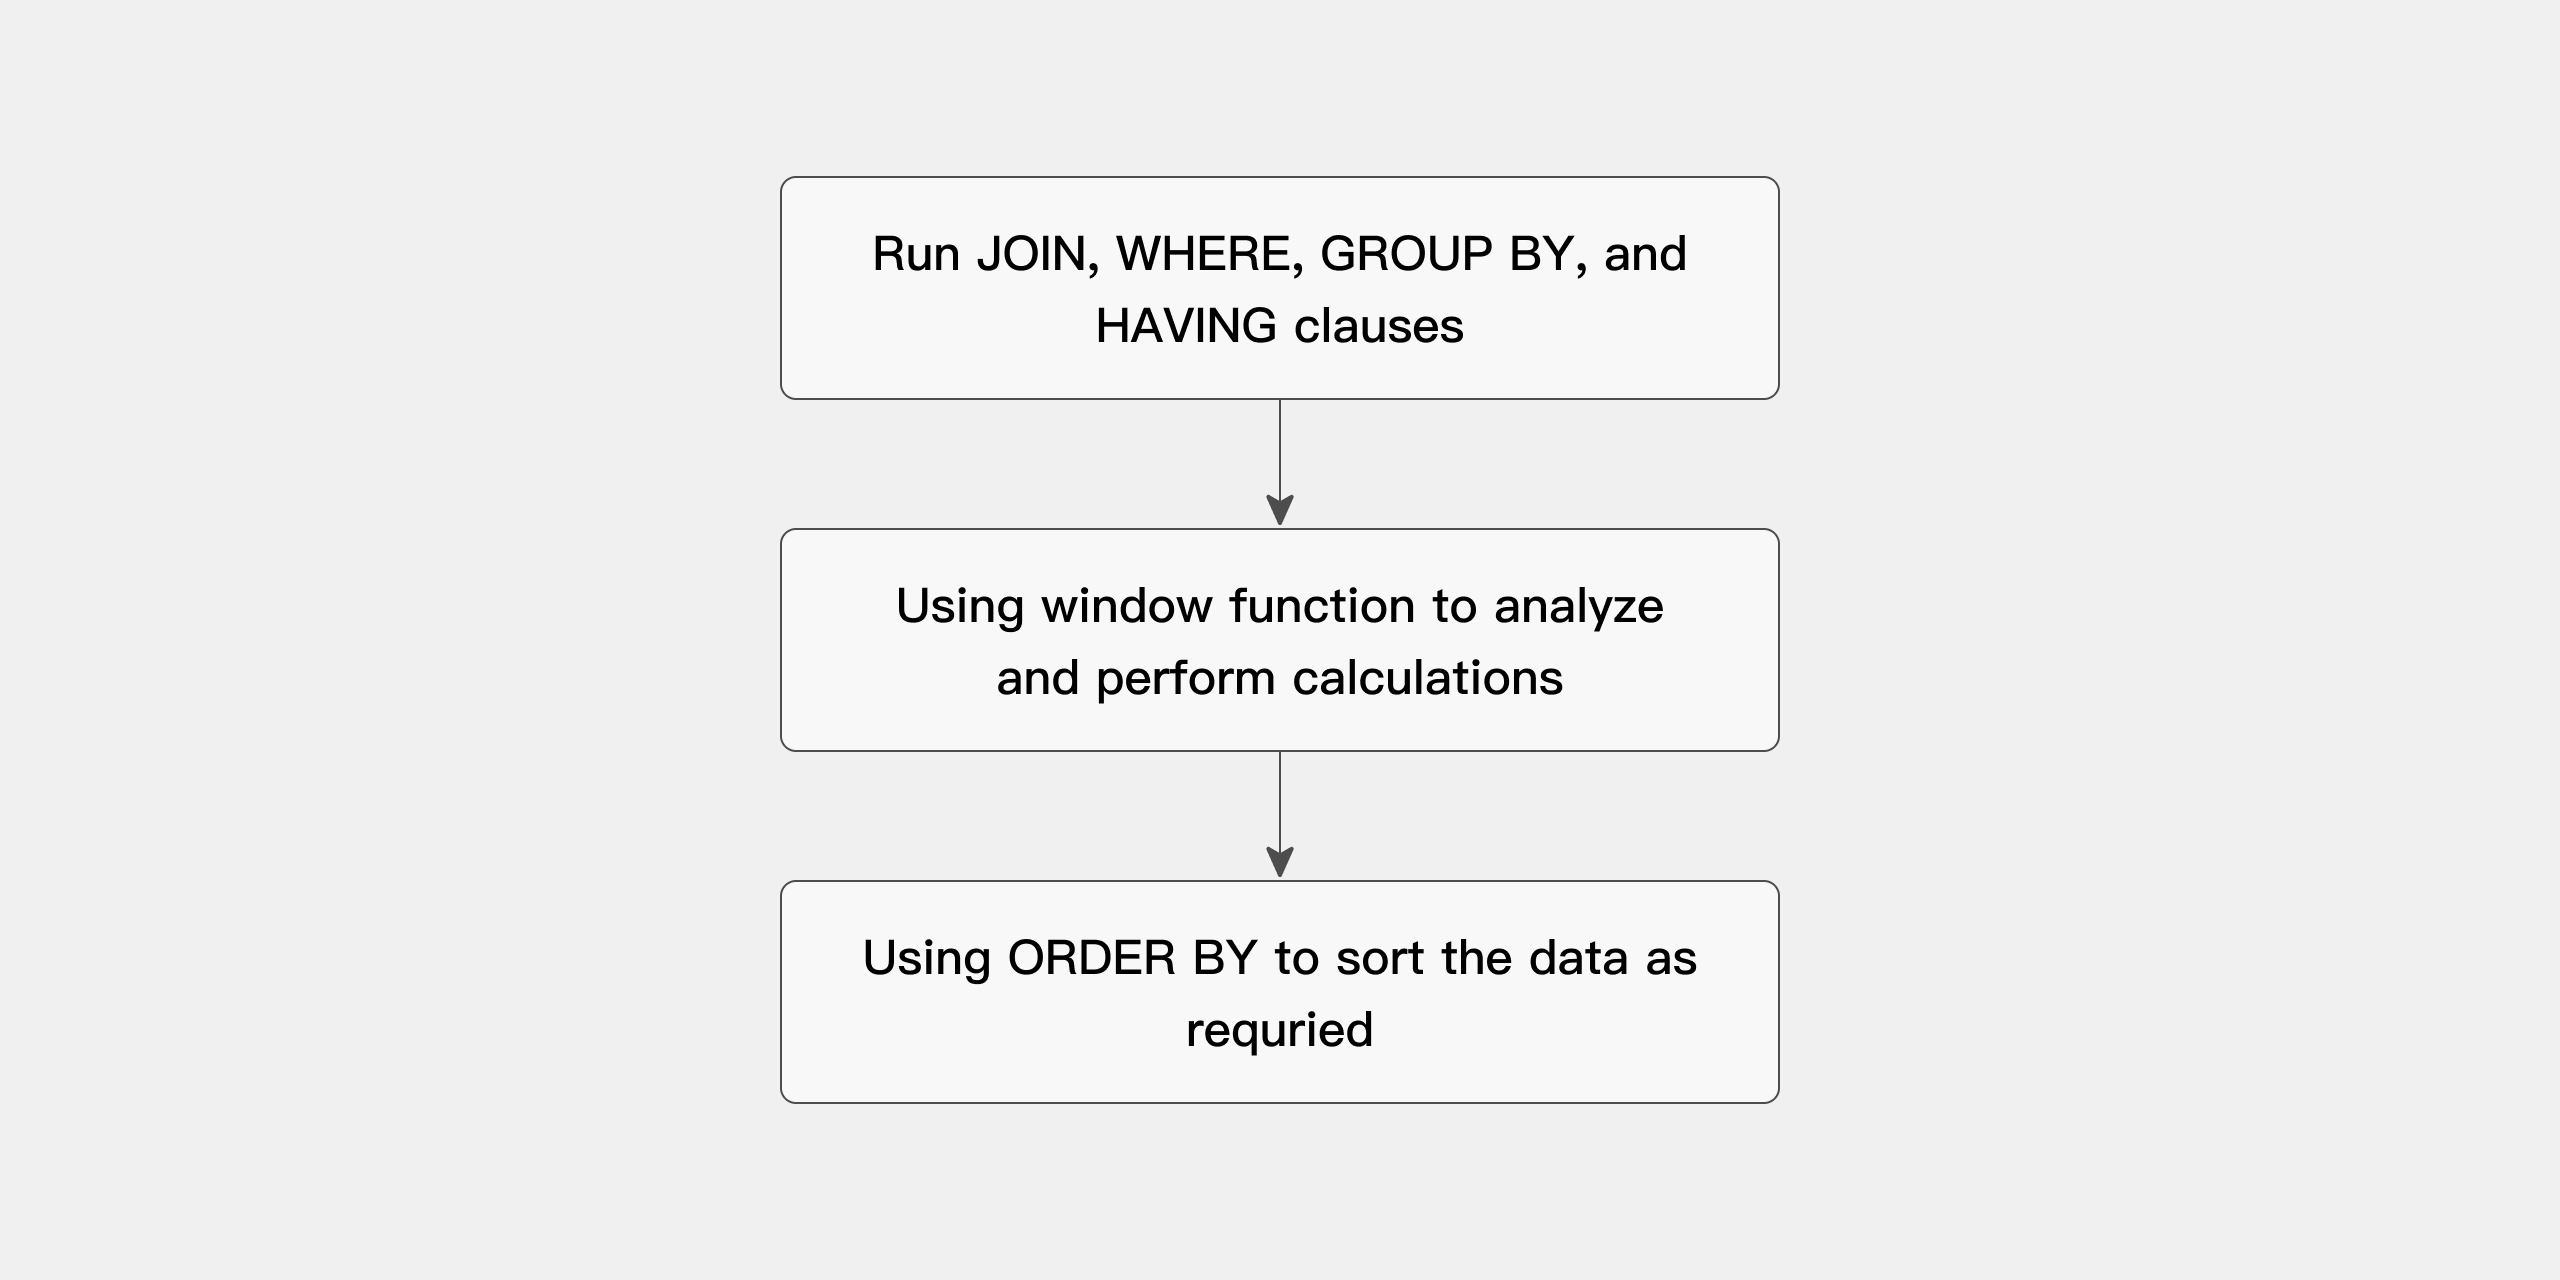
Запрос с аналитическими функциями обрабатывается в три этапа:
- Сначала обрабатываются все предложения
JOIN,WHERE,GROUP BYиHAVING. - Полученный набор передаётся аналитическим функциям, которые выполняют все оконные вычисления.
- Если запрос заканчивается предложением
ORDER BY, оно обрабатывается последним и определяет окончательный порядок вывода.
Порядок обработки показан на схеме ниже:
Разделение набора результатов
Раздел — это логическая группа, определяемая предложением PARTITION BY. Вычисления для строк каждого раздела выполняются независимо.
«Раздел» в аналитических функциях никак не связан с партиционированием таблиц. В этой главе термин «раздел» используется только в контексте аналитических функций.
Окно
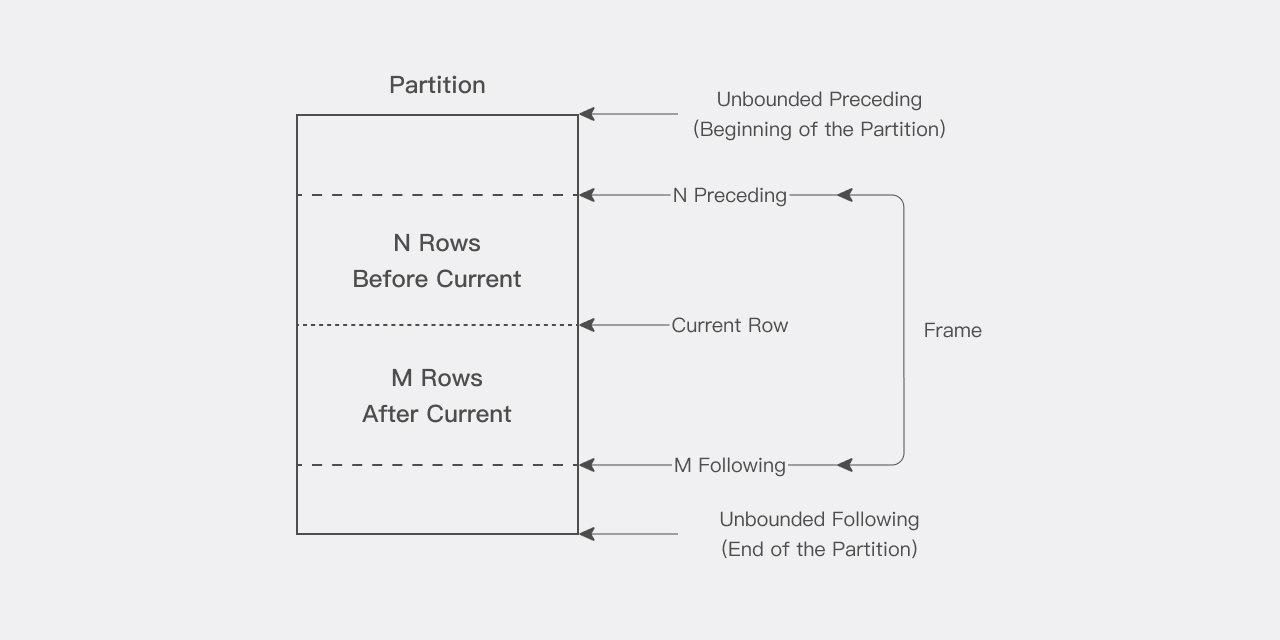
Для каждой строки раздела можно определить скользящее окно данных. Окно задаёт диапазон строк, используемых при вычислении значения для текущей строки. У окна есть начальная и конечная строки; в зависимости от определения окна одна или обе границы могут сдвигаться:
ROWS BETWEEN UNBOUNDED PRECEDING AND CURRENT ROW: используется для накопительных сумм. Начало окна фиксируется на первой строке раздела, а конец сдвигается от начальной строки до последней строки раздела.ROWS BETWEEN 3 PRECEDING AND 3 FOLLOWING: используется для скользящих средних. Начало и конец окна сдвигаются вместе с текущей строкой.
Окно может охватывать как весь раздел, так и единственную строку. Обратите внимание: вблизи границы раздела количество строк, участвующих в вычислении, может уменьшаться из-за этой границы, и функция возвращает результат только на основе доступных строк.
При использовании оконной функции текущая строка также участвует в вычислении. Поэтому для обработки n элементов следует указать (n-1). Например, для вычисления 5-дневного среднего задайте окно как ROWS BETWEEN 4 PRECEDING AND CURRENT ROW; эту запись также можно сократить до ROWS 4 PRECEDING.
Текущая строка
Каждое вычисление аналитической функции выполняется относительно текущей строки раздела. Текущая строка служит точкой отсчёта для определения начала и конца окна.
Например, ROWS BETWEEN 6 PRECEDING AND 6 FOLLOWING задаёт окно для центрированного скользящего среднего. Окно содержит текущую строку, 6 строк перед ней и 6 строк после неё, всего 13 строк.
Функции ранжирования
Функции ранжирования сортируют или группируют строки внутри раздела. Обратите внимание: результат запроса детерминирован только в том случае, если указанный столбец сортировки содержит уникальные значения. Если в столбце сортировки есть повторяющиеся значения, результат может меняться от выполнения к выполнению. О других функциях см. в разделе Обзор оконных функций.
Функция NTILE
NTILE делит набор результатов на указанное число бакетов (групп) и присваивает каждой строке номер бакета. Эта функция часто используется при анализе данных и подготовке отчётности для ранжирования с распределением по группам.
Синтаксис
NTILE(num_buckets) OVER ([PARTITION BY partition_expression] ORDER BY order_expression)
Описание параметров:
| Параметр | Описание |
|---|---|
num_buckets | Количество бакетов, по которым распределяются строки. |
PARTITION BY partition_expression | Необязательный параметр. Определяет способ разделения данных. |
ORDER BY order_expression | Обязательный параметр. Определяет способ сортировки данных. |
Пример: распределение учащихся по группам в зависимости от баллов
Предположим, есть таблица с результатами экзаменов учащихся под названием class_student_scores, и нужно разделить учащихся на 4 группы по баллам так, чтобы в каждой группе было примерно одинаковое количество учащихся.
Сначала создайте таблицу и вставьте данные:
CREATE TABLE class_student_scores (
    class_id INT,
    student_id INT,
    student_name VARCHAR(50),
    score INT
) DISTRIBUTED BY HASH(student_id) PROPERTIES('replication_num'='1');

INSERT INTO class_student_scores VALUES
(1, 1, 'Alice', 85),
(1, 2, 'Bob', 92),
(1, 3, 'Charlie', 87),
(2, 4, 'David', 78),
(2, 5, 'Eve', 95),
(2, 6, 'Frank', 80),
(2, 7, 'Grace', 90),
(2, 8, 'Hannah', 84);
Затем используйте функцию NTILE, чтобы распределить учащихся по бакетам в зависимости от баллов:
SELECT
    student_id,
    student_name,
    score,
    NTILE(4) OVER (ORDER BY score DESC) AS bucket
FROM class_student_scores;
Результат запроса:
+------------+--------------+-------+--------+
| student_id | student_name | score | bucket |
+------------+--------------+-------+--------+
|          5 | Eve          |    95 |      1 |
|          2 | Bob          |    92 |      1 |
|          7 | Grace        |    90 |      2 |
|          3 | Charlie      |    87 |      2 |
|          1 | Alice        |    85 |      3 |
|          8 | Hannah       |    84 |      3 |
|          6 | Frank        |    80 |      4 |
|          4 | David        |    78 |      4 |
+------------+--------------+-------+--------+
8 rows in set (0.12 sec)
В этом примере NTILE(4) распределяет учащихся по 4 бакетам в зависимости от баллов так, чтобы в каждом бакете было примерно одинаковое количество учащихся.
- Если строки нельзя распределить по бакетам равномерно, в некоторых бакетах может оказаться на одну строку больше.
NTILEработает независимо внутри каждого раздела. При использованииPARTITION BYданные каждого раздела распределяются по бакетам отдельно.
Совместное использование с PARTITION BY
Если нужно «сначала сгруппировать учащихся по классам, а затем внутри каждого класса разделить их на 3 группы по баллам», можно использовать NTILE вместе с PARTITION BY:
SELECT
    class_id,
    student_id,
    student_name,
    score,
    NTILE(3) OVER (PARTITION BY class_id ORDER BY score DESC) AS bucket
FROM class_student_scores;
Результат запроса:
+----------+------------+--------------+-------+--------+
| class_id | student_id | student_name | score | bucket |
+----------+------------+--------------+-------+--------+
|        1 |          2 | Bob          |    92 |      1 |
|        1 |          3 | Charlie      |    87 |      2 |
|        1 |          1 | Alice        |    85 |      3 |
|        2 |          5 | Eve          |    95 |      1 |
|        2 |          7 | Grace        |    90 |      1 |
|        2 |          8 | Hannah       |    84 |      2 |
|        2 |          6 | Frank        |    80 |      2 |
|        2 |          4 | David        |    78 |      3 |
+----------+------------+--------------+-------+--------+
8 rows in set (0.05 sec)
Как видно, учащиеся разделены по классам, а внутри каждого класса распределены по 3 бакетам в зависимости от баллов; в каждом бакете примерно одинаковое количество учащихся.
Агрегатные функции
Агрегатные функции, такие как SUM, AVG, MAX и MIN, можно использовать как оконные вместе с предложением OVER. Они вычисляют агрегированные значения внутри раздела для каждой строки, не требуя GROUP BY.
Вычисление накопительного итога с помощью SUM
Следующий запрос вычисляет продажи по месяцам для товарных категорий Books и Electronics за 2000 год, а также накопительный итог продаж по месяцам:
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    sum(sum(ss_net_paid)) OVER (
        PARTITION BY i_category
        ORDER BY year(d_date), month(d_date)
        ROWS UNBOUNDED PRECEDING
    ) AS cum_sales
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category IN ('Books', 'Electronics')
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
Результат запроса:
+-------------+--------------+---------------+-------------+-------------+
| i_category  | year(d_date) | month(d_date) | total_sales | cum_sales   |
+-------------+--------------+---------------+-------------+-------------+
| Books       |         2000 |             1 |  5348482.88 |  5348482.88 |
| Books       |         2000 |             2 |  4353162.03 |  9701644.91 |
| Books       |         2000 |             3 |  4466958.01 | 14168602.92 |
| Books       |         2000 |             4 |  4495802.19 | 18664405.11 |
| Books       |         2000 |             5 |  4589913.47 | 23254318.58 |
| Books       |         2000 |             6 |  4384384.00 | 27638702.58 |
| Books       |         2000 |             7 |  4488018.76 | 32126721.34 |
| Books       |         2000 |             8 |  9909227.94 | 42035949.28 |
| Books       |         2000 |             9 | 10366110.30 | 52402059.58 |
| Books       |         2000 |            10 | 10445320.76 | 62847380.34 |
| Books       |         2000 |            11 | 15246901.52 | 78094281.86 |
| Books       |         2000 |            12 | 15526630.11 | 93620911.97 |
| Electronics |         2000 |             1 |  5534568.17 |  5534568.17 |
| Electronics |         2000 |             2 |  4472655.10 | 10007223.27 |
| Electronics |         2000 |             3 |  4316942.60 | 14324165.87 |
| Electronics |         2000 |             4 |  4211523.06 | 18535688.93 |
| Electronics |         2000 |             5 |  4723661.00 | 23259349.93 |
| Electronics |         2000 |             6 |  4127773.06 | 27387122.99 |
| Electronics |         2000 |             7 |  4286523.05 | 31673646.04 |
| Electronics |         2000 |             8 | 10004890.96 | 41678537.00 |
| Electronics |         2000 |             9 | 10143665.77 | 51822202.77 |
| Electronics |         2000 |            10 | 10312020.35 | 62134223.12 |
| Electronics |         2000 |            11 | 14696000.54 | 76830223.66 |
| Electronics |         2000 |            12 | 15344441.52 | 92174665.18 |
+-------------+--------------+---------------+-------------+-------------+
24 rows in set (0.13 sec)
В этом примере агрегатная функция SUM задаёт окно для каждой строки: начало фиксируется на первой строке раздела (UNBOUNDED PRECEDING), а конец по умолчанию соответствует текущей строке. Обратите внимание на вложенность SUM: внешняя функция SUM агрегирует результат внутренней функции SUM. Вложенная агрегация очень распространена в аналитических агрегатных функциях.
Вычисление скользящего среднего с помощью AVG
Следующий запрос вычисляет «3-месячное скользящее среднее» (за текущий месяц и два предыдущих) продаж по месяцам для категории Books за 2000 год:
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    avg(sum(ss_net_paid)) OVER (
        ORDER BY year(d_date), month(d_date)
        ROWS 2 PRECEDING
    ) AS avg
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category = 'Books'
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
Результат запроса:
+------------+--------------+---------------+-------------+---------------+
| i_category | year(d_date) | month(d_date) | total_sales | avg           |
+------------+--------------+---------------+-------------+---------------+
| Books      |         2000 |             1 |  5348482.88 |  5348482.8800 |
| Books      |         2000 |             2 |  4353162.03 |  4850822.4550 |
| Books      |         2000 |             3 |  4466958.01 |  4722867.6400 |
| Books      |         2000 |             4 |  4495802.19 |  4438640.7433 |
| Books      |         2000 |             5 |  4589913.47 |  4517557.8900 |
| Books      |         2000 |             6 |  4384384.00 |  4490033.2200 |
| Books      |         2000 |             7 |  4488018.76 |  4487438.7433 |
| Books      |         2000 |             8 |  9909227.94 |  6260543.5666 |
| Books      |         2000 |             9 | 10366110.30 |  8254452.3333 |
| Books      |         2000 |            10 | 10445320.76 | 10240219.6666 |
| Books      |         2000 |            11 | 15246901.52 | 12019444.1933 |
| Books      |         2000 |            12 | 15526630.11 | 13739617.4633 |
+------------+--------------+---------------+-------------+---------------+
12 rows in set (0.13 sec)
В результате значения столбца avg для первых двух строк фактически не являются полноценным 3-месячным средним, поскольку предшествующих строк недостаточно (в SQL задано окно из 3 строк).
Также можно вычислить оконную агрегацию, «центрированную относительно текущей строки». В следующем примере вычисляется центрированное скользящее среднее продаж по месяцам для категории Books за 2000 год, то есть среднее продаж за «предыдущий месяц, текущий месяц и следующий месяц»:
SELECT
    i_category,
    year(d_date),
    month(d_date),
    sum(ss_net_paid) AS total_sales,
    avg(sum(ss_net_paid)) OVER (
        ORDER BY year(d_date), month(d_date)
        ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
    ) AS avg_sales
FROM
    store_sales,
    date_dim d1,
    item
WHERE
    d1.d_date_sk = ss_sold_date_sk
    AND i_item_sk = ss_item_sk
    AND year(d_date) = 2000
    AND i_category = 'Books'
GROUP BY
    i_category,
    year(d_date),
    month(d_date);
В результате центрированное скользящее среднее для первой и последней строк вычисляется только по данным за два месяца, поскольку с одной стороны границы не хватает строк.
Отчётные функции
Особенность отчётной функции заключается в том, что «окно для каждой строки охватывает весь раздел». Её главное преимущество — возможность обращаться к одним и тем же данным несколько раз в одном запросе, что позволяет избежать явных соединений JOIN и повысить производительность запроса.
Например, задачу «найти товарную категорию с наибольшим объёмом продаж за каждый год» можно решить с помощью отчётной функции без JOIN:
SELECT year, category, total_sum FROM (
    SELECT
        year(d_date) AS year,
        i_category AS category,
        sum(ss_net_paid) AS total_sum,
        max(sum(ss_net_paid)) OVER (PARTITION BY year(d_date)) AS max_sales
    FROM
        store_sales,
        date_dim d1,
        item
    WHERE
        d1.d_date_sk = ss_sold_date_sk
        AND i_item_sk = ss_item_sk
        AND year(d_date) IN (1998, 1999)
    GROUP BY
        year(d_date), i_category
) t
WHERE total_sum = max_sales;
Внутренний запрос определяет наибольший объём продаж категории за каждый год с помощью MAX(SUM(ss_net_paid)) и возвращает следующий результат:
+------+-------------+-------------+-------------+
| year | category    | total_sum   | max_sales   |
+------+-------------+-------------+-------------+
| 1998 | Electronics | 91723676.27 | 91723676.27 |
| 1998 | Books       | 91307909.84 | 91723676.27 |
| 1999 | Electronics | 90310850.54 | 90310850.54 |
| 1999 | Books       | 88993351.11 | 90310850.54 |
+------+-------------+-------------+-------------+
4 rows in set (0.11 sec)
После фильтрации во внешнем запросе по условию total_sum = max_sales получается категория с наибольшим объёмом продаж за каждый год:
+------+-------------+-------------+
| year | category    | total_sum   |
+------+-------------+-------------+
| 1998 | Electronics | 91723676.27 |
| 1999 | Electronics | 90310850.54 |
+------+-------------+-------------+
2 rows in set (0.12 sec)
Отчётные агрегации также можно сочетать с вложенными запросами для решения более сложных задач. Например: «найти подкатегории, продажи товаров которых составляют более 20% от общего объёма продаж соответствующей товарной категории, и выбрать 5 самых продаваемых товаров из этих подкатегорий»:
SELECT i_category AS categ, i_class AS sub_categ, i_item_id
FROM (
    SELECT
        i_item_id, i_class, i_category,
        sum(ss_net_paid) AS sales,
        sum(sum(ss_net_paid)) OVER (PARTITION BY i_category) AS cat_sales,
        sum(sum(ss_net_paid)) OVER (PARTITION BY i_class) AS sub_cat_sales,
        rank() OVER (PARTITION BY i_class ORDER BY sum(ss_net_paid) DESC) AS rank_in_line
    FROM
        store_sales,
        item
    WHERE
        i_item_sk = ss_item_sk
    GROUP BY i_class, i_category, i_item_id
) t
WHERE sub_cat_sales > 0.2 * cat_sales AND rank_in_line <= 5;
Функции LAG / LEAD
Функции LAG и LEAD предназначены для сценариев «сравнения строк». Обе функции позволяют обращаться к нескольким строкам таблицы без соединения таблицы с самой собой, что значительно повышает эффективность запроса:
LAG: обращается к строке с заданным смещением перед текущей строкой.LEAD: обращается к строке с заданным смещением после текущей строки.
Пример 1: вычисление разницы продаж по сравнению с предыдущим годом с помощью LAG
Следующий запрос выбирает общий объём продаж, общий объём продаж за предыдущий год и разницу между ними для каждой товарной категории за 1999, 2000, 2001 и 2002 годы:
SELECT year, category, total_sales, before_year_sales, total_sales - before_year_sales FROM (
    SELECT
        sum(ss_net_paid) AS total_sales,
        year(d_date) AS year,
        i_category AS category,
        lag(sum(ss_net_paid), 1, 0) OVER (
            PARTITION BY i_category
            ORDER BY YEAR(d_date)
        ) AS before_year_sales
    FROM
        store_sales,
        date_dim d1,
        item
    WHERE
        d1.d_date_sk = ss_sold_date_sk
        AND i_item_sk = ss_item_sk
    GROUP BY
        YEAR(d_date), i_category
) t
WHERE year IN (1999, 2000, 2001, 2002);
Результат запроса:
+------+-------------+-------------+-------------------+-----------------------------------+
| year | category    | total_sales | before_year_sales | (total_sales - before_year_sales) |
+------+-------------+-------------+-------------------+-----------------------------------+
| 1999 | Books       | 88993351.11 |       91307909.84 |                       -2314558.73 |
| 2000 | Books       | 93620911.97 |       88993351.11 |                        4627560.86 |
| 2001 | Books       | 90640097.99 |       93620911.97 |                       -2980813.98 |
| 2002 | Books       | 89585515.90 |       90640097.99 |                       -1054582.09 |
| 1999 | Electronics | 90310850.54 |       91723676.27 |                       -1412825.73 |
| 2000 | Electronics | 92174665.18 |       90310850.54 |                        1863814.64 |
| 2001 | Electronics | 92598527.85 |       92174665.18 |                         423862.67 |
| 2002 | Electronics | 94303831.84 |       92598527.85 |                        1705303.99 |
+------+-------------+-------------+-------------------+-----------------------------------+
8 rows in set (0.16 sec)
Пример 2: вычисление 3-дневной средней цены акций с помощью оконной функции
Предположим, имеются следующие данные об акциях, где биржевой символ — JDR, а closing_price — ежедневная цена закрытия:
CREATE TABLE stock_ticker (
    stock_symbol STRING,
    closing_price DECIMAL(8, 2),
    closing_date DATETIME
);

INSERT INTO stock_ticker VALUES
    ("JDR", 12.86, "2014-10-02 00:00:00"),
    ("JDR", 12.89, "2014-10-03 00:00:00"),
    ("JDR", 12.94, "2014-10-04 00:00:00"),
    ("JDR", 12.55, "2014-10-05 00:00:00"),
    ("JDR", 14.03, "2014-10-06 00:00:00"),
    ("JDR", 14.75, "2014-10-07 00:00:00"),
    ("JDR", 13.98, "2014-10-08 00:00:00");

SELECT * FROM stock_ticker ORDER BY stock_symbol, closing_date;
| stock_symbol | closing_price | closing_date        |
|--------------|---------------|---------------------|
| JDR          | 12.86         | 2014-10-02 00:00:00 |
| JDR          | 12.89         | 2014-10-03 00:00:00 |
| JDR          | 12.94         | 2014-10-04 00:00:00 |
| JDR          | 12.55         | 2014-10-05 00:00:00 |
| JDR          | 14.03         | 2014-10-06 00:00:00 |
| JDR          | 14.75         | 2014-10-07 00:00:00 |
| JDR          | 13.98         | 2014-10-08 00:00:00 |
Следующий запрос использует оконную функцию для формирования столбца moving_average, значение которого равно средней цене акций за предыдущий, текущий и следующий дни. У первого дня нет предыдущего, а у последнего — следующего, поэтому для этих двух строк среднее фактически вычисляется только за два дня. PARTITION BY здесь не даёт реального эффекта группировки (поскольку все данные относятся к JDR), но при наличии нескольких акций PARTITION BY гарантирует, что оконное вычисление выполняется только для одной и той же акции:
SELECT
    stock_symbol,
    closing_date,
    closing_price,
    avg(closing_price) OVER (
        PARTITION BY stock_symbol
        ORDER BY closing_date
        ROWS BETWEEN 1 PRECEDING AND 1 FOLLOWING
    ) AS moving_average
FROM stock_ticker;
| stock_symbol | closing_date        | closing_price | moving_average |
|--------------|---------------------|---------------|----------------|
| JDR          | 2014-10-02 00:00:00 | 12.86         | 12.87          |
| JDR          | 2014-10-03 00:00:00 | 12.89         | 12.89          |
| JDR          | 2014-10-04 00:00:00 | 12.94         | 12.79          |
| JDR          | 2014-10-05 00:00:00 | 12.55         | 13.17          |
| JDR          | 2014-10-06 00:00:00 | 14.03         | 13.77          |
| JDR          | 2014-10-07 00:00:00 | 14.75         | 14.25          |
| JDR          | 2014-10-08 00:00:00 | 13.98         | 14.36          |
Приложение: подготовка данных для примеров
Все примеры агрегатных функций, отчётных функций и LAG/LEAD в этом документе основаны на таблицах в стиле TPC-DS (item, store_sales, date_dim, customer_address). Чтобы воспроизвести их, подготовьте данные, выполнив следующие действия.
1. Создание таблиц для примеров
CREATE DATABASE IF NOT EXISTS doc_tpcds;
USE doc_tpcds;

CREATE TABLE IF NOT EXISTS item (
    i_item_sk bigint not null,
    i_item_id char(16) not null,
    i_rec_start_date date,
    i_rec_end_date date,
    i_item_desc varchar(200),
    i_current_price decimal(7,2),
    i_wholesale_cost decimal(7,2),
    i_brand_id integer,
    i_brand char(50),
    i_class_id integer,
    i_class char(50),
    i_category_id integer,
    i_category char(50),
    i_manufact_id integer,
    i_manufact char(50),
    i_size char(20),
    i_formulation char(20),
    i_color char(20),
    i_units char(10),
    i_container char(10),
    i_manager_id integer,
    i_product_name char(50)
)
DUPLICATE KEY(i_item_sk)
DISTRIBUTED BY HASH(i_item_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS store_sales (
    ss_item_sk bigint not null,
    ss_ticket_number bigint not null,
    ss_sold_date_sk bigint,
    ss_sold_time_sk bigint,
    ss_customer_sk bigint,
    ss_cdemo_sk bigint,
    ss_hdemo_sk bigint,
    ss_addr_sk bigint,
    ss_store_sk bigint,
    ss_promo_sk bigint,
    ss_quantity integer,
    ss_wholesale_cost decimal(7,2),
    ss_list_price decimal(7,2),
    ss_sales_price decimal(7,2),
    ss_ext_discount_amt decimal(7,2),
    ss_ext_sales_price decimal(7,2),
    ss_ext_wholesale_cost decimal(7,2),
    ss_ext_list_price decimal(7,2),
    ss_ext_tax decimal(7,2),
    ss_coupon_amt decimal(7,2),
    ss_net_paid decimal(7,2),
    ss_net_paid_inc_tax decimal(7,2),
    ss_net_profit decimal(7,2)
)
DUPLICATE KEY(ss_item_sk, ss_ticket_number)
DISTRIBUTED BY HASH(ss_item_sk, ss_ticket_number) BUCKETS 32
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS date_dim (
    d_date_sk bigint not null,
    d_date_id char(16) not null,
    d_date date,
    d_month_seq integer,
    d_week_seq integer,
    d_quarter_seq integer,
    d_year integer,
    d_dow integer,
    d_moy integer,
    d_dom integer,
    d_qoy integer,
    d_fy_year integer,
    d_fy_quarter_seq integer,
    d_fy_week_seq integer,
    d_day_name char(9),
    d_quarter_name char(6),
    d_holiday char(1),
    d_weekend char(1),
    d_following_holiday char(1),
    d_first_dom integer,
    d_last_dom integer,
    d_same_day_ly integer,
    d_same_day_lq integer,
    d_current_day char(1),
    d_current_week char(1),
    d_current_month char(1),
    d_current_quarter char(1),
    d_current_year char(1)
)
DUPLICATE KEY(d_date_sk)
DISTRIBUTED BY HASH(d_date_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);

CREATE TABLE IF NOT EXISTS customer_address (
    ca_address_sk bigint not null,
    ca_address_id char(16) not null,
    ca_street_number char(10),
    ca_street_name varchar(60),
    ca_street_type char(15),
    ca_suite_number char(10),
    ca_city varchar(60),
    ca_county varchar(30),
    ca_state char(2),
    ca_zip char(10),
    ca_country varchar(20),
    ca_gmt_offset decimal(5,2),
    ca_location_type char(20)
)
DUPLICATE KEY(ca_address_sk)
DISTRIBUTED BY HASH(ca_address_sk) BUCKETS 12
PROPERTIES (
    "replication_num" = "1"
);
2. Скачивание и загрузка данных через Stream Load
В терминале выполните следующие команды, чтобы скачать данные локально и загрузить их с помощью Stream Load:
curl -L https://cdn.selectdb.com/static/doc_ddl_dir_d27a752a7b.tar -o - | tar -Jxf -

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: i_item_sk, i_item_id, i_rec_start_date, i_rec_end_date, i_item_desc, i_current_price, i_wholesale_cost, i_brand_id, i_brand, i_class_id, i_class, i_category_id, i_category, i_manufact_id, i_manufact, i_size, i_formulation, i_color, i_units, i_container, i_manager_id, i_product_name" \
    -T "doc_ddl_dir/item_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/item/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: d_date_sk, d_date_id, d_date, d_month_seq, d_week_seq, d_quarter_seq, d_year, d_dow, d_moy, d_dom, d_qoy, d_fy_year, d_fy_quarter_seq, d_fy_week_seq, d_day_name, d_quarter_name, d_holiday, d_weekend, d_following_holiday, d_first_dom, d_last_dom, d_same_day_ly, d_same_day_lq, d_current_day, d_current_week, d_current_month, d_current_quarter, d_current_year" \
    -T "doc_ddl_dir/date_dim_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/date_dim/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: ss_sold_date_sk, ss_sold_time_sk, ss_item_sk, ss_customer_sk, ss_cdemo_sk, ss_hdemo_sk, ss_addr_sk, ss_store_sk, ss_promo_sk, ss_ticket_number, ss_quantity, ss_wholesale_cost, ss_list_price, ss_sales_price, ss_ext_discount_amt, ss_ext_sales_price, ss_ext_wholesale_cost, ss_ext_list_price, ss_ext_tax, ss_coupon_amt, ss_net_paid, ss_net_paid_inc_tax, ss_net_profit" \
    -T "doc_ddl_dir/store_sales.csv" \
    http://127.0.0.1:8030/api/doc_tpcds/store_sales/_stream_load

curl --location-trusted \
    -u "root:" \
    -H "column_separator:|" \
    -H "columns: ca_address_sk, ca_address_id, ca_street_number, ca_street_name, ca_street_type, ca_suite_number, ca_city, ca_county, ca_state, ca_zip, ca_country, ca_gmt_offset, ca_location_type" \
    -T "doc_ddl_dir/customer_address_1_10.dat" \
    http://127.0.0.1:8030/api/doc_tpcds/customer_address/_stream_load
Файлы данных item_1_10.dat, date_dim_1_10.dat, store_sales.csv и customer_address_1_10.dat также можно скачать из этого архива.