Агрегатная модель
Модель с ключом агрегации Doris предназначена для эффективного выполнения операций агрегации в запросах к большим объёмам данных. Благодаря предварительной агрегации при загрузке данных и фоновом слиянии она сокращает повторные вычисления и хранит только агрегированные результаты, экономя место в хранилище и ускоряя запросы.
Сценарии применения
Агрегатная модель подходит для следующих двух типов бизнес-сценариев:
- Обобщение детальных данных: многомерный сводный анализ, например месячных показателей продаж на платформах электронной коммерции, общей суммы транзакций клиентов при контроле финансовых рисков и количества кликов по рекламе.
- Запросы, не зависящие от исходных детальных данных: например, отчёты для управленческих панелей и анализ транзакционного поведения пользователей. Исходные детальные данные хранятся в озере данных, а в хранилище данных достаточно сохранять только обобщённые результаты.
Принцип работы
Каждая загрузка данных создаёт новую версию в агрегатной модели. Версии объединяются на этапе фонового слияния Compaction, а при выполнении запроса данные повторно агрегируются по первичному ключу. Весь процесс состоит из трёх этапов:
- Загрузка данных: данные загружаются пакетами. Каждый пакет создаёт версию, а строки с одинаковым ключом агрегации предварительно агрегируются, например путём суммирования или подсчёта.
- Фоновое слияние (Compaction): файлы нескольких версий периодически объединяются для сокращения избыточности и оптимизации хранения.
- Выполнение запроса: система выполняет окончательную агрегацию данных по ключу агрегации, чтобы обеспечить точность результатов запроса.
Синтаксис создания таблицы
Используйте ключевое слово AGGREGATE KEY, чтобы задать агрегатную модель, и объявите столбцы Key, по которым будут агрегироваться столбцы Value.
CREATE TABLE IF NOT EXISTS example_tbl_agg
(
    user_id             LARGEINT    NOT NULL,
    load_date           DATE        NOT NULL,
    city                VARCHAR(20),
    last_visit_dt       DATETIME    REPLACE DEFAULT "1970-01-01 00:00:00",
    cost                BIGINT      SUM     DEFAULT "0",
    max_dwell           INT         MAX     DEFAULT "0"
)
AGGREGATE KEY(user_id, load_date, city)
DISTRIBUTED BY HASH(user_id) BUCKETS 10;
В примере выше создаётся таблица со сведениями о пользователях и их посещениях. Столбцы user_id, load_date и city используются как столбцы Key для агрегации. При загрузке данных строки с одинаковыми значениями столбцов Key объединяются в одну строку, а значения столбцов Value агрегируются по каждому измерению в соответствии с объявленным типом агрегации.
Поддерживаемые методы агрегации
Столбцы Value в агрегатной таблице поддерживают следующие методы агрегации:
| Метод агрегации | Описание |
|---|---|
| SUM | Суммирует значения Value из нескольких строк. |
| REPLACE | Заменяет значение Value из предыдущих строк значением Value из следующего пакета. |
| MAX | Сохраняет максимальное значение. |
| MIN | Сохраняет минимальное значение. |
| REPLACE_IF_NOT_NULL | Заменяет значениями, отличными от NULL. В отличие от REPLACE, не выполняет замену значениями null. |
| HLL_UNION | Используется для столбцов типа HLL; выполняет агрегацию по алгоритму HyperLogLog. |
| BITMAP_UNION | Используется для столбцов типа BITMAP; выполняет агрегацию путём объединения битовых карт. |
Если перечисленные методы агрегации не отвечают вашим бизнес-требованиям, можно использовать тип AGG_STATE.
Пример записи и агрегации данных
Данные в агрегатной таблице агрегируются по столбцам Key; агрегация завершается по окончании записи.
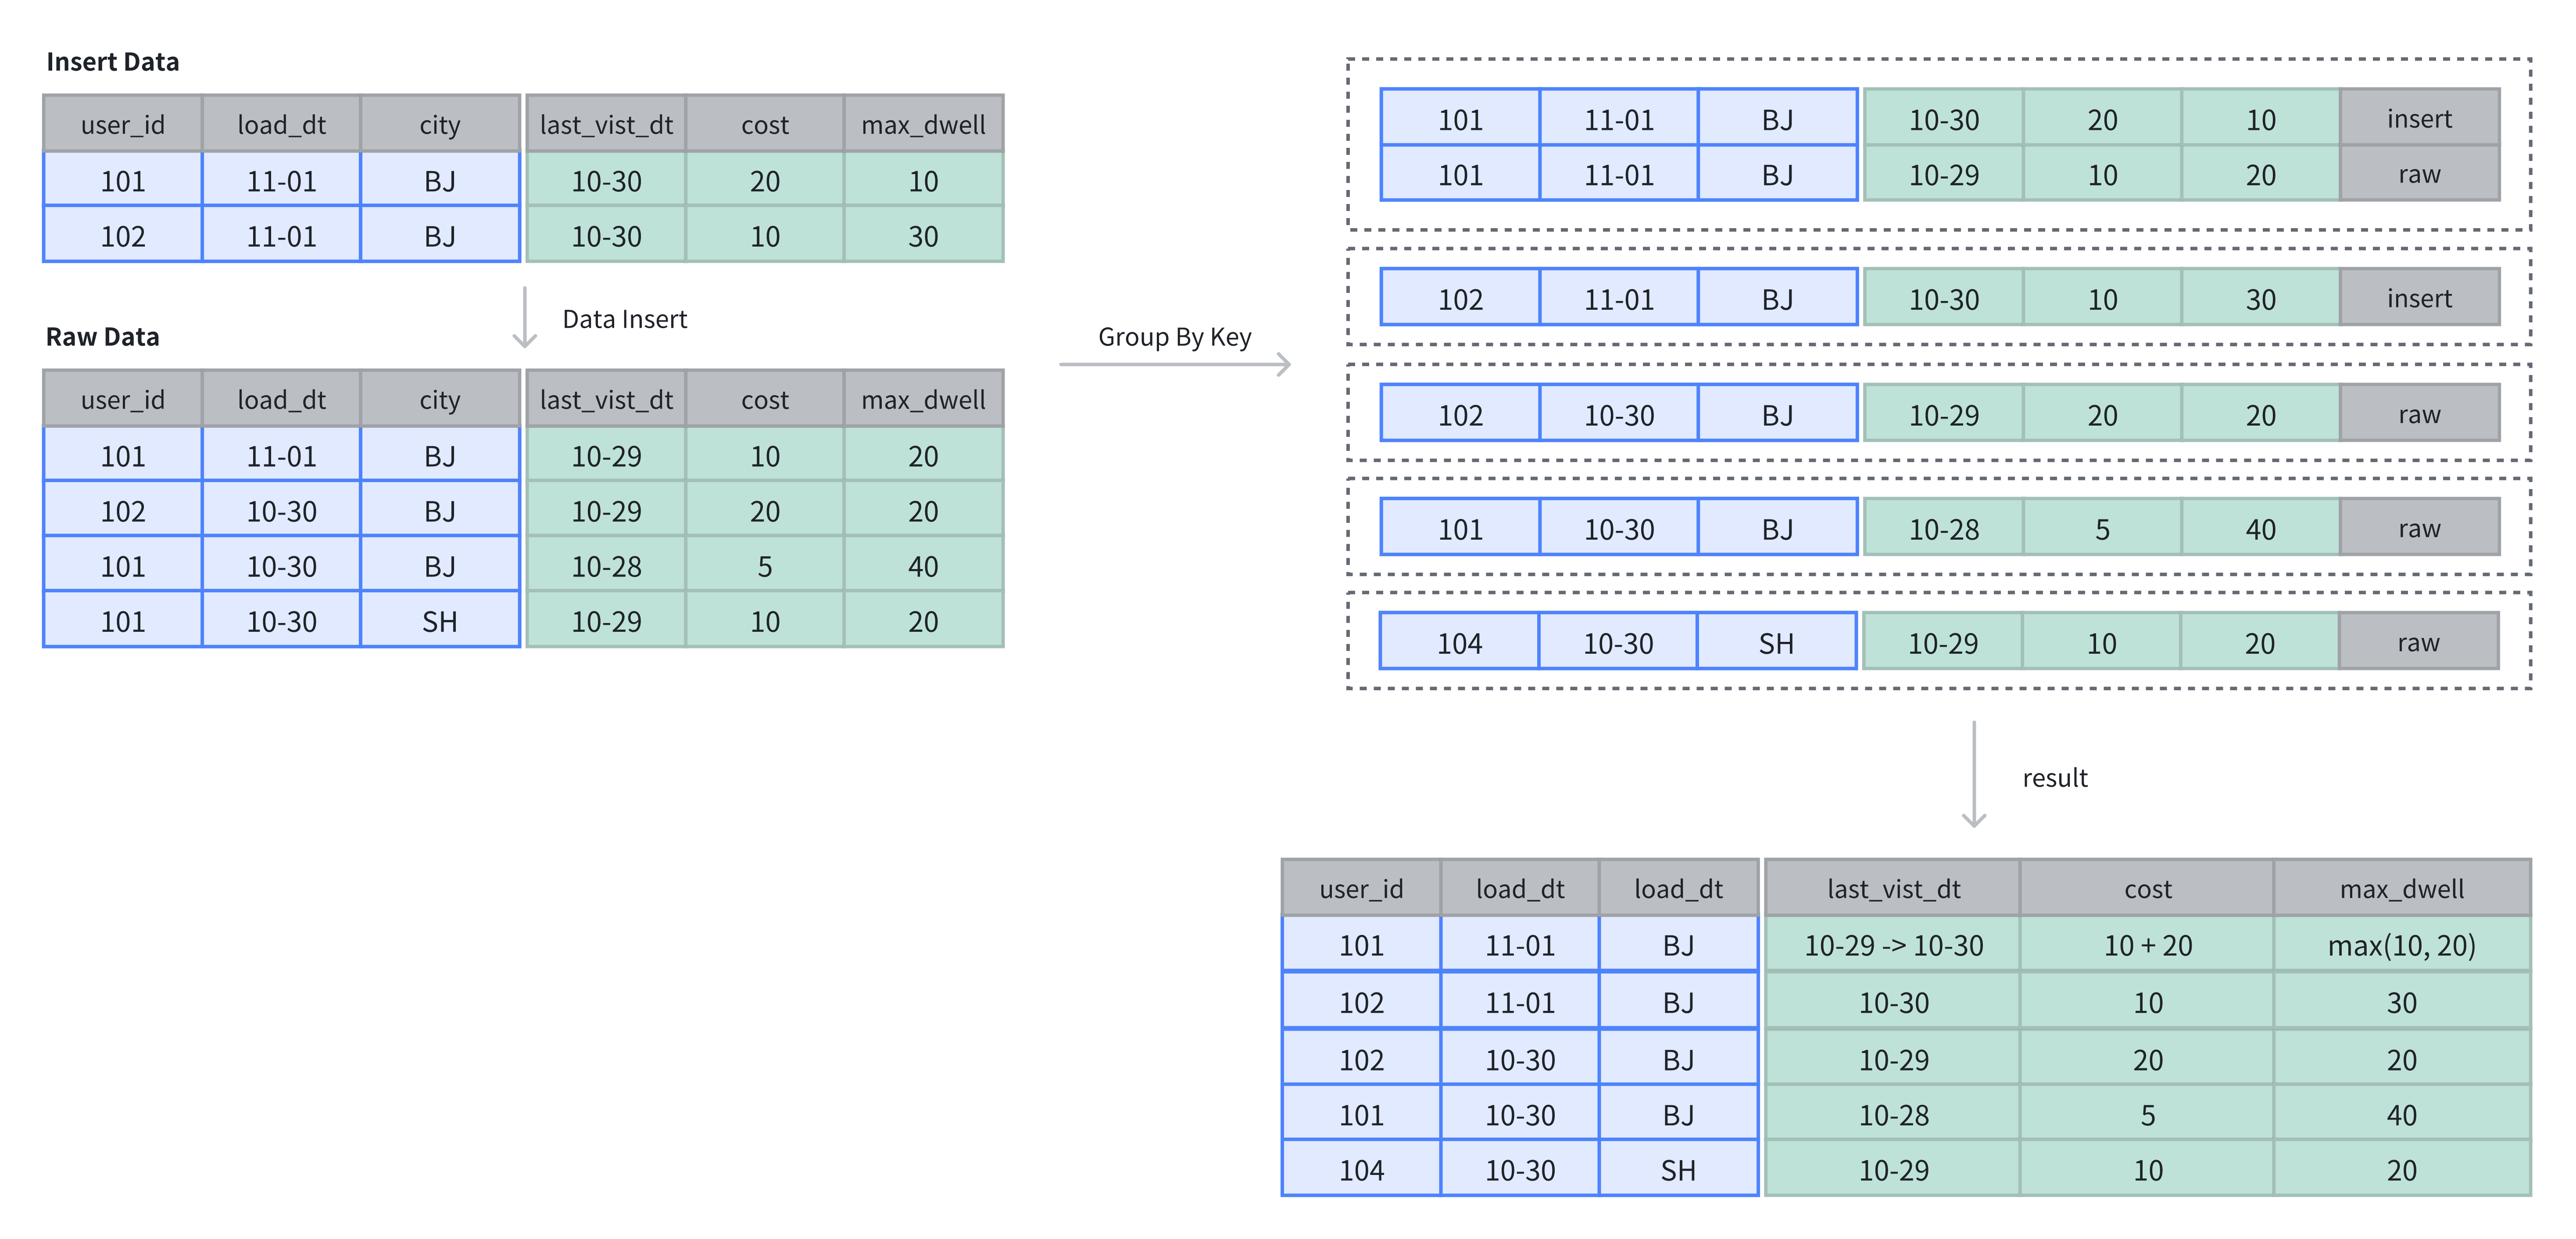
В следующем примере таблица изначально содержит 4 строки. После вставки ещё 2 строк значения столбцов Value агрегируются по столбцам Key.
-- 4 rows raw data
INSERT INTO example_tbl_agg VALUES
(101, '2024-11-01', 'BJ', '2024-10-29', 10, 20),
(102, '2024-10-30', 'BJ', '2024-10-29', 20, 20),
(101, '2024-10-30', 'BJ', '2024-10-28',  5, 40),
(101, '2024-10-30', 'SH', '2024-10-29', 10, 20);

-- insert into 2 rows
INSERT INTO example_tbl_agg VALUES
(101, '2024-11-01', 'BJ', '2024-10-30', 20, 10),
(102, '2024-11-01', 'BJ', '2024-10-30', 10, 30);

-- check the rows of table
SELECT * FROM example_tbl_agg;
+---------+------------+------+---------------------+------+----------------+
| user_id | load_date  | city | last_visit_dt       | cost | max_dwell       |
+---------+------------+------+---------------------+------+----------------+
| 102     | 2024-10-30 | BJ   | 2024-10-29 00:00:00 |   20 |             20 |
| 102     | 2024-11-01 | BJ   | 2024-10-30 00:00:00 |   10 |             30 |
| 101     | 2024-10-30 | BJ   | 2024-10-28 00:00:00 |    5 |             40 |
| 101     | 2024-10-30 | SH   | 2024-10-29 00:00:00 |   10 |             20 |
| 101     | 2024-11-01 | BJ   | 2024-10-30 00:00:00 |   30 |             20 |
+---------+------------+------+---------------------+------+----------------+
AGG_STATE
AGG_STATE — экспериментальная функция. Её рекомендуется использовать в средах разработки и тестирования.
AGG_STATE подходит для сценариев, в которых встроенные методы агрегации не отвечают вашим требованиям. При его использовании учитывайте следующие ограничения:
- Его нельзя использовать в качестве столбца Key.
- Сигнатуру агрегатной функции необходимо объявить при создании таблицы.
- Указывать длину или значение по умолчанию не требуется; фактический размер хранимых данных зависит от реализации функции.
Пример создания таблицы
set enable_agg_state = true;

CREATE TABLE aggstate
(
    k1   INT  NULL,
    v1   INT  SUM,
    v2   agg_state<group_concat(string)> generic
)
AGGREGATE KEY(k1)
DISTRIBUTED BY HASH(k1) BUCKETS 3;
В примере выше agg_state используется для объявления типа данных, а sum / group_concat — это сигнатуры агрегатных функций. agg_state — тип данных, подобный int, array или string, который можно использовать только вместе с тремя комбинаторами функций: state, merge и union. Он представляет промежуточный результат агрегатной функции (например, промежуточное состояние group_concat), а не итоговый результат.
Запись: использование state для получения промежуточных результатов
Данные типа agg_state необходимо создавать с помощью функции state. Для этой таблицы используйте group_concat_state:
INSERT INTO aggstate VALUES (1, 1, group_concat_state('a'));
INSERT INTO aggstate VALUES (1, 2, group_concat_state('b'));
INSERT INTO aggstate VALUES (1, 3, group_concat_state('c'));
INSERT INTO aggstate VALUES (2, 4, group_concat_state('d'));
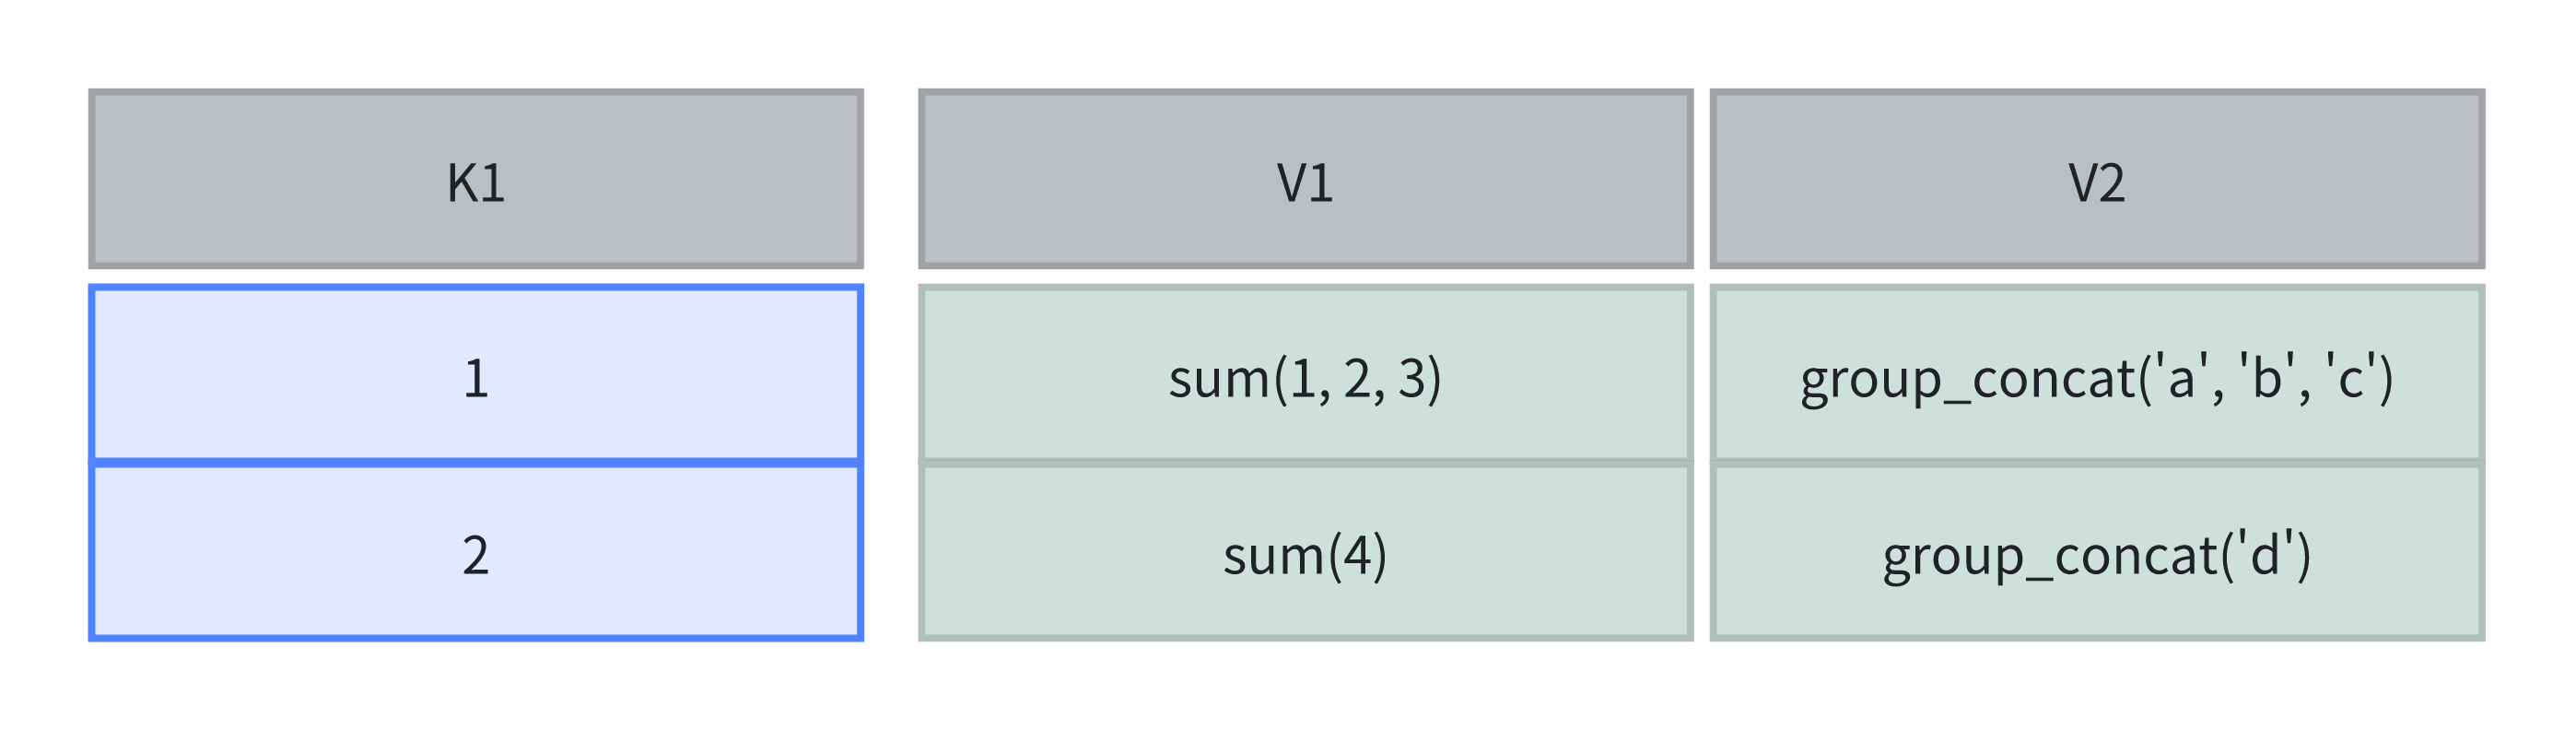
Вычисления в таблице на этом этапе показаны на следующем рисунке:
Запрос: использование merge для получения итогового результата
При выполнении запроса можно использовать операцию merge, чтобы объединить несколько состояний и получить итоговый агрегированный результат. Поскольку group_concat зависит от порядка, результат нестабилен:
SELECT group_concat_merge(v2) FROM aggstate;
+------------------------+
| group_concat_merge(v2) |
+------------------------+
| d,c,b,a                |
+------------------------+
Сохранение промежуточных результатов: использование операции union
Если требуется сохранить промежуточный результат вместо получения итогового агрегированного результата, используйте операцию union:
INSERT INTO aggstate
SELECT 3, sum(v1), group_concat_union(v2) FROM aggstate;
Вычисления в таблице на этом этапе показаны на следующем рисунке:
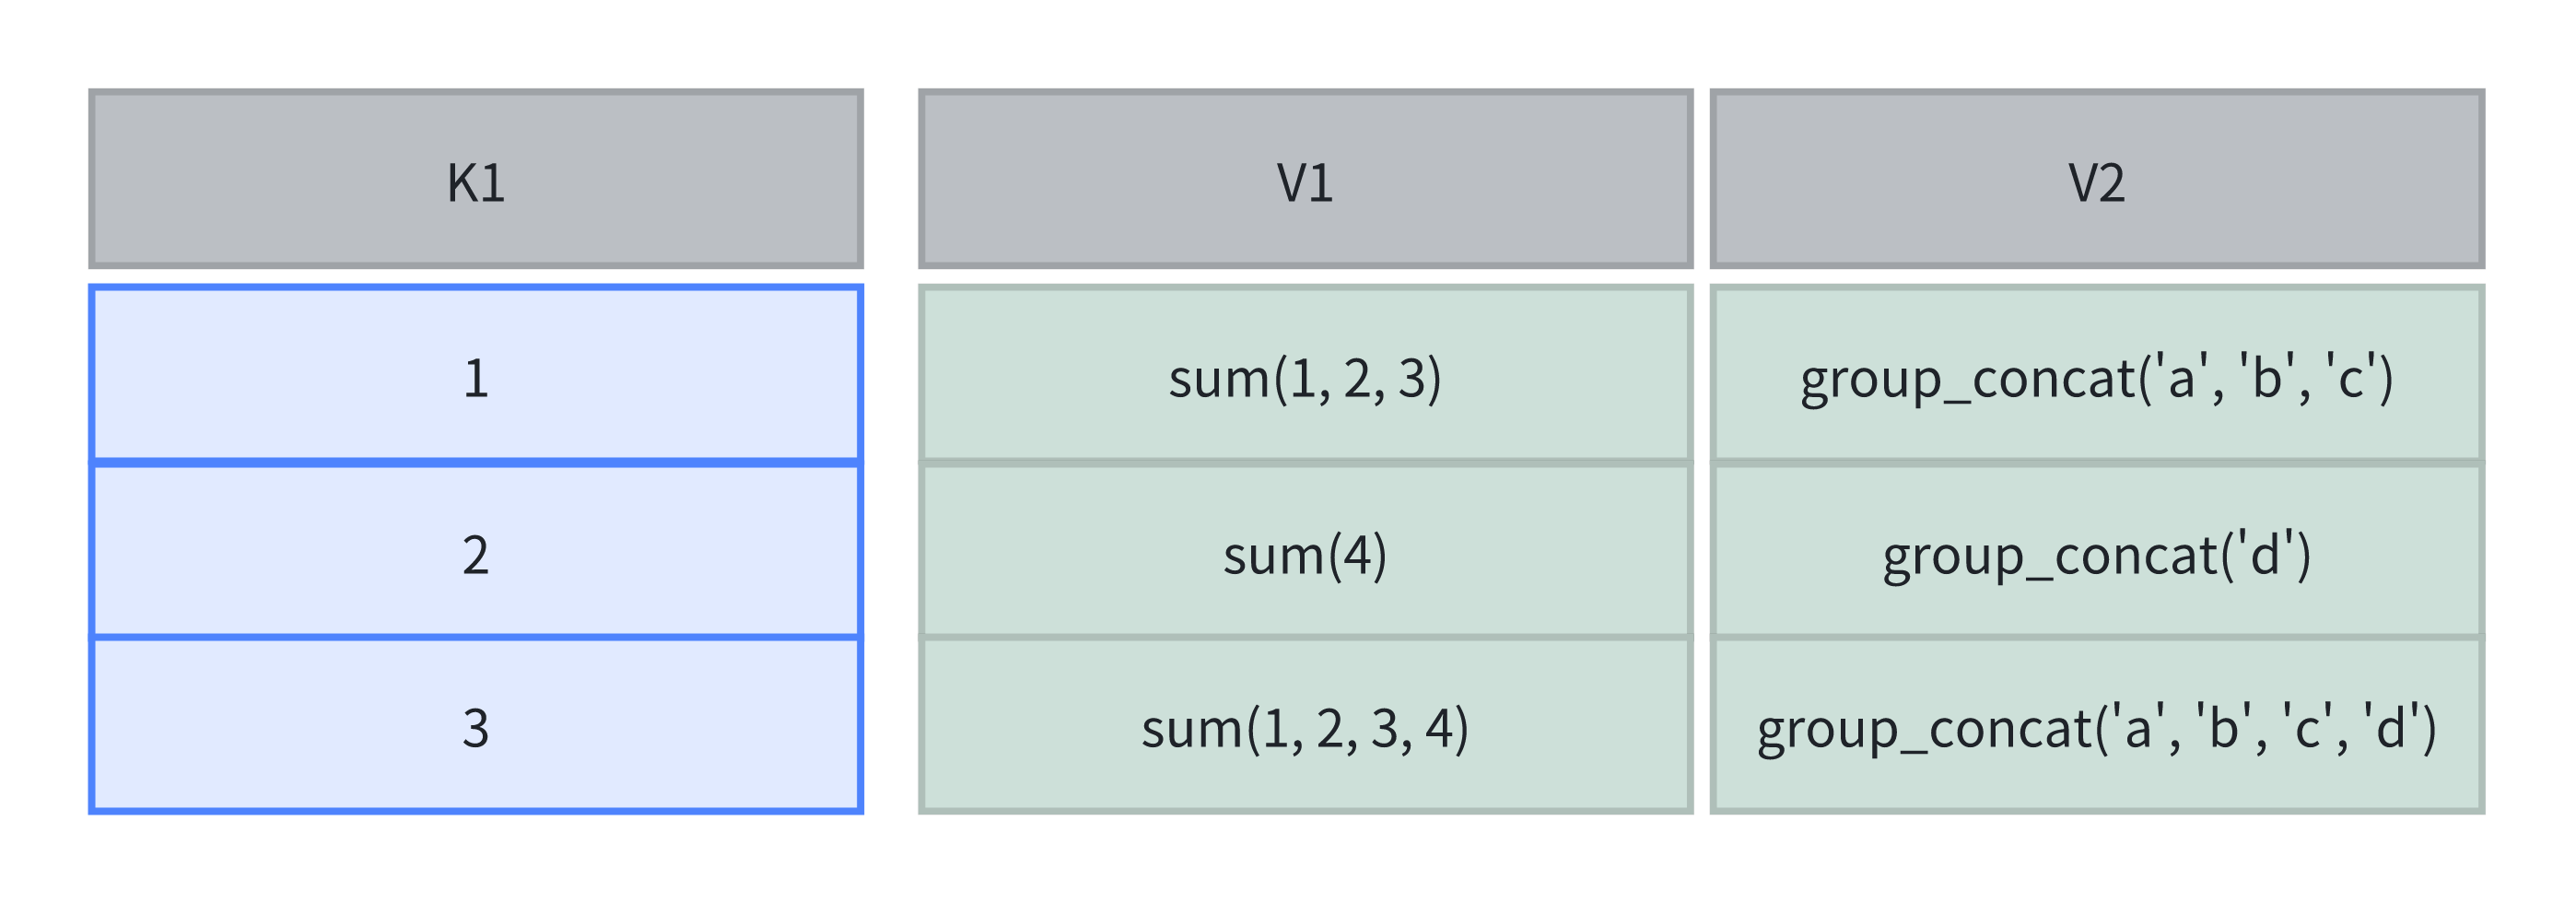
Поскольку group_concat зависит от порядка, результат нестабилен. Результаты запросов приведены ниже:
mysql> SELECT sum(v1), group_concat_merge(v2) FROM aggstate;
+---------+------------------------+
| sum(v1) | group_concat_merge(v2) |
+---------+------------------------+
|      20 | c,b,a,d,c,b,a,d        |
+---------+------------------------+

mysql> SELECT sum(v1), group_concat_merge(v2) FROM aggstate WHERE k1 != 2;
+---------+------------------------+
| sum(v1) | group_concat_merge(v2) |
+---------+------------------------+
|      16 | c,b,a,d,c,b,a          |
+---------+------------------------+