Индекс BloomFilter
Индекс BloomFilter представляет собой индекс пропуска данных, основанный на алгоритме BloomFilter. Он быстро определяет, может ли искомое значение присутствовать в блоке данных, и пропускает блоки, которые не удовлетворяют условию равенства. Это снижает затраты на ввод-вывод и ускоряет запросы.
Принципы работы алгоритма BloomFilter
BloomFilter представляет собой алгоритм быстрого поиска, основанный на отображении с помощью нескольких хеш-функций и предложенный Блумом в 1970 году. Его основные характеристики:
- Высокая эффективность использования памяти: множество можно представить с помощью длинного двоичного битового массива и набора хеш-функций.
- Результаты запроса: при проверке наличия элемента в множестве BloomFilter возвращает только один из двух результатов:
- Возможно, присутствует (из-за возможной коллизии хешей результат может быть ложноположительным)
- Точно отсутствует (результат достоверен)
Алгоритм работает следующим образом:
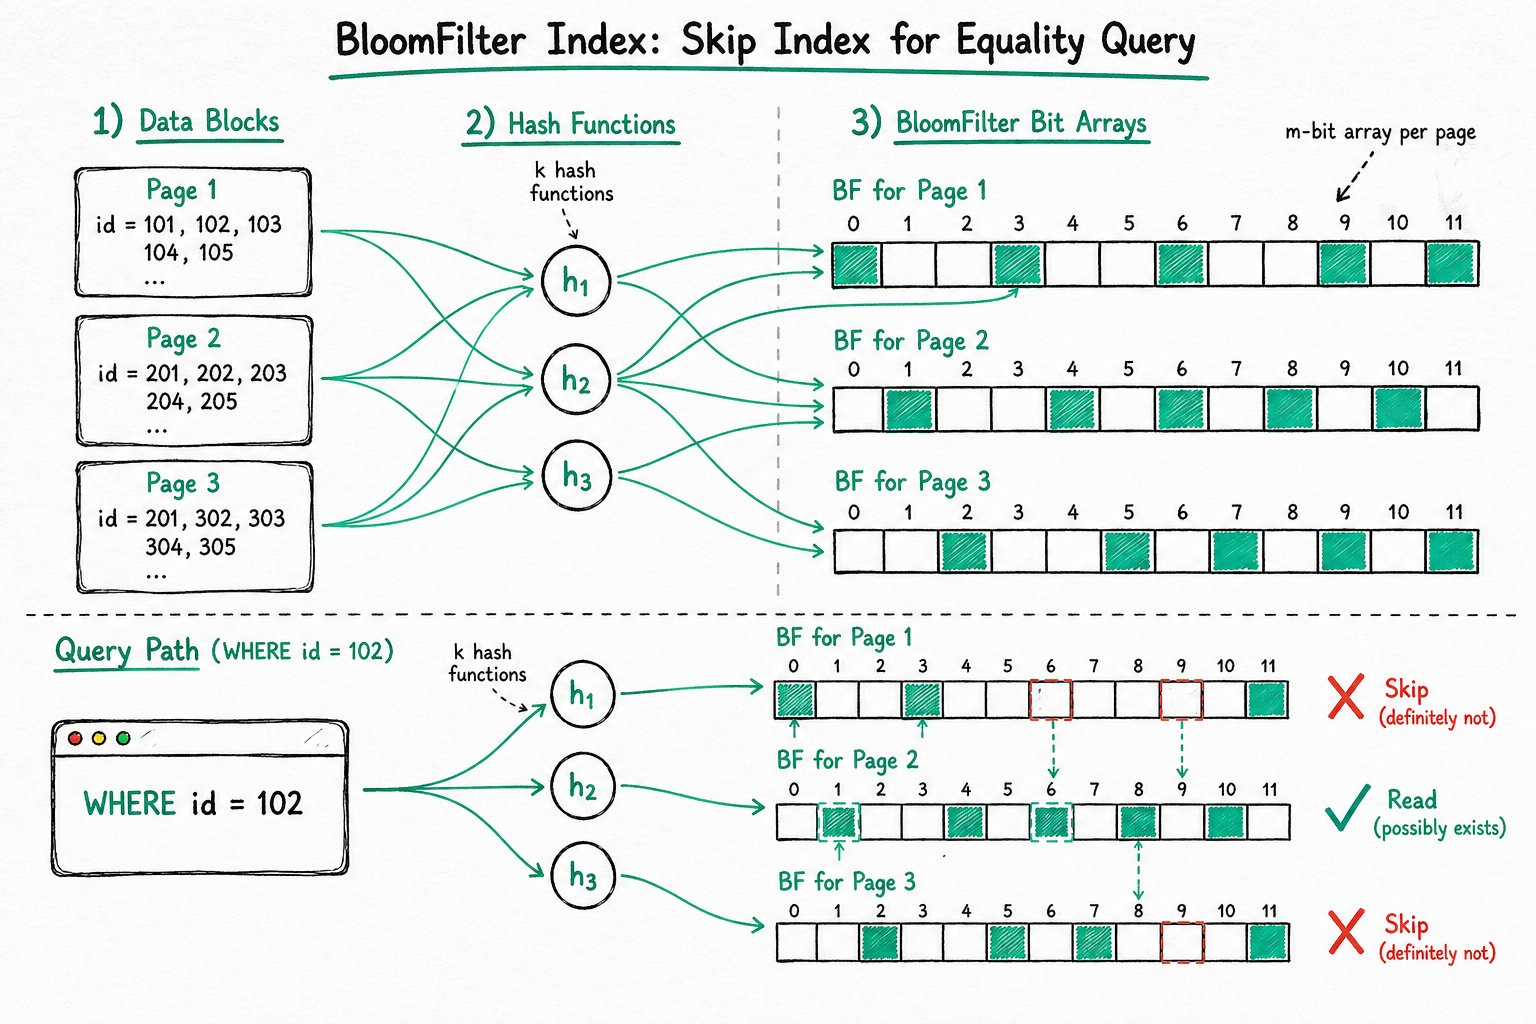
- Все биты двоичного массива инициализируются нулями.
- При вставке элемента с помощью набора хеш-функций вычисляется несколько смещений, а соответствующие позиции в битовом массиве устанавливаются в 1.
- При поиске элемента смещения вычисляются тем же способом. Если хотя бы одна из соответствующих позиций равна 0, элемент точно отсутствует. Если все позиции равны 1, элемент, возможно, присутствует.
На следующем рисунке показан пример BloomFilter с m=18 и k=3 (m обозначает размер битового массива, а k обозначает количество хеш-функций). Три элемента множества, x, y и z, отображаются в битовый массив с помощью 3 различных хеш-функций. При поиске элемента w хотя бы один из соответствующих ему битов равен 0, поэтому w точно отсутствует в множестве.
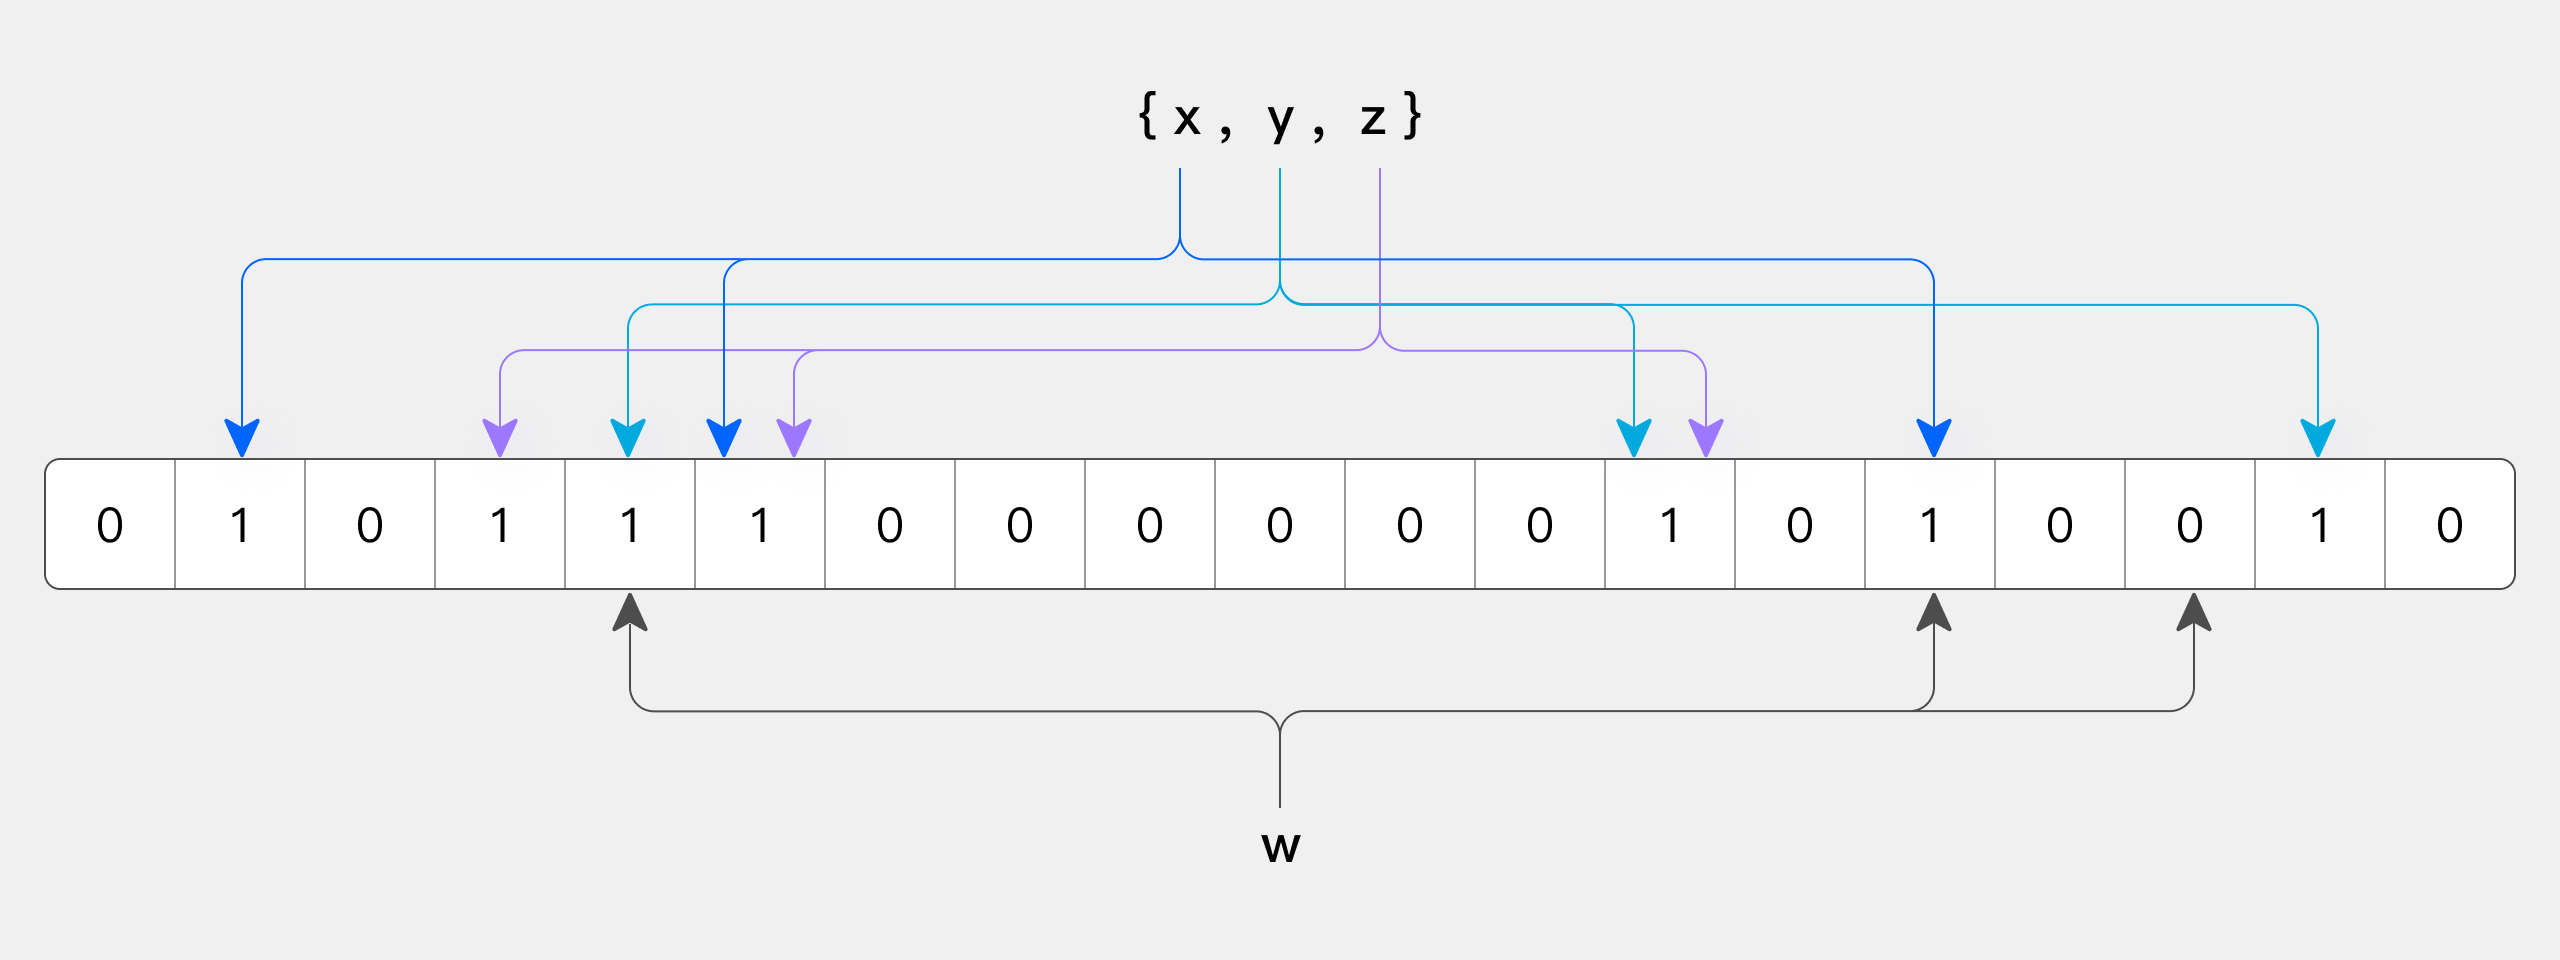
Из-за возможных коллизий хешей BloomFilter может давать ложноположительные результаты. Поэтому индекс на основе BloomFilter может лишь пропускать данные, которые точно не удовлетворяют условию; он не позволяет точно определить расположение данных, удовлетворяющих условию.
Реализация в Doris
В Doris индекс BloomFilter строится для каждого блока данных (страницы): каждому блоку соответствует отдельный BloomFilter.
- При записи: каждое значение в блоке данных хешируется и сохраняется в BloomFilter соответствующего блока.
- При выполнении запроса: для значения из условия равенства Doris проверяет, содержит ли его BloomFilter каждого блока данных. Если значение отсутствует, блок пропускается, что сокращает объём ввода-вывода и ускоряет запрос.
Варианты использования
Индекс BloomFilter позволяет ускорить запросы на равенство (включая = и IN) и особенно хорошо подходит для столбцов с высокой кардинальностью (например, столбцов с уникальными идентификаторами, таких как userid).
Подходящие сценарии
| Сценарий | Описание |
|---|---|
| Запрос на равенство | WHERE column = value |
| Запрос с IN | WHERE column IN (v1, v2, ...) |
| Столбец с высокой кардинальностью | Столбец с большим количеством различных значений и низкой частотой повторений, например идентификатор пользователя или номер заказа |
Ограничения
- Ограничение по типу запроса: индекс эффективен только для запросов с
=иIN. Для запросов с!=,NOT IN,>или<он неэффективен. - Ограничение по типу данных: создание индекса BloomFilter для столбцов типов
Tinyint,FloatилиDoubleне поддерживается. - Ограничение по кардинальности: для столбцов с низкой кардинальностью ускорение ограничено. Например, столбец «пол» содержит всего два значения, поэтому почти каждый блок данных содержит все возможные значения. BloomFilter не может отфильтровать данные, и индекс становится бесполезным.
- Ограничение по версии: начиная с версии 4.1.2 индексы BloomFilter для столбцов типа
CHARбольше не действуют.
Управление индексами
Создание индекса BloomFilter при создании таблицы
По историческим причинам синтаксис определения индекса BloomFilter отличается от общего синтаксиса INDEX, используемого, например, для инвертированных индексов. Индекс BloomFilter задаётся в атрибуте таблицы PROPERTIES с помощью свойства bloom_filter_columns. При этом можно указать один или несколько столбцов:
PROPERTIES (
    "bloom_filter_columns" = "column_name1,column_name2"
);
Просмотр индекса BloomFilter
Используйте SHOW CREATE TABLE, чтобы просмотреть индексы BloomFilter, созданные для таблицы:
SHOW CREATE TABLE table_name;
Изменение индекса BloomFilter
Используйте ALTER TABLE для изменения свойства таблицы bloom_filter_columns, чтобы добавить или удалить столбцы индекса BloomFilter.
Добавление индекса BloomFilter для column_name3:
ALTER TABLE table_name SET ("bloom_filter_columns" = "column_name1,column_name2,column_name3");
Удаление индекса BloomFilter для column_name1:
ALTER TABLE table_name SET ("bloom_filter_columns" = "column_name2,column_name3");
Использование индекса
Индекс BloomFilter ускоряет запросы с условиями равенства в WHERE. Он применяется автоматически при выполнении необходимых условий, специальный синтаксис не требуется.
Анализ эффективности индекса с помощью Query Profile
Для оценки ускорения, которое даёт индекс BloomFilter, можно использовать следующие метрики в Query Profile:
| Метрика | Значение |
|---|---|
RowsBloomFilterFiltered | Количество строк, отфильтрованных индексом BloomFilter. Сравните его с другими метриками Rows, чтобы оценить эффективность фильтрации. |
BlockConditionsFilteredBloomFilterTime | Время, затраченное на фильтрацию с помощью индекса BloomFilter. |
Пример использования
Следующий пример показывает, как создать индекс BloomFilter в Doris.
В разделе PROPERTIES оператора CREATE TABLE укажите имена столбцов, для которых нужно построить индексы BloomFilter, с помощью "bloom_filter_columns" = "k1,k2,k3". Например, в следующем примере индексы BloomFilter создаются для столбцов saler_id и category_id:
CREATE TABLE IF NOT EXISTS sale_detail_bloom (
    sale_date date NOT NULL COMMENT "Sale time",
    customer_id int NOT NULL COMMENT "Customer ID",
    saler_id int NOT NULL COMMENT "Salesperson",
    sku_id int NOT NULL COMMENT "Product ID",
    category_id int NOT NULL COMMENT "Product category",
    sale_count int NOT NULL COMMENT "Sales quantity",
    sale_price DECIMAL(12,2) NOT NULL COMMENT "Unit price",
    sale_amt DECIMAL(20,2) COMMENT "Total sales amount"
)
DUPLICATE KEY(sale_date, customer_id, saler_id, sku_id, category_id)
DISTRIBUTED BY HASH(saler_id) BUCKETS 10
PROPERTIES (
    "replication_num" = "1",
    "bloom_filter_columns" = "saler_id,category_id"
);