Обзор индексов
Apache Doris ускоряет запросы с помощью нескольких типов индексов. Эта страница поможет решить, стоит ли добавлять индекс и какой именно, а также содержит ссылки на подробное описание каждого типа.
С чего начать
В каждой таблице уже есть два индекса, которые Doris создаёт и поддерживает автоматически:
- Префиксный индекс по ключу сортировки, который ускоряет фильтрацию по начальным столбцам Key. Чтобы использовать его, поместите столбец, по которому вы чаще всего фильтруете данные, в начало Key.
- Индекс ZoneMap для каждого столбца, который позволяет пропускать блоки данных, не соответствующие условию фильтрации по диапазону или равенству.
Добавляйте индекс вручную, только если этих индексов недостаточно для ваших запросов:
| Характер запросов | Рекомендуемый индекс | Когда нужен |
|---|---|---|
| Фильтрация по наиболее часто используемому столбцу | Поместите этот столбец в начало Key (префиксный индекс) | Всегда начинайте проектирование с этого |
| Фильтрация по равенству или диапазону для столбца, не входящего в Key | Инвертированный индекс | Часто |
Поиск подстроки в тексте с помощью LIKE | Индекс NGram BloomFilter | Иногда |
| Фильтрация по равенству, когда размер индекса важнее гибкости | Индекс BloomFilter | Редко; обычно предпочтителен инвертированный индекс |
| Полнотекстовый поиск: по ключевым словам, фразам или нескольким полям | Инвертированный индекс | При поиске по тексту |
| Поиск по векторному сходству (Top-K ближайших соседей) | Векторный индекс (ANN) | Для RAG, семантического поиска, рекомендаций и поиска медиаданных |
Если запрос выполняется медленнее, чем ожидалось, с помощью QueryProfile проверьте, какой объём данных отфильтровал каждый индекс и сколько времени это заняло. Подробности приведены на странице соответствующего индекса.
Как работает каждый индекс
Apache Doris предоставляет четыре категории индексов для различных сценариев запросов: индексы для точечных запросов, индексы пропуска данных, индексы полнотекстового поиска и векторные индексы.
Сценарий 1: условию соответствует мало строк (индексы для точечных запросов)
Сценарии применения: точный поиск небольшого объёма данных, например запросы по первичному ключу или получение подробных записей по идентификатору пользователя.
Принцип ускорения: индекс напрямую находит строки, удовлетворяющие условию WHERE, и считывает только их, позволяя избежать построчного сканирования.
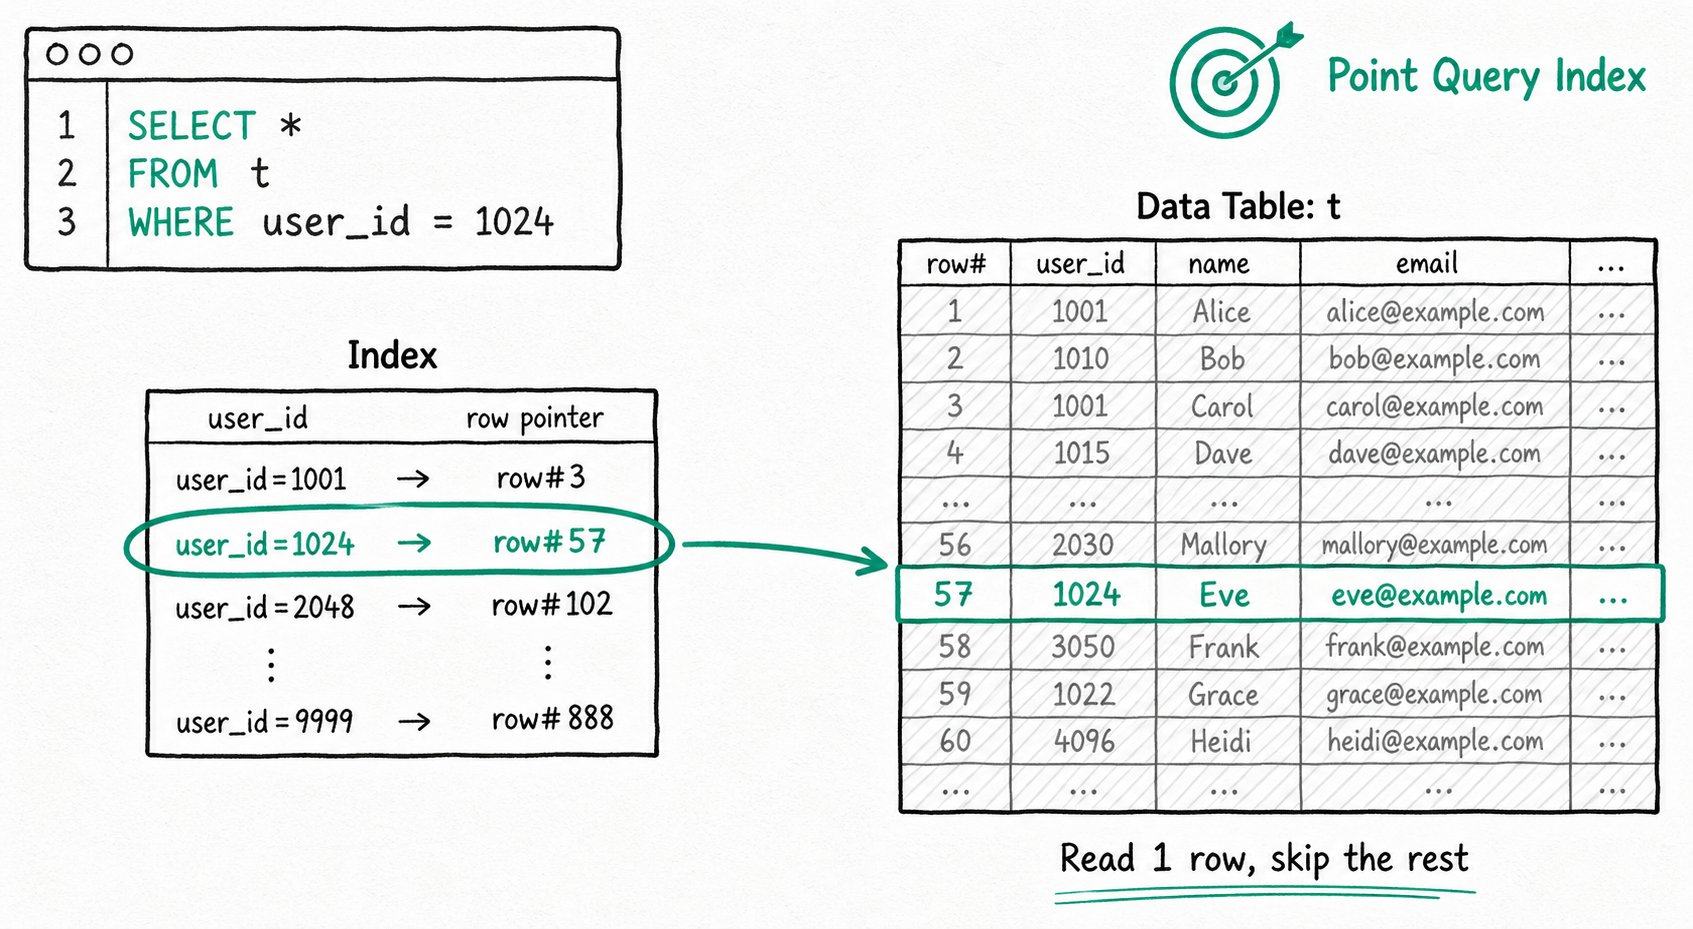
Apache Doris предоставляет два индекса для точечных запросов:
- Префиксный индекс: Doris хранит данные в порядке ключа сортировки и создаёт разреженный префиксный индекс через каждые 1024 строки. Каждая запись индекса содержит значения столбцов сортировки из первой строки своей группы. Если запрос фильтрует данные по столбцам сортировки, Doris переходит к нужной группе и начинает сканирование с неё.
- Инвертированный индекс: Doris создаёт инвертированную таблицу, которая сопоставляет каждое значение со строками, содержащими его. При запросе по равенству система находит соответствующие строки и считывает только их, избегая полного сканирования и сокращая I/O. Инвертированные индексы также ускоряют фильтрацию по диапазону и поиск ключевых слов в тексте; алгоритм сложнее, но принцип остаётся тем же.
Индекс BITMAP заменён инвертированным индексом.
Сценарий 2: условию соответствует много строк (индексы пропуска данных)
Сценарии применения: аналитические запросы с фильтрацией больших объёмов данных, например агрегация за временной диапазон и фильтрация по измерениям.
Принцип ускорения: индекс определяет, какие блоки данных не удовлетворяют условию WHERE, пропускает их и считывает только блоки, которые могут удовлетворять условию. Затем выполняется построчная фильтрация для получения окончательного результата.
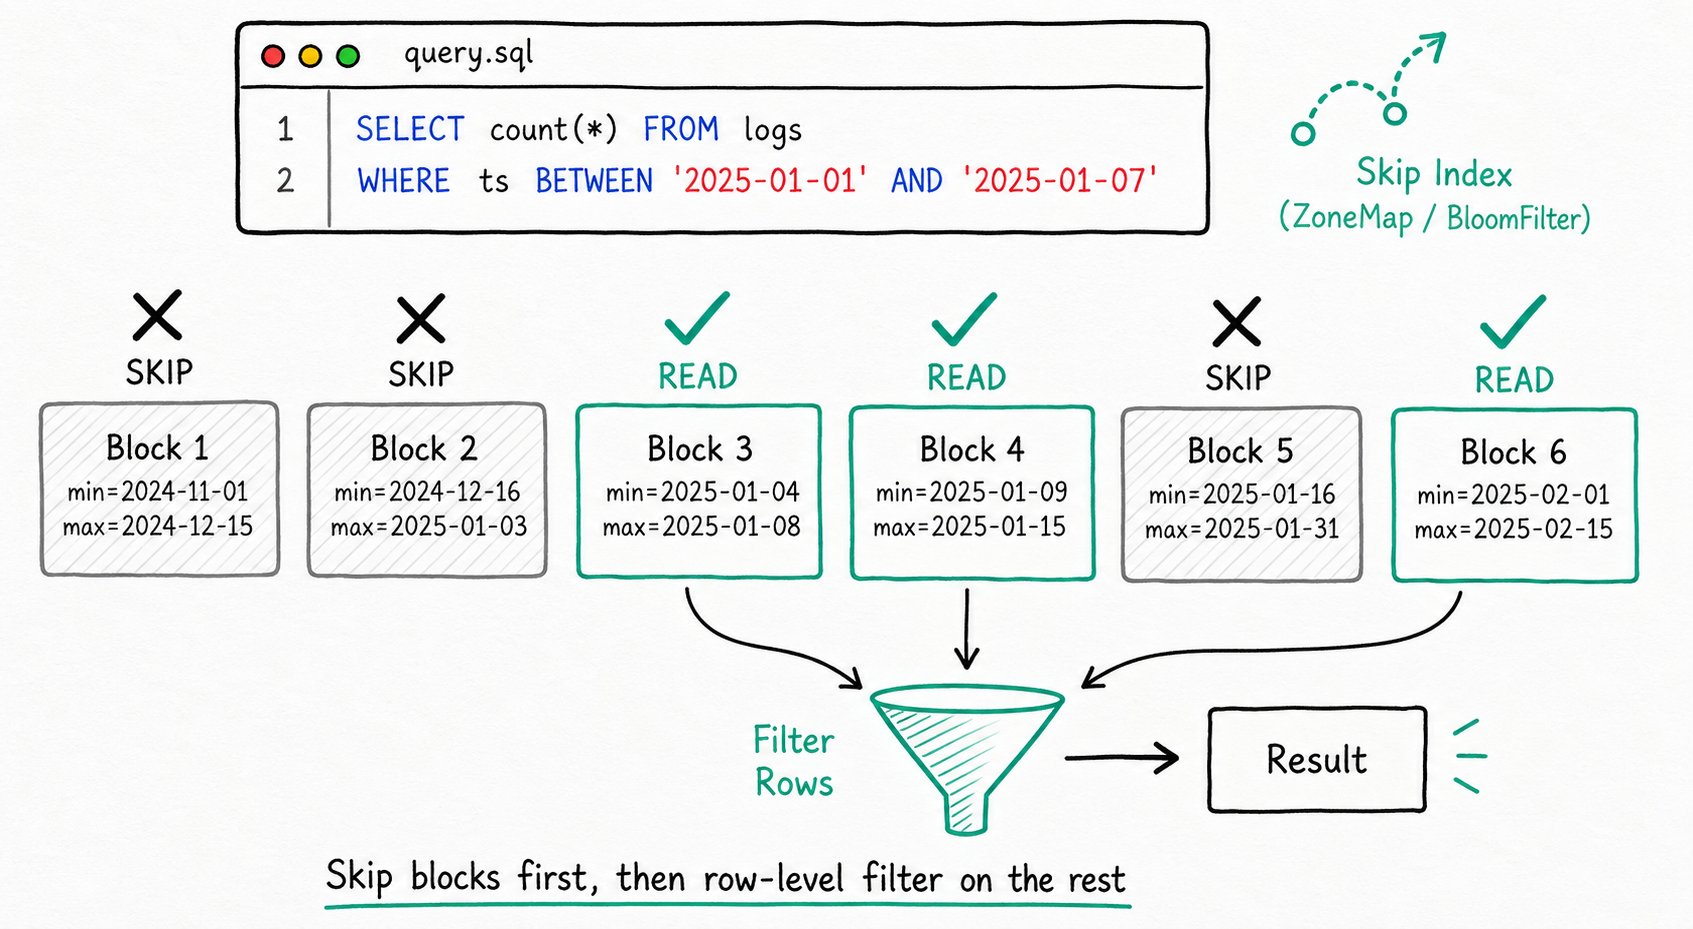
Apache Doris предоставляет три индекса пропуска данных:
- Индекс ZoneMap: Doris автоматически сохраняет статистику по столбцам (min, max и наличие NULL) для каждого файла данных (Segment) и блока данных (Page). При фильтрации по равенству, диапазону и IS NULL система использует эту статистику, чтобы определить, может ли файл или блок содержать подходящие строки. Если не может, Doris пропускает этот файл или блок и сокращает I/O.
- Индекс BloomFilter: Doris сохраняет значения столбца в BloomFilter, структуре, которая позволяет проверять наличие значения и занимает очень мало места. При запросе по равенству, если значения нет в фильтре, Doris пропускает соответствующий файл или блок и сокращает I/O.
- Индекс NGram BloomFilter: ускоряет текстовые запросы с
LIKE. Работает аналогично индексу BloomFilter, но сохраняет токены NGram из текста вместо целых значений. Для запроса сLIKEDoris разбивает шаблон на токены тем же способом и проверяет каждый токен по фильтру. Если хотя бы один токен отсутствует, файл или блок не может содержать совпадений, поэтому Doris пропускает его.
Сценарий 3: полнотекстовый поиск по тексту (инвертированный индекс)
Сценарии применения: анализ журналов, поиск по содержимому, анализ обращений в службу поддержки и другие сценарии, в которых требуется находить данные в текстовых полях по ключевым словам, фразам или шаблонам.
Принцип ускорения: токенизатор разбивает текст на термы, и строится инвертированная таблица, которая сопоставляет каждый терм с соответствующими номерами строк. При выполнении запроса поисковые термы токенизируются тем же способом. Из инвертированной таблицы извлекаются множества номеров строк, содержащих эти термы, и объединяются в соответствии с логическими связями AND/OR/NOT. Затем подходящие строки считываются напрямую. Это позволяет избежать построчного сканирования и сопоставления исходного текста с регулярными выражениями.
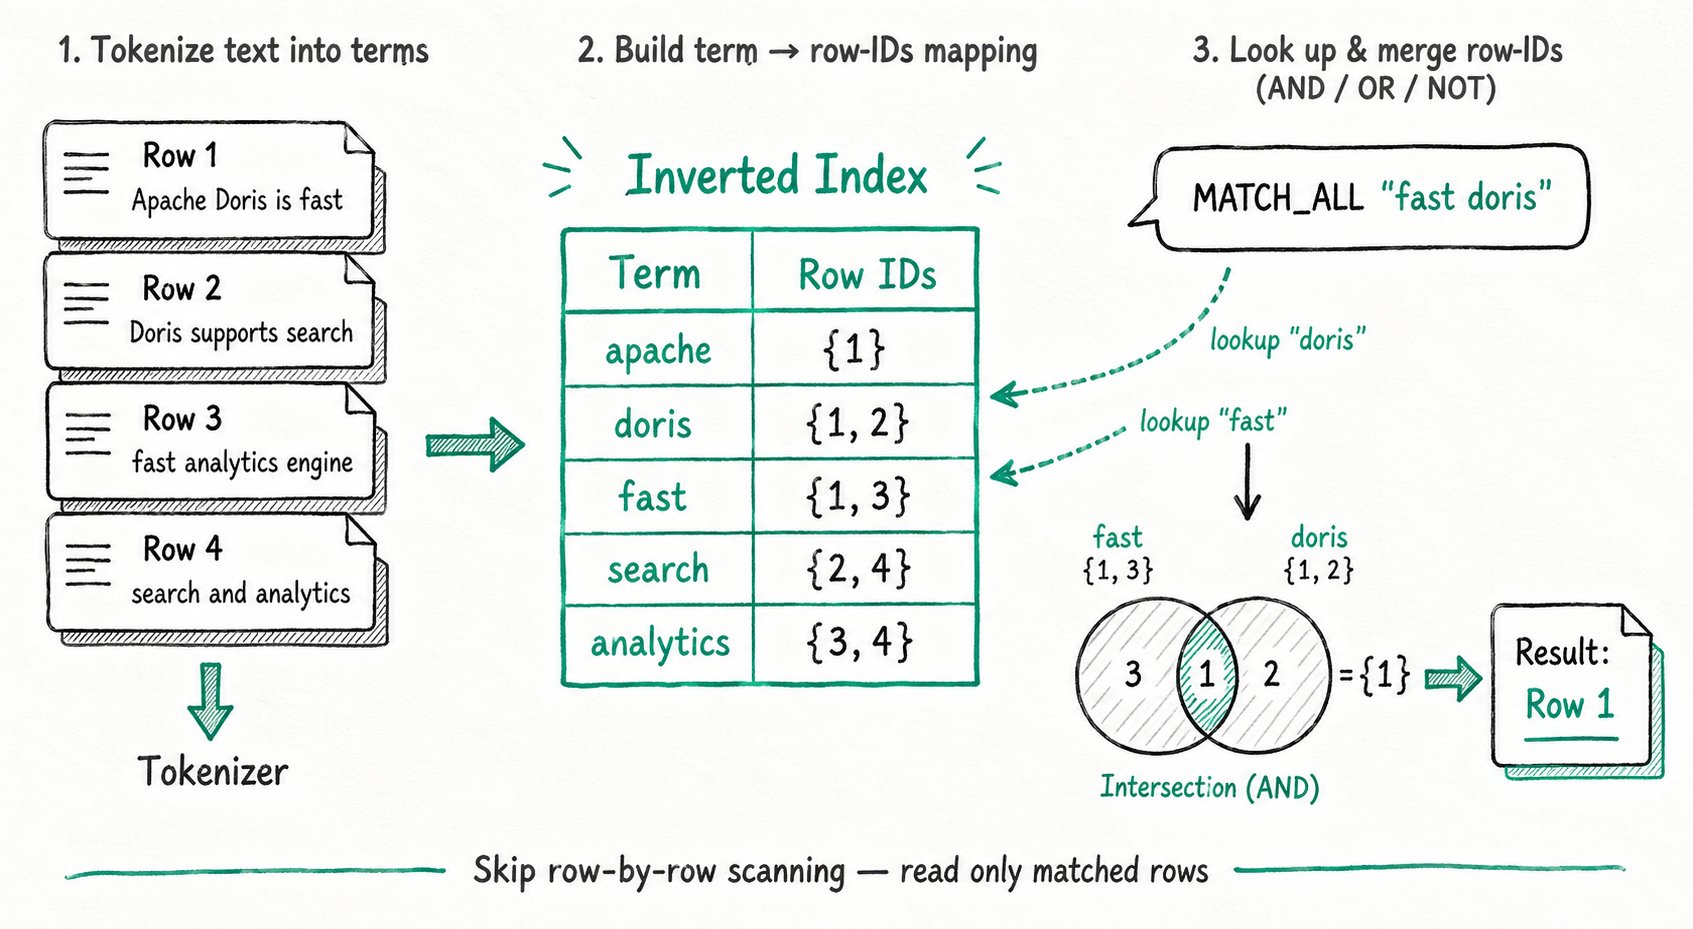
Подробное описание использования приведено в разделе Инвертированный индекс. Инвертированный индекс Apache Doris поддерживает:
- Поиск по ключевым словам:
MATCH_ANY(совпадение хотя бы одного слова) иMATCH_ALL(совпадение всех слов). - Фразовые запросы:
MATCH_PHRASEподдерживает поиск фраз с учётом порядка слов и настраиваемым расстоянием между словамиslop;MATCH_PHRASE_PREFIXподдерживает поиск фраз с сопоставлением последнего слова по префиксу;MATCH_REGEXPподдерживает сопоставление токенизированных термов с регулярными выражениями. - Многоязычная токенизация: встроенные токенизаторы, включая
english,chinese,unicode,icu,basicиik, для китайского, английского, смешанных текстов и многоязычных сценариев. - Комбинированный поиск по нескольким столбцам: функция
multi_matchпозволяет выполнять поиск с OR/AND, по фразам и префиксам сразу по нескольким полям. - Сочетание с обычными фильтрами: произвольное комбинирование с условиями равенства, диапазона,
INи другими условиями, а также с другими индексами через AND/OR/NOT с повторным использованием того же инвертированного индекса для выполнения запроса.
Сценарий 4: поиск по векторному сходству (векторный индекс)
Сценарии применения: RAG (генерация с дополнением результатами поиска), семантический поиск, рекомендательные системы и поиск изображений, аудио и видео, где требуется находить Top-K ближайших соседей по векторному сходству или фильтровать по пороговому значению расстояния.
Принцип ускорения: традиционный подход вычисляет расстояние между вектором запроса и каждой записью, поэтому затраты растут линейно с объёмом данных. Векторный индекс (ANN, Approximate Nearest Neighbor) заранее строит на множестве векторов структуру графа (например, HNSW) или кластеризации (например, IVF), ограничивая область поиска небольшим набором векторов-кандидатов. Это позволяет получить ускорение на порядок ценой контролируемого снижения точности.
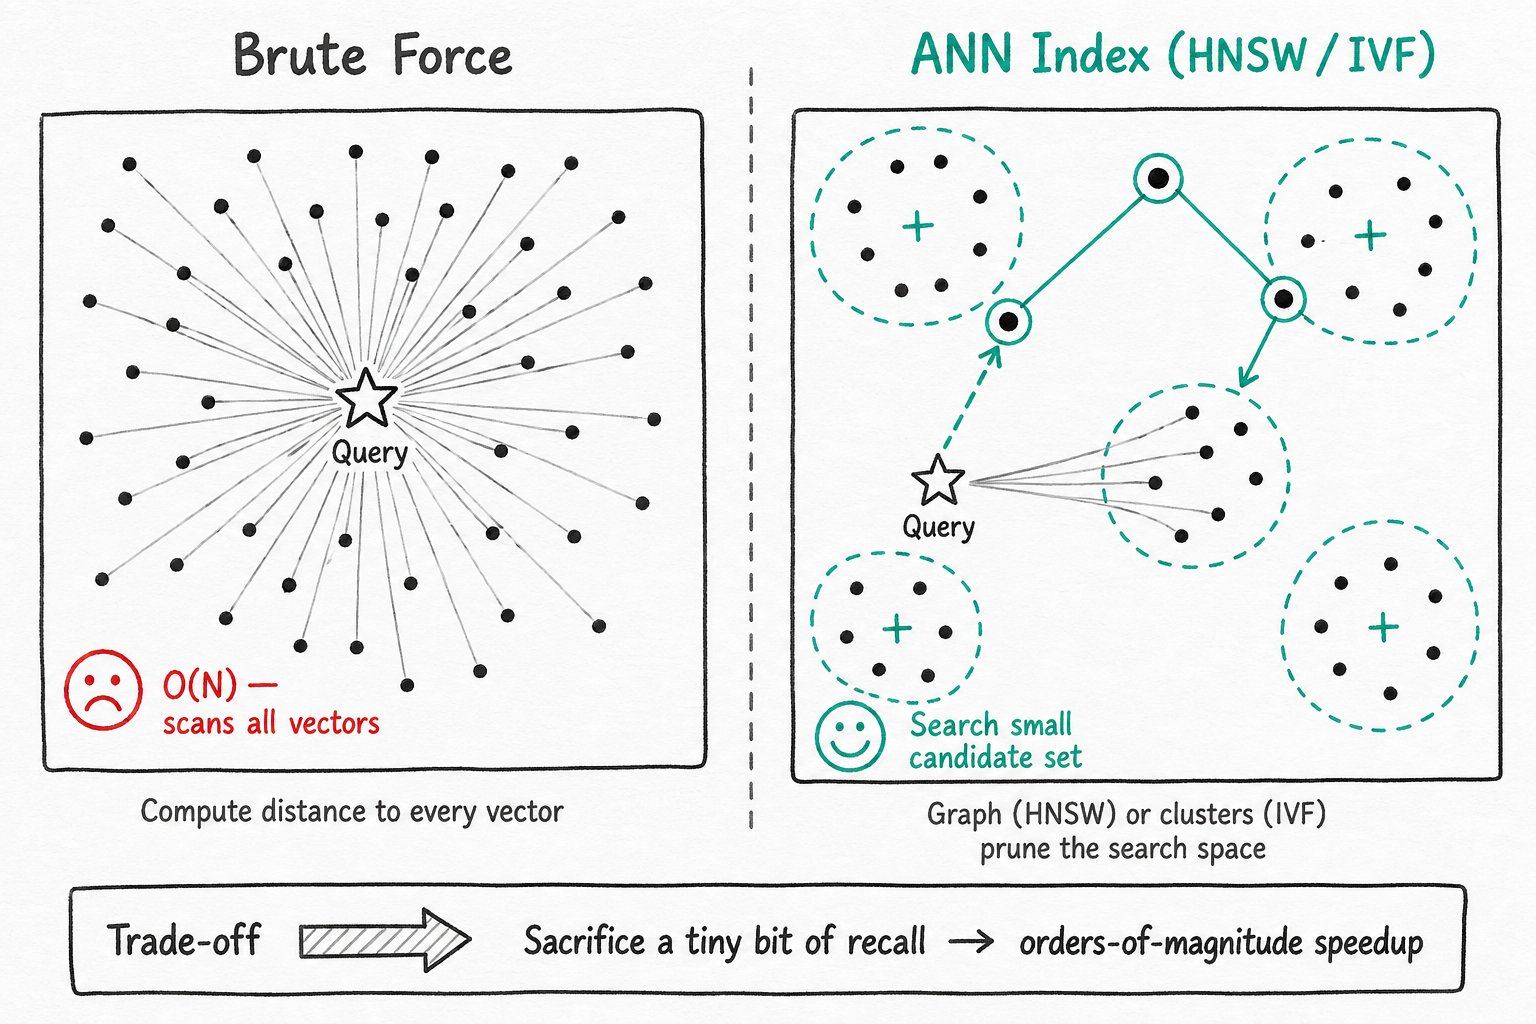
Подробное описание использования приведено в разделе Векторный индекс. Apache Doris поддерживает индексы ANN начиная с версии 4.0. Основные возможности:
- Несколько алгоритмов индексирования: поддерживаются
hnsw,ivfиivf_on_disk, подходящие соответственно для сценариев с высоким QPS и хранением в памяти, с ограниченным объёмом памяти и со сверхбольшими объёмами данных на диске. - Несколько метрик расстояния: поддерживаются
l2_distance(евклидово расстояние) иinner_product(скалярное произведение). После применения L2-нормализации к векторам можно эквивалентным образом реализовать косинусное сходство. - TopN / диапазонные / комбинированные запросы: функции
l2_distance_approximateиinner_product_approximateпозволяют выполнять ANN TopN. Также поддерживаются диапазонный поиск по пороговому значению расстояния и сочетание TopN с условиями Range в одном SQL-запросе. - Гибридный поиск со скалярными фильтрами: работает совместно со вторичными индексами, например с инвертированным индексом. Условия по структурированным данным (например,
MATCH_ANY 'music') могут сначала отфильтровать набор кандидатов, после чего ANN TopN выполняется на этом наборе, обеспечивая векторный поиск с условиями фильтрации. - Квантование векторов: поддерживаются
flat,sq8,sq4,pqи другие методы квантования, позволяющие гибко выбирать баланс между полнотой поиска и использованием памяти и диска.
Способы управления индексами
В зависимости от необходимости ручного управления со стороны пользователя индексы Apache Doris делятся на две категории:
| Способ управления | Типы индексов | Описание |
|---|---|---|
| Поддерживаются автоматически | Префиксный индекс, индекс ZoneMap | Встроенные интеллектуальные индексы Apache Doris, не требующие управления со стороны пользователя |
| Создаются вручную | Инвертированный индекс, индекс BloomFilter, индекс NGram BloomFilter, векторный индекс | Пользователи выбирают индексы в зависимости от сценария запросов и создают или удаляют их вручную |
Сравнение характеристик индексов
В следующей таблице приведены преимущества и ограничения каждого типа индексов, чтобы упростить выбор:
| Категория | Индекс | Преимущества | Ограничения |
|---|---|---|---|
| Индекс для точечных запросов | Префиксный индекс | Встроенный индекс с наилучшей производительностью | В каждой таблице может быть только один набор префиксных индексов |
| Точечные запросы / полнотекстовый поиск | Инвертированный индекс | Поддерживает токенизацию и поиск по ключевым словам, может быть построен для любого столбца, поддерживает комбинирование нескольких условий; возможности ускорения на уровне функций постоянно расширяются | Занимает много места, сопоставимо с объёмом исходных данных |
| Индекс пропуска данных | Индекс ZoneMap | Встроенный индекс, занимающий мало места | Поддерживает мало типов запросов, только равенство и диапазон |
| Индекс пропуска данных | Индекс BloomFilter | Обеспечивает более детальную фильтрацию, чем ZoneMap, и занимает умеренный объём места | Поддерживает мало типов запросов, только равенство |
| Индекс пропуска данных | Индекс NGram BloomFilter | Ускоряет запросы LIKE и занимает умеренный объём места | Поддерживает мало типов запросов, ускоряет только LIKE |
| Векторный индекс | Индекс ANN | Поддерживает поиск по векторному сходству TopN / по диапазону / с комбинированными условиями, может работать совместно со скалярными фильтрами; поддерживает несколько методов квантования для выбора баланса между полнотой поиска и использованием ресурсов | Применим только к столбцам Array<Float> с ограничением NOT NULL; поддерживает модель таблиц DUPLICATE KEY и модель таблиц UNIQUE KEY с включённым merge-on-write (поддерживается с версии 4.1.4) |
Поддержка операторов и функций индексами
В следующей таблице указано, какие типы индексов поддерживают ускорение распространённых операторов и функций:
| Оператор / функция | Префиксный индекс | Инвертированный индекс | Индекс ZoneMap | Индекс BloomFilter | Индекс NGram BloomFilter |
|---|---|---|---|---|---|
= | ДА | ДА | ДА | ДА | НЕТ |
!= | ДА | ДА | НЕТ | НЕТ | НЕТ |
IN | ДА | ДА | ДА | ДА | НЕТ |
NOT IN | ДА | ДА | НЕТ | НЕТ | НЕТ |
>, >=, <, <=, BETWEEN | ДА | ДА | ДА | НЕТ | НЕТ |
IS NULL | ДА | ДА | ДА | НЕТ | НЕТ |
IS NOT NULL | ДА | ДА | НЕТ | НЕТ | НЕТ |
LIKE | НЕТ | НЕТ | НЕТ | НЕТ | ДА |
MATCH, MATCH_* | НЕТ | ДА | НЕТ | НЕТ | НЕТ |
array_contains | НЕТ | ДА | НЕТ | НЕТ | НЕТ |
array_overlaps | НЕТ | ДА | НЕТ | НЕТ | НЕТ |
is_ip_address_in_range | НЕТ | ДА | НЕТ | НЕТ | НЕТ |
Принципы проектирования индексов
Проектирование и настройка индексов таблицы базы данных тесно связаны с характеристиками данных и характером запросов и требуют проверки и настройки в реальных условиях использования. Универсального решения нет, но Apache Doris постоянно упрощает работу с индексами. При проектировании индексов используйте таблицу из раздела С чего начать, чтобы выбрать и проверить подходящие варианты.