Префиксный индекс и ключ сортировки
Префиксный индекс — это разреженный индекс, который встроен в Apache Doris и поддерживается автоматически. Он быстро определяет расположение блоков данных по первым 36 байтам ключа сортировки и не требует создания вручную. Выбор подходящего ключа сортировки при проектировании схемы таблицы существенно ускоряет запросы с условиями равенства и диапазонными условиями в WHERE.
Принцип работы
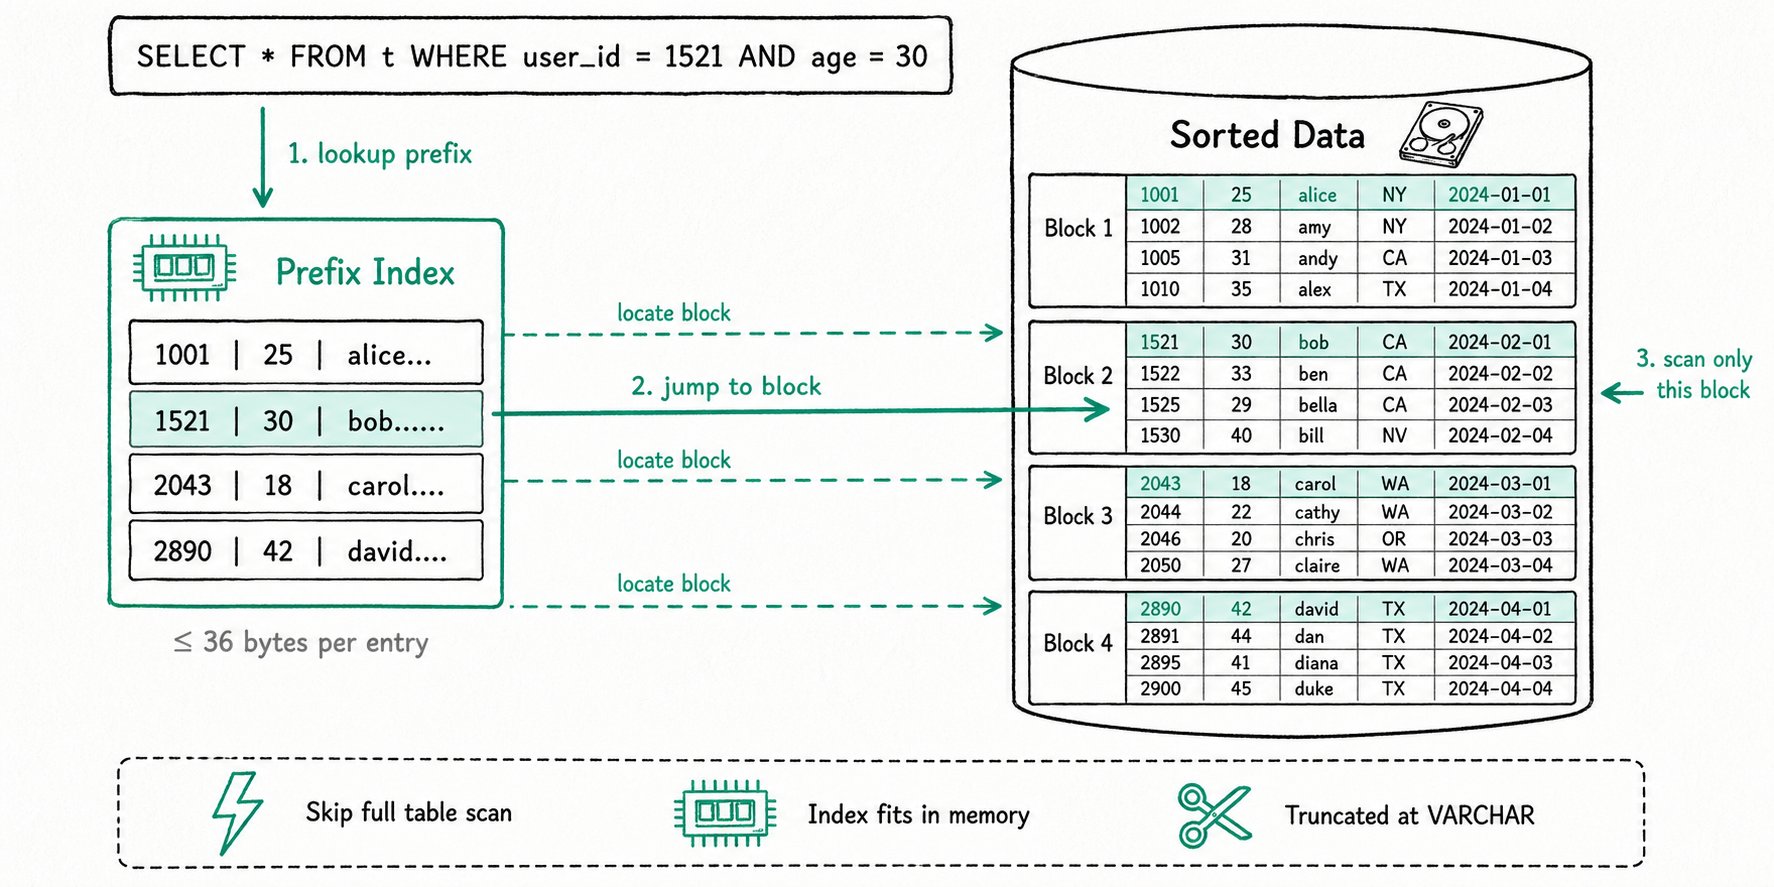
Ключ сортировки
Apache Doris хранит данные в упорядоченной структуре, похожей на SSTable (Sorted String Table). Данные могут быть отсортированы по одному или нескольким заданным столбцам. Эти столбцы называются ключом сортировки.
Ключ сортировки определяется по-разному в зависимости от модели данных:
| Модель данных | Источник ключа сортировки |
|---|---|
| Aggregate | Aggregate Key в операторе CREATE TABLE |
| Unique | Unique Key в операторе CREATE TABLE |
| Duplicate | Duplicate Key в операторе CREATE TABLE |
Если условие WHERE в запросе использует столбцы сортировки, ключ сортировки позволяет Doris быстро перейти к соответствующему диапазону данных и избежать полного сканирования таблицы. Это снижает сложность поиска и ускоряет запрос.
Префиксный индекс
На основе ключа сортировки Apache Doris также формирует префиксный индекс:
- Каждые несколько строк таблицы образуют один логический блок данных.
- Каждому блоку данных соответствует только одна запись в таблице префиксного индекса. Эта запись представляет собой префикс, полученный объединением значений столбцов сортировки первой строки блока, длиной не более 36 байт.
- Благодаря небольшому размеру префиксный индекс можно целиком кэшировать в памяти. Он быстро определяет номер начальной строки целевого блока данных и существенно повышает эффективность запросов.
Правило усечения до 36 байт
Префиксный индекс использует первые 36 байт столбцов сортировки строки в качестве содержимого индекса, но немедленно усекается, когда встречается столбец VARCHAR:
- Когда объединение значений столбцов сортировки доходит до столбца
VARCHAR, усечение происходит в конце этого столбца независимо от того, заполнены ли все 36 байт. - Если уже первый столбец имеет тип
VARCHAR, усечение происходит в конце этого столбца, даже если его длина меньше 36 байт. Последующие столбцы в префиксный индекс не добавляются.
Сценарии применения
Префиксный индекс в основном предназначен для следующих сценариев запросов:
- Запросы с условиями равенства:
col = value,col IN (...) - Запросы с диапазонными условиями:
col > value,BETWEEN ... AND ...и подобные
Префиксный индекс может ускорить запрос, если условие WHERE использует префикс ключа сортировки, то есть несколько крайних левых столбцов начиная с первого.
Рекомендации по проектированию схемы таблицы
У таблицы может быть только одно определение ключа сортировки, поэтому таблица может иметь только один набор префиксных индексов. Выбор ключа сортировки при создании таблицы напрямую определяет, насколько префиксный индекс ускорит запросы. Учитывайте следующие рекомендации:
- Выбирайте в качестве ключевых те столбцы, которые чаще всего встречаются в условиях фильтрации
WHERE. - Размещайте первыми столбцы, которые чаще используются в запросах, поскольку префиксный индекс действует только для условий, охватывающих последовательные столбцы начиная с крайнего левого.
- Будьте осторожны при размещении столбцов
VARCHARв начале ключа сортировки, чтобы избежать усечения, из-за которого последующие столбцы не попадут в префиксный индекс.
Если изменением ключа сортировки не удаётся задействовать префиксный индекс для часто используемого условия запроса, см. раздел Альтернативы, если префиксный индекс нельзя использовать ниже.
Примеры использования
Пример 1: префиксный индекс без усечения
Для следующего ключа сортировки префиксный индекс имеет вид user_id (8 Bytes) + age (4 Bytes) + message (first 20 Bytes), что в сумме составляет 32 байта:
| Имя столбца | Тип |
|---|---|
| user_id | BIGINT |
| age | INT |
| message | VARCHAR(100) |
| max_dwell_time | DATETIME |
| min_dwell_time | DATETIME |
Пример 2: первый столбец имеет тип VARCHAR и вызывает усечение
Для следующего ключа сортировки префиксный индекс содержит только user_name (20 Bytes). Хотя общий размер ещё не достиг 36 байт, усечение происходит сразу, поскольку первый столбец имеет тип VARCHAR, и последующие столбцы в префиксный индекс не добавляются:
| Имя столбца | Тип |
|---|---|
| user_name | VARCHAR(20) |
| age | INT |
| message | VARCHAR(100) |
| max_dwell_time | DATETIME |
| min_dwell_time | DATETIME |
Пример 3: запросы с использованием и без использования префиксного индекса
Для схемы таблицы из примера 1:
-
Префиксный индекс используется (условие охватывает два крайних левых столбца сортировки, что обеспечивает высокую эффективность):
SELECT * FROM table WHERE user_id = 1829239 AND age = 20; -
Префиксный индекс не используется (условие пропускает
user_id, поэтому префикс нельзя использовать для определения расположения данных):SELECT * FROM table WHERE age = 20;
Таким образом, правильный выбор порядка столбцов при создании таблицы значительно повышает эффективность запросов.
Проверка эффективности индекса
Префиксный индекс применяется автоматически, когда может ускорить запрос, и не требует специального синтаксиса. Проверить ускорение можно с помощью следующей метрики в профиле запроса:
| Метрика | Значение |
|---|---|
RowsKeyRangeFiltered | Количество строк, отфильтрованных префиксным индексом. Сравните его с другими метриками Rows*, чтобы оценить эффективность фильтрации с помощью индекса. |
Альтернативы, если префиксный индекс нельзя использовать
Если часто используемое условие запроса не позволяет задействовать префиксный индекс, например когда часто используемые столбцы фильтрации не образуют префикс ключа сортировки, рассмотрите следующие два варианта:
- Создайте инвертированный индекс: таблица может иметь несколько инвертированных индексов, что позволяет гибко охватывать столбцы, используемые в разных условиях запросов.
- Используйте материализованное представление для одной таблицы (модель Duplicate): создав синхронное материализованное представление для одной таблицы с другим порядком столбцов и строгой согласованностью, можно косвенно получить несколько наборов префиксных индексов.
Часто задаваемые вопросы
Вопрос 1: Нужно ли создавать префиксный индекс вручную?
Нет. При создании таблицы Doris автоматически использует первые 36 байт ключа сортировки в качестве префиксного индекса. Отдельного синтаксиса DDL для него нет.
Вопрос 2: Может ли одна таблица иметь несколько наборов префиксных индексов?
Нет. Поскольку ключ сортировки у таблицы только один, она может иметь только один набор префиксных индексов. Если требуется несколько наборов, используйте инвертированные индексы или материализованные представления.
Вопрос 3: Почему мой префиксный индекс намного короче, чем ожидалось?
Чаще всего причина в том, что столбец VARCHAR расположен близко к началу ключа сортировки и вызывает усечение. Размещайте типы фиксированной длины, такие как BIGINT, INT и DATETIME, в начале ключа сортировки.
Вопрос 4: Может ли префиксный индекс ускорять запросы с LIKE или текстовый поиск?
Нет. Для нечёткого сопоставления с помощью LIKE и полнотекстового поиска используйте индекс NGram BloomFilter и инвертированный индекс соответственно.