IVF: ускорение векторного поиска в Apache Doris с помощью индексов IVF
Определение в одном предложении: IVF (Inverted File Index) — это индекс приближённого поиска ближайших соседей (ANN), который сужает область поиска, разбивая векторное пространство на кластеры. Встроенная поддержка IVF доступна начиная с Apache Doris 4.x.
Эта статья отвечает на следующие вопросы:
- Что такое индекс IVF? Почему он ускоряет векторный поиск?
- Как создать, построить и удалить индекс IVF в Apache Doris?
- Как выбрать ключевые параметры, такие как
nlistиnprobe, чтобы сбалансировать полноту поиска и производительность? - Какие факторы влияют на полноту поиска? Как избежать снижения производительности?
Быстрая навигация
| Ваша цель | Перейти к разделу |
|---|---|
| Понять основные принципы IVF | Что такое индекс IVF |
| Создать и использовать индекс IVF | Использование IVF в Apache Doris |
| Настроить полноту поиска | Оптимизация полноты поиска |
| Устранить проблемы с производительностью запросов | Производительность запросов |
| Воспроизвести тесты производительности | Тест производительности |
| Найти ответы на частые вопросы | Часто задаваемые вопросы |
Что такое индекс IVF
От инвертированных индексов к векторным инвертированным индексам
Термин IVF (Inverted File) пришёл из области информационного поиска. Рассмотрим поиск по тексту:
-
Прямой индекс: для каждого документа хранится список слов. При выполнении запроса необходимо просмотреть все документы.
Документ Слова Документ 1 the, cow, says, moo Документ 2 the, cat, and, the, hat Документ 3 the, dish, ran, away, with, the, spoon -
Инвертированный индекс: для каждого слова хранится список документов, содержащих это слово. При выполнении запроса достаточно просмотреть соответствующие списки.
Слово Документы the Документ 1, Документ 3, Документ 4, Документ 5, Документ 7 cow Документ 2, Документ 3, Документ 4 says Документ 5 moo Документ 7
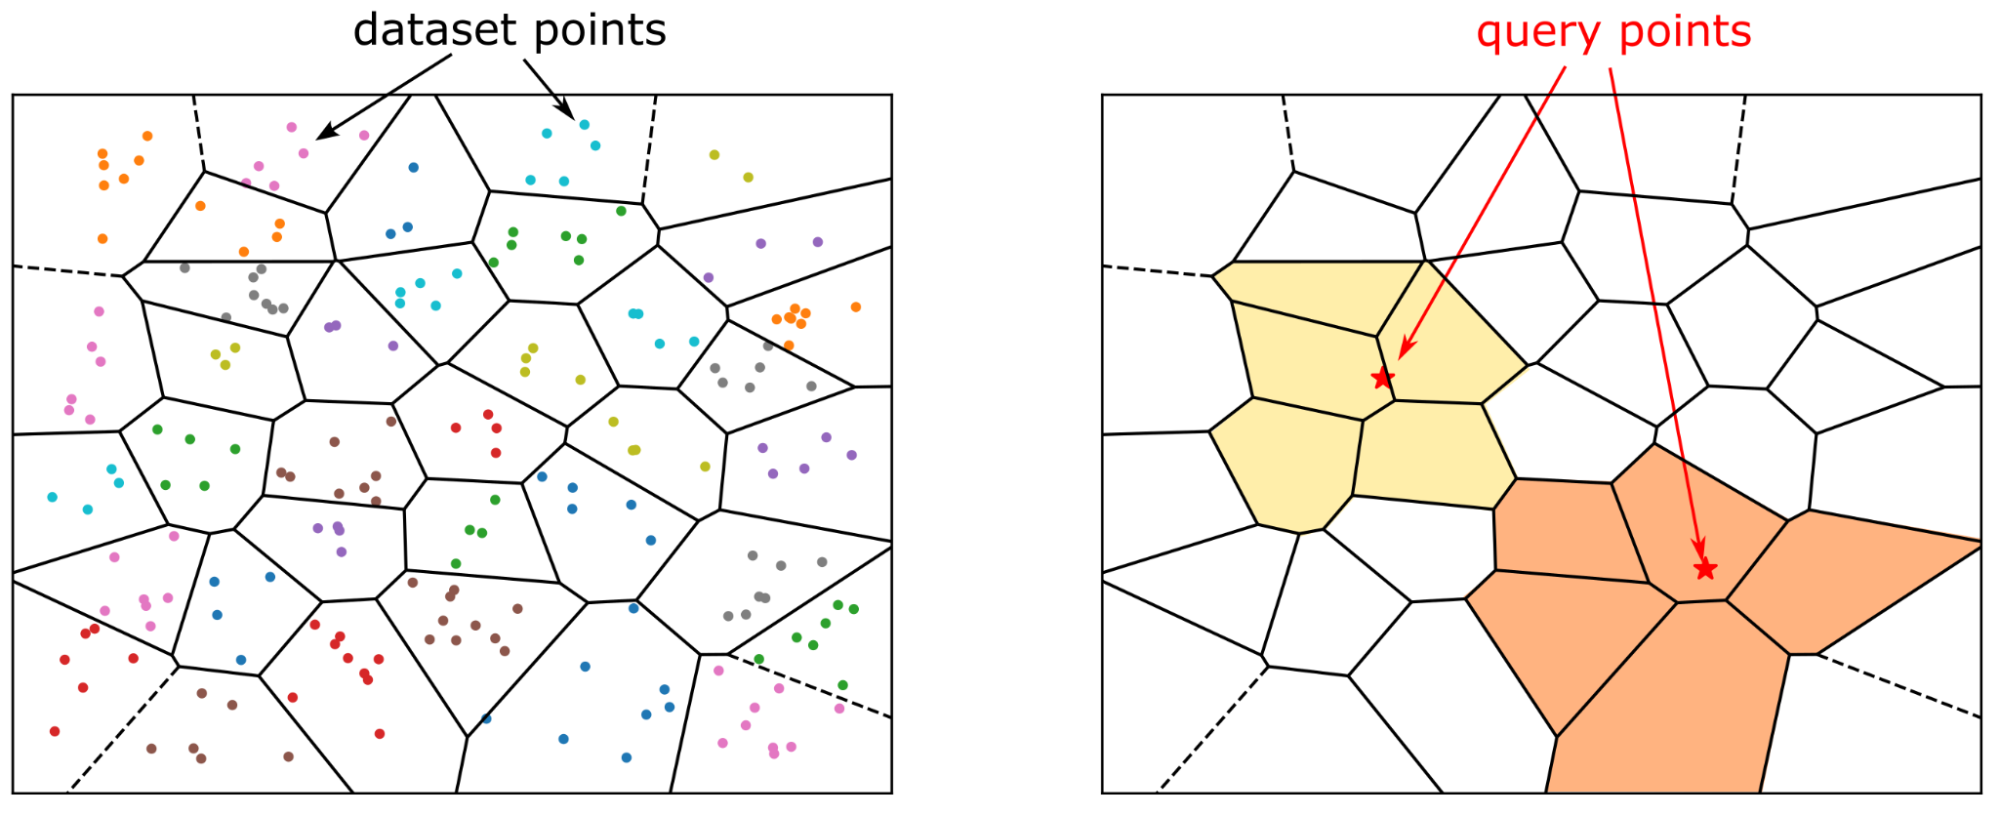
Сегодня текст обычно представляют в виде векторных эмбеддингов. IVF использует идею инвертированного индекса: центроиды кластеров играют роль «словаря», а для каждого центроида хранится список векторов, принадлежащих этому кластеру. При выполнении запроса достаточно проверить небольшое число выбранных кластеров.
Почему IVF ускоряет векторный поиск
Когда набор данных вырастает до миллионов или миллиардов векторов, точный поиск kNN (вычисление расстояния между вектором запроса и каждым вектором в базе данных) становится эквивалентен масштабному матричному умножению, а вычислительные затраты — неприемлемыми.
Приближённый поиск ближайших соседей (ANN) позволяет ускорить поиск на порядок ценой небольшой потери точности. IVF — один из самых распространённых и эффективных методов ANN в отрасли. Его основная идея — «разделяй и властвуй»:
- Разбить весь набор векторов на несколько кластеров, каждый из которых представлен центроидом.
- При выполнении запроса сначала найти небольшое число кластеров, центроиды которых ближе всего к вектору запроса, а затем искать только в этих кластерах, пропуская остальные данные.
Использование IVF в Apache Doris
Apache Doris поддерживает индексы ANN на основе IVF начиная с версии 4.x. Тип индекса всегда задаётся как ANN, а алгоритм IVF выбирается с помощью параметра index_type=ivf.
Способы построения индекса
Создать индекс ANN можно двумя способами, подходящими для разных сценариев:
| Способ | Когда строится индекс | Преимущества | Недостатки | Сценарии применения |
|---|---|---|---|---|
| Определение индекса при создании таблицы | Синхронно во время загрузки данных | Запросы ускоряются сразу после записи данных | Замедляет запись; Compaction может вызывать перестроение индекса, расходуя ресурсы | Производственные среды с уже подобранными параметрами индекса |
CREATE INDEX + BUILD INDEX | Асинхронно после загрузки данных | Не влияет на загрузку данных; удобен для подбора параметров | Запросы не ускоряются, пока индекс строится | Подбор параметров, первоначальное заполнение очень больших таблиц |
Способ 1: определение индекса при создании таблицы
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="ivf",
      "metric_type"="l2_distance",
      "dim"="128",
      "nlist"="1024"
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
  "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
  "format" = "csv");
Способ 2: CREATE INDEX + BUILD INDEX
Шаг 1: создайте таблицу без индекса и загрузите данные.
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT ""
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
  "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
  "format" = "csv");
Шаг 2: выполните CREATE INDEX, чтобы добавить определение индекса. На этом этапе регистрируются только метаданные индекса; сам индекс для существующих данных ещё не построен.
CREATE INDEX idx_test_ann ON sift_1M (`embedding`) USING ANN PROPERTIES (
  "index_type"="ivf",
  "metric_type"="l2_distance",
  "dim"="128",
  "nlist"="1024"
);

SHOW DATA ALL FROM sift_1M;
Ожидаемый результат (LocalIndexSize всё ещё равен 0):
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| TableName | IndexName | ReplicaCount | RowCount | LocalTotalSize | LocalDataSize | LocalIndexSize | RemoteTotalSize | RemoteDataSize | RemoteIndexSize |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| sift_1M   | sift_1M   | 10           | 1000000  | 170.093 MB     | 170.093 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
|           | Total     | 10           |          | 170.093 MB     | 170.093 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
Шаг 3: выполните BUILD INDEX, чтобы построить индекс для существующих данных. Эта задача выполняется асинхронно.
BUILD INDEX idx_test_ann ON sift_1M;
Шаг 4: проверьте состояние задачи с помощью SHOW BUILD INDEX.
SHOW BUILD INDEX WHERE TableName = "sift_1M";
После завершения задачи снова проверьте размер данных. Теперь отображается размер построенного индекса (LocalIndexSize):
+---------------+-----------+---------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| JobId         | TableName | PartitionName | AlterInvertedIndexes                                                                                                                                | CreateTime              | FinishTime              | TransactionId | State    | Msg  | Progress |
+---------------+-----------+---------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| 1764392359610 | sift_1M   | sift_1M       | [ADD INDEX idx_test_ann (`embedding`) USING ANN PROPERTIES("dim" = "128", "index_type" = "ivf", "metric_type" = "l2_distance", "nlist" = "1024")],  | 2025-12-01 14:18:22.360 | 2025-12-01 14:18:27.885 | 5036          | FINISHED |      | NULL     |
+---------------+-----------+---------------+-----------------------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+

mysql> SHOW DATA ALL FROM sift_1M;
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| TableName | IndexName | ReplicaCount | RowCount | LocalTotalSize | LocalDataSize | LocalIndexSize | RemoteTotalSize | RemoteDataSize | RemoteIndexSize |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| sift_1M   | sift_1M   | 10           | 1000000  | 671.084 MB     | 170.093 MB    | 500.991 MB     | 0.000           | 0.000          | 0.000           |
|           | Total     | 10           |          | 671.084 MB     | 170.093 MB    | 500.991 MB     | 0.000           | 0.000          | 0.000           |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
Удаление индекса
При подборе параметров часто требуется проверить разные комбинации, чтобы обеспечить нужную полноту поиска. Используйте DROP INDEX для гибкого управления индексами:
ALTER TABLE sift_1M DROP INDEX idx_test_ann;
Выполнение векторных запросов
Индексы ANN ускоряют как поиск TopN, так и поиск в диапазоне.
Рекомендация для производственной среды: строковое представление векторов высокой размерности создаёт дополнительные накладные расходы при разборе SQL, поэтому при большом числе одновременных запросов не рекомендуется выполнять SQL напрямую. Рекомендуются два варианта оптимизации:
- Используйте Prepare Statement для предварительного разбора SQL.
- Используйте официальную библиотеку Python для векторного поиска в Doris. Эта библиотека предоставляет обёртку для вызовов Prepare Statement и преобразует результаты запросов непосредственно в pandas DataFrame, что удобно при разработке приложений ИИ.
Пример кода:
from doris_vector_search import DorisVectorClient, AuthOptions

auth = AuthOptions(
    host="127.0.0.1",
    query_port=9030,
    user="root",
    password="",
)

client = DorisVectorClient(database="test", auth_options=auth)

tbl = client.open_table("sift_1M")

query = [0.1] * 128  # Example 128-dimensional vector

# SELECT id FROM sift_1M ORDER BY l2_distance_approximate(embedding, query) LIMIT 10;
result = tbl.search(query, metric_type="l2_distance").limit(10).select(["id"]).to_pandas()

print(result)
Ожидаемый результат:
       id
0  123911
1  926855
2  123739
3   73311
4  124493
5  153178
6  126138
7  123740
8  125741
9  124048
Оптимизация полноты поиска
Основная метрика векторного поиска — полнота. Любой показатель производительности имеет смысл только при приемлемой полноте поиска. Основные факторы, влияющие на полноту:
- Параметры индекса IVF (
nlist) и параметры запроса (nprobe) - Квантование векторов в индексе
- Размер и количество файлов Segment
В этом разделе рассматриваются пункты 1 и 3. Квантование векторов описано в других документах.
Гиперпараметры индекса: nlist и nprobe
IVF использует ключевые параметры на этапе построения индекса и при выполнении запросов:
Этап построения индекса:
- Кластеризация: алгоритм кластеризации (например, k-means) разбивает векторы на
nlistкластеров, после чего для каждого кластера вычисляется и сохраняется центроид. - Распределение векторов: каждый вектор назначается кластеру с ближайшим центроидом и добавляется в соответствующий инвертированный список.
Этап выполнения запроса:
- Выбор кластеров: вычисляется расстояние от вектора запроса до всех
nlistцентроидов и выбираютсяnprobeближайших кластеров. - Полный перебор внутри кластеров: для поиска ближайших соседей последовательно сравниваются векторы внутри выбранных
nprobeкластеров.
| Параметр | Назначение | Влияние | Значение по умолчанию в Doris |
|---|---|---|---|
nlist | Количество кластеров (инвертированных списков) | Чем больше значение, тем мельче разбиение и быстрее поиск, но выше затраты на кластеризацию и вероятность того, что соседние векторы окажутся в разных кластерах | 1024 |
nprobe | Количество кластеров, проверяемых при выполнении запроса | Большее значение повышает полноту поиска и задержку; меньшее ускоряет поиск, но повышает вероятность пропуска результатов | 64 |
Результаты измерений на наборе данных SIFT_1M:
| nlist | nprobe | recall@100 |
|---|---|---|
| 1024 | 64 | 0.9542 |
| 1024 | 32 | 0.9034 |
| 1024 | 16 | 0.8299 |
| 1024 | 8 | 0.7337 |
| 512 | 32 | 0.9384 |
| 512 | 16 | 0.8763 |
| 512 | 8 | 0.7869 |
Практический подбор гиперпараметров
Хотя точные оптимальные параметры нельзя определить заранее, их можно подобрать систематически:
- Создайте временную таблицу
table_multi_indexбез индексов, содержащую от 2 до 3 векторных столбцов. - Загрузите данные в эту таблицу с помощью Stream Load или другим способом.
- Выполните
CREATE INDEXиBUILD INDEXс разными параметрами для каждого векторного столбца. - Сравните полноту поиска для каждого столбца и выберите наиболее подходящую комбинацию параметров.
Пример:
ALTER TABLE tbl DROP INDEX idx_embedding;
CREATE INDEX idx_embedding ON tbl (`embedding`) USING ANN PROPERTIES (
  "index_type"="ivf",
  "metric_type"="inner_product",
  "dim"="768",
  "nlist"="1024"
);
BUILD INDEX idx_embedding ON tbl;
Количество строк, охватываемых индексом
Данные во внутренней таблице Doris организованы иерархически:
- Таблица → Tablet: данные равномерно распределяются по N Tablets с помощью ключа бакетирования (Tablet — базовая единица миграции и перебалансировки данных).
- Tablet → Rowset: при каждой загрузке или Compaction добавляется новый Rowset (единица управления версиями).
- Rowset → Segment: сами данные хранятся в файлах Segment.
Как и инвертированные индексы, векторные индексы работают на уровне Segment. Размер Segment регулируется параметрами конфигурации BE write_buffer_size и vertical_compaction_max_segment_size. Во время загрузки или Compaction, когда размер memtable достигает определённого значения, её содержимое сбрасывается в файл Segment, и для этого Segment строится векторный индекс (для нескольких индексируемых столбцов создаётся несколько индексов).
Каждая комбинация параметров индекса IVF обеспечивает эффективный поиск лишь для ограниченного объёма данных. Когда количество строк в Segment превышает некоторый порог, полнота поиска снижается.
Совет: используйте
SHOW TABLETS FROM <table>, чтобы проверить состояние Compaction таблицы. Откройте соответствующий URL, чтобы узнать количество файлов Segment.
Влияние Compaction на полноту поиска
Compaction объединяет несколько небольших файлов Segment в более крупные. Из-за этого параметры индекса, подобранные для меньшего объёма данных, становятся неэффективными, и полнота поиска снижается.
Рекомендация: запустите FULL COMPACTION перед выполнением BUILD INDEX. Построение индекса после полного объединения файлов Segment даёт два преимущества:
- Полнота поиска остаётся стабильной.
- Снижается усиление записи, вызванное построением индекса.
Производительность запросов
Холодная загрузка файлов индекса
Индекс ANN в Doris реализован на основе faiss — библиотеки Meta с открытым исходным кодом. Чтобы индекс IVF мог ускорять запросы, его необходимо полностью загрузить в память.
Рекомендация: перед выполнением большого числа одновременных запросов выполните холодный запрос, чтобы загрузить все необходимые файлы индексов Segment в память. В противном случае производительность первого запроса существенно снизится.
Потребление памяти и производительность
Объём памяти, занимаемый индексом IVF без сжатия с помощью квантования, примерно в 1.02 раза превышает объём индексируемых векторов.
Например, индекс IVF FLAT для набора данных с векторами размерности 128 и 1M строк занимает приблизительно следующий объём памяти:
128 * 4 * 1,000,000 * 1.02 ≈ 500 MB
Справочные значения:
| dim | Количество строк | Расчётный объём памяти |
|---|---|---|
| 128 | 1M | 500 MB |
| 768 | 1M | 2.9 GB |
Для обеспечения производительности запросов на BE должно быть достаточно памяти для размещения всего индекса. В противном случае частые операции IO с файлами индекса приводят к серьёзному снижению производительности запросов.
Тест производительности
Рекомендация по развёртыванию: условия тестирования должны быть близки к производственной среде. Разверните FE и BE отдельно, а клиент запускайте на отдельной машине.
Средство тестирования: VectorDBBench.
Performance768D1M
Команды для тестирования:
# load
NUM_PER_BATCH=1000000 python3 -m vectordbbench doris --host 127.0.0.1 --port 9030 --case-type Performance768D1M --db-name Performance768D1M --stream-load-rows-per-batch 500000 --index-prop index_type=ivf,nlist=1024 --skip-search-serial --skip-search-concurrent

# search
NUM_PER_BATCH=1000000 python3 -m vectordbbench doris --host 127.0.0.1 --port 9030 --case-type Performance768D1M --db-name Performance768D1M --search-concurrent --search-serial --num-concurrency 10,40,80 --stream-load-rows-per-batch 500000 --index-prop index_type=ivf,nlist=1024 --session-var ivf_nprobe=64 --skip-load --skip-drop-old
Часто задаваемые вопросы
Вопрос 1: как выбрать между IVF и HNSW? IVF подходит для больших объёмов данных при достаточном объёме памяти, когда нужно сбалансировать затраты на построение индекса и задержку запросов. HNSW обеспечивает меньшую задержку запросов, но потребляет больше памяти. Подробнее см. в документации HNSW.
Вопрос 2: почему полнота поиска остаётся низкой после BUILD INDEX?
Распространённые причины: слишком низкое значение nprobe, слишком большой размер файлов Segment, из-за чего индекс не обеспечивает достаточную полноту поиска, или отсутствие FULL COMPACTION перед BUILD. См. раздел Оптимизация полноты поиска.
Вопрос 3: зачем выполнять холодный запрос перед большим числом одновременных запросов? Чтобы индекс IVF мог ускорять запросы, его необходимо полностью загрузить в память. Холодный запрос прогревает кэш, загружая индекс с диска в память, что позволяет избежать снижения производительности первого рабочего запроса.
Вопрос 4: нужно ли менять значение nlist по умолчанию, равное 1024?
По умолчанию Doris использует nlist=1024 и nprobe=64, что подходит для большинства наборов данных среднего размера. Корректируйте параметры с учётом фактического объёма данных и требований к полноте поиска, следуя рекомендациям раздела Практический подбор гиперпараметров.
Вопрос 5: освобождает ли DROP INDEX память немедленно?
DROP INDEX удаляет определение индекса, а файлы индекса очищаются позже. При подборе параметров используйте эту команду вместе с последовательностью CREATE INDEX и BUILD INDEX.
Устранение неполадок
| Симптом | Возможная причина | Решение |
|---|---|---|
| Полнота поиска значительно ниже ожидаемой | Слишком низкое значение nprobe / слишком большие файлы Segment / FULL COMPACTION не выполнялась | Увеличьте nprobe; выполните FULL COMPACTION перед BUILD; скорректируйте nlist |
| Первый запрос выполняется с очень большой задержкой, последующие — нормально | Индекс ещё не загружен в память (холодная загрузка) | Выполните холодный запрос для прогрева перед большим числом одновременных запросов |
| На BE не хватает памяти, и производительность запросов снижается | Индекс не помещается в память целиком, что вызывает частые операции IO | Увеличьте объём памяти BE; рассмотрите сжатие с помощью квантования, чтобы снизить потребление памяти |
BUILD INDEX долго не завершается | Задача выполняется асинхронно, а объём данных велик | Проверьте ход выполнения с помощью SHOW BUILD INDEX WHERE TableName = "<tbl>" |
| Загрузка данных замедляется | Индекс, определённый при создании таблицы, строится синхронно | Перейдите на способ CREATE INDEX + BUILD INDEX для асинхронного построения |