Векторный поиск
Начиная с версии 4.0 Apache Doris имеет встроенную поддержку векторного поиска ANN (Approximate Nearest Neighbor, приближённый поиск ближайших соседей). Решение основано на Faiss и индексах HNSW и IVF и обеспечивает поиск TopN и поиск по диапазону среди миллиардов векторов с задержкой в миллисекунды.
Сценарии применения
Векторный поиск лежит в основе RAG (Retrieval-Augmented Generation, генерация с дополнением из результатов поиска) и мультимодального поиска. Типичные области применения:
- Поиск для RAG: извлечение Top-K текстовых фрагментов, наиболее релевантных запросу пользователя, из большой базы знаний и использование их как основы для генерации ответов LLM. Это уменьшает проблемы, связанные с галлюцинациями и устареванием знаний.
- Мультимодальный поиск: преобразование изображений, аудио, видео и других данных в векторы для поиска по семантическому сходству. Например, в медицинских системах вопросов и ответов можно находить истории болезни и публикации, которые помогают формировать диагностические рекомендации.
- Рекомендательные системы: поиск «похожего, но не идентичного» контента с помощью поиска по диапазону для повышения разнообразия рекомендаций.
- Обнаружение аномалий: поиск точек данных, отклоняющихся от нормальных закономерностей.
Суть векторного поиска: преобразовать запрос и документы в семантические векторы по одной и той же схеме, а затем найти в большой коллекции K векторов, наиболее похожих на запрос.
Быстрая навигация
| Сценарий | Раздел |
|---|---|
| Узнать, как создать векторный индекс | Приближённый поиск ближайших соседей |
| Реализовать поиск по косинусному сходству | Использование косинусного сходства |
| Фильтровать по пороговому расстоянию | Приближённый поиск по диапазону |
| Совместить TopN с условиями диапазона | Комбинированный поиск |
| Фильтровать по другим столбцам перед поиском ANN | Поиск ANN с фильтрами |
| Настроить параметры выполнения запросов | Параметры запросов |
| Сэкономить память и уменьшить размер индекса | Квантование векторов |
| Повысить QPS и уменьшить задержку | Настройка производительности |
| Использовать Python SDK | Python SDK |
| Узнать об ограничениях использования | Ограничения использования |
Приближённый поиск ближайших соседей
Doris не вводит новый тип данных. Векторы хранятся в виде Array<Float> фиксированной длины, а для поиска по расстоянию предоставляется индекс ANN на основе Faiss.
Пример создания таблицы
Рассмотрим пример с распространённым набором данных SIFT:
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="flat"
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
Значение основных параметров:
index_type: алгоритм индекса. Допустимые варианты:hnsw(Hierarchical Navigable Small World),ivf(индекс Inverted File) илиivf_on_disk(вариант IVF, в котором инвертированные списки записываются на диск, а доступ к ним осуществляется через кэш).metric_type: метрика расстояния. Значениеl2_distanceозначает использование расстояния L2 в качестве функции расстояния.dim: размерность вектора. Значение128означает, что каждый вектор в этом столбце имеет длину 128.quantizer: схема кодирования. Значениеflatозначает, что каждая координата хранится как исходное значение float32.
Полный список параметров индекса
| Параметр | Обязательный | Поддерживаемые / допустимые значения | По умолчанию | Описание |
|---|---|---|---|---|
index_type | Да | hnsw, ivf, ivf_on_disk | (нет) | Задаёт алгоритм индекса ANN. Сейчас поддерживаются HNSW, IVF в памяти и IVF On-Disk. |
metric_type | Да | l2_distance, inner_product | (нет) | Задаёт метрику сходства / расстояния между векторами. l2_distance означает евклидово расстояние. inner_product можно использовать для поиска по косинусному сходству, но сначала векторы необходимо нормализовать. |
dim | Да | Положительное целое число (> 0) | (нет) | Задаёт размерность вектора. Все загружаемые впоследствии векторы должны иметь такую же размерность, иначе возникнет ошибка. |
nlist | Нет | Положительное целое число | 1024 | Количество инвертированных корзин в IVF. Действует при index_type=ivf или ivf_on_disk. Большее значение обычно позволяет лучше сбалансировать полноту поиска и скорость, но увеличивает затраты на построение. |
max_degree | Нет | Положительное целое число | 32 | Максимальное количество соседей у узла в графе HNSW (M). Влияет на потребление памяти индексом и производительность поиска. |
ef_construction | Нет | Положительное целое число | 40 | Размер очереди кандидатов при построении HNSW (efConstruction). Большее значение повышает качество графа, но замедляет построение. |
quantizer | Нет | flat, sq8, sq4, pq | flat | Схема кодирования / квантования векторов. flat: хранение исходных значений. sq8 / sq4: скалярное квантование (8 / 4 бита). pq: продуктовое квантование. |
pq_m | Обязательный при quantizer=pq | Положительное целое число | (нет) | Количество подвекторов, на которые разбивается исходный вектор высокой размерности. dim должен делиться на pq_m без остатка. |
pq_nbits | Обязательный при quantizer=pq | Положительное целое число | (нет) | Количество битов для квантования каждого подвектора, определяющее размер кодовой книги подпространства (k = 2 ^ pq_nbits). В Faiss это значение обычно не должно превышать 24. |
Загрузка данных
Загрузите набор данных SIFT через S3 TVF:
INSERT INTO sift_1M
SELECT *
FROM S3(
  "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
  "format" = "csv");

select count(*) from sift_1M
--------------

+----------+
| count(*) |
+----------+
|  1000000 |
+----------+
Пример запроса
Вызов l2_distance_approximate / inner_product_approximate задействует индекс ANN.
Правила вызова:
- Имя функции должно точно соответствовать параметру индекса
metric_type:metric_type=l2_distance→ используйтеl2_distance_approximatemetric_type=inner_product→ используйтеinner_product_approximate
- Порядок сортировки:
- Для расстояния L2 используется сортировка по возрастанию (
ORDER BY dist ASC, меньшее значение означает большую близость). - Для скалярного произведения используется сортировка по убыванию (
ORDER BY dist DESC, большее значение означает большую близость).
- Для расстояния L2 используется сортировка по возрастанию (
SELECT id,
       l2_distance_approximate(
        embedding,
        [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]
       ) AS distance
FROM sift_1M
ORDER BY distance
LIMIT 10;
--------------

+--------+----------+
| id     | distance |
+--------+----------+
| 178811 | 210.1595 |
| 177646 | 217.0161 |
| 181997 | 218.5406 |
| 181605 | 219.2989 |
| 821938 | 221.7228 |
| 807785 | 226.7135 |
| 716433 | 227.3148 |
| 358802 | 230.7314 |
| 803100 | 230.9112 |
| 866737 | 231.6441 |
+--------+----------+
10 rows in set (0.02 sec)
Для сравнения с точными результатами используйте l2_distance / inner_product (без суффикса _approximate). В этом примере точный поиск занимает около 290 мс; при использовании индекса ANN задержка запроса уменьшается примерно с 290 мс до 20 мс.
10 rows in set (0.29 sec)
Механизм выполнения
Индекс ANN строится на уровне сегментов. В распределённой таблице:
- Каждый сегмент возвращает свои локальные результаты TopN.
- Оператор TopN объединяет результаты из разных tablet и сегментов, формируя глобальный TopN.
Использование косинусного сходства
Параметр индекса ANN в Doris metric_type сейчас поддерживает только l2_distance и inner_product и не поддерживает cosine напрямую. Если в приложении используется косинусное сходство, его можно эквивалентно заменить скалярным произведением с помощью нормализации.
Порядок действий
- Перед записью: выполните L2-нормализацию векторов (приведите их к единичной длине).
- При создании индекса: используйте
metric_type="inner_product". - При выполнении запроса: используйте
inner_product_approximate(...)с сортировкойORDER BY ... DESC.
Пример:
CREATE INDEX idx_emb_cosine ON your_table (embedding) USING ANN PROPERTIES (
  "index_type"="hnsw",
  "metric_type"="inner_product",
  "dim"="768"
);
Обоснование эквивалентности
- Формула косинусного сходства:
cos(x, y) = (x · y) / (||x|| ||y||) - Для L2-нормализованных векторов (
||x|| = ||y|| = 1):cos(x, y) = x · y
Таким образом, в пространстве единичных векторов максимизация косинусного сходства эквивалентна максимизации скалярного произведения. Без нормализации скалярное произведение и косинусное сходство уже не эквивалентны.
Приближённый поиск по диапазону
Помимо поиска ближайших соседей TopN, в векторном поиске есть ещё один распространённый тип запросов: поиск по диапазону на основе порогового расстояния. Такой запрос возвращает не фиксированное количество строк, а все точки данных, расстояние от которых до целевого вектора удовлетворяет условию.
Типичные области применения:
- В рекомендательных системах: поиск «близкого, но не идентичного» контента для повышения разнообразия.
- При обнаружении аномалий: поиск точек данных, отклоняющихся от нормальных закономерностей.
Пример: подсчёт строк, у которых расстояние L2 до целевого вектора больше 300:
SELECT count(*)
FROM   sift_1M
WHERE  l2_distance_approximate(
        embedding,
        [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2])
        > 300
--------------

+----------+
| count(*) |
+----------+
|   999271 |
+----------+
1 row in set (0.19 sec)
Индекс ANN также ускоряет поиск по диапазону: система сначала быстро отбирает множество векторов-кандидатов, а затем вычисляет точное значение приближённого расстояния, существенно сокращая накладные расходы. Сейчас поддерживаются следующие условия диапазона: >, >=, <, <=.
Комбинированный поиск
Комбинированный поиск совмещает ANN TopN и фильтрацию по диапазону в одном SQL-запросе и возвращает TopN, удовлетворяющий ограничению диапазона.
SELECT id,
       l2_distance_approximate(
        embedding, [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]) as dist
FROM sift_1M
WHERE l2_distance_approximate(
        embedding, [0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2])
        > 300
ORDER BY dist limit 10
--------------

+--------+----------+
| id     | dist     |
+--------+----------+
| 243590 |  300.005 |
| 549298 | 300.0317 |
| 429685 | 300.0533 |
| 690172 | 300.0916 |
| 123410 | 300.1333 |
| 232540 | 300.1649 |
| 547696 | 300.2066 |
| 855437 | 300.2782 |
| 589017 | 300.3048 |
| 930696 | 300.3381 |
+--------+----------+
10 rows in set (0.12 sec)
Предварительная и последующая фильтрация
| Стратегия | Смысл | Преимущества | Недостатки |
|---|---|---|---|
| Предварительная фильтрация (используется в Doris) | Сначала применить предикат, затем выбрать TopN из оставшегося множества | Высокая полнота поиска | Относительно низкая скорость |
| Последующая фильтрация | Сначала выбрать TopN, затем отфильтровать | Высокая скорость | Может значительно снизить полноту поиска |
В Doris оба этапа комбинированного поиска могут ускоряться с помощью индексов. Однако в некоторых сценариях, например при высокой селективности фильтра диапазона на первом этапе, использование индексов на обоих этапах может снизить полноту поиска. Doris адаптивно решает, использовать ли индексы на обоих этапах, исходя из селективности предиката и типа индекса.
Поиск ANN с фильтрами
Поиск ANN с фильтрами означает применение других предикатов перед выполнением ANN TopN и возврат TopN, удовлетворяющего условиям.
Следующий пример с векторами размерности 8 иллюстрирует процесс гибридного поиска:
CREATE TABLE ann_with_fulltext (
  id int NOT NULL,
  embedding array<float> NOT NULL,
  comment String NOT NULL,
  value int NULL,
  INDEX idx_comment(`comment`) USING INVERTED PROPERTIES("parser" = "english") COMMENT 'inverted index for comment',
  INDEX ann_embedding(`embedding`) USING ANN PROPERTIES("index_type"="hnsw","metric_type"="l2_distance","dim"="8")
) DUPLICATE KEY (`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES("replication_num"="1");

INSERT INTO ann_with_fulltext VALUES
(1, [0.1,0.2,0.3,0.4,0.5,0.6,0.7,0.8], 'this is about music', 10),
(2, [0.2,0.1,0.5,0.3,0.9,0.4,0.7,0.1], 'sports news today',   20),
(3, [0.9,0.8,0.7,0.6,0.5,0.4,0.3,0.2], 'latest music trend',  30),
(4, [0.05,0.06,0.07,0.08,0.09,0.1,0.2,0.3], 'politics update',40)
Для вектора запроса пользователя [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4] найдём 2 наиболее похожих документа только среди тех, у которых comment содержит «music»:
SELECT id, comment,
       l2_distance_approximate(embedding, [0.1,0.1,0.2,0.2,0.3,0.3,0.4,0.4]) AS dist
FROM ann_with_fulltext
WHERE comment MATCH_ANY 'music'       -- Filter using the inverted index first
ORDER BY dist ASC                     -- Then perform ANN TopN over the filtered result set
LIMIT 2;

+------+---------------------+----------+
| id   | comment             | dist     |
+------+---------------------+----------+
|    1 | this is about music | 0.663325 |
|    3 | latest music trend  | 1.280625 |
+------+---------------------+----------+
2 rows in set (0.04 sec)
Чтобы поиск ANN с фильтрами мог использовать векторный индекс для ускорения TopN, на столбцах, участвующих в фильтрации, должен быть вторичный индекс, например инвертированный.
Параметры запросов
Помимо параметров, задаваемых при построении индекса HNSW, поведение на этапе выполнения запроса можно настраивать с помощью переменных сеанса:
| Переменная сеанса | По умолчанию | Описание |
|---|---|---|
hnsw_ef_search | 32 | Параметр поиска EF для индекса HNSW. Управляет максимальной длиной очереди кандидатов во время поиска. Большее значение повышает точность ценой увеличения задержки. |
hnsw_check_relative_distance | true | Включает или отключает механизм проверки относительного расстояния для повышения точности поиска HNSW. |
hnsw_bounded_queue | true | Определяет, использовать ли ограниченную очередь с приоритетами для оптимизации производительности поиска HNSW. |
Квантование векторов
При кодировании FLAT индекс HNSW, включающий исходные векторы и структуру графа, может потреблять большой объём памяти. Для работы HNSW должен полностью находиться в памяти, поэтому на очень больших наборах данных это легко становится узким местом.
Doris предоставляет две категории схем квантования:
| Квантование | Принцип | Поддержка в Doris |
|---|---|---|
| Скалярное квантование (SQ) | Сжимает каждую координату FLOAT32 для уменьшения потребления памяти | sq8 (INT8), sq4 (INT4) |
| Продуктовое квантование (PQ) | Разбивает вектор высокой размерности и квантует каждый подвектор отдельно | pq |
Пример скалярного квантования (SQ)
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="sq8"    -- Use INT8 for quantization
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
В тестах на наборах данных Cohere-MEDIUM-1M и Cohere-LARGE-10M с размерностью 768 квантование SQ8 уменьшает размер индекса примерно до 1/3 от размера FLAT.
Сравнение схем квантования
| Набор данных | Размерность вектора | Схема хранения / индекса | Общий объём на диске | Данные | Индекс | Примечания |
|---|---|---|---|---|---|---|
| Cohere-MEDIUM-1M | 768D | Doris (FLAT) | 5.647 GB (2.533 + 3.114) | 2.533 GB | 3.114 GB | 1M векторов, исходные данные + индекс HNSW FLAT |
| Cohere-MEDIUM-1M | 768D | Doris SQ INT8 | 3.501 GB (2.533 + 0.992) | 2.533 GB | 0.992 GB | Симметричное квантование INT8 |
| Cohere-MEDIUM-1M | 768D | Doris PQ (pq_m=384, pq_nbits=8) | 3.149 GB (2.535 + 0.614) | 2.535 GB | 0.614 GB | Продуктовое квантование |
| Cohere-LARGE-10M | 768D | Doris (FLAT) | 56.472 GB (25.328 + 31.145) | 25.328 GB | 31.145 GB | 10M векторов |
| Cohere-LARGE-10M | 768D | Doris SQ INT8 | 35.016 GB (25.329 + 9.687) | 25.329 GB | 9.687 GB | Квантование INT8, размер индекса значительно меньше |
Продуктовое квантование (PQ)
Doris также поддерживает продуктовое квантование, но для использования PQ требуются дополнительные параметры:
pq_m: количество подвекторов, на которые разбивается исходный вектор высокой размерности. Размерность вектораdimдолжна делиться наpq_mбез остатка.pq_nbits: количество битов для квантования каждого подвектора, определяющее размер кодовой книги подпространства. В Faiss это значение обычно не должно превышать 24.
На этапе обучения квантование PQ предъявляет требования к обучающим данным: точек должно быть не меньше, чем центров кластеров. То есть количество обучающих точек n >= 2 ^ pq_nbits.
CREATE TABLE sift_1M (
  id int NOT NULL,
  embedding array<float>  NOT NULL  COMMENT "",
  INDEX ann_index (embedding) USING ANN PROPERTIES(
      "index_type"="hnsw",
      "metric_type"="l2_distance",
      "dim"="128",
      "quantizer"="pq",    -- Use PQ for quantization
      "pq_m"="2",          -- Required when using PQ. Number of low-dim sub-vectors the high-dim vector is split into
      "pq_nbits"="2"       -- Required when using PQ. Number of bits per subspace codebook
  )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
  "replication_num" = "1"
);
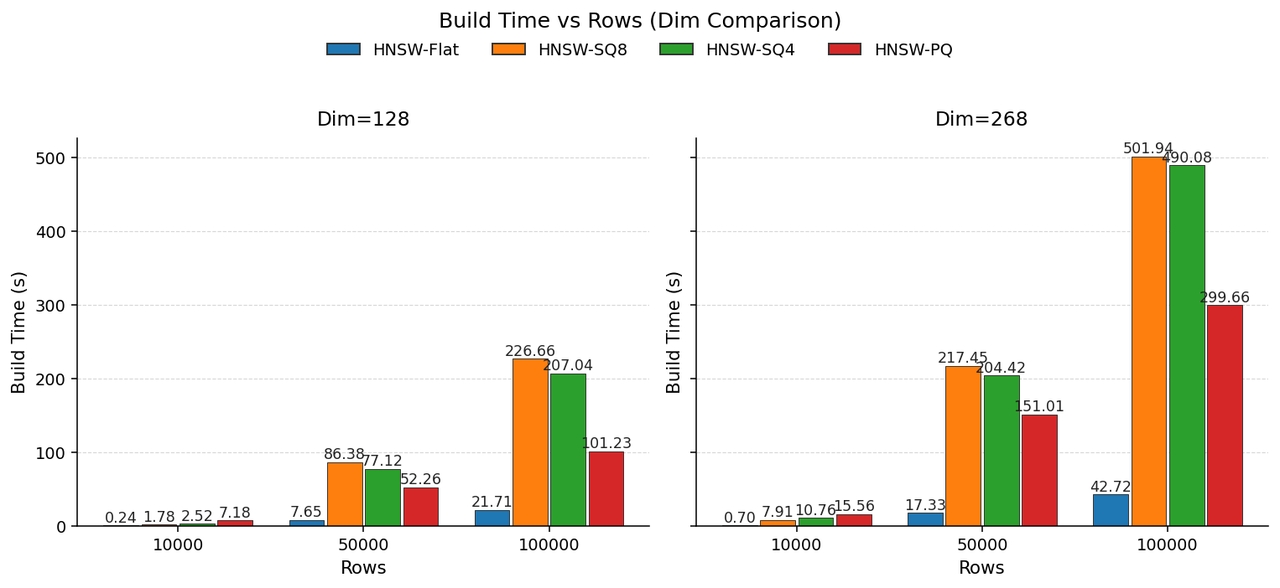
Затраты на квантование
Квантование увеличивает накладные расходы на построение индекса: на этом этапе требуется множество вычислений расстояния, и каждое вычисление должно декодировать квантованные значения. Для векторов размерности 128 время построения растёт с количеством строк, а SQ может увеличить затраты на построение примерно в 10 раз по сравнению с FLAT.
Настройка производительности
Векторный поиск представляет собой типичный сценарий точечных запросов с использованием вторичного индекса. Если вам важны высокий QPS и низкая задержка, воспользуйтесь рекомендациями ниже. После настройки на машинах FE 32C 64GB + BE 32C 64GB Doris может достигать 3000+ QPS (набор данных: Cohere-MEDIUM-1M).
Результаты тестирования производительности запросов
| Число одновременных запросов | Схема | QPS | Средняя задержка (с) | Задержка P99 (с) | Использование CPU | Полнота поиска |
|---|---|---|---|---|---|---|
| 240 | Doris | 3340.4399 | 0.071368168 | 0.163399825 | 40% | 91.00% |
| 240 | Doris SQ INT8 | 3188.6359 | 0.074728852 | 0.160370195 | 40% | 88.26% |
| 240 | Doris SQ INT4 | 2818.2291 | 0.084663868 | 0.174826815 | 43% | 80.38% |
| 240 | Doris, полный перебор | 3.6787 | 25.554878826 | 29.363227973 | 100% | 100.00% |
| 480 | Doris | 4155.7220 | 0.113387271 | 0.261086075 | 60% | 91.00% |
| 480 | Doris SQ INT8 | 3833.1130 | 0.123040214 | 0.276912867 | 50% | 88.26% |
| 480 | Doris SQ INT4 | 3431.0538 | 0.137636995 | 0.281631249 | 57% | 80.38% |
| 480 | Doris, полный перебор | 3.6787 | 25.554878826 | 29.363227973 | 100% | 100.00% |
Используйте подготовленные запросы
Распространённые модели эмбеддингов обычно выдают векторы размерности 768 или выше. Если вставить такой вектор непосредственно в SQL в виде литерала, время синтаксического разбора может превысить время самого выполнения. Поэтому рекомендуется использовать подготовленные запросы. Сейчас Doris не поддерживает выполнение этих команд напрямую через клиент mysql, поэтому требуется JDBC.
-
Включите подготовленные запросы на стороне сервера в JDBC URL.
url = jdbc:mysql://127.0.0.1:9030/demo?useServerPrepStmts=true -
Используйте подготовленный запрос.
// use `?` for placement holders, readStatement should be reused
PreparedStatement readStatement = conn.prepareStatement("SELECT id, l2_distance_approximate(embedding, cast (? as ARRAY<FLOAT>)) AS distance
    FROM sift_1M
    ORDER BY distance
    LIMIT 10");

...

readStatement.setString("[0,11,77,24,3,0,0,0,28,70,125,8,0,0,0,0,44,35,50,45,9,0,0,0,4,0,4,56,18,0,3,9,16,17,59,10,10,8,57,57,100,105,125,41,1,0,6,92,8,14,73,125,29,7,0,5,0,0,8,124,66,6,3,1,63,5,0,1,49,32,17,35,125,21,0,3,2,12,6,109,21,0,0,35,74,125,14,23,0,0,6,50,25,70,64,7,59,18,7,16,22,5,0,1,125,23,1,0,7,30,14,32,4,0,2,2,59,125,19,4,0,0,2,1,6,53,33,2]");

ResultSet resultSet = readStatement.executeQuery();
Уменьшите количество сегментов
Индекс ANN в Doris строится на уровне сегментов. Слишком большое количество сегментов создаёт дополнительные накладные расходы.
- Рекомендация: для таблиц с индексом ANN количество сегментов в каждом tablet не должно превышать 5.
- Как это сделать: настройте
write_buffer_sizeиvertical_compaction_max_segment_sizeвbe.conf, чтобы увеличить размер отдельного сегмента и уменьшить их количество. Рекомендуется установить для обоих параметров значение10737418240(10 GB).
Уменьшите количество rowset
Каждая загрузка создаёт один rowset, и слишком большое количество rowset также увеличивает накладные расходы на планирование. Используйте Stream Load или INSERT INTO SELECT для пакетной загрузки.
Держите индексы ANN в памяти
Текущий алгоритм индекса ANN работает в памяти. Если индекс запрашиваемого сегмента отсутствует в памяти, возникает дисковый ввод-вывод. Для повышения производительности держите его в памяти, задав в be.conf:
enable_segment_cache_prune=false
parallel_pipeline_task_num = 1
Запросы ANN TopN возвращают очень мало строк и не требуют высокой степени параллелизма. Используйте:
SET parallel_pipeline_task_num = 1;
enable_profile = false
Если задержка особенно критична, отключите профилирование запроса:
SET enable_profile = false;
Python SDK
В эпоху ИИ Python стал основным языком для обработки данных и разработки интеллектуальных приложений. Чтобы разработчикам было проще использовать векторный поиск Doris в Python, сообщество создало Python SDK:
- doris_vector_search: оптимизирован для поиска векторов по расстоянию. На данный момент это самый производительный Python SDK для векторного поиска Doris.
Ограничения использования
При использовании векторного индекса Doris учитывайте следующие ограничения:
-
Ограничение типа данных: столбец, на котором строится индекс ANN, должен иметь тип
NOT NULLABLEArray<Float>. При загрузке данных длина каждого вектора в этом столбце должна совпадать с размерностью, указанной в свойстве индекса (dim), иначе возникнет ошибка. -
Ограничение модели таблицы: индекс ANN можно использовать только для таблиц модели Duplicate Key или таблиц Unique Key с включённым merge-on-write (
enable_unique_key_merge_on_write = true). Поддержка таблиц Unique Key добавлена в версии 4.1.4. Таблицы Unique Key с merge-on-read и таблицы Aggregate Key по-прежнему не поддерживаются; попытка создать для них индекс вызывает ошибку:ANN index can only be used in DUP_KEYS table or UNIQUE_KEYS table with merge-on-write enabled. -
Столбцы предикатов должны иметь вторичный индекс: Doris использует семантику предварительной фильтрации: предикаты вычисляются до AnnTopN. Если столбцы, на которые ссылаются предикаты в SQL, не имеют вторичного индекса, Doris переходит к вычислению полным перебором, чтобы обеспечить корректность. Например:
SELECT id, l2_distance_approximate(embedding, [xxx]) AS distance
    FROM sift_1M
    WHERE round(id) > 100
    ORDER BY distance limit 10;
Хотя
idявляется первичным ключом, на этом столбце не построен вторичный индекс, например инвертированный, позволяющий точно определять номера строк. Такие предикаты вычисляются после анализа индексов. Чтобы сохранить семантику предварительной фильтрации ANN TopN, система переходит к вычислению полным перебором. -
Функция расстояния должна соответствовать типу метрики: если функция расстояния в SQL не соответствует
metric_typeиндекса, определённого в DDL, Doris не сможет использовать индекс ANN для вычисления TopN, даже при использованииl2_distance_approximate/inner_product_approximate. -
Для
inner_productтребуется сортировка DESC: когдаmetric_typeимеет значениеinner_product, индекс ANN может ускорять только запросы видаORDER BY inner_product_approximate() DESC LIMIT N(DESCнельзя опускать). -
Порядок аргументов функции: функция
xxx_approximate()запускает анализ индексов, только если первый аргумент имеет типColumnArray, а второй являетсяCASTилиArrayLiteral. Перестановка аргументов приводит к переходу на поиск полным перебором.
Часто задаваемые вопросы
Q1: Какие метрики расстояния поддерживает индекс ANN в Doris?
Сейчас поддерживаются l2_distance (евклидово расстояние) и inner_product. О косинусном сходстве см. раздел Использование косинусного сходства.
Q2: Почему мой запрос ANN не использует индекс?
Возможные причины:
- Функция расстояния не соответствует
metric_type. - При использовании
inner_productне указана сортировкаORDER BY ... DESC. - Аргументы функции указаны в обратном порядке (
ColumnArrayдолжен быть первым аргументом). - На столбцах фильтрации нет вторичного индекса, например инвертированного, что приводит к переходу на полный перебор.
Q3: Как выбрать между HNSW, IVF и IVF On-Disk?
| Индекс | Потребление памяти | Производительность запросов | Сценарии применения |
|---|---|---|---|
| HNSW | Высокое (должен полностью находиться в памяти) | Высокая | Небольшие и средние объёмы данных, строгие требования к низкой задержке |
| IVF | Среднее | Средняя | Большие объёмы данных |
| IVF On-Disk | Низкое (диск + кэш) | Средняя | Очень большие объёмы данных, ограниченная память |
Q4: Что делать, если памяти недостаточно?
Уменьшите потребление памяти с помощью квантования:
- Сначала попробуйте
sq8(скалярное квантование INT8). Обычно оно уменьшает индекс примерно до 1/3 исходного размера с небольшим влиянием на полноту поиска. - При очень жёстких ограничениях памяти используйте
sq4илиpq, но полнота поиска несколько снизится.
Q5: Как совместить фильтрацию по ключевым словам с векторным поиском?
Постройте инвертированный индекс на столбцах фильтрации, а затем используйте запрос ANN с условием WHERE. См. раздел Поиск ANN с фильтрами.
Q6: Как повысить QPS?
См. раздел Настройка производительности. Основные рекомендации:
- Используйте подготовленные запросы, чтобы избежать накладных расходов на синтаксический разбор SQL.
- Уменьшите количество сегментов и rowset.
- Держите индекс ANN в памяти.
parallel_pipeline_task_num = 1.- Отключите профилирование запроса.