Оптимизация загрузки при высокой параллельности (Group Commit)
При частой записи небольшими пакетами традиционные способы загрузки имеют следующие недостатки:
- Каждая загрузка создаёт отдельную транзакцию, для которой FE должен выполнить разбор SQL и построить план выполнения. Это снижает общую производительность.
- Каждая загрузка создаёт новую версию, из-за чего число версий быстро растёт и увеличивается нагрузка на фоновую Compaction.
Для решения этих проблем в Doris предусмотрен механизм Group Commit. Group Commit представляет собой оптимизацию существующих способов загрузки и в первую очередь предназначен для:
- Оператора
INSERT INTO tbl VALUES(...) - Stream Load
Объединяя несколько небольших загрузок в одну крупную транзакцию, фиксируемую в фоновом режиме, Group Commit значительно повышает производительность параллельной записи небольшими пакетами. Совместное использование Group Commit и PreparedStatement позволяет добиться ещё большего прироста производительности.
Сценарии применения и выбор режима
| Сценарий | Рекомендуемый режим | Описание |
|---|---|---|
| Высокопараллельная запись с требованием немедленной видимости данных | sync_mode | Несколько загрузок объединяются в одну транзакцию, и вызов завершается после её фиксации. |
| Частая запись с жёсткими требованиями к задержке | async_mode | Данные сначала записываются в WAL, после чего вызов немедленно завершается; фиксация выполняется асинхронно в фоновом режиме. |
| Group Commit не требуется | off_mode | Отключает Group Commit и использует обычный механизм загрузки. |
Режимы Group Commit
Запись с использованием Group Commit поддерживает три режима:
-
Отключённый режим (
off_mode)Отключает Group Commit.
-
Синхронный режим (
sync_mode)Doris объединяет несколько загрузок в одну транзакцию с учётом нагрузки и свойства таблицы
group_commit_interval. Каждая загрузка завершается после фиксации транзакции. Этот режим подходит для высокопараллельной записи, когда данные должны быть видны сразу после завершения загрузки. -
Асинхронный режим (
async_mode)Doris сначала записывает данные в WAL (
Write Ahead Log), после чего загрузка немедленно завершается. Затем Doris асинхронно фиксирует данные с учётом нагрузки и свойства таблицыgroup_commit_interval. Данные становятся видимыми после фиксации. Чтобы WAL не занимал слишком много места на диске, при большом объёме данных в одной загрузке Doris автоматически переключается наsync_mode. Этот режим подходит для частой записи с жёсткими требованиями к задержке.Количество файлов WAL можно проверить через HTTP-интерфейс FE; подробности см. здесь. Также можно найти ключевое слово
walв метриках BE.
Быстрый старт
Во всех следующих примерах используется такая схема таблицы:
CREATE TABLE `dt` (
    `id` int(11) NOT NULL,
    `name` varchar(50) NULL,
    `score` int(11) NULL
) ENGINE=OLAP
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);
Настройка свойств таблицы
Свойство таблицы group_commit_mode поддерживается начиная с версии 4.1.0.
На уровне таблицы можно задать режим Group Commit по умолчанию. Если в Stream Load не указан HTTP-заголовок group_commit, используется режим из свойства таблицы.
1. Настройка при создании таблицы:
CREATE TABLE `dt` (
    `id` int(11) NOT NULL,
    `name` varchar(50) NULL,
    `score` int(11) NULL
) ENGINE=OLAP
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "group_commit_mode" = "async_mode"
);
2. Изменение свойства таблицы:
# Change to sync mode
ALTER TABLE dt SET ("group_commit_mode" = "sync_mode");

# Disable Group Commit
ALTER TABLE dt SET ("group_commit_mode" = "off_mode");
3. Просмотр свойства таблицы:
SHOW CREATE TABLE отображает свойство group_commit_mode, если его значение отличается от off_mode:
mysql> SHOW CREATE TABLE dt;
+-------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| Table | Create Table                                                                                                                                                                                                       |
+-------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
| dt    | CREATE TABLE `dt` (
  `id` int(11) NOT NULL,
  `name` varchar(50) NULL,
  `score` int(11) NULL
) ENGINE=OLAP
DUPLICATE KEY(`id`)
DISTRIBUTED BY HASH(`id`) BUCKETS 1
PROPERTIES (
    "group_commit_mode" = "async_mode"
) |
+-------+----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------+
1 row in set (0.00 sec)
4. Приоритет:
| Способ загрузки | Приоритет (от высокого к низкому) |
|---|---|
| Stream Load | HTTP-заголовок group_commit > свойство таблицы group_commit_mode |
| INSERT INTO VALUES | Переменная сеанса group_commit > свойство таблицы group_commit_mode |
Использование
INSERT INTO VALUES
Включите Group Commit, задав переменную сеанса group_commit. Переменная сеанса имеет приоритет перед свойством таблицы.
Асинхронный режим:
# Set the session variable to enable group commit (default is off_mode), using async mode
mysql> set group_commit = async_mode;

# The returned label starts with group_commit, which tells you that group commit is in use
mysql> insert into dt values(1, 'Bob', 90), (2, 'Alice', 99);
Query OK, 2 rows affected (0.05 sec)
{'label':'group_commit_a145ce07f1c972fc-bd2c54597052a9ad', 'status':'PREPARE', 'txnId':'181508'}

# This label and txn_id match the previous one, indicating that the inserts are batched into the same load task
mysql> insert into dt(id, name) values(3, 'John');
Query OK, 1 row affected (0.01 sec)
{'label':'group_commit_a145ce07f1c972fc-bd2c54597052a9ad', 'status':'PREPARE', 'txnId':'181508'}

# The data is not immediately queryable
mysql> select * from dt;
Empty set (0.01 sec)

# After 10 seconds, the data is queryable. The data visibility delay is controlled by the table property group_commit_interval.
mysql> select * from dt;
+------+-------+-------+
| id   | name  | score |
+------+-------+-------+
|    1 | Bob   |    90 |
|    2 | Alice |    99 |
|    3 | John  |  NULL |
+------+-------+-------+
3 rows in set (0.02 sec)
Синхронный режим:
# Set the session variable to enable group commit (default is off_mode), using sync mode
mysql> set group_commit = sync_mode;

# The returned label starts with group_commit, which tells you that group commit is in use. The load takes at least the value of the table property group_commit_interval.
mysql> insert into dt values(4, 'Bob', 90), (5, 'Alice', 99);
Query OK, 2 rows affected (10.06 sec)
{'label':'group_commit_d84ab96c09b60587_ec455a33cb0e9e87', 'status':'PREPARE', 'txnId':'3007', 'query_id':'fc6b94085d704a94-a69bfc9a202e66e2'}

# The data is queryable immediately
mysql> select * from dt;
+------+-------+-------+
| id   | name  | score |
+------+-------+-------+
|    1 | Bob   |    90 |
|    2 | Alice |    99 |
|    3 | John  |  NULL |
|    4 | Bob   |    90 |
|    5 | Alice |    99 |
+------+-------+-------+
5 rows in set (0.03 sec)
Отключённый режим:
mysql> set group_commit = off_mode;
Использование JDBC (PreparedStatement)
При записи данных через JDBC с помощью insert into values Doris поддерживает механизм PreparedStatement протокола MySQL на стороне FE, чтобы снизить затраты на разбор SQL и построение плана. При использовании PreparedStatement SQL и план загрузки сохраняются в кэше памяти на уровне сеанса. Последующие загрузки используют сохранённый объект напрямую, что снижает загрузку CPU на FE.
1. Задайте URL JDBC и включите PreparedStatement на стороне сервера:
url = jdbc:mysql://127.0.0.1:9030/db?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=500
2. Задайте переменную сеанса group_commit одним из двух способов:
-
Через URL JDBC, добавив
sessionVariables=group_commit=async_mode:url = jdbc:mysql://127.0.0.1:9030/db?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=500&sessionVariables=group_commit=async_mode,enable_nereids_planner=false -
Выполнив оператор SQL:
try (Statement statement = conn.createStatement()) {
    statement.execute("SET group_commit = async_mode;");
}
3. Используйте PreparedStatement для пакетной записи:
private static final String JDBC_DRIVER = "com.mysql.jdbc.Driver";
private static final String URL_PATTERN = "jdbc:mysql://%s:%d/%s?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=50&sessionVariables=group_commit=async_mode";
private static final String HOST = "127.0.0.1";
private static final int PORT = 9030;
private static final String DB = "db";
private static final String TBL = "dt";
private static final String USER = "root";
private static final String PASSWD = "";
private static final int INSERT_BATCH_SIZE = 10;

private static void groupCommitInsertBatch() throws Exception {
    Class.forName(JDBC_DRIVER);
    // add rewriteBatchedStatements=true and cachePrepStmts=true in JDBC url
    // set session variables by sessionVariables=group_commit=async_mode in JDBC url
    try (Connection conn = DriverManager.getConnection(
            String.format(URL_PATTERN, HOST, PORT, DB), USER, PASSWD)) {

        String query = "insert into " + TBL + " values(?, ?, ?)";
        try (PreparedStatement stmt = conn.prepareStatement(query)) {
            for (int j = 0; j < 5; j++) {
                // 10 rows per insert
                for (int i = 0; i < INSERT_BATCH_SIZE; i++) {
                    stmt.setInt(1, i);
                    stmt.setString(2, "name" + i);
                    stmt.setInt(3, i + 10);
                    stmt.addBatch();
                }
                int[] result = stmt.executeBatch();
            }
        }
    } catch (Exception e) {
        e.printStackTrace();
    }
}
Частое выполнение операторов INSERT INTO создаёт большой объём записей в журнале аудита, что влияет на итоговую производительность. Поэтому аудит подготовленных запросов по умолчанию отключён. Управлять записью подготовленных запросов в журнал аудита можно с помощью переменной сеанса.
# Set the session variable to enable audit logging for prepared statements. The default value is false, which disables audit logging for prepared statements.
set enable_prepared_stmt_audit_log=true;
Подробнее об использовании JDBC см. в разделе Синхронизация данных с помощью INSERT.
Пакетная запись с помощью клиента Golang
В Golang поддержка подготовленных запросов ограничена, поэтому для повышения производительности Group Commit можно вручную объединять данные в пакеты на стороне клиента. Ниже приведён пример программы:
package main

import (
	"database/sql"
	"fmt"
	"math/rand"
	"strings"
	"sync"
	"sync/atomic"
	"time"

	_ "github.com/go-sql-driver/mysql"
)

const (
	host     = "127.0.0.1"
	port     = 9030
	db       = "test"
	user     = "root"
	password = ""
	table    = "async_lineitem"
)

var (
	threadCount = 20
	batchSize   = 100
)

var totalInsertedRows int64
var rowsInsertedLastSecond int64

func main() {
	dbDSN := fmt.Sprintf("%s:%s@tcp(%s:%d)/%s?parseTime=true", user, password, host, port, db)
	db, err := sql.Open("mysql", dbDSN)
	if err != nil {
		fmt.Printf("Error opening database: %s\n", err)
		return
	}
	defer db.Close()

	var wg sync.WaitGroup
	for i := 0; i < threadCount; i++ {
		wg.Add(1)
		go func() {
			defer wg.Done()
			groupCommitInsertBatch(db)
		}()
	}

	go logInsertStatistics()

	wg.Wait()
}

func groupCommitInsertBatch(db *sql.DB) {
	for {
		valueStrings := make([]string, 0, batchSize)
		valueArgs := make([]interface{}, 0, batchSize*16)
		for i := 0; i < batchSize; i++ {
		    valueStrings = append(valueStrings, "(?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?, ?)")
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, rand.Intn(1000))
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, sql.NullFloat64{Float64: 1.0, Valid: true})
			valueArgs = append(valueArgs, "N")
			valueArgs = append(valueArgs, "O")
			valueArgs = append(valueArgs, time.Now())
			valueArgs = append(valueArgs, time.Now())
			valueArgs = append(valueArgs, time.Now())
			valueArgs = append(valueArgs, "DELIVER IN PERSON")
			valueArgs = append(valueArgs, "SHIP")
			valueArgs = append(valueArgs, "N/A")
		}
		stmt := fmt.Sprintf("INSERT INTO %s VALUES %s",
			table, strings.Join(valueStrings, ","))
		_, err := db.Exec(stmt, valueArgs...)
		if err != nil {
			fmt.Printf("Error executing batch: %s\n", err)
			return
		}
		atomic.AddInt64(&rowsInsertedLastSecond, int64(batchSize))
		atomic.AddInt64(&totalInsertedRows, int64(batchSize))
	}
}

func logInsertStatistics() {
	for {
		time.Sleep(1 * time.Second)
		fmt.Printf("Total inserted rows: %d\n", totalInsertedRows)
		fmt.Printf("Rows inserted in the last second: %d\n", rowsInsertedLastSecond)
		rowsInsertedLastSecond = 0
	}
}
Stream Load
При загрузке данных через Stream Load можно включить Group Commit, задав параметр group_commit в HTTP-заголовке.
Если заголовок group_commit не указан, а в свойствах таблицы задан group_commit_mode, автоматически используется режим из свойства таблицы.
Предположим, что файл data.csv содержит:
6,Amy,60
7,Ross,98
Асинхронный режим:
# Add the "group_commit:async_mode" header during load

curl --location-trusted -u {user}:{passwd} -T data.csv -H "group_commit:async_mode"  -H "column_separator:,"  http://{fe_host}:{http_port}/api/db/dt/_stream_load
{
    "TxnId": 7009,
    "Label": "group_commit_c84d2099208436ab_96e33fda01eddba8",
    "Comment": "",
    "GroupCommit": true,
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 2,
    "NumberLoadedRows": 2,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 19,
    "LoadTimeMs": 35,
    "StreamLoadPutTimeMs": 5,
    "ReadDataTimeMs": 0,
    "WriteDataTimeMs": 26
}

# The returned GroupCommit is true, which means the load entered the group commit path
# The returned Label starts with group_commit and is the label associated with the load that actually consumes the data
Синхронный режим:
# Add the "group_commit:sync_mode" header during load

curl --location-trusted -u {user}:{passwd} -T data.csv -H "group_commit:sync_mode"  -H "column_separator:,"  http://{fe_host}:{http_port}/api/db/dt/_stream_load
{
    "TxnId": 3009,
    "Label": "group_commit_d941bf17f6efcc80_ccf4afdde9881293",
    "Comment": "",
    "GroupCommit": true,
    "Status": "Success",
    "Message": "OK",
    "NumberTotalRows": 2,
    "NumberLoadedRows": 2,
    "NumberFilteredRows": 0,
    "NumberUnselectedRows": 0,
    "LoadBytes": 19,
    "LoadTimeMs": 10044,
    "StreamLoadPutTimeMs": 4,
    "ReadDataTimeMs": 0,
    "WriteDataTimeMs": 10038
}

# The returned GroupCommit is true, which means the load entered the group commit path
# The returned Label starts with group_commit and is the label associated with the load that actually consumes the data
Подробнее о синтаксисе Stream Load и рекомендациях по использованию см. в разделе Stream Load.
Условия автоматической фиксации
Данные фиксируются автоматически при выполнении любого из двух условий: истечении заданного интервала времени (по умолчанию 10 секунд) или достижении заданного объёма данных (по умолчанию 64 MB). Эти параметры работают совместно; настраивайте их с учётом конкретного сценария.
Настройка интервала фиксации
По умолчанию интервал фиксации составляет 10 секунд. Его можно изменить в настройках таблицы:
# Change the commit interval to 2 seconds
ALTER TABLE dt SET ("group_commit_interval_ms" = "2000");
Рекомендации по настройке:
| Пример значения | Преимущества | Недостатки |
|---|---|---|
| Короткий интервал (например, 2 секунды) | Меньшая задержка видимости данных; подходит для сценариев с более строгими требованиями к доступности данных в реальном времени | Более частые фиксации, ускоренный рост числа версий и повышенная нагрузка на фоновую Compaction |
| Длинный интервал (например, 30 секунд) | Более крупные пакеты при фиксации, замедленный рост числа версий, меньшие накладные расходы системы | Более высокая задержка видимости данных |
Выбирайте значение с учётом допустимой для ваших задач задержки видимости данных. При высокой нагрузке на систему интервал можно увеличить.
Настройка объёма данных для фиксации
По умолчанию объём данных для фиксации Group Commit составляет 64 MB. Его можно изменить в настройках таблицы:
# Change the commit data size to 128MB
ALTER TABLE dt SET ("group_commit_data_bytes" = "134217728");
Рекомендации по настройке:
| Пример значения | Преимущества | Недостатки |
|---|---|---|
| Меньший порог (например, 32 MB) | Меньшее потребление памяти; подходит для сред с ограниченными ресурсами | Меньшие пакеты при фиксации; пропускная способность может быть ограничена |
| Больший порог (например, 256 MB) | Более эффективная пакетная фиксация и более высокая пропускная способность системы | Повышенное потребление памяти |
Выбирайте значение, учитывая доступную память и требования к надёжности данных. Если памяти достаточно и требуется более высокая пропускная способность, значение можно увеличить до 128 MB или больше.
Связанные системные настройки
Настройки BE
group_commit_wal_path
-
Описание: каталог, в котором Group Commit хранит файлы WAL.
-
Значение по умолчанию: каталог с именем
walсоздаётся в каждом каталоге, указанном вstorage_root_path. Пример настройки:group_commit_wal_path=/data1/storage/wal;/data2/storage/wal;/data3/storage/wal
Перенаправление Stream Load в режиме с разделением вычислений и хранения
В режиме с разделением вычислений и хранения балансировщик нагрузки может случайным образом распределять запросы Stream Load. В результате запросы к одной таблице попадают на разные узлы BE, и Group Commit не может эффективно объединять их в пакеты. Если перенаправление на BE включено, узел BE, получивший запрос, перенаправляет его на целевой BE для этой таблицы. Таким образом, все запросы к одной таблице поступают на один BE.
| Параметр | Расположение | По умолчанию | Описание |
|---|---|---|---|
enable_group_commit_streamload_be_forward | FE | false | Включать ли перенаправление Stream Load на BE. Действует только в режиме с разделением вычислений и хранения, если запрос использует Group Commit |
enable_group_commit_streamload_be_forward | BE | false | Разрешены ли запросы к конечной точке BE /api/{db}/{table}/_stream_load_forward. Добавлено в Doris 4.0.8 для серии 4.0 и в Doris 4.1.4 для серии 4.1 |
Параметр должен иметь значение true как на FE, так и на BE.
Начиная с Doris 4.0.8 в серии 4.0 и Doris 4.1.4 в серии 4.1, для конечной точки BE _stream_load_forward действуют два ограничения:
- Доступ к конечной точке регулируется параметром BE
enable_group_commit_streamload_be_forward. Если его значение равноfalse(по умолчанию), запросы возвращают403 Forbiddenс сообщениемStream load forward is disabled. - После включения параметра запросы к конечной точке также должны проходить аутентификацию, а учётная запись должна обладать глобальной привилегией
LOAD.
Если до обновления функция была включена только на FE, после обновления перенаправление перестанет работать. Добавьте enable_group_commit_streamload_be_forward=true в каждый be.conf и убедитесь, что учётная запись для загрузки обладает привилегией LOAD.
Перенаправление на Follower FE
Поддерживается начиная с версии 4.1.4.
Помимо описанного выше перенаправления на BE, FE может поочерёдно перенаправлять запросы Stream Load с Group Commit на Follower FE, распределяя нагрузку по объединению запросов в пакеты между несколькими FE.
| Параметр | Расположение | По умолчанию | Описание |
|---|---|---|---|
enable_forward_group_commit_stream_load_to_follower | FE | false | Перенаправлять ли запросы Stream Load с Group Commit поочерёдно на Follower FE |
Примечание: это перенаправление не поддерживается, если для целевой таблицы свойство light_schema_change имеет значение false; такие запросы завершаются ошибкой.
Ограничение количества WAL
Поддерживается начиная с версии 4.1.4.
Group Commit в режиме async_mode сначала записывает данные в WAL, а затем асинхронно воспроизводит их. Если воспроизведение WAL постоянно завершается ошибкой, файлы WAL накапливаются и могут заполнить диск. Начиная с версии 4.1.4, параметр BE group_commit_max_wal_num_per_table ограничивает количество файлов WAL для одной таблицы.
| Параметр | Расположение | По умолчанию | Описание |
|---|---|---|---|
group_commit_max_wal_num_per_table | BE | 10 | Максимальное допустимое количество файлов WAL Group Commit для одной таблицы. 0 означает отсутствие ограничения. Поддерживает динамическое изменение |
При превышении ограничения загрузки Group Commit в режиме async_mode для этой таблицы отклоняются с ошибкой EXCEEDED_LIMIT, например:
Too many group commit async WALs for table <table_name>
Эта ошибка означает, что при воспроизведении WAL возникла проблема, например изменение схемы или сбой диска. Найдите причину и восстановите воспроизведение WAL, вместо того чтобы просто повышать ограничение.
Ограничения
Сценарии отказа от Group Commit
| Способ загрузки | Условия перехода к загрузке без Group Commit |
|---|---|
INSERT INTO VALUES | Использование транзакционной записи (Begin; INSERT INTO VALUES; COMMIT)Указание метки ( INSERT INTO dt WITH LABEL {label} VALUES)Наличие выражения в VALUES ( INSERT INTO dt VALUES (1 + 100))Запись с обновлением отдельных столбцов Таблицы, не поддерживающие облегчённое изменение схемы |
Stream Load | Использование двухфазной фиксации Указание метки ( -H "label:my_label")Запись с обновлением отдельных столбцов Таблицы, не поддерживающие облегчённое изменение схемы |
Модель Unique
- Group Commit не гарантирует порядок фиксации. Для обеспечения согласованности данных используйте столбец Sequence.
Ограничения WAL
Начиная с 4.1.5, при воспроизведении WAL неполное поле длины или неполные данные в конце файла трактуются как конец файла. Полный блок данных всё ещё можно воспроизвести, даже если завершающее поле контрольной суммы было записано не полностью. Незавершённая запись в конце файла не восстанавливается как полная запись. При отсутствии или повреждении файлов WAL целостность данных по-прежнему не гарантируется.
async_modeзаписывает данные в WAL, удаляет его при успешной загрузке и восстанавливает данные из WAL при сбое.- Файлы WAL хранятся в единственной реплике. Если соответствующий диск повреждён или файл случайно удалён, данные могут быть потеряны.
- При выводе узла BE из эксплуатации используйте команду
DECOMMISSION, чтобы предотвратить потерю данных. async_modeавтоматически переключается наsync_modeв следующих случаях:- Объём данных в одной загрузке слишком велик (превышает 80% ёмкости одного каталога WAL)
- Stream Load с передачей по частям и неизвестным объёмом данных
- Недостаточно свободного места на диске
- Во время тяжёлого Schema Change записи Group Commit отклоняются, и клиент должен повторить попытку.
Производительность
Производительность записи с group commit (в режиме async_mode) при большом числе параллельных загрузок небольшого объёма проверялась с использованием Stream Load и JDBC.
Тестирование загрузки журналов через Stream Load
Конфигурация оборудования:
- 1 FE: Alibaba Cloud, CPU с 8 ядрами, 16 GB памяти, 1 x 100 GB облачный диск ESSD PL1
- 3 BE: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 1 TB облачный диск ESSD PL1
- 1 тестовый клиент: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 100 GB облачный диск ESSD PL1
- Тестируемая версия: Doris-3.0.1
Набор данных:
- Набор данных
httplogs, всего 31 GB и 247 миллионов строк
Инструмент тестирования:
Методика тестирования:
- Сравнение режима
non-group_commitи режимаgroup_commitasync_modeпри разных объёмах данных на поток и разном числе параллельных потоков с загрузкой247249096строк.
Результаты тестирования:
| Способ загрузки | Объём данных на поток | Число параллельных потоков | Время (секунды) | Скорость загрузки (строк/секунду) | Пропускная способность загрузки (MB/секунду) |
|---|---|---|---|---|---|
group_commit | 10 KB | 10 | 2204 | 112,181 | 14.8 |
group_commit | 10 KB | 30 | 2176 | 113,625 | 15.0 |
group_commit | 100 KB | 10 | 283 | 873,671 | 115.1 |
group_commit | 100 KB | 30 | 244 | 1,013,315 | 133.5 |
group_commit | 500 KB | 10 | 125 | 1,977,992 | 260.6 |
group_commit | 500 KB | 30 | 122 | 2,026,631 | 267.1 |
group_commit | 1 MB | 10 | 119 | 2,077,723 | 273.8 |
group_commit | 1 MB | 30 | 119 | 2,077,723 | 273.8 |
group_commit | 10 MB | 10 | 118 | 2,095,331 | 276.1 |
non-group_commit | 1 MB | 10 | 1883 | 131,305 | 17.3 |
non-group_commit | 10 MB | 10 | 294 | 840,983 | 105.4 |
non-group_commit | 10 MB | 30 | 118 | 2,095,331 | 276.1 |
В приведённых выше тестах group_commit загрузка CPU на BE остаётся в пределах от 10% до 40%.
Результаты показывают, что режим group_commit эффективно повышает производительность параллельной загрузки небольших объёмов данных, одновременно сокращая число версий и снижая нагрузку на фоновое слияние данных.
JDBC
Конфигурация оборудования:
- 1 FE: Alibaba Cloud, CPU с 8 ядрами, 16 GB памяти, 1 x 100 GB облачный диск ESSD PL1
- 1 BE: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 500 GB облачный диск ESSD PL1
- 1 тестовый клиент: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 100 GB облачный диск ESSD PL1
- Тестируемая версия: Doris-3.0.1
- Для повышения производительности аудит подготовленных запросов отключён
Набор данных:
- Набор данных таблицы
lineitemиз TPC-H sf10, 30 файлов, всего около 22 GB и 180 миллионов строк
Инструмент тестирования:
Методика тестирования:
- Запись данных через
txtfilereaderвmysqlwriterпри разном числе параллельных потоков и разном количестве строк на одинINSERT.
Результаты тестирования:
| Строк на вставку | Число параллельных потоков | Скорость загрузки (строк/секунду) | Пропускная способность загрузки (MB/секунду) |
|---|---|---|---|
| 100 | 10 | 160,758 | 17.21 |
| 100 | 20 | 210,476 | 22.19 |
| 100 | 30 | 214,323 | 22.92 |
В приведённых выше тестах загрузка CPU на FE составляет около 60-70%, а на BE — около 10-20%.
Синхронный режим INSERT INTO, небольшие пакеты
Конфигурация оборудования:
- 1 FE: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 500 GB облачный диск ESSD PL1
- 5 BE: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 1 TB облачный диск ESSD PL1
- 1 тестовый клиент: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 100 GB облачный диск ESSD PL1
- Тестируемая версия: Doris-3.0.1
Набор данных:
-
Набор данных таблицы
lineitemиз TPC-H sf10. -
Оператор CREATE TABLE:
CREATE TABLE IF NOT EXISTS lineitem (
  L_ORDERKEY    INTEGER NOT NULL,
  L_PARTKEY     INTEGER NOT NULL,
  L_SUPPKEY     INTEGER NOT NULL,
  L_LINENUMBER  INTEGER NOT NULL,
  L_QUANTITY    DECIMAL(15,2) NOT NULL,
  L_EXTENDEDPRICE  DECIMAL(15,2) NOT NULL,
  L_DISCOUNT    DECIMAL(15,2) NOT NULL,
  L_TAX         DECIMAL(15,2) NOT NULL,
  L_RETURNFLAG  CHAR(1) NOT NULL,
  L_LINESTATUS  CHAR(1) NOT NULL,
  L_SHIPDATE    DATE NOT NULL,
  L_COMMITDATE  DATE NOT NULL,
  L_RECEIPTDATE DATE NOT NULL,
  L_SHIPINSTRUCT CHAR(25) NOT NULL,
  L_SHIPMODE     CHAR(10) NOT NULL,
  L_COMMENT      VARCHAR(44) NOT NULL
)
DUPLICATE KEY(L_ORDERKEY, L_PARTKEY, L_SUPPKEY, L_LINENUMBER)
DISTRIBUTED BY HASH(L_ORDERKEY) BUCKETS 32
PROPERTIES (
  "replication_num" = "3"
);
Инструмент тестирования:
Параметры Jmeter, которые нужно настроить, показаны ниже:
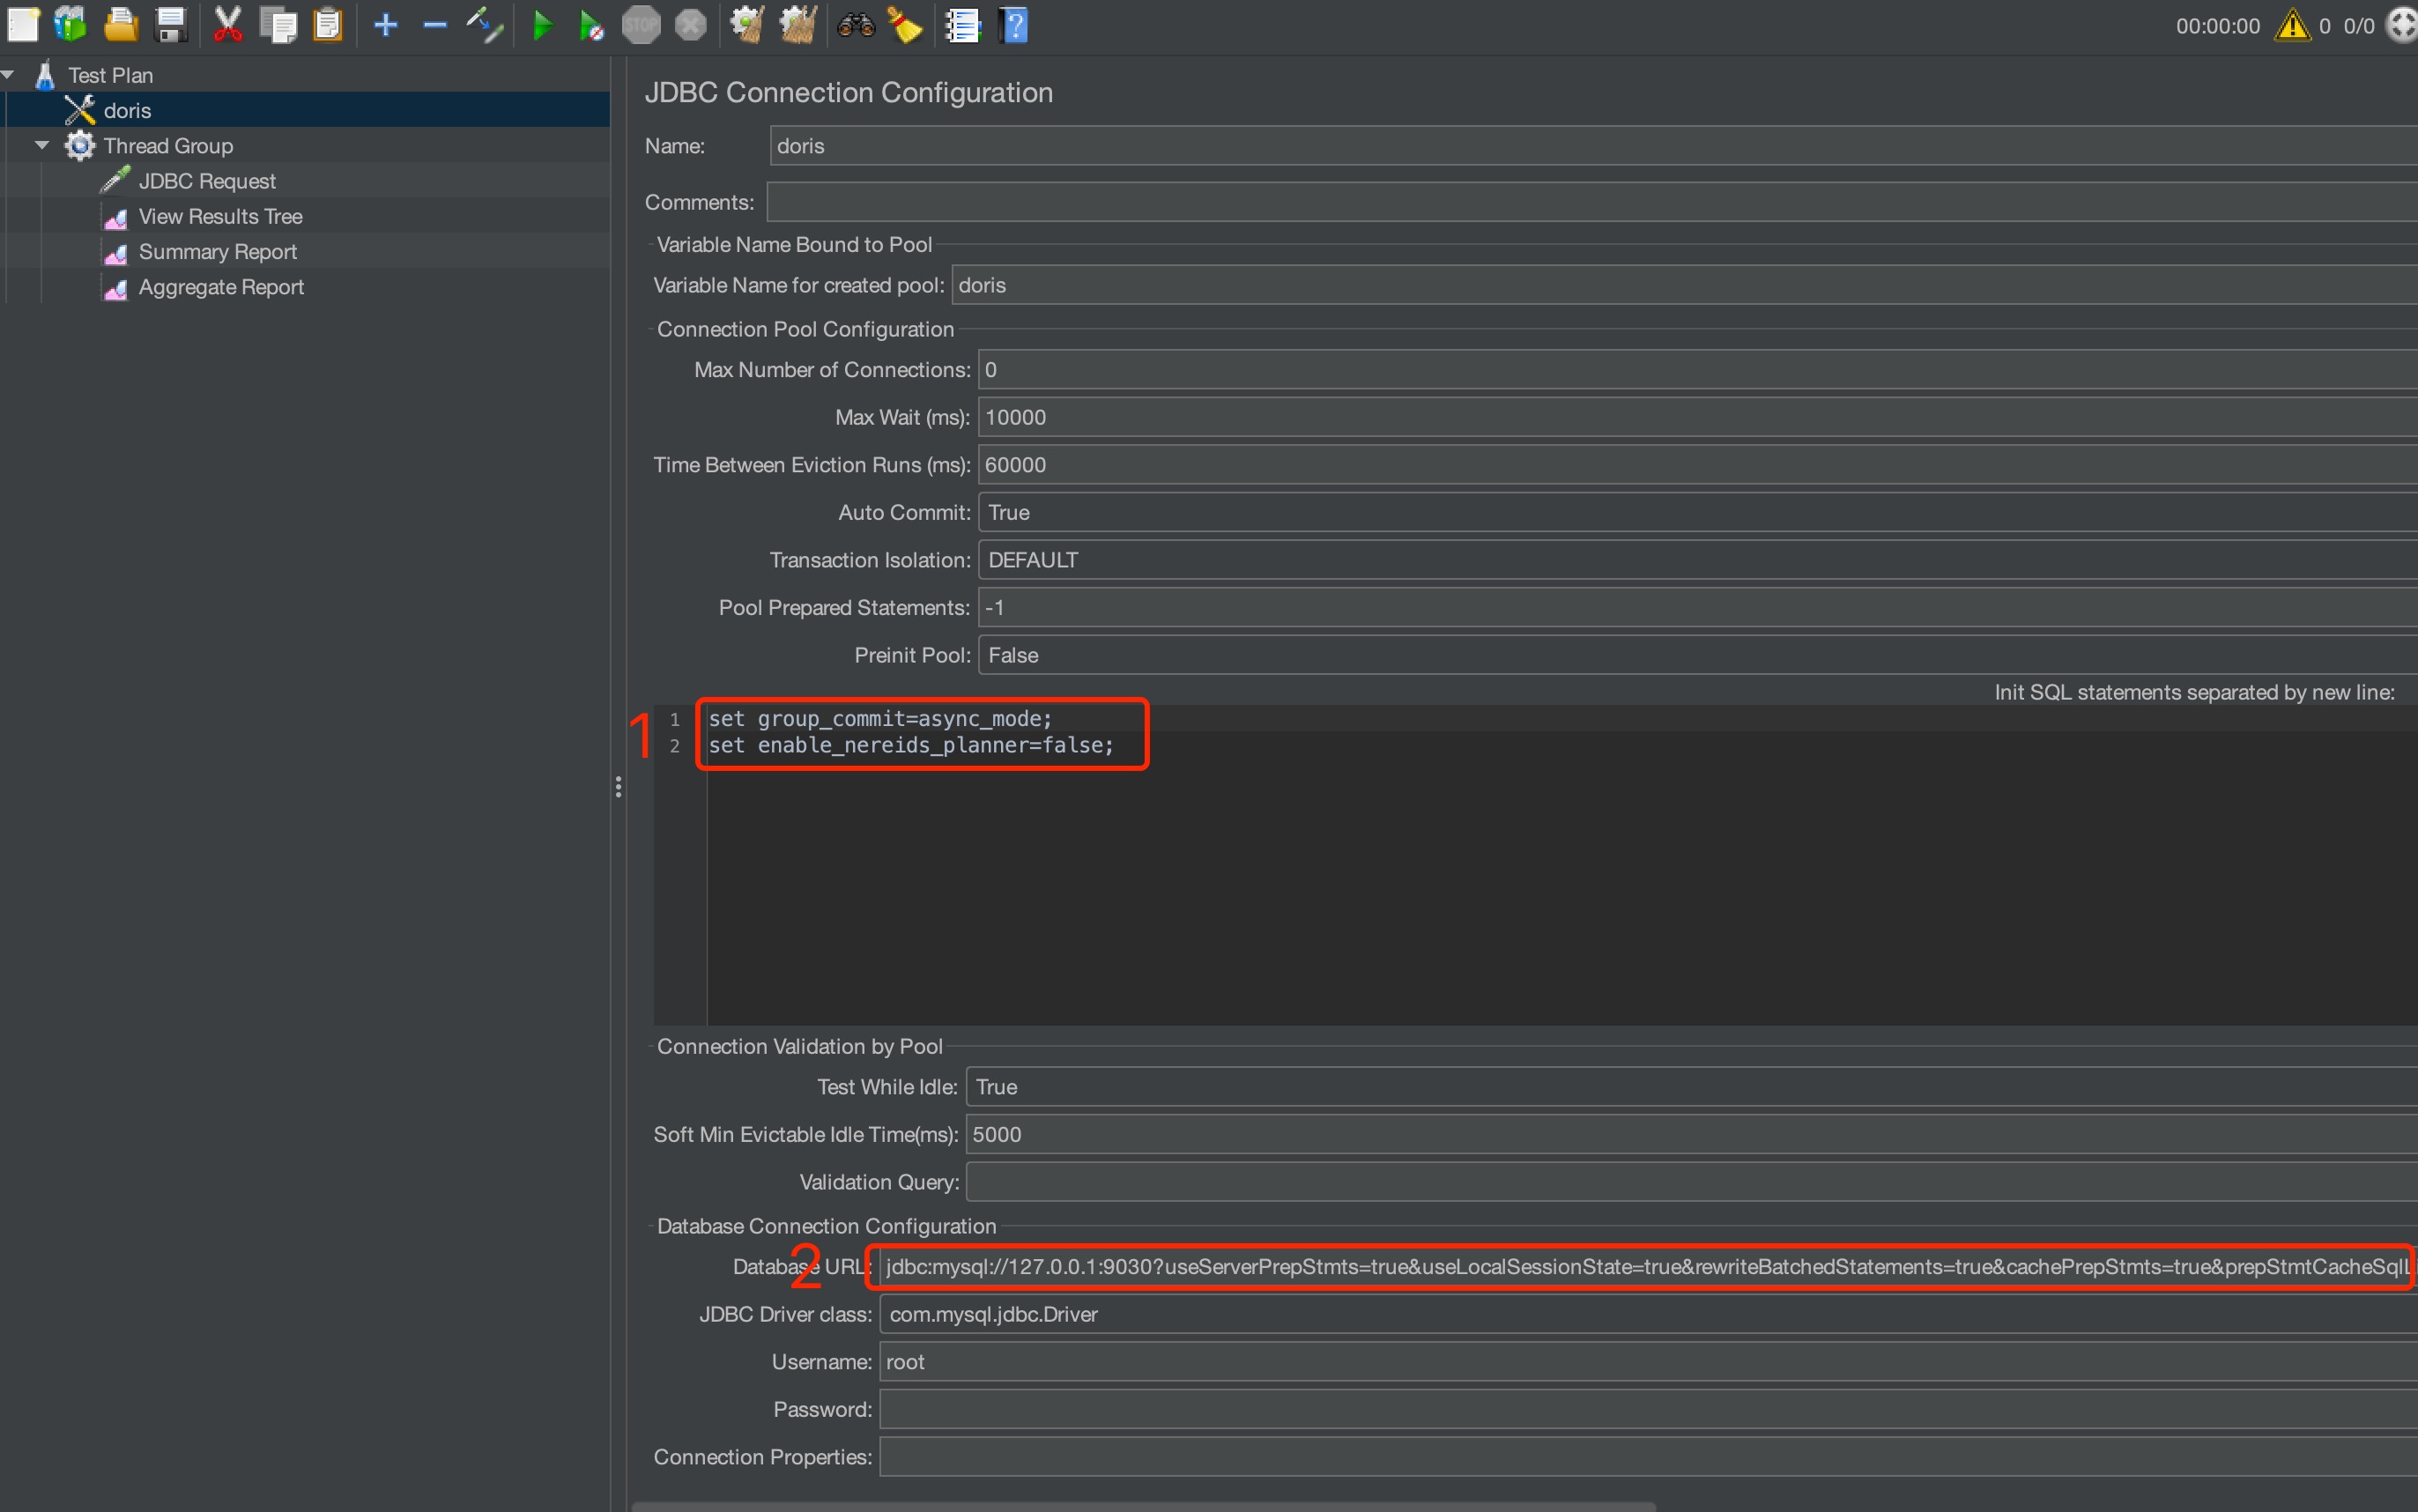
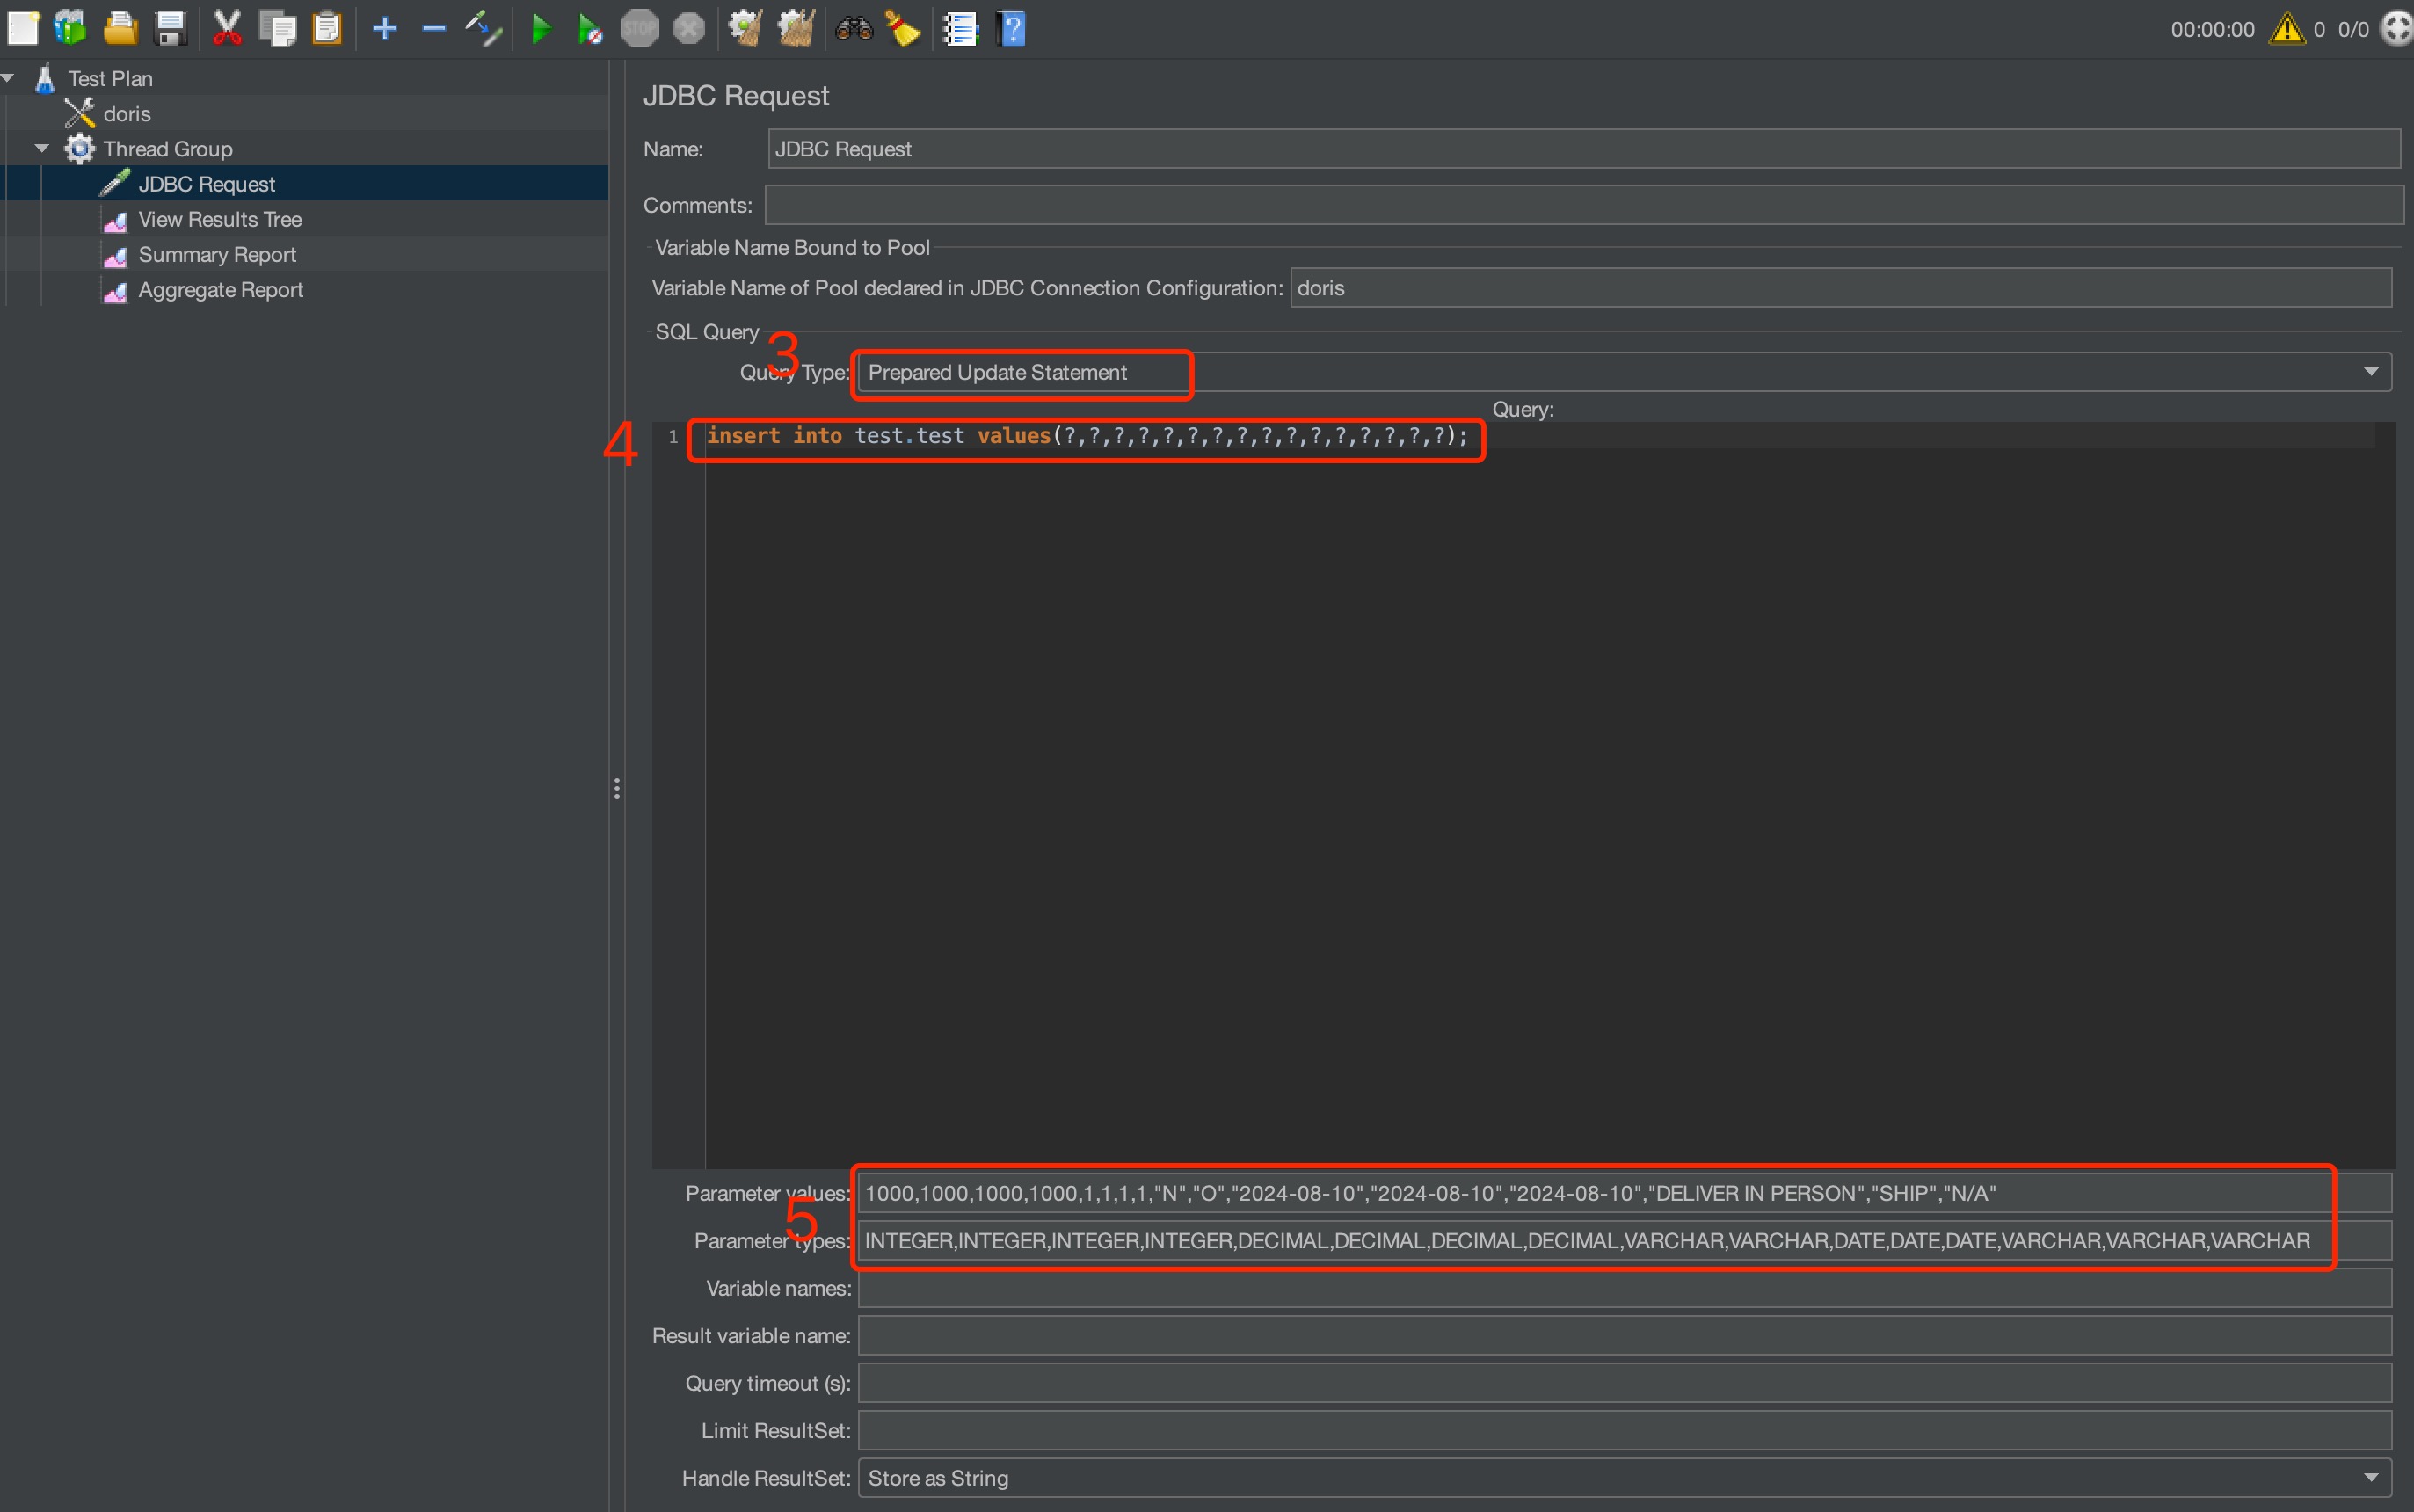
-
Перед тестом задайте операторы инициализации:
set group_commit=async_modeиset enable_nereids_planner=false. -
Включите JDBC PreparedStatement. Полный URL:
jdbc:mysql://127.0.0.1:9030?useServerPrepStmts=true&useLocalSessionState=true&rewriteBatchedStatements=true&cachePrepStmts=true&prepStmtCacheSqlLimit=99999&prepStmtCacheSize=50&sessionVariables=group_commit=async_mode,enable_nereids_planner=false`. -
Выберите тип загрузки «подготовленный оператор обновления».
-
Задайте оператор загрузки.
-
Задайте значения для каждой загрузки. Убедитесь, что тип каждого значения соответствует ожидаемому типу загружаемых данных.
Методика тестирования:
- Запись данных в
DorisчерезJmeter. Каждый параллельный поток записывает 1 строку на одинINSERT INTO.
Результаты тестирования (в строках/секунду):
В следующих тестах используются 30, 100 и 500 параллельных потоков.
30 параллельных потоков, синхронный режим, 5 BE с 3 репликами:
| Интервал Group Commit | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 891.8 | 701.1 | 400.0 | 237.5 |
enable_nereids_planner=false | 885.8 | 688.1 | 398.7 | 232.9 |
100 параллельных потоков, синхронный режим, 5 BE с 3 репликами:
| Интервал Group Commit | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 2427.8 | 2068.9 | 1259.4 | 764.9 |
enable_nereids_planner=false | 2320.4 | 1899.3 | 1206.2 | 749.7 |
500 параллельных потоков, синхронный режим, 5 BE с 3 репликами:
| Интервал Group Commit | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 5567.5 | 5713.2 | 4681.0 | 3131.2 |
enable_nereids_planner=false | 4471.6 | 5042.5 | 4932.2 | 3641.1 |
Синхронный режим INSERT INTO, крупные пакеты
Конфигурация оборудования:
- 1 FE: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 500 GB облачный диск ESSD PL1
- 5 BE: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 1 TB облачный диск ESSD PL1. Примечание: в тестах использовались соответственно 1, 3 и 5 BE.
- 1 тестовый клиент: Alibaba Cloud, CPU с 16 ядрами, 64 GB памяти, 1 x 100 GB облачный диск ESSD PL1
- Тестируемая версия: Doris-3.0.1
Набор данных:
-
Набор данных таблицы
lineitemиз TPC-H sf10. -
Оператор CREATE TABLE:
CREATE TABLE IF NOT EXISTS lineitem (
  L_ORDERKEY    INTEGER NOT NULL,
  L_PARTKEY     INTEGER NOT NULL,
  L_SUPPKEY     INTEGER NOT NULL,
  L_LINENUMBER  INTEGER NOT NULL,
  L_QUANTITY    DECIMAL(15,2) NOT NULL,
  L_EXTENDEDPRICE  DECIMAL(15,2) NOT NULL,
  L_DISCOUNT    DECIMAL(15,2) NOT NULL,
  L_TAX         DECIMAL(15,2) NOT NULL,
  L_RETURNFLAG  CHAR(1) NOT NULL,
  L_LINESTATUS  CHAR(1) NOT NULL,
  L_SHIPDATE    DATE NOT NULL,
  L_COMMITDATE  DATE NOT NULL,
  L_RECEIPTDATE DATE NOT NULL,
  L_SHIPINSTRUCT CHAR(25) NOT NULL,
  L_SHIPMODE     CHAR(10) NOT NULL,
  L_COMMENT      VARCHAR(44) NOT NULL
)
DUPLICATE KEY(L_ORDERKEY, L_PARTKEY, L_SUPPKEY, L_LINENUMBER)
DISTRIBUTED BY HASH(L_ORDERKEY) BUCKETS 32
PROPERTIES (
  "replication_num" = "3"
);
Инструмент тестирования:
Методика тестирования:
- Запись данных в
DorisчерезJmeter. Каждый параллельный поток записывает 1000 строк на одинINSERT INTO.
Результаты тестирования (в строках/секунду):
В следующих тестах используются 30, 100 и 500 параллельных потоков.
30 параллельных потоков, синхронный режим, 5 BE с 3 репликами:
| Интервал Group Commit | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 9.1K | 11.1K | 11.4K | 11.1K |
enable_nereids_planner=false | 157.8K | 159.9K | 154.1K | 120.4K |
100 параллельных потоков, синхронный режим, 5 BE с 3 репликами:
| Интервал Group Commit | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 10.0K | 9.2K | 8.9K | 8.9K |
enable_nereids_planner=false | 130.4K | 131.0K | 130.4K | 124.1K |
500 параллельных потоков, синхронный режим, 5 BE с 3 репликами:
| Интервал Group Commit | 10ms | 20ms | 50ms | 100ms |
|---|---|---|---|---|
enable_nereids_planner=true | 2.5K | 2.5K | 2.3K | 2.1K |
enable_nereids_planner=false | 94.2K | 95.1K | 94.4K | 94.8K |
Часто задаваемые вопросы
Вопрос 1: Как проверить, использует ли моя загрузка Group Commit?
- INSERT INTO VALUES: в возвращаемом результате
labelначинается сgroup_commit_, а несколько загрузок могут иметь одинаковыеlabelиtxnId. - Stream Load: в возвращаемом JSON поле
GroupCommitимеет значениеtrue, аLabelначинается сgroup_commit_.
Вопрос 2: Как скоро после включения async_mode данные станут доступны для запросов?
- Задержка видимости данных определяется совместно свойствами таблицы
group_commit_interval_ms(по умолчанию 10 секунд) иgroup_commit_data_bytes(по умолчанию 64 MB). Фиксация происходит сразу после выполнения любого из этих условий.
Вопрос 3: Когда async_mode автоматически переключается на sync_mode?
- Объём данных в одной загрузке превышает 80% ёмкости одного каталога WAL.
- Используется Stream Load с передачей по частям и неизвестным объёмом данных.
- Недостаточно свободного места на диске.
Вопрос 4: Почему мой INSERT INTO VALUES выполняется без Group Commit?
- Проверьте, выполняется ли запись внутри явной транзакции, указана ли метка, содержится ли выражение в VALUES, обновляются ли отдельные столбцы и поддерживает ли таблица облегчённое изменение схемы. Подробнее см. в разделе Сценарии отказа от Group Commit.
Вопрос 5: Есть ли риск потери данных при использовании async_mode?
- Файлы WAL хранятся в единственной реплике. Если соответствующий диск повреждён или файл случайно удалён, данные могут быть потеряны. При выводе узла BE из эксплуатации всегда используйте команду
DECOMMISSION, чтобы предотвратить потерю данных.
Вопрос 6: На что обратить внимание при использовании Group Commit с моделью Unique?
- Group Commit не гарантирует порядок фиксации. Для обеспечения согласованности данных используйте столбец Sequence.