Состояние Doris Operator и устранение неполадок
Doris Operator записывает состояние компонентов в поле status пользовательских ресурсов Doris. При устранении неполадок Doris в Kubernetes начните с состояния CR, затем проверьте журналы Operator, ресурсы Kubernetes и журналы компонентов Doris.
Просмотр состояния ресурсов
Кластеры с совмещёнными вычислениями и хранением используют DorisCluster, обычно сокращённо обозначаемый как dcr:
kubectl get dcr -n ${namespace}
kubectl describe dcr ${cluster_name} -n ${namespace}
Кластеры с разделением вычислений и хранения используют DorisDisaggregatedCluster, обычно сокращённо обозначаемый как ddc:
kubectl get ddc -n ${namespace}
kubectl describe ddc ${cluster_name} -n ${namespace}
Если состояние CR указывает, что компоненты не готовы, проверьте лежащие в их основе ресурсы:
kubectl get pod,sts,svc,pvc -n ${namespace}
kubectl get event -n ${namespace} --sort-by=.lastTimestamp
Состояние DorisCluster
В DorisCluster.status состояние сгруппировано по компонентам:
| Поле | Описание |
|---|---|
feStatus | Состояние FE |
beStatus | Состояние BE |
cnStatus | Состояние CN |
brokerStatus | Состояние Broker |
Состояние каждого компонента обычно включает следующие поля:
| Поле | Описание |
|---|---|
accessService | Service для внешнего доступа к компоненту |
runningInstances | Работающие экземпляры |
creatingInstances | Создаваемые экземпляры |
failedInstances | Экземпляры, в которых произошёл сбой |
componentCondition.phase | Текущая фаза состояния компонента |
componentCondition.reason | Причина перехода в эту фазу |
componentCondition.message | Понятное человеку сообщение о состоянии |
Распространённые фазы:
| Фаза | Значение |
|---|---|
available | Компонент доступен |
reconciling | Operator приводит ресурсы к желаемому состоянию |
waitScheduling | Ожидание планирования или доступности других ресурсов |
haveMemberFailed | Произошёл сбой хотя бы одного экземпляра |
initializing | Компонент инициализируется |
upgrading | Компонент обновляется |
scaling | Компонент масштабируется |
restarting | Компонент перезапускается |
Состояние DorisDisaggregatedCluster
DorisDisaggregatedCluster.status включает состояние компонентов и общее состояние кластера.
| Поле | Описание |
|---|---|
metaServiceStatus | Состояние MetaService |
feStatus | Состояние FE |
computeGroupStatuses | Список состояний групп ComputeGroup |
clusterHealth | Общее состояние кластера |
observedGeneration | Поколение ресурса, наблюдаемое Operator |
clusterHealth отражает общую доступность кластера:
| Поле | Описание |
|---|---|
health | Общее состояние, например green, yellow или red |
feAvailable | Доступен ли FE |
cgCount | Количество групп ComputeGroup |
cgAvailableCount | Количество доступных групп ComputeGroup |
cgFullAvailableCount | Количество групп ComputeGroup, в которых доступны все Pod |
| Состояние | Значение |
|---|---|
green | Основные компоненты доступны, а доступность групп ComputeGroup соответствует ожидаемой |
yellow | Кластер частично доступен, но ещё не полностью готов |
red | Основные компоненты недоступны или доступно слишком мало групп ComputeGroup |
Фазы ComputeGroup могут включать Ready, Reconciling, Scaling, Decommissioning, ScaleDownFailed и Suspended.
Рекомендуемый порядок устранения неполадок
Действуйте в следующем порядке:
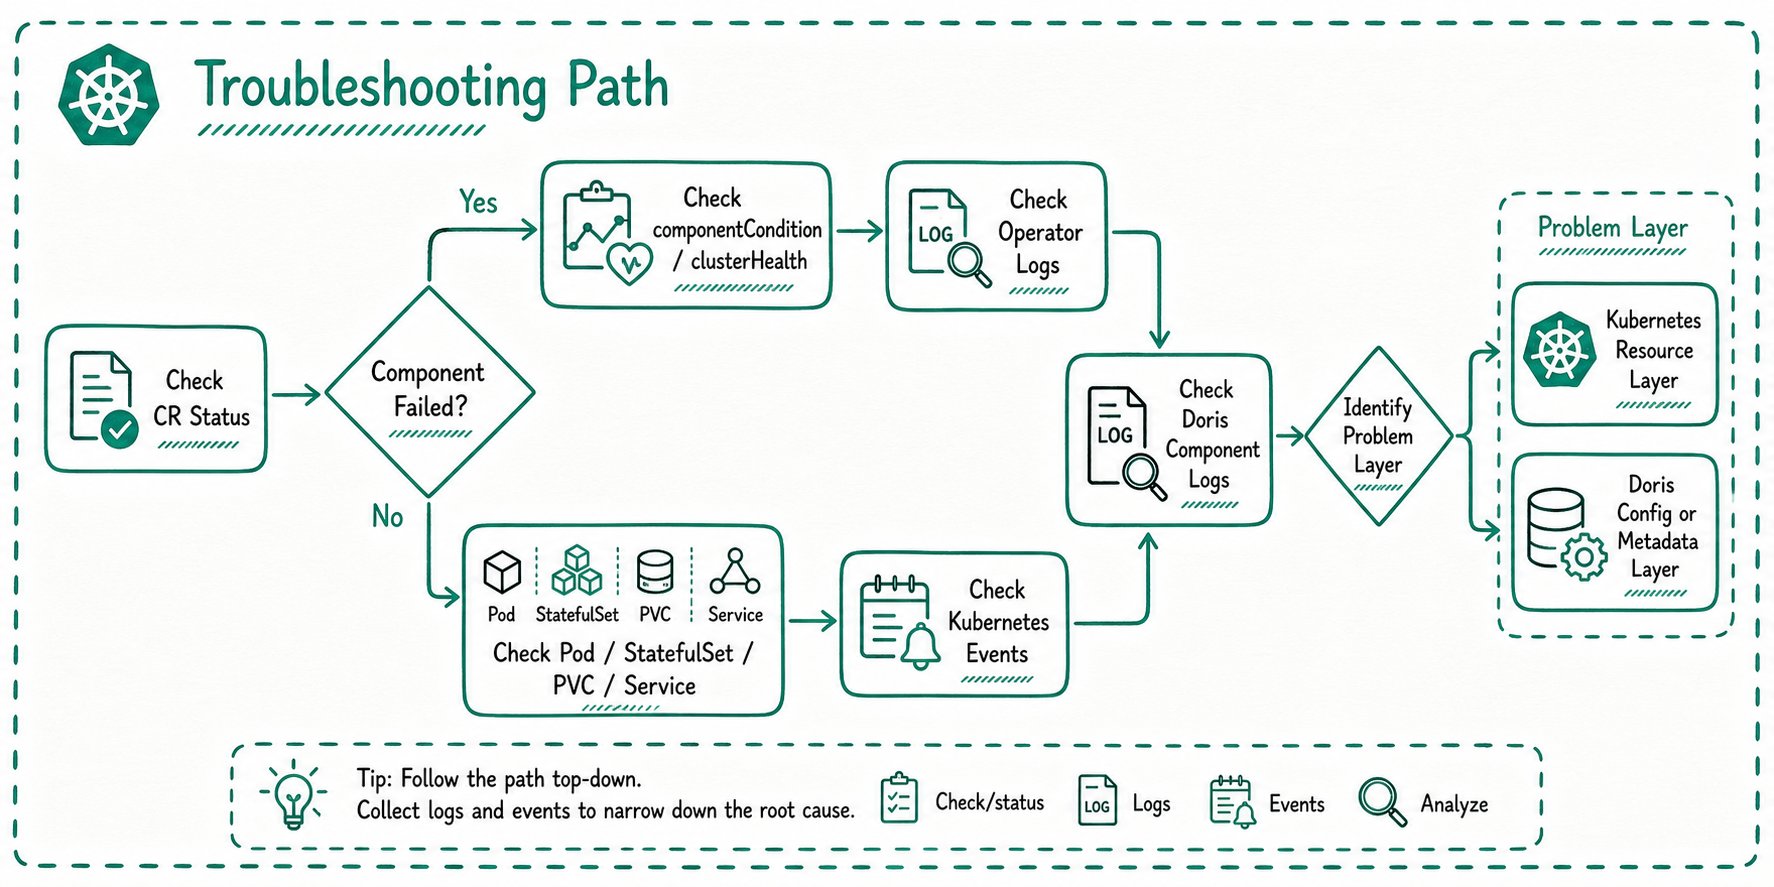
С чего начать при распространённых проблемах
Pod остаётся в состоянии Pending
Распространённые причины:
- Недостаточно ресурсов CPU или памяти на узлах.
- Несоответствие селектора узлов, правил affinity или toleration.
- Ошибка привязки PVC.
kubectl describe pod ${pod_name} -n ${namespace}
kubectl get event -n ${namespace} --sort-by=.lastTimestamp
kubectl get pvc -n ${namespace}
Не удаётся привязать PVC
Распространённые причины:
- StorageClass не существует.
- Недостаточно места в хранилище.
- Несоответствие режима доступа.
kubectl get storageclass
kubectl describe pvc ${pvc_name} -n ${namespace}
Компонент постоянно перезапускается
Распространённые причины:
- Некорректная конфигурация запуска Doris.
- Конфликт портов или некорректная конфигурация FQDN.
- Проблемы с правами доступа к хранилищу или путём монтирования.
- Параметры JVM или системы не соответствуют требованиям.
kubectl logs ${pod_name} -n ${namespace}
kubectl describe pod ${pod_name} -n ${namespace}
Если Pod находится в состоянии CrashLoopBackOff, а информации в журналах недостаточно, воспользуйтесь процедурой Debug, описанной в разделе об операциях с кластером.
Service недоступен
Распространённые причины:
- Внутренний Service используется как внешняя точка доступа.
- Тип Service не соответствует среде доступа.
- Pod не находятся в состоянии Ready, поэтому Endpoints пусты.
- Не удалось создать облачный LoadBalancer.
kubectl get svc -n ${namespace}
kubectl get endpoints -n ${namespace}
kubectl describe svc ${service_name} -n ${namespace}
Изменения конфигурации не вступают в силу
Распространённые причины:
- ConfigMap изменён, но компонент не перезапущен.
- Ключи ConfigMap не соответствуют требованиям компонента.
- В CR некорректно указана ссылка на ConfigMap.
- Путь монтирования не совпадает с путём к файлу, указанным в конфигурации.
kubectl get configmap -n ${namespace}
kubectl describe dcr ${cluster_name} -n ${namespace}
kubectl describe ddc ${cluster_name} -n ${namespace}
Для кластеров с совмещёнными вычислениями и хранением проверьте, настроен ли параметр enableRestartWhenConfigChange, если вы ожидаете, что изменения основного ConfigMap будут вызывать поочерёдный перезапуск.
Проблемы с authSecret
Doris Operator могут потребоваться учётные данные для управления Doris при регистрации узлов, уменьшении их количества, выводе из эксплуатации и выполнении связанных операций. Некорректная настройка authSecret может помешать завершению этих операций.
Распространённые причины:
- Указанный Secret не существует или находится в другом пространстве имён.
- Неверный тип или ключи Secret.
- Имя пользователя или пароль не соответствуют учётной записи для управления Doris.
- У учётной записи для управления недостаточно прав.
kubectl get secret ${auth_secret_name} -n ${namespace}
kubectl describe dcr ${cluster_name} -n ${namespace}
kubectl describe ddc ${cluster_name} -n ${namespace}
kubectl logs deployment/${operator_deployment_name} -n ${operator_namespace}
Если кластер использует учётную запись для управления, отличную от стандартной, или пароль root уже задан, убедитесь, что authSecret соответствует фактическим учётным данным Doris.
Уменьшение количества узлов в ComputeGroup не завершается
В кластерах с разделением вычислений и хранения уменьшение количества узлов в ComputeGroup может застрять в фазе Decommissioning или ScaleDownFailed.
Распространённые причины:
- Вывод узлов из эксплуатации на уровне метаданных Doris не завершён.
- FE недоступен.
- Учётные данные для управления неверны.
- На целевых узлах ещё выполняются задачи переноса или очистки данных.
kubectl describe ddc ${cluster_name} -n ${namespace}
kubectl logs deployment/${operator_deployment_name} -n ${operator_namespace}
Также может потребоваться проверить состояние узлов и групп ComputeGroup на стороне Doris.
Журналы Operator
Если состояния CR недостаточно для объяснения сбоя, проверьте журналы Doris Operator:
kubectl get pod -n ${operator_namespace}
kubectl logs ${operator_pod_name} -n ${operator_namespace}