Развёртывание Prometheus и Grafana
В этом документе описано, как развернуть Prometheus и Grafana в Kubernetes с помощью Helm и подключить их к кластеру Apache Doris с разделением вычислений и хранения для сбора и визуализации метрик и настройки оповещений. Prometheus собирает метрики, которые FE, BE и Meta Service предоставляют через HTTP и bRPC. Grafana отображает состояние кластера на дашбордах.
Примечание: в этом документе рассматривается настройка Helm + ServiceMonitor в Kubernetes. Шаблон облачного дашборда, загружаемый в этом руководстве, также подходит для кластеров с разделением вычислений и хранения, развёрнутых вне Kubernetes. Сведения об архитектуре мониторинга Doris, формате метрик, описаниях панелей дашбордов и полный каталог шаблонов (Catalog) см. в разделе Мониторинг и оповещения.
Сценарии использования
| Сценарий | Описание |
|---|---|
| Ввод нового кластера в эксплуатацию | Настройте мониторинг перед вводом кластера Doris с разделением вычислений и хранения в промышленную эксплуатацию, чтобы своевременно обнаруживать аномалии. |
| Повседневная эксплуатация | Непрерывно отслеживайте ключевые метрики FE, BE и Meta Service, а также использование ресурсов узлов. |
| Диагностика проблем | Используйте историю метрик, дашборды и оповещения, чтобы быстро определять причины проблем с производительностью или доступностью. |
| Планирование ресурсов | Определяйте, когда требуется горизонтальное масштабирование, на основе динамики метрик узлов и компонентов. |
Предварительные требования
- Работоспособный кластер Kubernetes с уже настроенным
kubectl. - Кластер с разделением вычислений и хранения, уже развёрнутый в пространстве имён
defaultс помощью Doris Operator, со всеми готовыми к работе компонентами трёх типов (FE, BE/Compute Group, Meta Service). - Узлы имеют доступ в интернет и могут загрузить скрипт установки Helm, Prometheus Community Charts и JSON-файл дашборда Grafana.
- Права на создание пространств имён, Helm Releases, ServiceMonitors и других ресурсов Kubernetes.
Обзор развёртывания
- Установите Helm и разверните Prometheus, Grafana и Alertmanager одной командой с помощью
kube-prometheus-stack. - Настройте
ServiceMonitorдля Prometheus, чтобы он автоматически обнаруживал кластер Doris и собирал его метрики HTTP и bRPC. - Войдите в Grafana, импортируйте официальный дашборд Doris и при необходимости добавьте панель мониторинга узлов.
Шаг 1: развёртывание Helm, Prometheus и Grafana
1.1 Установка Helm
Назначение: установить Helm 3 на локальном компьютере или узле администрирования для установки компонентов мониторинга в Kubernetes и управления ими.
curl https://raw.githubusercontent.com/helm/helm/main/scripts/get-helm-3 | bash
1.2 Добавление репозитория Prometheus Community Helm
Назначение: зарегистрировать репозиторий с Chart kube-prometheus-stack и обновить локальный кеш.
helm repo add prometheus-community https://prometheus-community.github.io/helm-charts
helm repo update
1.3 Развёртывание kube-prometheus-stack
Назначение: развернуть Prometheus, Grafana, Alertmanager и связанный с ними Operator в отдельном пространстве имён monitoring.
# Create the namespace
kubectl create namespace monitoring

# Deploy kube-prometheus-stack
helm install prometheus prometheus-community/kube-prometheus-stack -n monitoring
1.4 Проверка состояния Pod
Назначение: убедиться, что все Pod в стеке мониторинга находятся в состоянии Running, прежде чем переходить к следующему шагу.
kubectl get pods -n monitoring
При нормальной работе вывод выглядит следующим образом:
NAME                                                     READY   STATUS    RESTARTS         AGE
alertmanager-prometheus-kube-prometheus-alertmanager-0   2/2     Running   8 (5h28m ago)    4d23h
prometheus-grafana-7994c77c7-8nk7j                       3/3     Running   12 (5h28m ago)   5d
prometheus-kube-prometheus-operator-5576477887-dgp8h     1/1     Running   4 (5h28m ago)    5d
prometheus-kube-state-metrics-77885ddddc-hldlw           1/1     Running   4 (5h28m ago)    4d23h
prometheus-prometheus-kube-prometheus-prometheus-0       2/2     Running   0                4h11m
prometheus-prometheus-node-exporter-2tl9s                1/1     Running   4 (5h28m ago)    4d23h
prometheus-prometheus-node-exporter-b58rd                1/1     Running   4 (5h28m ago)    4d23h
prometheus-prometheus-node-exporter-fqp6v                1/1     Running   4 (5h28m ago)    4d23h
Шаг 2: настройка Prometheus для сбора метрик Doris
Создайте ServiceMonitor, чтобы Prometheus Operator автоматически обнаруживал Service Doris в пространстве имён default с меткой app.doris.disaggregated.cluster=test-disaggregated-cluster и собирал их метрики, группируя их по трём типам компонентов: FE, BE и Meta Service.
2.1 Подготовка YAML для ServiceMonitor
Назначение: задать цели сбора, пути конечных точек и интервал сбора, а с помощью relabelings назначить каждому сервису единую метку group в соответствии с его ролью для фильтрации на дашборде.
apiVersion: monitoring.coreos.com/v1
kind: ServiceMonitor
metadata:
  name: doris-disaggregated-monitor
  namespace: monitoring
  labels:
    release: prometheus
spec:
  namespaceSelector:
    matchNames:
    - default
  selector:
    matchLabels:
      app.doris.disaggregated.cluster: test-disaggregated-cluster
  endpoints:
  - port: http
    path: /metrics
    interval: 15s
    relabelings:
    # 1. Unify the job name
    - action: replace
      targetLabel: job
      replacement: doris-cluster
    # 2. Map Service name suffix to component group: -cg1 -> be, -fe -> fe, -ms -> meta_service
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-cg1
      replacement: be
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-fe
      replacement: fe
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-ms
      replacement: meta_service
      targetLabel: group

  - port: brpc-port
    path: /brpc_metrics
    interval: 15s
    relabelings:
    # 1. Unify the job name
    - action: replace
      targetLabel: job
      replacement: doris-cluster
    # 2. Map Service name suffix to component group: -cg1 -> be, -fe -> fe, -ms -> meta_service
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-cg1
      replacement: be
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-fe
      replacement: fe
      targetLabel: group
    - sourceLabels: [__meta_kubernetes_service_name]
      regex: .*-ms
      replacement: meta_service
      targetLabel: group
2.2 Основные поля ServiceMonitor
| Поле | Значение | Описание |
|---|---|---|
metadata.namespace | monitoring | ServiceMonitor должен находиться в том же пространстве имён, что и экземпляр Prometheus. |
metadata.labels.release | prometheus | Должно совпадать с именем Helm Release. Prometheus Operator использует эту метку для обнаружения ServiceMonitors. |
spec.namespaceSelector.matchNames | default | Пространство имён, в котором работает кластер Doris. Укажите значение, соответствующее вашей среде. |
spec.selector.matchLabels | app.doris.disaggregated.cluster: test-disaggregated-cluster | Выбирает Service кластера Doris с разделением вычислений и хранения. При необходимости измените имя кластера. |
endpoints[0].port | http | Имя HTTP-порта, через который FE, BE и Meta Service предоставляют /metrics. |
endpoints[1].port | brpc-port | Имя порта bRPC, через который BE предоставляет /brpc_metrics. |
endpoints[*].interval | 15s | Интервал сбора метрик. Настройте его с учётом объёма данных и требований к точности. |
Метка group в relabelings | be / fe / meta_service | Разделяет метрики на три категории компонентов по суффиксу имени Service для фильтрации с помощью переменных дашборда. |
2.3 Применение YAML и проверка
Назначение: дать Prometheus Operator возможность обнаружить новый ServiceMonitor и обновить цели сбора метрик.
kubectl apply -f doris-monitor.yaml
В браузере откройте Prometheus (порт по умолчанию 9090, например http://your_ip:9090), перейдите в Состояние → Цели и убедитесь, что все цели FE, BE и Meta Service в группе doris-cluster находятся в состоянии UP.
Шаг 3: настройка Grafana и дашборда
3.1 Вход в Grafana
Назначение: открыть Grafana, входящую в состав kube-prometheus-stack, и выполнить первый вход.
-
В браузере откройте Grafana (порт по умолчанию
3000, напримерhttp://your_ip:3000). -
Имя пользователя:
admin. Получите начальный пароль с помощью следующей команды:kubectl get secret --namespace monitoring prometheus-grafana -o jsonpath="{.data.admin-password}" | base64 --decode ; echo
3.2 Импорт дашборда Doris
Назначение: использовать официальный JSON-файл дашборда для визуализации метрик кластера Doris.
-
Загрузите официальный файл дашборда: Doris-Dashboard-Cloud.json
-
В Grafana перейдите в Дашборды → Создать → Импорт, импортируйте JSON-файл и выберите входящий в комплект Prometheus в качестве источника данных.
-
Добавьте
&var-cluster_id=doris-clusterв конец URL дашборда, чтобы значение соответствовало имениjob, заданному в ServiceMonitor. Например:http://your_ip:3000/d/3fFiWJ4mz456/doris-cloud-dashboard-overview?orgId=1&var-cluster_id=doris-cluster&refresh=5s
3.3 Добавление мониторинга узлов (необязательно)
Назначение: пример JSON-файла не содержит панели мониторинга узлов. Используйте официальный шаблон Grafana 1860, чтобы напрямую отображать метрики node-exporter.
-
В Grafana импортируйте дашборд:
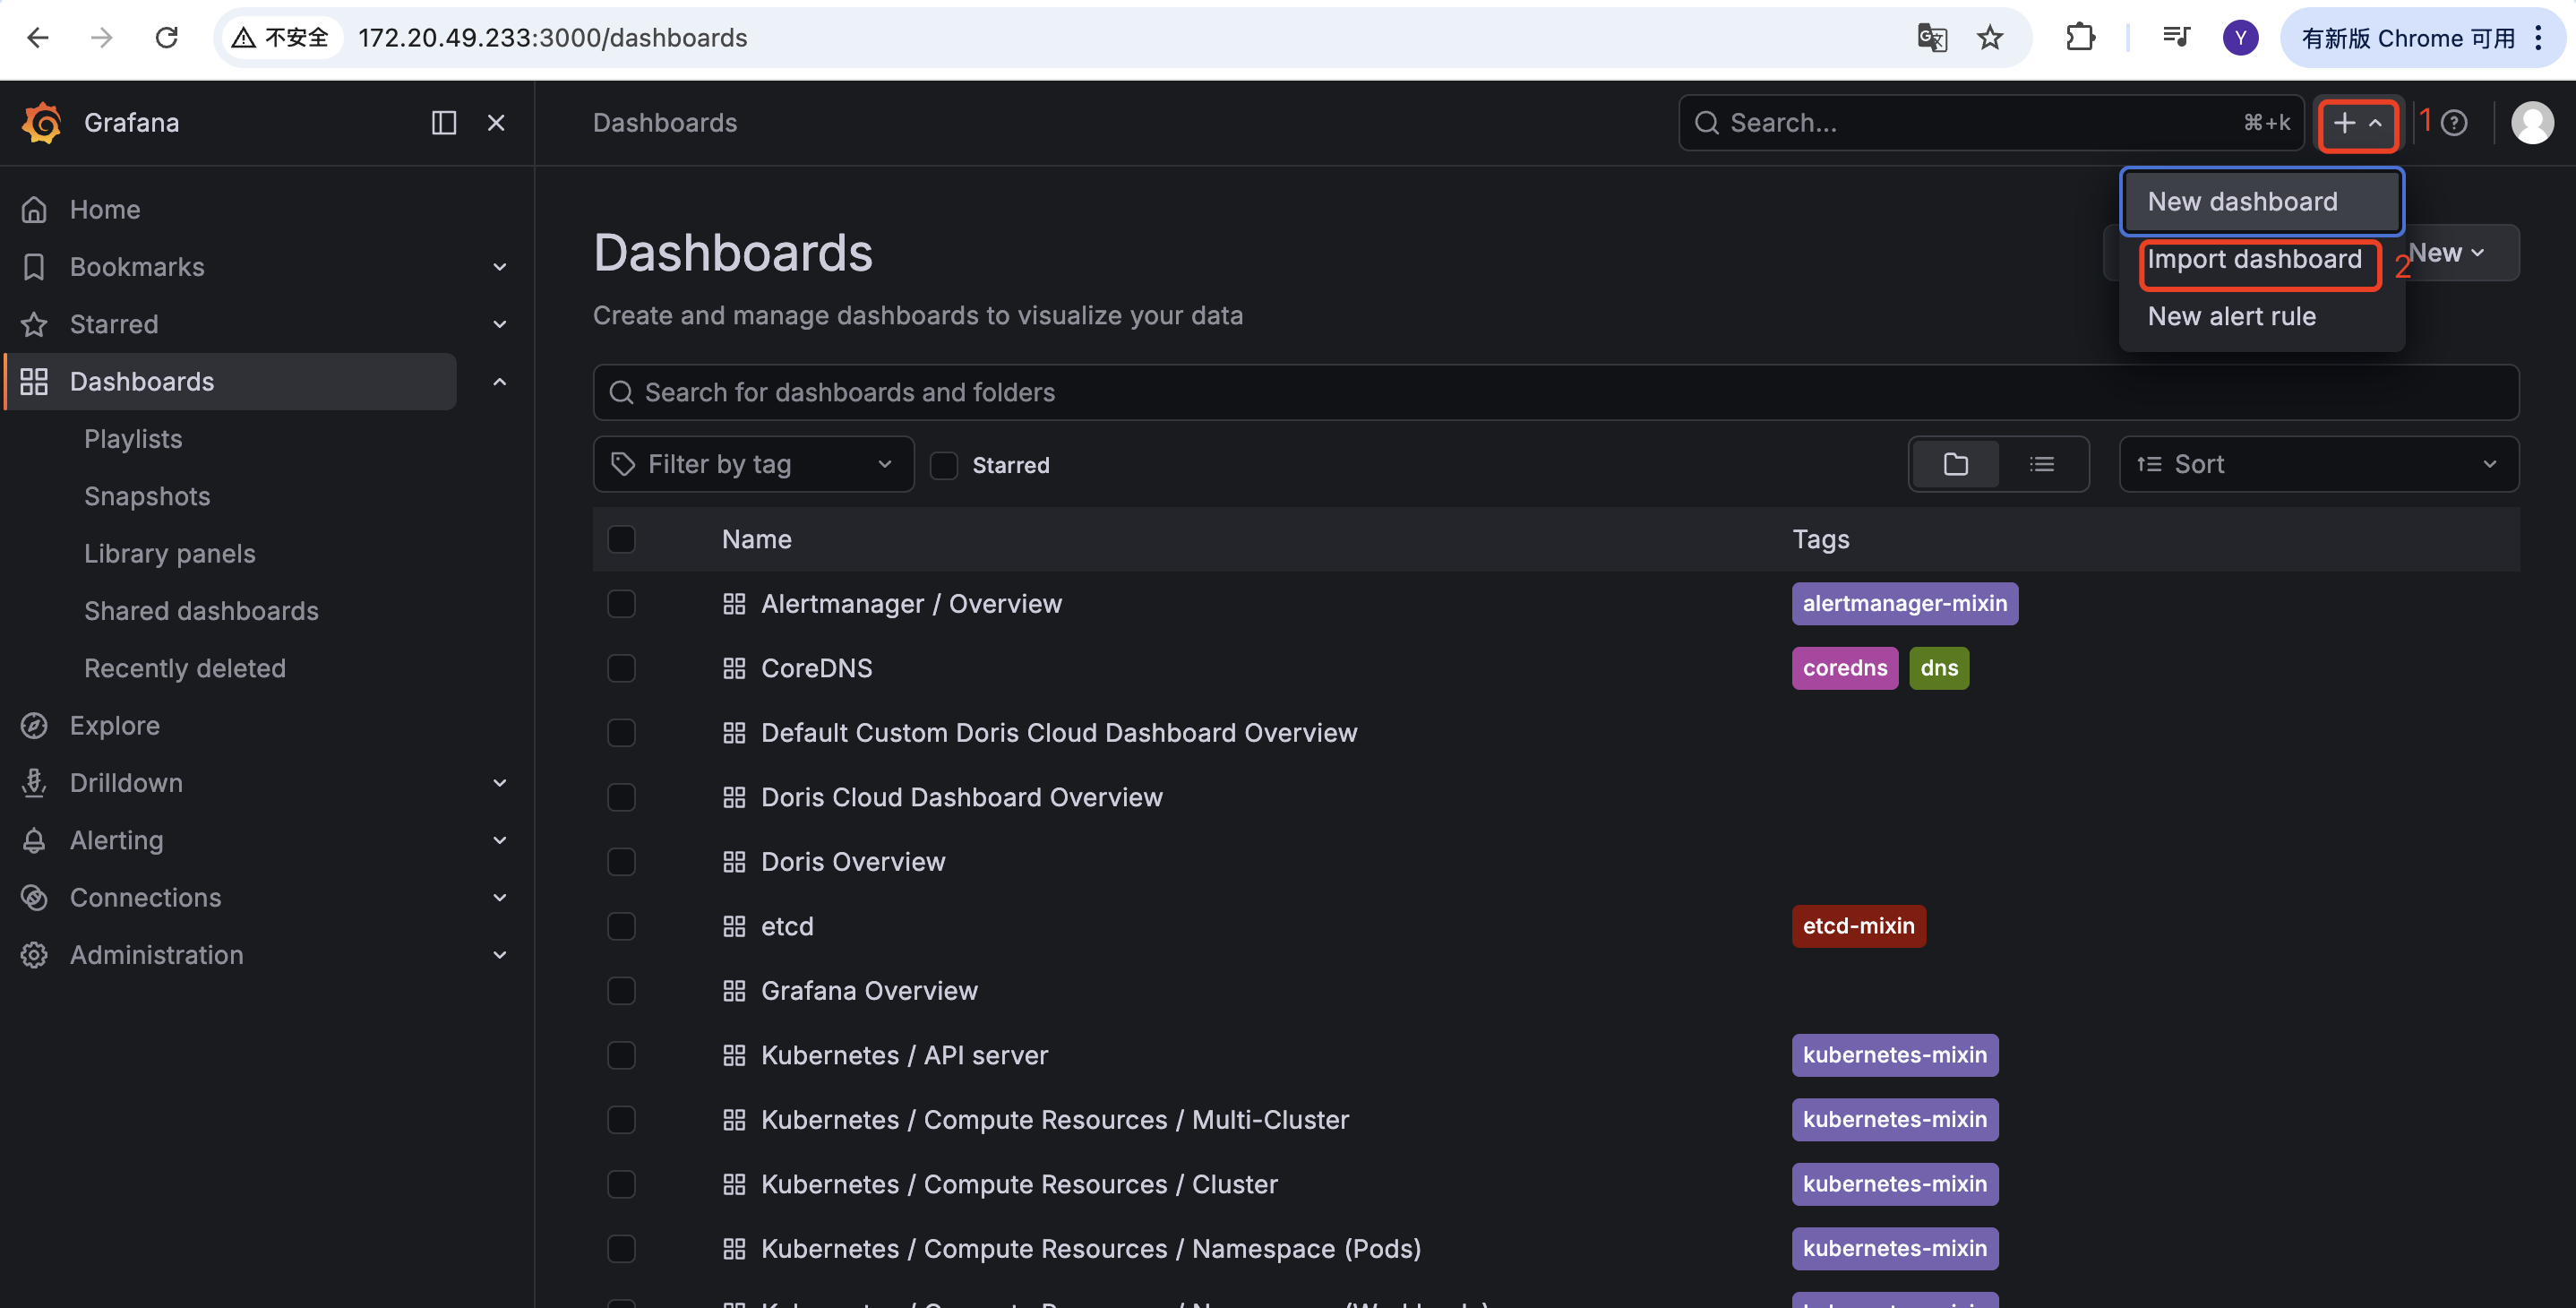
-
Выберите официальный шаблон с номером
1860: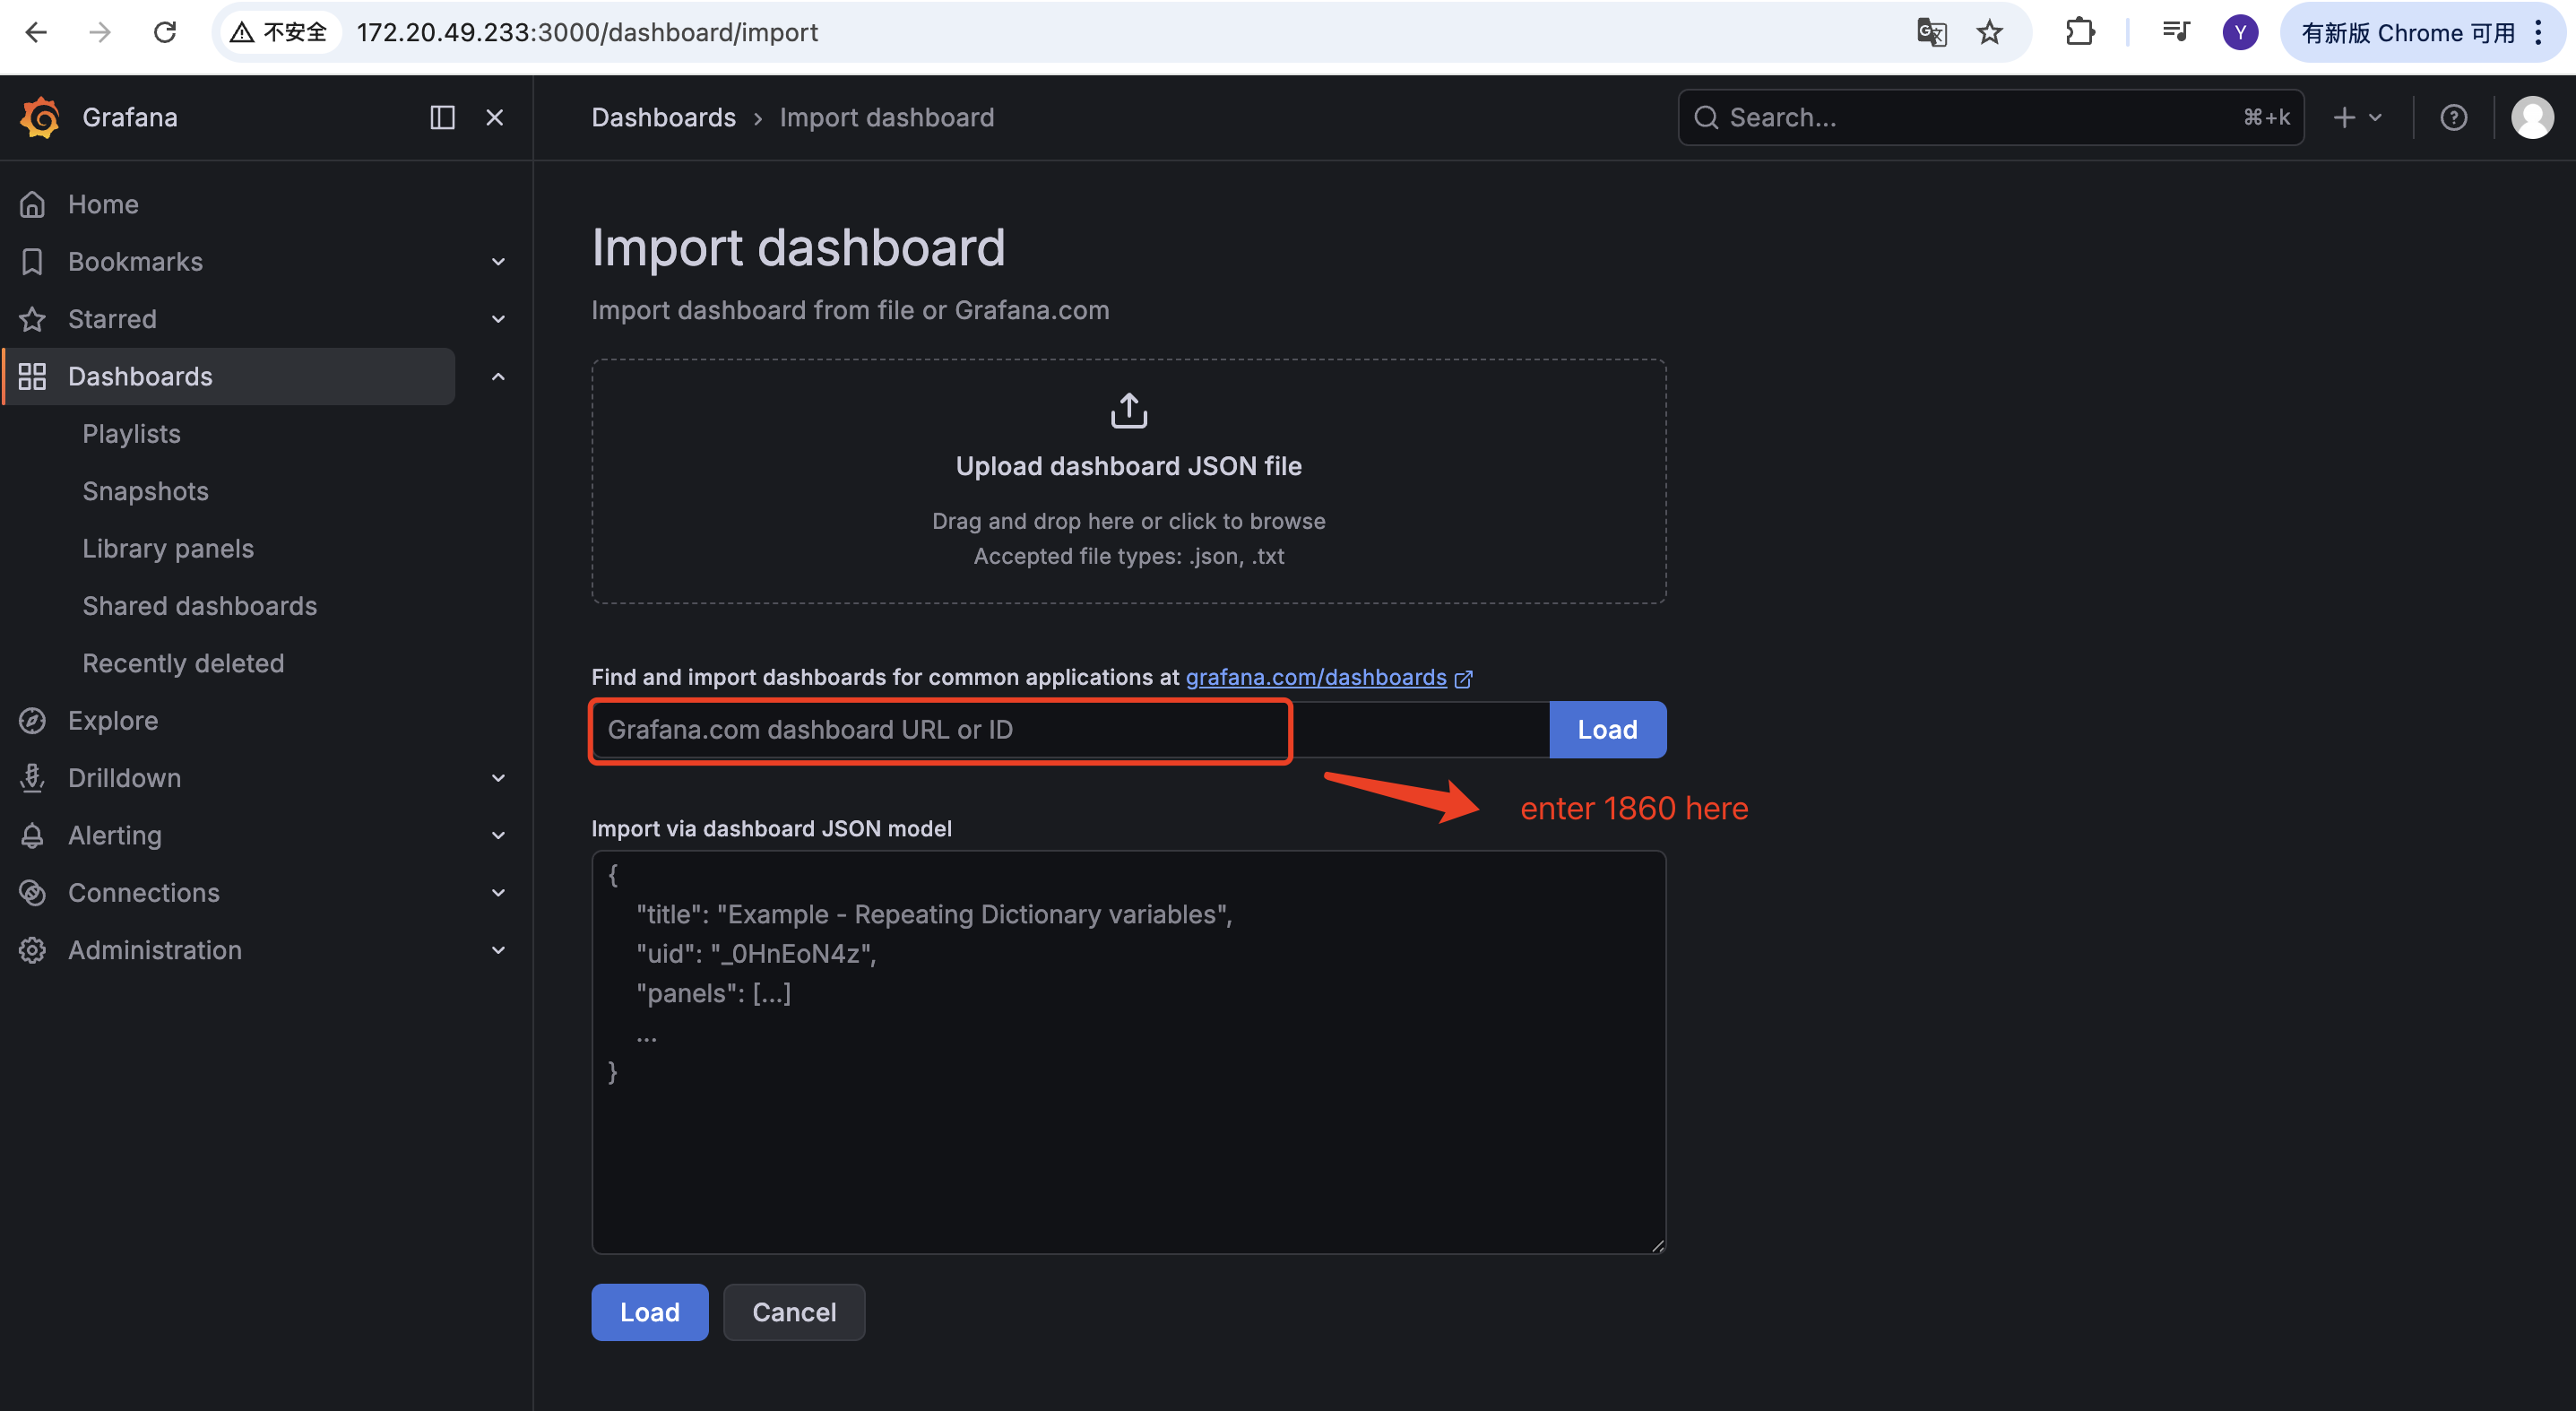
-
После завершения импорта можно просматривать метрики узлов:
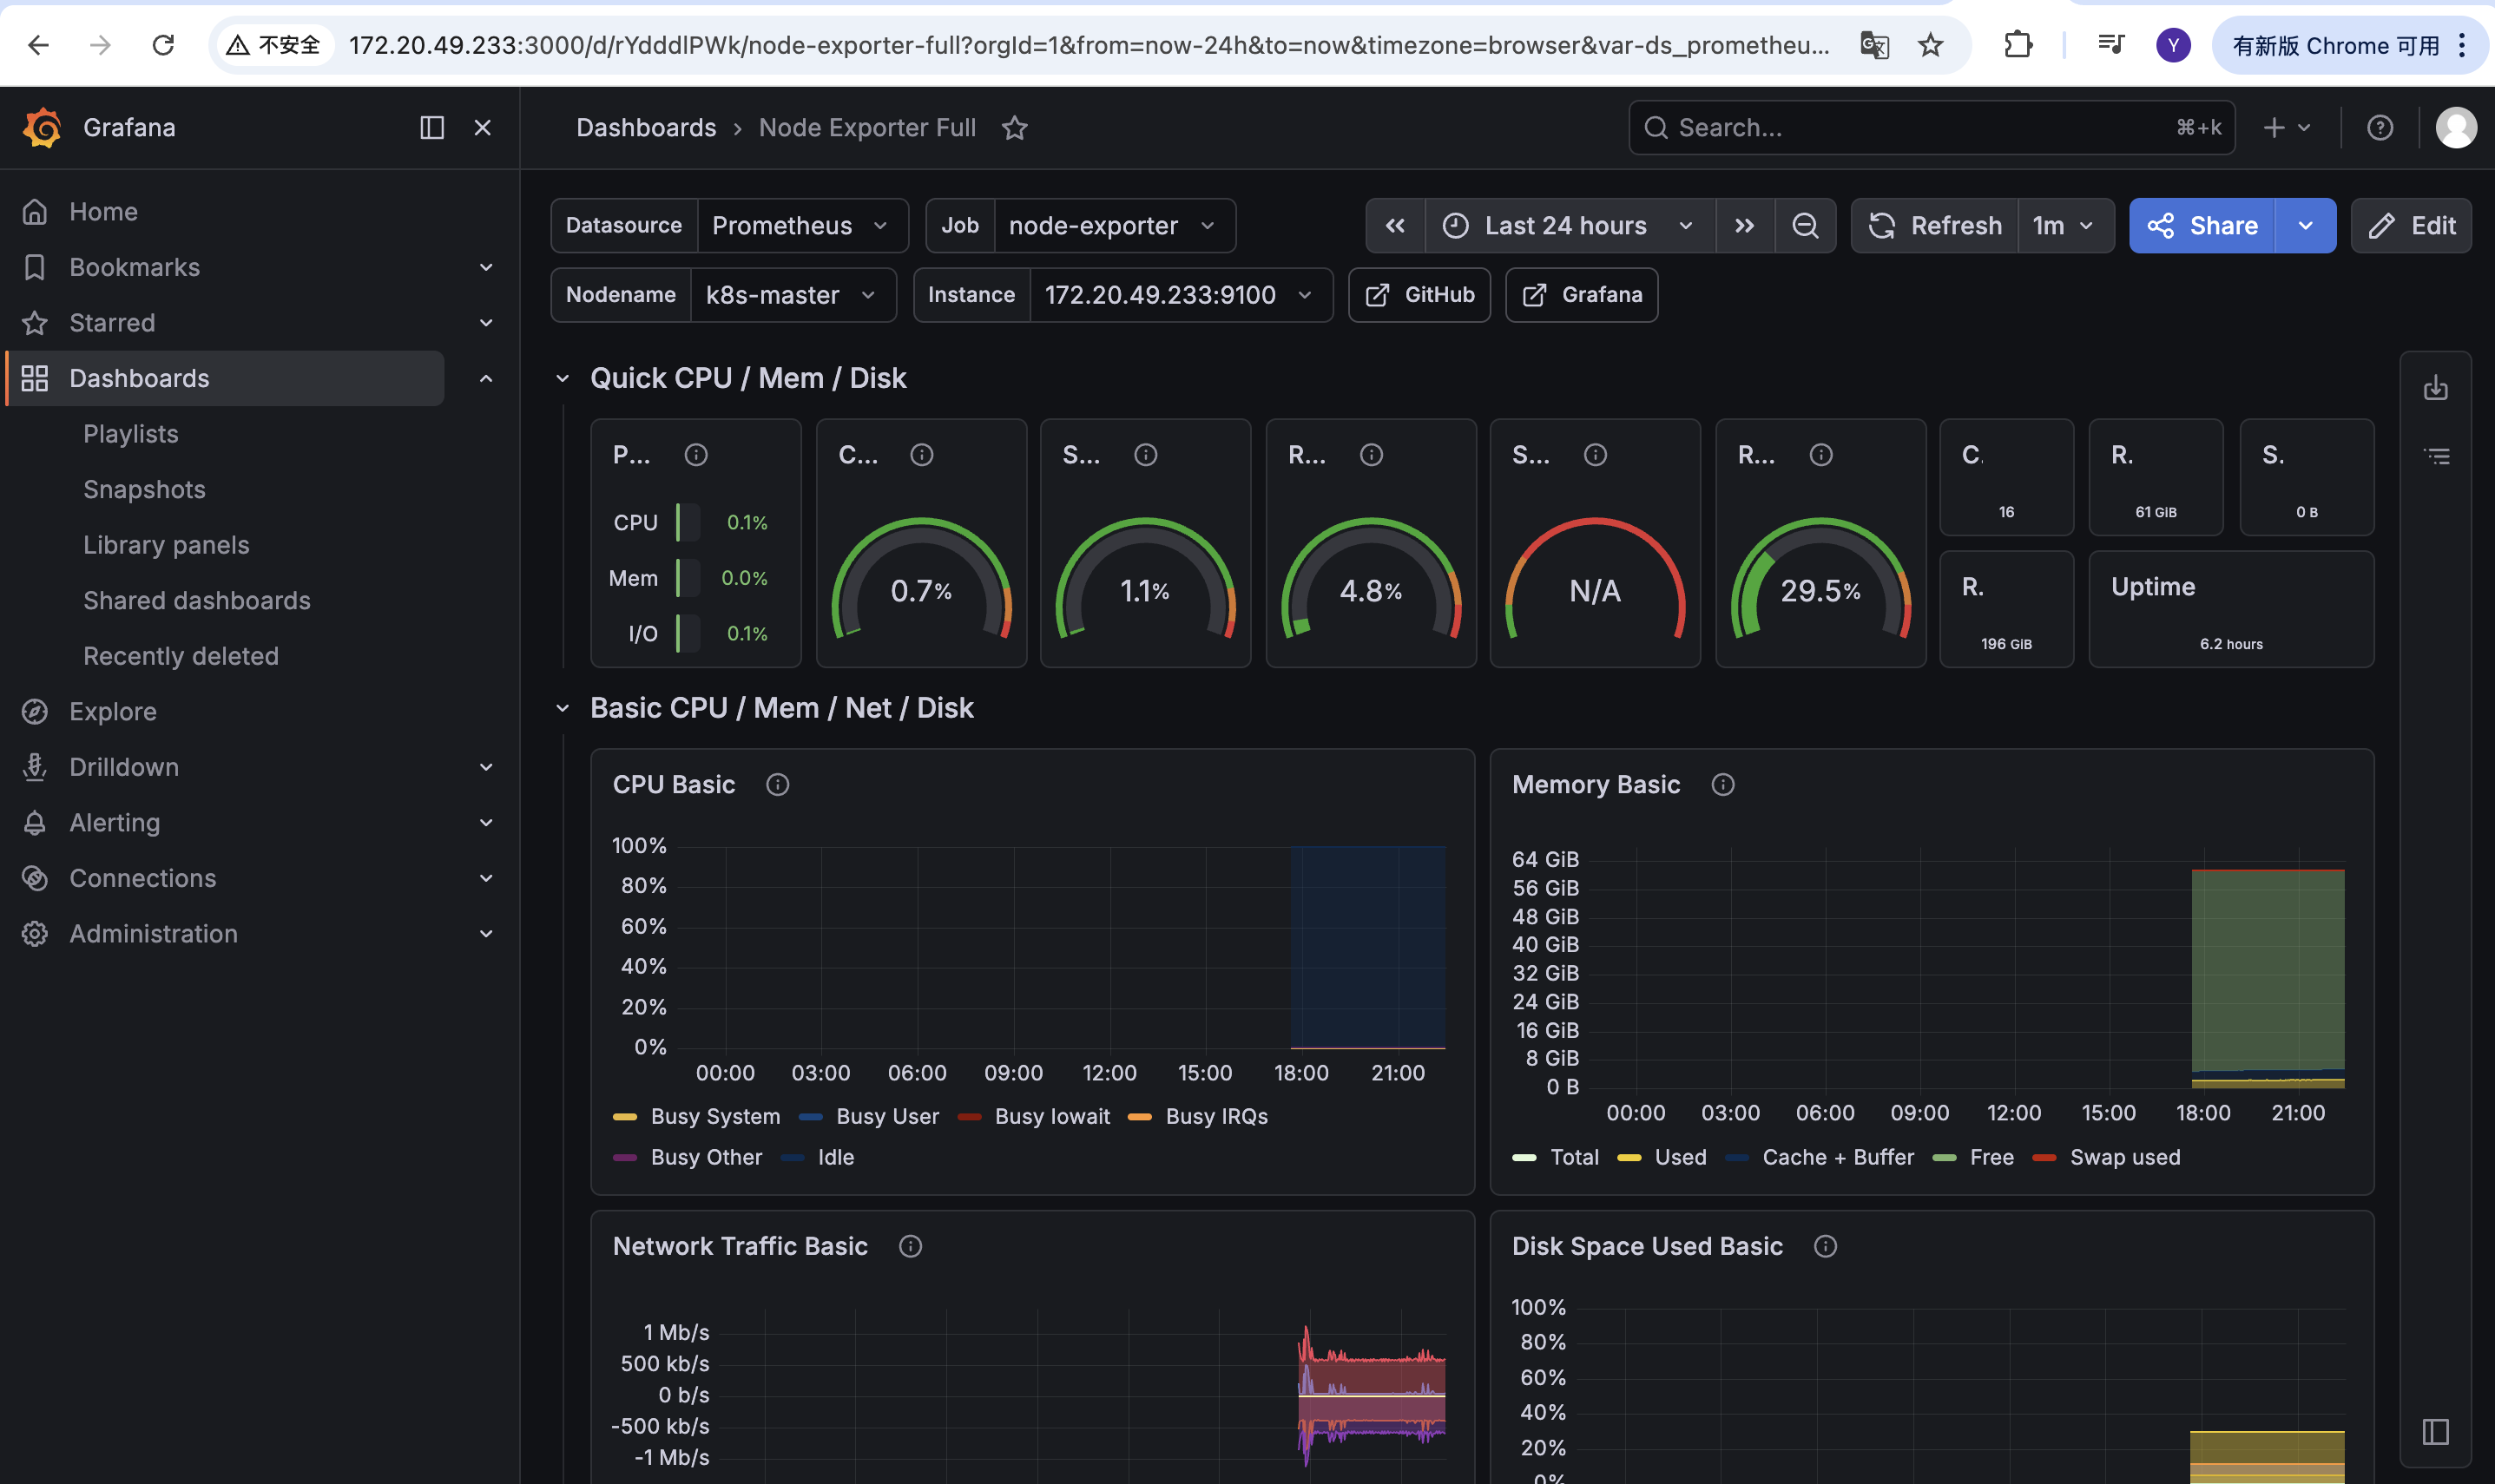
Распространённые проблемы
| Проблема | Возможная причина | Решение |
|---|---|---|
| Цели Doris не отображаются в разделе Цели Prometheus | Значение namespaceSelector или matchLabels в ServiceMonitor не соответствует фактическому кластеру Doris; метка release не совпадает с именем Helm Release. | Проверьте пространство имён кластера, метку Service app.doris.disaggregated.cluster и убедитесь, что метка release в ServiceMonitor имеет значение prometheus. |
Цели отображаются в списке, но находятся в состоянии DOWN | Pod не готов к работе либо имя порта http / brpc-port не совпадает с именем фактически предоставляемого порта. | С помощью kubectl get svc -n default и kubectl describe pod проверьте имена портов, состояние готовности и доступность /metrics и /brpc_metrics внутри контейнера. |
| Панели дашборда Grafana пусты | В URL отсутствует var-cluster_id=doris-cluster либо имя job в ServiceMonitor было изменено. | Убедитесь, что параметр var-cluster_id в URL дашборда и метка job в ServiceMonitor имеют значение doris-cluster. |
| Не удаётся подключиться к Prometheus через порт 9090 или к Grafana через порт 3000 | По умолчанию используется тип Service ClusterIP, недоступный извне кластера. | Настройте перенаправление порта с помощью kubectl port-forward либо измените тип соответствующего Service на NodePort или LoadBalancer. |
Команда получения пароля Grafana возвращает NotFound | Helm Release имеет имя, отличное от prometheus, поэтому имя Secret отличается. | С помощью kubectl get secret -n monitoring найдите фактическое имя Secret для Grafana, затем подставьте его в команду вместо prometheus-grafana. |