Оценка релевантности BM25
Кратко Apache Doris ранжирует результаты полнотекстового поиска с помощью BM25 — того же алгоритма оценки, который используют Lucene и Elasticsearch. Добавьте
score()в SELECT, укажите предикатMATCH_*в предложении WHERE и отсортируйте результаты по оценке с помощьюORDER BY, задавLIMIT. Планировщик Apache Doris переносит вычисление top-K в инвертированный индекс и сначала возвращает наиболее релевантные строки.
Зачем использовать оценку BM25 в Apache Doris?
Оценка BM25 в Apache Doris позволяет ранжировать совпадения полнотекстового поиска и получать top-K непосредственно в SQL. Так из корпуса в миллион строк можно выбрать десять лучших результатов без отдельной поисковой системы. Фильтры по равенству показывают, какие строки соответствуют условию. Но они не показывают, какие совпадения наиболее удачны. Запрос вида WHERE content MATCH_ANY 'apache doris real-time analytics' к таблице журналов с миллионом строк легко может вернуть 50,000 совпадений, хотя пользователю нужны только десять лучших. Без оценки релевантности у базы данных нет подходящего способа выбрать эти десять строк:
- При сортировке по дате идеально подходящий результат за прошлый год окажется далеко внизу.
- При сортировке по произвольному столбцу пользователю достанутся случайные результаты.
- Если вычислять релевантность в приложении, придётся построить половину поисковой системы поверх хранилища данных.
BM25 решает эту задачу внутри SQL. Apache Doris присваивает каждой подходящей строке оценку с учётом того, как часто в ней встречаются термы запроса, насколько редки эти термы во всей таблице и какова длина текста строки. Сортировка по этой оценке даёт ранжирование как в поисковой системе с помощью обычного SELECT.
Что такое оценка BM25 в Apache Doris?
Оценка BM25 в Apache Doris — это доступная через SQL реализация функции ранжирования по релевантности BM25 (Best Matching 25) из семейства TF-IDF. Функция принимает терм запроса и документ и возвращает положительное число: чем оно больше, тем выше релевантность. Оценка зависит от трёх факторов. Строки, в которых терм встречается чаще, получают более высокую оценку. Редкие термы имеют больший вес, чем распространённые. Кроме того, оценка длинных строк нормализуется в сторону уменьшения, чтобы строка из 200 слов не получала автоматически более высокую оценку, чем строка из 20 слов с тем же содержанием.
Apache Doris предоставляет доступ к BM25 через SQL-функцию score(). Инвертированный индекс уже хранит частоты термов, частоты документов с этими термами и длины полей, необходимые для формулы. Поэтому, если индекс создан, дополнительное сканирование для вычисления оценки не требуется.
Основные термины
score(): скалярная функция Apache Doris, которая возвращает оценку релевантности BM25 текущей строки относительно предикатовMATCH_*запроса. ВозвращаетFLOAT.- TF (частота терма): количество вхождений терма запроса в строку.
- IDF (обратная частота документа): мера того, насколько редко терм встречается в таблице. Распространённые слова получают низкую оценку, редкие — высокую.
k1иb: настроечные константы BM25. Apache Doris используетk1 = 1.2иb = 0.75— значения по умолчанию в Lucene. В настоящее время они недоступны в виде переменных сеанса.
Как работает оценка BM25 в Apache Doris?
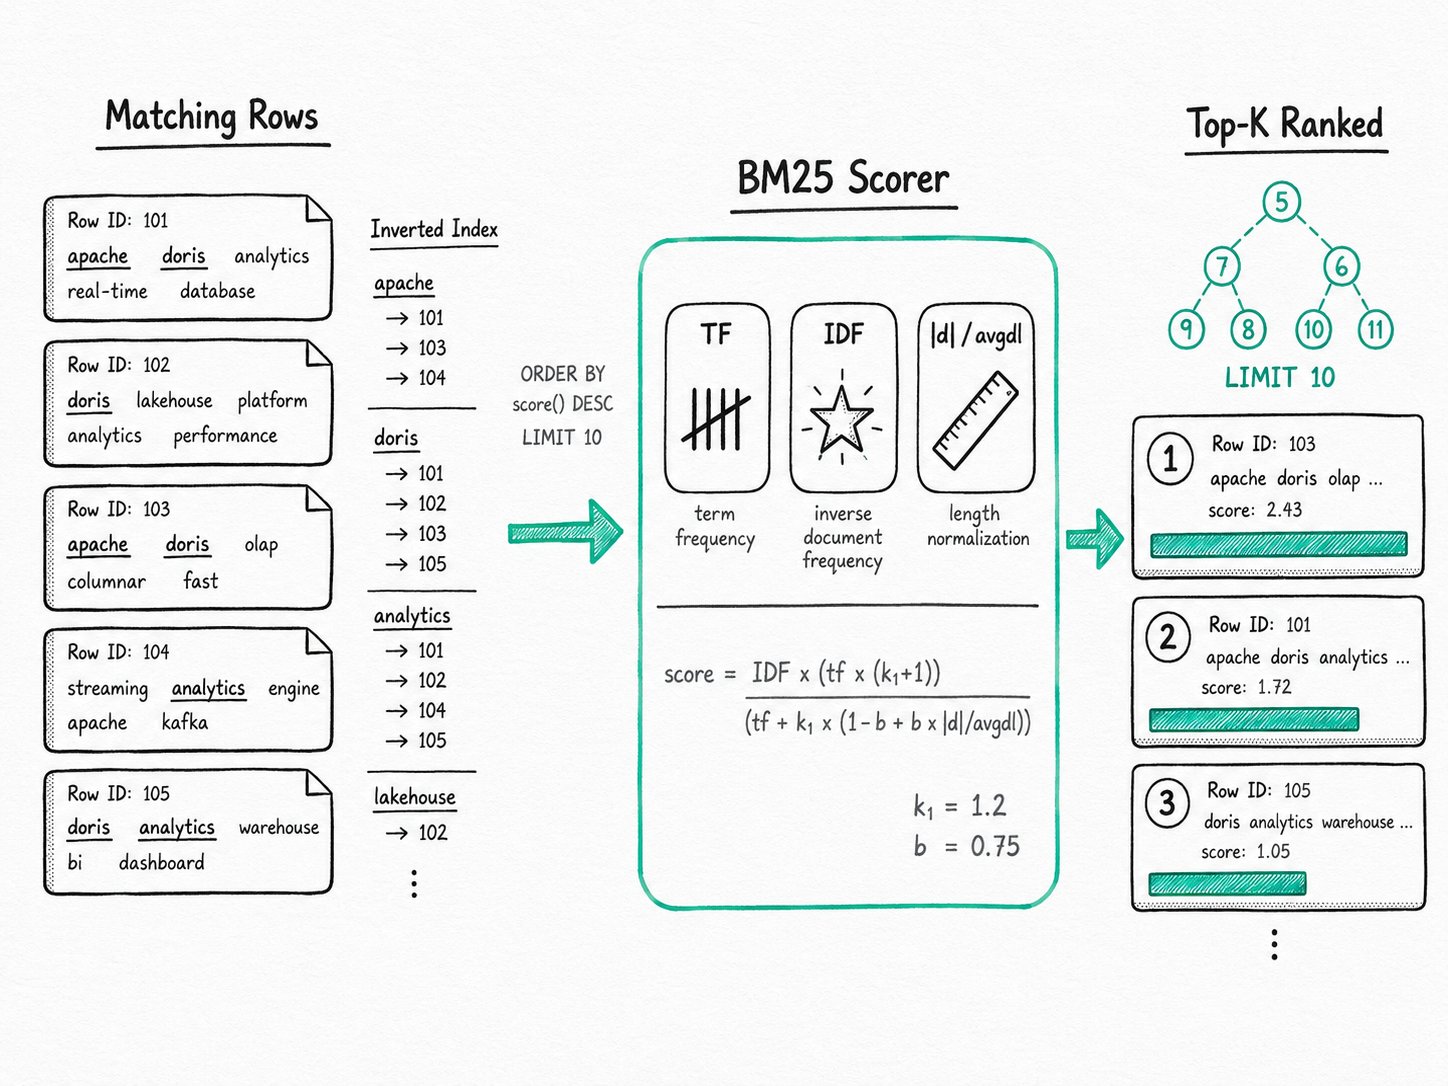
Apache Doris вычисляет BM25 внутри компонента чтения инвертированного индекса: планировщик распознаёт сочетание score() + MATCH_* + ORDER BY + LIMIT, BE оценивает строки при сканировании списков вхождений, а ограниченная минимальная куча размером LIMIT сохраняет только top-K.
- Инвертированный индекс сохраняет статистику. При загрузке данных в столбец с инвертированным индексом с токенизацией, использующим, например, парсеры
english,standardилиchinese, Apache Doris сохраняет словарь термов, частоты термов для каждой строки и длины полей. Та же статистика, которая обеспечивает фильтрациюMATCH_*, используется и для BM25. - Планировщик распознаёт структуру запроса для оценки. Если запрос содержит
score()в SELECT, предикатMATCH_*в WHERE иORDER BY score()сLIMIT, Nereids преобразует план, перенося вычисление оценок top-K на уровень хранения. Если использоватьscore()вне этой структуры, Apache Doris завершит запрос с ошибкойscore() function requires WHERE clause with MATCH function, ORDER BY and LIMIT for optimization. Это ограничение защищает от случайного вычисления оценок для всех строк таблицы с миллиардом строк. - BE вычисляет оценки при сканировании. Компонент чтения инвертированного индекса обходит списки вхождений для каждого терма запроса. Для каждой строки-кандидата он вычисляет
IDF * (tf * (k1 + 1)) / (tf + k1 * (1 - b + b * |d| / avgdl)), где|d|— длина строки в токенах, аavgdl— средняя длина по таблице. В запросах с несколькими термами оценки отдельных термов суммируются. - Куча сохраняет top-K. BE поддерживает ограниченную минимальную кучу размером
LIMIT, поэтому ему не требуется хранить в памяти весь набор совпадений. Вместо того чтобы сначала оценить 50,000 строк, а затем отсортировать их, он вычисляет оценки по мере чтения и сохраняет только десять лучших результатов. - Apache Doris возвращает ранжированные строки. FE объединяет уже отсортированные результаты top-K от каждого tablet и возвращает итоговый результат.
Быстрый старт
CREATE TABLE articles (
  id BIGINT,
  content TEXT,
  INDEX idx_content(content) USING INVERTED PROPERTIES("parser" = "english")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO articles VALUES
  (1, 'apache doris is a real-time analytics database'),
  (2, 'real-time analytics on streaming data'),
  (3, 'a guide to apache kafka');

SELECT id, content, score() AS relevance
FROM articles
WHERE content MATCH_ANY 'apache doris analytics'
ORDER BY relevance DESC
LIMIT 3;
Ожидаемый результат
+----+----------------------------------------------------+-----------+
| id | content                                            | relevance |
+----+----------------------------------------------------+-----------+
|  1 | apache doris is a real-time analytics database     |  1.871290 |
|  2 | real-time analytics on streaming data              |  0.575364 |
|  3 | a guide to apache kafka                            |  0.287682 |
+----+----------------------------------------------------+-----------+
Строка 1 получает наивысшую оценку, поскольку содержит все три терма запроса. Строка 2 содержит один редкий терм (analytics). Строка 3 содержит только apache, самый распространённый терм в этом корпусе, поэтому её оценка самая низкая. Абсолютные значения сами по себе ничего не означают. Важен порядок строк в пределах этого набора результатов.
Когда следует использовать оценку BM25 в Apache Doris?
Оценка BM25 в Apache Doris подходит для ранжирования top-K в полнотекстовом поиске и для текстовой составляющей гибридного поиска. Она не подходит для поиска по точному равенству, агрегаций по релевантности или сравнения оценок разных запросов.
Подходящие сценарии
- Полнотекстовый поиск top-K по журналам, документам, статьям, описаниям товаров или любому текстовому столбцу с инвертированным индексом с токенизацией.
- Текстовая составляющая запроса гибридного поиска, объединяемая с векторным сходством через SQL
ORDER BYили RRF. - Отказ от отдельного кластера Elasticsearch, единственная задача которого — ранжировать совпадения по данным, уже хранящимся в Doris.
- Запросы с несколькими термами, в которых пользователям важно найти лучшее совпадение, а не просто любое совпадение.
Неподходящие сценарии
- Поиск по точному равенству. Инвертированный индекс без токенизации не вычисляет оценки. Используйте
=илиINи полностью исключитеscore(). - Агрегации по результатам с оценками. Apache Doris не допускает
score()внутриGROUP BY, внутри агрегатных функций и в любом плане безORDER BY score() LIMIT. Если нужна аналитика по релевантности, сначала материализуйте top-K, а затем выполните агрегацию по полученному набору результатов. - Сравнение оценок разных запросов. BM25 зависит от корпуса и запроса. Оценка 3.0 в одном запросе и 3.0 в другом имеют разный смысл. Вместо этого используйте объединение на основе рангов, например RRF. См. Reciprocal Rank Fusion.
- Настройка
k1иbдля каждого запроса. Apache Doris использует значения по умолчанию в Lucene и в настоящее время не предоставляет эти константы как параметры времени выполнения. Если вашей рабочей нагрузке действительно нужна индивидуальная настройка, создайте issue, вместо того чтобы обходить ограничение с помощью самостоятельно реализованной оценки. - Чисто векторное ранжирование. Если запрос звучит как «найти 10 ближайших эмбеддингов без каких-либо ограничений по ключевым словам», используйте функцию расстояния ANN и не применяйте BM25.
Дополнительные материалы
- Инвертированный индекс: как Apache Doris хранит данные, которые использует BM25
- Полнотекстовый поиск: токенизаторы, операторы MATCH и функция SEARCH
- Гибридный поиск: объединение BM25 и векторного сходства в одном запросе
- Reciprocal Rank Fusion: независимый от запроса способ объединения ранжирований BM25 и векторного поиска
- Справочник по оценке релевантности: полная формула BM25, параметры и часто задаваемые вопросы
- Обзор инвертированного индекса: типы индексов, парсеры и поддерживаемые запросы