Колоночное хранение
Кратко Каждая OLAP-таблица Apache Doris записывает данные в колоночные файлы Segment. Для каждого столбца выбирается своё кодирование (PLAIN, dictionary, RLE, bit-shuffle, frame-of-reference), а каждая страница сжимается независимо (по умолчанию LZ4, опционально ZSTD). Постраничные карты зон и фильтры Блума позволяют запросам пропускать страницы без их декодирования, а футер V3, добавленный в 4.1, сокращает время открытия сегментов широких таблиц в 16 раз.
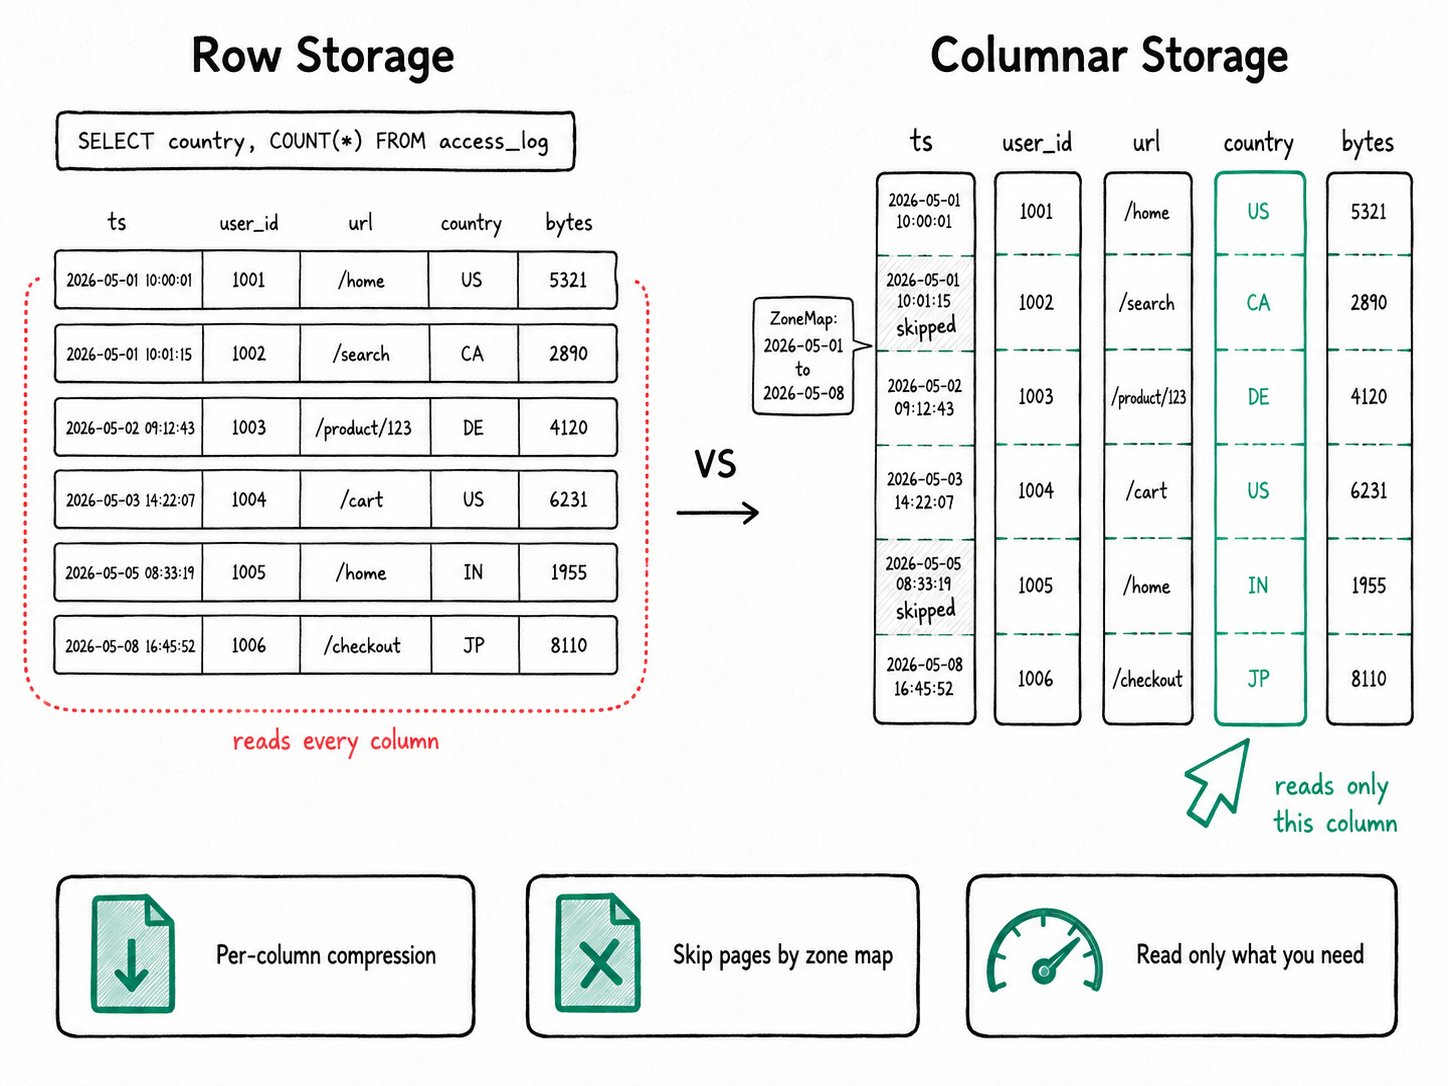
Зачем использовать колоночное хранение в Apache Doris?
Apache Doris хранит каждую OLAP-таблицу в колоночных файлах Segment, поскольку такое размещение ограничивает ввод-вывод столбцами, к которым обращается запрос, позволяет выбирать наиболее эффективный кодек для каждого столбца и удобно размещать индексы для пропуска данных. При выполнении аналитических запросов к строчному хранилищу сразу возникают три проблемы.
- Запрос с
GROUP BY countryк таблице из 50 столбцов всё равно читает байты остальных 49 столбцов. Затраты на ввод-вывод зависят от ширины строки, а не от числа столбцов в запросе. - Слабое сжатие. В соседних строках перемешаны данные разных типов, поэтому словарное кодирование, кодирование длин серий и дельта-кодирование не могут эффективно использовать сходство значений.
- Сложно пропускать данные. Чтобы определить, что «в этом блоке размером 64 KB нет строк, для которых
ts >= '2026-05-01'», нужна статистика по отдельным столбцам, а при строчном размещении для неё нет подходящего места.
Колоночное размещение решает все три проблемы. Значения одного столбца располагаются на диске рядом, поэтому кодек может выбрать преобразование, подходящее для их типа. А индексы страниц позволяют проверить предикаты ещё до того, как начнётся распаковка данных.
Что такое колоночное хранение Apache Doris?
Колоночное хранение Apache Doris представляет собой единый формат файлов сегментов на диске для всех OLAP-таблиц (Duplicate, Unique, Aggregate). Каждая загрузка создаёт один или несколько файлов Segment. Внутри сегмента каждый столбец записывается отдельно: значения потоком поступают на страницы размером ~64 KB, каждая страница кодируется и сжимается, а рядом записываются индексы для пропуска данных. Футер в конце файла содержит указатели на все его части.
Основные термины
Segment: единица неизменяемых данных на диске, обозначенная сигнатуройD0R1. Значения по умолчанию: размер страницы 64 KB, размер страницы словаря 256 KB, предельный размер сегмента 256 MB. Определён вbe/src/storage/segment/segment.h.Page: часть значений одного столбца. На этом уровне выполняется сжатие и собирается статистика карты зон.Encoding: преобразование отдельного столбца перед сжатием. PLAIN для числовых данных общего назначения, DICT для строк с низкой кардинальностью, RLE для булевых значений, BIT_SHUFFLE для целочисленных столбцов, FOR (frame-of-reference) для дат, BINARY_PLAIN_V2 для строк в V3.Page indexes: индекс порядковых номеров, индекс короткого ключа, карта зон (постраничные min/max и has-null) и фильтр Блума. Все они записываются в сегмент вместе с данными.Footer: запись protobuf в конце файла, описывающая каждый столбец, каждое кодирование, каждый указатель на страницу и расположение каждого индекса. V3 (4.1+) выносит метаданные столбцов за пределы футера, чтобы при открытии широкого сегмента не приходилось читать их целиком.
Как работает колоночное хранение Apache Doris?
Apache Doris записывает каждый столбец внутри сегмента независимо: кодирует, разбивает на страницы размером ~64 KB, сжимает, индексирует и добавляет футер. Жизненный цикл одного столбца на диске:
- Кодирование. Способ кодирования выбирается по типу столбца и распределению значений. Для столбца
INTс низкой кардинальностью используется bit-shuffle; для строкового столбца с небольшим числом различных значений создаётся словарь на отдельной странице словаря. - Разбиение на страницы и сжатие. Закодированные значения потоком поступают на страницы размером около 64 KB каждая. По умолчанию каждая страница сжимается с помощью LZ4F либо с помощью ZSTD / Snappy / Zlib, если в таблице задано свойство
compression. Сжатие пропускается, если экономия составляет менее 10%. - Индексирование. По мере записи страниц в сегмент также записываются индекс порядковых номеров (двоичный поиск по номеру строки), карта зон для каждой страницы (min, max, has-null) и фильтр Блума для каждого столбца, указанного в
bloom_filter_columns. Индекс короткого ключа содержит сводные сведения о префиксе ключа сортировки таблицы. - Футер. В конец файла добавляется
SegmentFooterPB, описывающий каждый столбец, каждый указатель на страницу и каждый индекс. В V3 он разделён на две части: компактный футер и областьcolumn_meta_entries, которая загружается только для столбцов, к которым действительно обращается запрос. - Чтение. При сканировании открывается футер, круг нужных страниц сужается с помощью индекса порядковых номеров / индекса короткого ключа / карты зон / фильтра Блума, распаковываются только оставшиеся страницы, затем они декодируются, и пакеты данных по столбцам передаются напрямую в векторизованный движок.
Сегмент входит в иерархию Tablet → Rowset → Segment → Column → Page. Компактизация объединяет rowset, но никогда не перезаписывает данные на более мелком уровне; каждый запрос читает данные из лежащей ниже структуры столбцов и страниц.
Быстрый старт
CREATE TABLE access_log (
  ts DATETIME,
  user_id BIGINT,
  url VARCHAR(512),
  country CHAR(2)
)
DUPLICATE KEY(ts, user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "compression" = "zstd",
  "bloom_filter_columns" = "url",
  "storage_format" = "V3"
);

SELECT country, COUNT(*) AS hits
FROM access_log
WHERE ts >= '2026-05-01'
GROUP BY country
ORDER BY hits DESC;
Ожидаемый результат
+---------+--------+
| country | hits   |
+---------+--------+
| US      | 184320 |
| DE      |  62018 |
| ...     |        |
+---------+--------+
Запрос читает только столбцы ts и country. Ещё до распаковки пропускаются страницы, для которых карта зон показывает max(ts) < 2026-05-01. ZSTD обычно уменьшает размер таблицы в 5–10 раз, а футер V3 сохраняет затраты на открытие сегмента на постоянном уровне при росте числа столбцов.
Когда следует использовать колоночное хранение Apache Doris?
Колоночное хранение Apache Doris является форматом OLAP по умолчанию и единственным доступным форматом, поэтому его использует каждая аналитическая таблица; компромиссы возникают только в особых сценариях, таких как точечные запросы с высоким QPS и настройка кодеков.
Подходящие сценарии
- Любая аналитическая таблица, с которой вы работаете в Apache Doris. Колоночное хранение обязательно: это формат OLAP по умолчанию и единственный доступный формат.
- Широкие таблицы и запросы для дашбордов. Чем шире таблица и чем меньше столбцов выбирает запрос, тем больше экономия по сравнению со строчным хранилищем.
- Таблицы, в которые часто загружаются данные. Сжатие столбцов и постраничные карты зон работают эффективнее по мере накопления строк при неизменной схеме.
- Широкие таблицы с тысячами столбцов. Установите
"storage_format" = "V3"(4.1+), чтобы ограничить время открытия сегментов и потребление памяти.
Неподходящие сценарии
- Поиск по первичному ключу с
SELECT *при тысячах QPS. Каждый столбец читается отдельно, поэтому точечный запрос к широкой строке требует в N раз больше операций ввода-вывода. Используйте механизм высокопараллельных точечных запросов, который добавляет столбец с кэшированными строками с помощью"store_row_column" = "true"в таблицу Unique-Key Merge-on-Write. - Настройка
compressionилиstorage_page_sizeбез профилирования. Значения по умолчанию (LZ4F, 64 KB) подходят для большинства нагрузок. Переходите на ZSTD, только если стоимость хранения важнее затрат CPU; уменьшайте размер страницы, только если при распаковке небольших столбцов выполняется лишняя работа. - Отключение кодирования, чтобы «увидеть столбец в исходном виде». Режима без кодирования нет. Кодек является частью формата файла, а не слоем, который можно убрать.
- Попытка ускорить точечные запросы с выборкой небольшого числа столбцов в строчной схеме за счёт колоночного хранения. Если каждый запрос имеет вид
WHERE id = ?и возвращает одну строку, вам нужна другая система или расширение для строчного хранения, а не другой кодек сжатия.
Производительность / показатели
- Футер V3 для широких таблиц: на таблице с 7,000 столбцов и 10,000 сегментов время открытия сегментов сократилось с 65 с до 4 с (в 16 раз быстрее), а потребление памяти при открытии снизилось с 60 GB до менее 1 GB (в 60 раз меньше). Источник: Формат хранения V3.
- ZSTD в сравнении с прежним вариантом по умолчанию на наборе текстовых журналов объёмом 25 GB / 110 миллионов строк: сжатие почти в 10 раз, что на 53% лучше прежнего варианта по умолчанию, а полный цикл чтения и распаковки выполняется на 30% быстрее. Источник: Примечания к выпуску Apache Doris 1.1.0.
Дополнительные материалы
- Формат хранения V3: оптимизация футера для широких таблиц и вынос метаданных отдельных столбцов за его пределы.
- Отсечение данных: как ZoneMap, BloomFilter и постраничные индексы внутри сегмента позволяют пропускать данные при сканировании.
- Векторизованное выполнение: движок, которому механизм чтения столбцов передаёт декодированные пакеты данных.
- Тип данных VARIANT: как пути JSON преобразуются в подстолбцы с тем же кодированием, разбиением на страницы и индексированием, которые описаны здесь.
- Примечания к выпуску Apache Doris 1.1.0: исходный тест производительности сжатия ZSTD и сведения о его внедрении.