Эмбеддинги
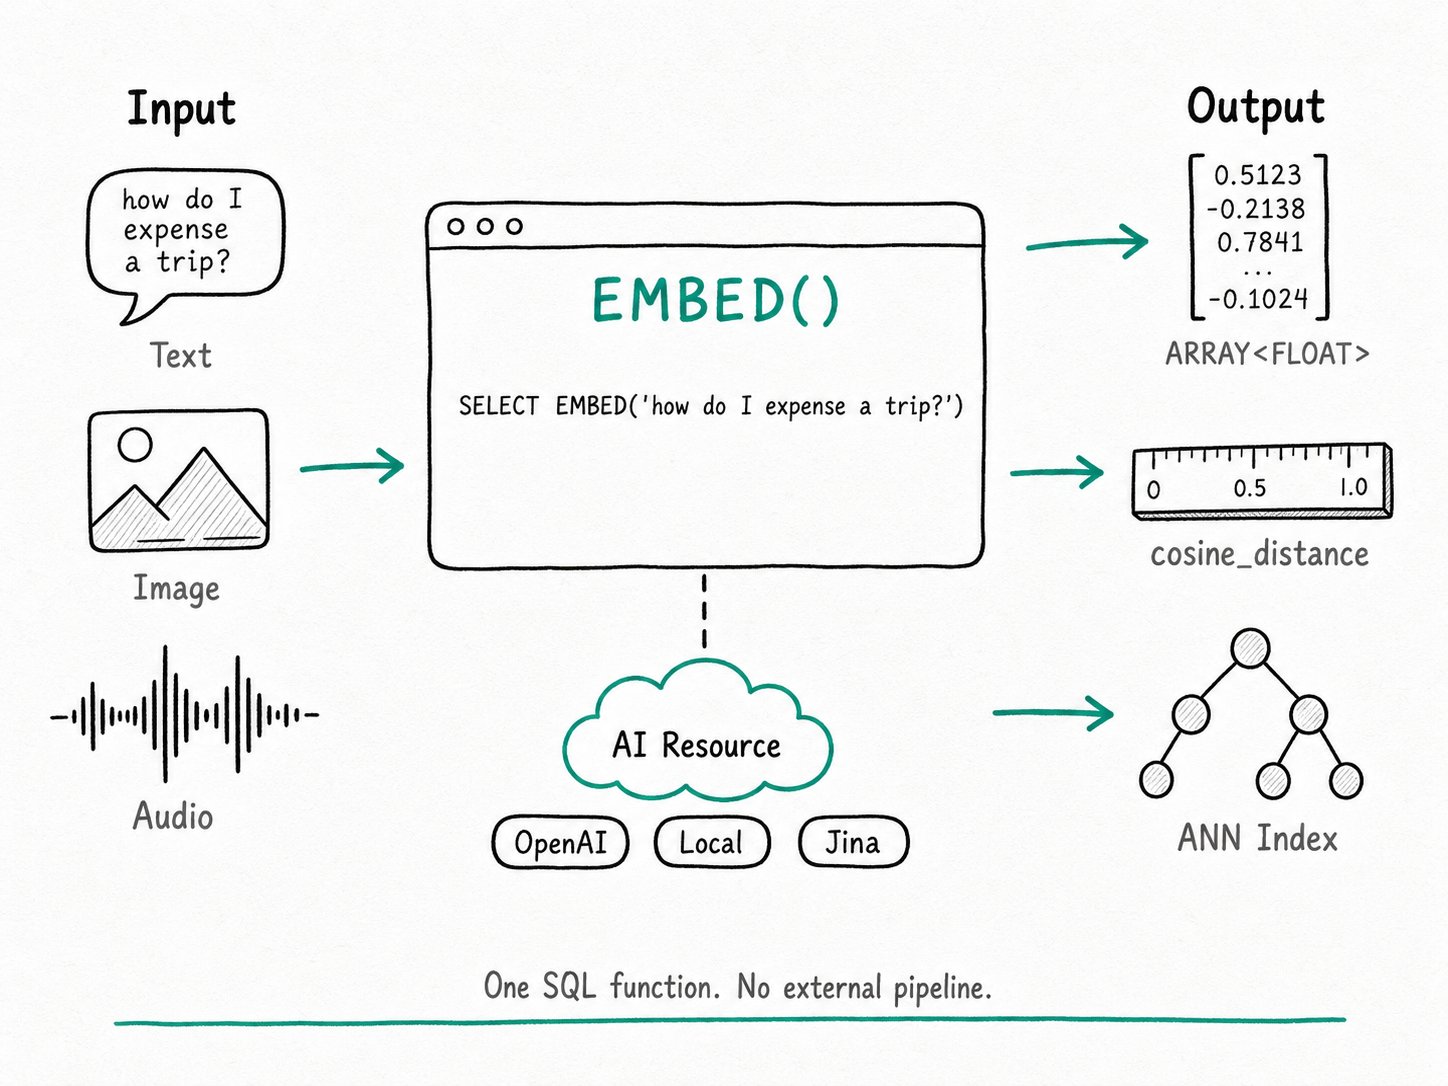
Кратко В Apache Doris есть встроенная SQL-функция
EMBED(), которая отправляет текст (или изображение, видео, аудиофайл) во внешнюю модель эмбеддингов и возвращаетARRAY<FLOAT>, который можно сохранить в столбце или передать в функцию вычисления расстояния. Модель один раз настраивается как AI-ресурсRESOURCE, после чегоEMBED('your text')можно использовать везде, где допустимо значение. Не нужны UDF, связующий код на стороне клиента и отдельный сервис, который придётся обслуживать.
Зачем использовать функцию EMBED в Apache Doris?
Функция EMBED() в Apache Doris сводит обычный конвейер создания эмбеддингов на стороне приложения к одному SQL-вызову. Векторы создаются, сохраняются и используются в запросах внутри базы данных без отдельного ETL-сервиса. Для векторного поиска нужны векторы, а векторы создаёт модель эмбеддингов. Обычно всё устроено так: сервер приложения извлекает строки из базы данных, отправляет их в OpenAI или локальную модель, получает векторы и записывает их в таблицу векторов. При выполнении запроса тот же цикл повторяется для поисковой строки. В результате приходится поддерживать небольшой ETL-сервис, единственная задача которого состоит в том, чтобы вызывать HTTP API и куда-то сохранять результат.
Часто возникают следующие проблемы:
- Конвейер теряет синхронизацию с исходной таблицей. Новые строки остаются без эмбеддингов до следующего запуска пакетной обработки.
- Дозаполнение существующих данных превращается в отдельную задачу, которая нередко выполняется медленнее и обходится дороже первоначальной загрузки.
- За один логический шаг отвечают две команды. Команда данных отвечает за строки, команда приложения отвечает за векторы, а за разрыв между ними не отвечает никто.
EMBED() возвращает весь этот цикл в SQL. Модель становится ресурсом Apache Doris, вызов становится функцией, а результат становится столбцом, который можно сохранить с помощью INSERT или вычислить на лету.
Что такое функция EMBED в Apache Doris?
Функция EMBED() в Apache Doris представляет собой встроенную AI-функцию, которая принимает текст или ссылку на мультимодальный файл, запрашивает вектор у внешнего провайдера эмбеддингов и возвращает ARRAY<FLOAT>. Apache Doris обращается к провайдеру через AI-ресурс, который достаточно один раз настроить с помощью CREATE RESOURCE. Один и тот же вызов функции работает как при загрузке данных, позволяя сохранять эмбеддинги в столбце, так и при выполнении запросов, позволяя создавать эмбеддинг поисковой строки пользователя на лету, не выходя за пределы SQL.
Основные термины
- AI-ресурс: именованное подключение к провайдеру эмбеддингов. В
EMBED()есть отдельные адаптеры дляopenai,gemini,voyageai,jina,qwen,minimax, а также вариантlocalдля собственных серверов моделей. Ресурс хранит адрес API, имя модели, ключ API и необязательную размерность. EMBED([resource_name], input): SQL-функция. При одном аргументе Apache Doris использует ресурс по умолчанию для сессии; при двух первый аргумент явно задаёт имя ресурса.default_ai_resource: переменная сессии, которая выбирает ресурс для дальнейшей работы в этой сессии.- Мультимодальные входные данные: значение JSON, описывающее файл (URI, тип содержимого, необязательные учётные данные S3). Apache Doris формирует подписанные URL для S3 и передаёт их провайдерам, поддерживающим эмбеддинги изображений, видео или аудио.
Как работает функция EMBED в Apache Doris?
Работа функции EMBED() в Apache Doris состоит из пяти этапов: регистрация AI-ресурса, планирование вызова на FE, объединение строк в пакеты на BE, повторные попытки при сбоях и возврат одного ARRAY<FLOAT> для каждой строки.
- Регистрация модели.
CREATE RESOURCEсохраняет тип провайдера, адрес API, имя модели и учётные данные. Apache Doris проверяет ресурс пробным вызовом провайдера, кроме случаяprovider_type = "local", когда проверка пропускается. - Планирование вызова. Когда планировщик встречает
EMBED(), он передаёт работу на BE. Функция обрабатывает входной столбец построчно, но не вызывает провайдера отдельно для каждой строки. - Формирование пакетов на BE. BE накапливает строки в пакете, ограниченном параметром
embed_max_batch_size(по умолчанию 5 входных значений) и параметромai_context_window_size(по умолчанию 128 КБ накопленного текста). Каждый пакет отправляется одним HTTP-запросом, что помогает контролировать число сетевых обращений и соблюдать поминутные ограничения частоты запросов. - Повторные попытки и явное завершение с ошибкой. При вызове провайдера учитываются параметры ресурса
ai.max_retriesиai.retry_delay_second. Если API возвращает неверное количество векторов, Apache Doris завершает запрос с ошибкой, чтобы не допустить нарушения соответствия между строками и векторами. - Возврат столбца. Каждая строка получает собственный
ARRAY<FLOAT>. Его можно сохранить, передать вcosine_distanceили загрузить в ANN-индекс для векторного поиска.
Быстрый старт
CREATE RESOURCE "openai_embed" PROPERTIES (
  "type" = "ai", "ai.provider_type" = "openai",
  "ai.endpoint"   = "https://api.openai.com/v1/embeddings",
  "ai.model_name" = "text-embedding-3-small",
  "ai.api_key"    = "sk-xxx", "ai.dimensions" = "8"
);

SET default_ai_resource = "openai_embed";

CREATE TABLE notes (id INT, body STRING, vec ARRAY<FLOAT>)
  DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO notes VALUES
  (1, 'travel reimbursement policy', EMBED('travel reimbursement policy')),
  (2, 'VPN setup guide',             EMBED('VPN setup guide'));

SELECT id, body, cosine_distance(vec, EMBED('how do I expense a trip?')) AS d
FROM notes ORDER BY d ASC LIMIT 1;
Ожидаемый результат
+----+-----------------------------+--------+
| id | body                        | d      |
+----+-----------------------------+--------+
|  1 | travel reimbursement policy | 0.4463 |
+----+-----------------------------+--------+
Оператор INSERT заранее вычисляет по одному вектору для каждой строки. Оператор SELECT один раз создаёт эмбеддинг строки запроса во время выполнения, а затем ранжирует строки по косинусному расстоянию. Всего два вызова API, оба выполняются внутри SQL.
Быстрый старт с мультимодальными данными
Для создания мультимодального эмбеддинга передайте JSON-объект вместо текстовой строки. Объект должен содержать URI файла в поле uri и его MIME-тип в поле content_type. URI может быть URL по протоколу HTTP или HTTPS либо URI, совместимым с S3. Убедитесь, что настроенные провайдер и модель поддерживают тип входных медиафайлов.
В этом примере создаётся эмбеддинг видео, хранящегося в объектном хранилище, совместимом с S3:
SELECT ARRAY_SIZE(
  EMBED(
    'multimodal_embed_resource',
    CAST('{
      "uri": "s3://example-bucket/videos/demo.mp4",
      "content_type": "video/mp4",
      "endpoint": "s3.us-east-1.amazonaws.com",
      "region": "us-east-1",
      "ak": "<access_key>",
      "sk": "<secret_key>"
    }' AS JSON)
  )
) AS video_embedding_dimension;
Пример результата
+---------------------------+
| video_embedding_dimension |
+---------------------------+
|                      2560 |
+---------------------------+
Размерность вектора зависит от настроенных провайдера и модели, поэтому результат выше приведён лишь для примера. Для URL по протоколу HTTP или HTTPS требуются только uri и content_type. Для URI, совместимого с S3, Doris формирует подписанный URL и поддерживает как учётные данные AK/SK, так и аутентификацию через роль IAM с помощью role_arn и external_id.
Когда стоит использовать функцию EMBED в Apache Doris?
Функция EMBED() в Apache Doris подходит для RAG и семантического поиска по корпусам данных, которые уже хранятся в Apache Doris, для дозаполнения данных средствами SQL, для гибридных конвейеров, сочетающих векторы с фильтрами по ключевым словам, а также для мультимодальных эмбеддингов, исходные файлы которых хранятся в S3. Она не подходит для построчного создания эмбеддингов по миллионам строк на критическом пути выполнения, для моделей вне списка поддерживаемых провайдеров и для изолированных кластеров без доступа к провайдеру.
Подходящие сценарии
- RAG и семантический поиск, когда корпус данных уже хранится в Apache Doris и вы хотите поручить одной системе загрузку данных, создание эмбеддингов и поиск.
- Дозаполнение существующих таблиц:
UPDATE t SET vec = EMBED(body) WHERE vec IS NULLпозволяет выполнить работу внутри базы данных. - Гибридные конвейеры, объединяющие
EMBED()с ANN-индексом для хранения и предикатомMATCH_*для фильтрации по ключевым словам. См. Гибридный поиск. - Мультимодальные эмбеддинги (изображения, видео, аудио), когда файл хранится в S3 и вы предпочитаете обойтись без скрипта, который сначала скачивает файл, а затем загружает его.
Неподходящие сценарии
- Запросы реального времени, при которых эмбеддинги вычисляются отдельно для каждой из миллионов строк. Каждая строка требует одного вызова провайдера, поэтому стоимость и задержка растут с числом строк. Вычисляйте эмбеддинги один раз и используйте их многократно.
- Нагрузки, которым нужна конкретная модель эмбеддингов вне списка поддерживаемых провайдеров. Адаптеры для эмбеддингов есть у OpenAI, Gemini, VoyageAI, Jina, Qwen и MiniMax, а для собственного сервера моделей предусмотрен вариант
local. Более широкий список AI-ресурсов Apache Doris также включает DeepSeek, MoonShot, Anthropic, Zhipu и Baichuan, но они работают через SQL-функции LLM и поддерживают только чат и дополнение текста, а неEMBED(). Для подключения моделей вне набора адаптеров эмбеддингов требуется API, совместимый с OpenAI или Gemini. - Изолированные кластеры без доступа к провайдеру. Используйте
provider_type = "local"с собственным сервером моделей или заранее вычисляйте векторы в своём конвейере. - Столбцы, для которых размерность модели эмбеддингов не совпадает с размерностью ANN-индекса. Длина ARRAY определяется моделью (или параметром
ai.dimensionsу моделей с поддержкой усечения); размерность индекса задаётся при создании таблицы. При несовпадении запись завершается ошибкой.
Стоимость и пропускная способность
Скорость EMBED() ограничена скоростью провайдера. Прежде чем использовать EMBED() на критическом пути выполнения, учтите следующее:
- У внешних API есть ограничения частоты запросов. Увеличение
embed_max_batch_sizeсокращает число сетевых обращений, но увеличивает количество токенов в каждом запросе, поэтому подбирайте настройки с учётом обоих ограничений. - Если входные данные строки превышают
ai_context_window_size, для неё автоматически создаётся отдельный пакет, чтобы один слишком большой документ не задерживал остальную часть запроса. - Провайдер взимает плату за входные токены, а не за строки. Создание эмбеддинга одного и того же текста дважды обходится вдвое дороже. Если вектор понадобится прочитать больше одного раза, сохраните его.
- Провайдеры
localпропускают проверку учётных данных и работают внутри вашей сети. Это избавляет от оплаты за каждый токен, но требует самостоятельно обслуживать сервер инференса.
Дополнительные материалы
- Справочник по функции EMBED: полный синтаксис, мультимодальные входные данные JSON и примеры для разных метрик расстояния.
- Обзор AI-функций: все поддерживаемые провайдеры и полный список свойств для
CREATE RESOURCE. - Гибридный поиск: как объединить
EMBED()с полнотекстовым предикатом и ANN-индексом в одном запросе. - Обзор векторных индексов: как хранить эмбеддинги в индексах HNSW или IVF для поиска ближайших соседей методом ANN в больших объёмах данных.
- Инвертированный индекс: индекс для предварительной фильтрации строк перед ранжированием векторов в гибридном запросе.
- Слияние обратных рангов (Reciprocal Rank Fusion): как объединить ранги BM25 и векторного поиска после создания эмбеддингов.
- SQL-функции LLM:
EMBED()использует ту же модель AI-ресурсов, что и семействоAI_*; это другая часть возможностей AI в SQL. - AI в Doris: остальные функции семейства AI, включая классификацию, генерацию и агрегацию по нескольким строкам.