Полнотекстовый поиск
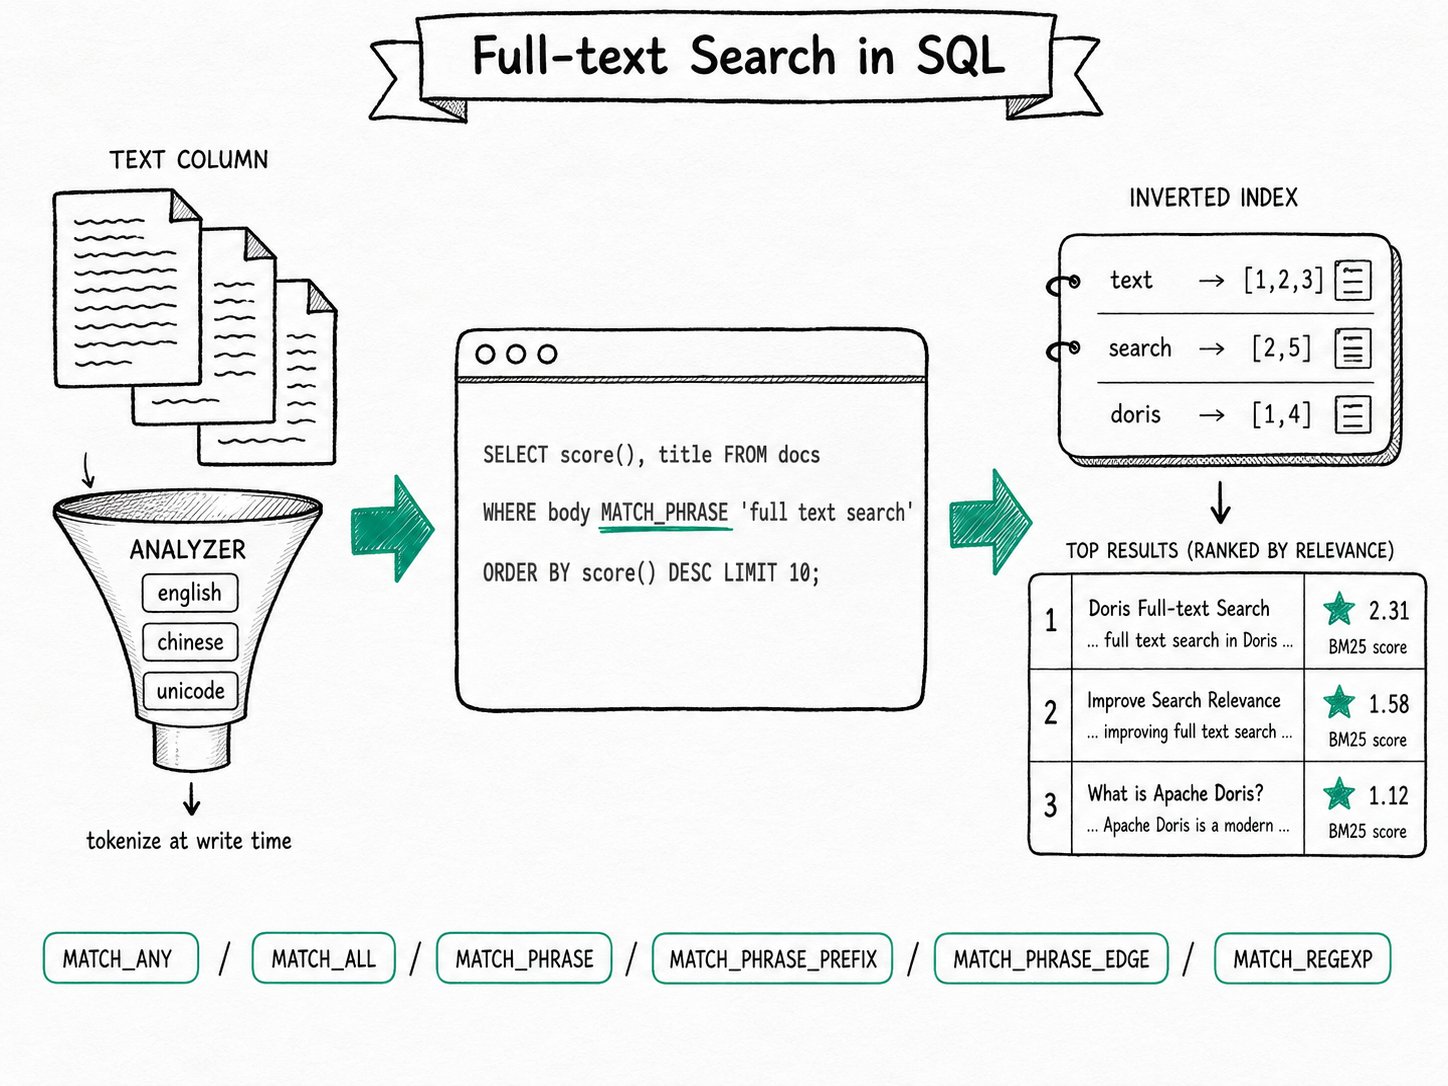
Кратко Полнотекстовый поиск Apache Doris преобразует текстовые столбцы в термы для поиска с помощью инвертированного индекса и предоставляет доступ к ним через шесть операторов
MATCH_*в SQL:MATCH_ANY,MATCH_ALL,MATCH_PHRASE,MATCH_PHRASE_PREFIX,MATCH_PHRASE_EDGEиMATCH_REGEXP. Вы выбираете токенизатор при создании индекса и пишете обычный SQL-запрос. Планировщик Apache Doris передаёт предикат на уровень индекса, поэтому отдельный поисковый кластер не требуется.
Зачем использовать полнотекстовый поиск в Apache Doris?
Полнотекстовый поиск Apache Doris объединяет полноценный поиск по тексту и аналитику хранилища данных в одном движке. Его операторы учитывают токены и значительно превосходят поиск подстрок с LIKE. Большинство хранилищ данных предлагают LIKE '%foo%' и называют это текстовым поиском. Такой подход работает для одной строки из десяти тысяч. Но его возможностей уже недостаточно, когда нужно найти все комментарии к заказам с упоминанием «battery» или «batteries», все строки журнала с фразой «connection refused» или все товары, описание которых начинается с «wireless».
LIKE читает каждое значение целиком, байт за байтом. Оператор не знает, что «Running» и «running» — одно и то же слово, а «search engine optimization» — три терма в определённом порядке, а не просто подстрока. Обычное обходное решение — подключить Elasticsearch, оплачивать второй кластер и писать ненадёжные конвейеры синхронизации.
Apache Doris объединяет всё это в одном движке. Та же таблица, которая обслуживает агрегатные запросы, обслуживает и текстовые, а названия операторов привычны для SQL.
- Поиск подстрок с
LIKEтребует полного сканирования. Инвертированный индекс сводит обработку текстовых предикатов к поиску по спискам вхождений. - Поиск по мере ввода, поиск фраз и регулярные выражения для токенов требуют правил сопоставления, которые невозможно выразить через
LIKE. - Сочетания структурированных и текстовых предикатов (
category = 'A' AND content MATCH_ANY 'doris') планируются и выполняются в одном запросе.
Что такое полнотекстовый поиск Apache Doris?
Полнотекстовый поиск Apache Doris — это возможность выполнения запросов на основе инвертированного индекса. Вы объявляете индекс INVERTED для столбца типа STRING, TEXT, VARCHAR или ARRAY<STRING>, выбираете анализатор, после чего операторы MATCH_* из предложений WHERE передаются на уровень индекса. Базовая таблица остаётся обычной таблицей Apache Doris, к которой уже обращаются ваши панели мониторинга.
Основные термины
- Анализатор (parser): конвейер, преобразующий исходный текст в термы для поиска. Среди встроенных вариантов —
none(точное совпадение),english,chinese,unicode,standardиicu. Пользовательские анализаторы позволяют объединять в цепочкуchar_filter,tokenizerи один или несколько этаповtoken_filter. - Запрос по термам: сопоставляет отдельные токены.
MATCH_ANYобъединяет термы по OR, аMATCH_ALL— по AND. - Запрос по фразе: сопоставляет соседние токены в заданном порядке. Для парсеров без токенизации требуется установить свойство индекса
"support_phrase" = "true". score(): оценка релевантности BM25, доступная при наличии индекса с токенизацией, предикатаMATCH_*и конструкцииORDER BY score() LIMIT N.
Как работает полнотекстовый поиск Apache Doris?
Полнотекстовый поиск Apache Doris токенизирует текст при записи, распознаёт каждый предикат MATCH_* в оптимизаторе Nereids и передаёт его на уровень инвертированного индекса, благодаря чему строки, не соответствующие условию, вообще не декодируются. Описанный ниже цикл из пяти шагов охватывает разбор запроса, передачу предикатов на нижний уровень, вычисление оценок и сочетание со структурированными предикатами.
- Токенизация при записи. Когда строка поступает в tablet, анализатор разбивает каждое текстовое значение на термы. Для каждого терма инвертированный индекс записывает, в каких строках и на каких позициях он встречается.
- Разбор запроса. Nereids распознаёт оператор
MATCH_*как один из следующих типов:Match,MatchAny,MatchAll,MatchPhrase,MatchPhrasePrefix,MatchPhraseEdgeилиMatchRegexp. Каждый из них содержит указание анализатора, определяющего способ токенизации самой строки запроса. - Передача на уровень индекса. BE находит соответствующие списки вхождений, пересекает или объединяет их в зависимости от оператора и возвращает битовую карту строк. Строки, не соответствующие условию, вообще не декодируются.
- Вычисление оценки по запросу. Если запрос содержит
SELECT score() ... ORDER BY score() DESC LIMIT N, Doris вычисляет BM25 с учётом частоты термов, обратной частоты документов и нормализации по длине, а затем возвращает лучшие N результатов. Без этих трёх составляющих предикат работает как обычный фильтр. - Свободное сочетание условий. Один запрос может сочетать
MATCH_*с=,IN, фильтрами по диапазону, соединениями и агрегациями. Оптимизатор рассматривает текстовые предикаты как ещё один вид предикатов, передаваемых на нижний уровень.
Быстрый старт
CREATE TABLE articles (
  id INT,
  title  STRING,
  body   STRING,
  INDEX idx_body (body) USING INVERTED
    PROPERTIES("parser" = "english", "support_phrase" = "true")
) DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;

INSERT INTO articles VALUES
  (1, 'Doris 4.0 release', 'Apache Doris adds BM25 scoring for full-text search'),
  (2, 'Storage notes',     'Inverted indexes accelerate text and structured filters'),
  (3, 'Vector primer',     'Approximate nearest neighbor search complements text search');

SELECT id, title, score() AS rel
FROM articles
WHERE body MATCH_ANY 'text search'
ORDER BY rel DESC LIMIT 3;
Ожидаемый результат
+------+-------------------+------------+
| id   | title             | rel        |
+------+-------------------+------------+
|    3 | Vector primer     |  0.8009131 |
|    1 | Doris 4.0 release |  0.5634479 |
|    2 | Storage notes     | 0.13845673 |
+------+-------------------+------------+
MATCH_ANY 'text search' токенизирует запрос на text и search, находит оба списка вхождений и возвращает строки, содержащие хотя бы один из термов. score() ранжирует их по BM25, когда конструкция ORDER BY rel LIMIT 3 заставляет оптимизатор рассматривать запрос как Top-N: строка 3 содержит оба терма (search встречается дважды), строка 1 содержит каждый из них по одному разу, а строка 2 содержит только text.
Краткий обзор семейства операторов
| Оператор | Для чего использовать |
|---|---|
MATCH / MATCH_ANY | Поиск любого из указанных ключевых слов (OR) |
MATCH_ALL | Поиск с обязательным присутствием всех ключевых слов (AND) |
MATCH_PHRASE 'a b' | Соседние термы в заданном порядке; поддерживает ~slop и ~slop+ со строгим порядком |
MATCH_PHRASE_PREFIX 'a b' | Фраза, в которой последний терм является префиксом; используется для поиска по мере ввода |
MATCH_PHRASE_EDGE 'a b c' | Суффикс первого терма, точное совпадение промежуточных термов, префикс последнего терма |
MATCH_REGEXP '^abc.*' | Регулярное выражение, применяемое к токенам, а не к исходным байтам |
Если для одного столбца существует несколько инвертированных индексов с разными анализаторами, добавьте USING ANALYZER <name>, чтобы выбрать анализатор при выполнении запроса.
Когда следует использовать полнотекстовый поиск Apache Doris?
Используйте полнотекстовый поиск Apache Doris для поиска по журналам и трассировкам, каталогам товаров в электронной коммерции, смешанному содержимому на языках CJK и латинице, поиска по мере ввода и конвейеров RAG, сочетающих текстовые совпадения с векторным сходством. Обращайтесь к LIKE или индексам n-gram, когда нужны поиск подстрок внутри токенов, нечёткое сопоставление по редакционному расстоянию или подсветка результатов.
Подходящие сценарии
- Поиск по журналам и трассировкам, в котором пользователи сочетают свободный текст со структурированными фильтрами (
level = 'ERROR' AND message MATCH_ANY 'timeout disconnect'). - Поиск в электронной коммерции и каталогах, где одна строка содержит цену, категорию и описание.
- Смешанное содержимое на языках CJK и латинице: парсеры
chinese,unicodeиicuобрабатывают оба вида текста в одном столбце. - Поиск по мере ввода, в котором
MATCH_PHRASE_PREFIXвозвращает варианты завершения без отдельного сервиса автодополнения. - Конвейеры RAG, сочетающие текстовые совпадения со сходством эмбеддингов. См. раздел Гибридный поиск, где описано объединение
MATCH_*с векторным расстоянием в одном SQL-запросе.
Неподходящие сценарии
- Поиск подстроки внутри отдельного токена, например всех строк, где столбец содержит «ear» внутри «year». Токенизация не сохраняет такое представление данных. Используйте
LIKE, индекс N-Gram BloomFilter или инвертированный индекс без токенизации. - Нечёткое сопоставление или сопоставление по редакционному расстоянию («возможно, вы имели в виду...»). Сейчас в Doris нет встроенного оператора нечёткого поиска. Выполняйте предварительную обработку при записи с помощью фонетического анализатора или анализатора n-gram либо формируйте варианты нечёткого запроса в приложении.
- Подсветка результатов: возврат совпавшего фрагмента с разметкой. Doris вычисляет оценки, но сейчас не возвращает фрагменты с подсветкой. Формируйте подсветку в приложении на основе совпавших термов.
- Ранжирование релевантности по нескольким полям, подобное
dis_maxв Elasticsearch.score()вычисляется для каждого предиката отдельно. Если нужны более сложные стратегии оценки, используйтеSEARCH('title:foo OR body:foo')и настраивайте ранжирование на уровне приложения.
Выбор токенизатора
Выбор анализатора имеет решающее значение. Он определяет, какие запросы смогут находить совпадения, а индексируемые термы фиксируются при записи.
none: без токенизации. Всё значение представляет собой один терм. Подходит для идентификаторов, тегов, перечислений статусов и фильтров точного совпадения.english: выделение слов ASCII с лёгкой нормализацией. Подходит для текста на английском языке.chinese: сегментация китайского текста на слова со значениемparser_mode, равнымfine_grainedилиcoarse_grained. Подходит для содержимого на языках CJK.kuromoji(5.0.0+): морфологический анализ японского языка. В японском языке между словами нет пробелов, поэтому текст разбивается на морфемы на основе словаря.parser_modeпозволяет выбратьsearch(по умолчанию; дополнительно разбивает длинные составные существительные для повышения полноты поиска),normalилиextended. Подходит для содержимого на японском языке. По умолчанию отключён. Чтобы включить его, задайтеenable_kuromoji_analyzer = trueвbe.conf.unicode: выделение границ слов без привязки к языку с обработкой CJK и пунктуации. Разумный выбор по умолчанию для смешанного содержимого.standard: токенизатор на основе правил сегментации текста Unicode; работает с большинством языков.icu: токенизатор на основе ICU для языков, которым нужен полный набор правил сегментации Unicode: тайского, кхмерского и текста со смешанными системами письма.- Пользовательские анализаторы (3.1+): позволяют объединять в цепочку
edge_ngramдля дополнения по префиксу,word_delimiterдля слов в camelCase и термов с дефисами,lowercaseиasciifoldingдля поиска без учёта регистра и диакритических знаков и другие компоненты.
Изменение анализатора требует перестроения индекса с помощью BUILD INDEX.
Дополнительные материалы
- Инвертированный индекс: структура индекса, на которой основаны эти операторы, включая организацию хранения, особенности построения и компактизации.
- Оценка релевантности BM25: как вычисляется
score(), когда включается её вычисление и как настраиватьk1иb. - Гибридный поиск: объединение
MATCH_*и векторного расстояния ANN в одном SQL-запросе с правилами предварительной фильтрации и перехода к резервному варианту выполнения. - Справочник поисковых операторов: полный каталог операторов (Catalog) с синтаксисом slop, правилами префиксов и
USING ANALYZER. - Руководство по пользовательским анализаторам: подробное описание символьных фильтров, токенизаторов и фильтров токенов.
- Функция SEARCH: DSL в виде одной строки, объединяющий несколько операторов для разных столбцов.
- Reciprocal Rank Fusion: SQL-шаблон для объединения рангов BM25 с рангами векторного поиска, когда одной функции оценки недостаточно.