Iceberg
Кратко Apache Doris представляет собой полноценный движок Apache Iceberg с поддержкой чтения и записи. Один оператор
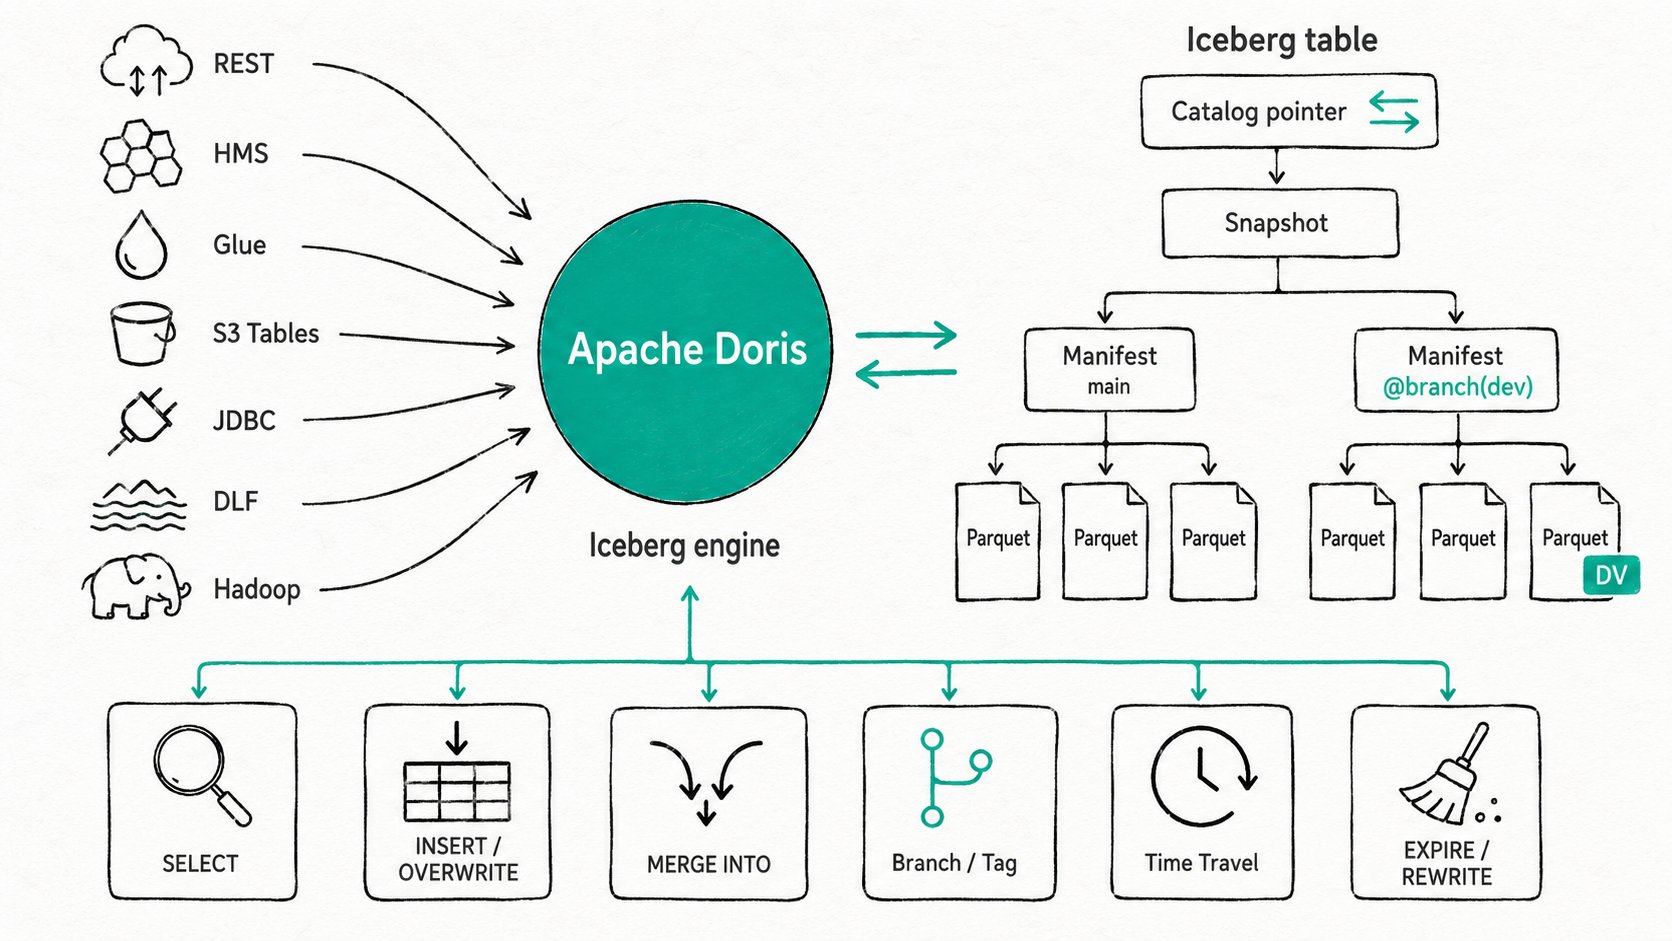
CREATE CATALOGподключает Apache Doris к любой из семи серверных реализаций Iceberg (REST, HMS, Glue, S3 Tables, JDBC, DLF, Hadoop). После этого вы можете выполнять запросы,INSERT,UPDATE,DELETE,MERGE INTO, создавать ветви и теги, использовать time travel, изменять схему и партиции, а также обслуживать таблицы (expire_snapshots,rewrite_data_files,rewrite_manifests), оставаясь в SQL. Apache Doris читает и записывает позиционные удаления и удаления по равенству V2, а векторы удаления V3 (Puffin) поддерживаются начиная с версии 4.1.
Зачем использовать Catalog Iceberg в Apache Doris?
Catalog Iceberg в Apache Doris представляет собой полноценный движок чтения и записи, поэтому тот же кластер, который обслуживает дашборды, также записывает строки, выполняет обслуживание и управляет ветвями в Iceberg без передачи этих задач Spark или Flink. Привлекательность Iceberg заключается в независимости от движка. Данные хранятся в формате Parquet в объектном хранилище, структура таблицы описывается открытой спецификацией, и любой движок, поддерживающий эту спецификацию, может читать и записывать одну и ту же таблицу без её копирования. Это преимущество теряется, как только ваш движок использует Iceberg лишь как дополнительный источник для чтения. Вы подключаетесь, выполняете несколько запросов SELECT, но при первой же необходимости записать строку снова приходится запускать Spark или Flink для записи. Два кластера, два диалекта SQL, два набора учётных данных и одна таблица.
Apache Doris выполняет обе задачи. Кластер, обслуживающий ваши дашборды, также поддерживает таблицы Iceberg, на которых они основаны.
- Федеративные запросы, соединяющие факты из Iceberg с данными хранилища Doris, выполняются в рамках единого плана MPP, без задания копирования.
- Конвейеры ELT записывают результаты обратно в Iceberg через стандартный SQL, поэтому другие движки сразу видят новый снимок.
- Обслуживание (компактация, удаление устаревших снимков, перезапись манифестов) выполняется через
ALTER TABLE ... EXECUTE, без отдельного задания Spark.
В этой статье рассматриваются возможности, специфичные для Iceberg. О федеративной работе с разными типами Catalog см. Работа с несколькими Catalog; о возможностях записи, общих для Iceberg, Hive и Paimon, см. Управление таблицами озера данных.
Что такое Catalog Iceberg в Apache Doris?
Catalog Iceberg в Apache Doris представляет собой встроенный коннектор на базе библиотеки Iceberg Java. Коннектор напрямую использует API Catalog Iceberg, поэтому фиксация изменений проходит через тот же код, что используют Spark и Trino, и создаёт снимки, которые эти движки могут читать без преобразования.
Основные термины
- Тип Catalog: серверная реализация хранилища метаданных, которая сопоставляет имена таблиц с указателями на текущие метаданные. Doris поддерживает семь типов:
rest,hms,glue,s3tables,dlf,jdbc,hadoop. - Версия формата: V1 (только добавление), V2 (merge-on-read с позиционными удалениями и удалениями по равенству), V3 (векторы удаления в файлах Puffin, отслеживание происхождения строк, значения по умолчанию). Doris читает версии от V1 до V3 и по умолчанию записывает V2. Для записи V3 требуется версия формата 4.1+.
- Снимок: неизменяемая версия таблицы Iceberg. Каждая фиксация изменений создаёт новый снимок.
- Ветвь и тег: именованные ссылки на снимки. Ветви перемещаются при фиксации новых изменений, а теги остаются неизменными. Doris поддерживает и ветви, и теги при чтении (
@branch(name),@tag(name)) и в DDL (ALTER TABLE ... CREATE BRANCH). - Позиционное удаление, удаление по равенству, вектор удаления: три способа, которыми Iceberg фиксирует удаления на уровне строк. Позиционные удаления помечают строку по пути к её файлу и порядковому номеру. Удаления по равенству находят строки по значениям столбцов. Векторы удаления хранят битовую карту Roaring для каждого файла данных в сопутствующем файле Puffin.
Как работает Catalog Iceberg в Apache Doris?
Catalog Iceberg в Apache Doris подключается через одну из семи серверных реализаций хранилища метаданных, планирует запросы к текущему снимку (либо к указанной ветви, тегу или точке time travel), учитывает удаления на уровне строк при обработке данных и фиксирует записи через API Catalog Iceberg.
- Подключитесь один раз.
CREATE CATALOG ... PROPERTIES ('type' = 'iceberg', 'iceberg.catalog.type' = '<backend>', ...)регистрирует хранилище метаданных и систему хранения данных. Дескриптор Catalog сохраняется при перезапусках FE. - Планируйте запросы по снимкам. Когда запрос обращается к таблице Iceberg, FE определяет текущий снимок (либо снимок указанной ветви, тега или точки time travel), читает список манифестов, отсекает партиции и файлы данных по статистике min/max и проталкивает фильтры. Рабочие процессы BE потоково читают оставшиеся файлы Parquet или ORC.
- Учитывайте удаления на лету. Позиционные удаления применяются как left anti-join по
<file_path, row_position>. Удаления по равенству сопоставляют строки по схеме удаления. Векторы удаления V3 учитываются при сканировании через проверку битовой карты, что обходится дешевле соединения при удалении большого числа различных строк. - Фиксируйте запись атомарно.
INSERT,INSERT OVERWRITE,CTAS,UPDATE,DELETEиMERGE INTOпроходят черезIcebergTransactionв Doris. Компоненты записи BE подготавливают файлы Parquet (либо, для новых таблиц V3, векторы удаления при перезаписи). FE формирует список манифестов и запрашивает у Catalog замену указателя таблицы. При конфликте оператор завершается с понятной ошибкой несовпадения снимков, не допуская частичной записи. - Выполняйте обслуживание на месте. Удаление устаревших снимков, компактация файлов данных, перезапись манифестов, fast-forward ветвей и cherrypick снимков выполняются через
ALTER TABLE <t> EXECUTE <action>(...)и фиксируются через тот же API Catalog. Внешний планировщик и отдельное задание Spark не требуются.
Быстрый старт
CREATE CATALOG iceberg_rest PROPERTIES (
  'type' = 'iceberg',
  'iceberg.catalog.type' = 'rest',
  'uri' = 'http://rest:8181',
  'warehouse' = 's3://lake/wh',
  's3.endpoint' = 'http://minio:9000',
  's3.access_key' = 'admin', 's3.secret_key' = 'password'
);

SWITCH iceberg_rest;
CREATE DATABASE IF NOT EXISTS sales;
CREATE TABLE sales.orders (id BIGINT, region STRING, amount DECIMAL(10,2), ts DATETIME)
  PARTITION BY LIST (region, day(ts)) ()
  PROPERTIES ('format-version' = '2');

INSERT INTO sales.orders VALUES (1, 'bj', 99.50, '2026-05-08 10:00:00');
ALTER TABLE sales.orders CREATE BRANCH dev;
INSERT INTO sales.orders@branch(dev) VALUES (2, 'sh', 12.00, '2026-05-08 11:00:00');
ALTER TABLE sales.orders EXECUTE expire_snapshots('retain_last' = '5');
Ожидаемый результат
+----------+
| count(*) |
+----------+
|        1 |  -- main branch
|        2 |  -- dev branch (SELECT ... FROM sales.orders@branch(dev))
+----------+
Trino или Spark, подключённые к тому же REST endpoint, видят те же снимки, которые только что записал Doris.
Когда следует использовать Catalog Iceberg в Apache Doris?
Catalog Iceberg в Apache Doris подходит для федеративной аналитики в lakehouse, загрузки в Iceberg через ELT исключительно на SQL, рабочих процессов с ветвями и обслуживания на месте; он не подходит для частых обновлений отдельных строк или записи в Hudi.
Подходит для следующих задач
- Федеративная аналитика по Iceberg и хранилищу Apache Doris без предварительного копирования данных в Apache Doris.
- Конвейеры ELT, которые записывают подготовленные данные в Iceberg из источников JDBC, Kafka или Hive, используя только SQL.
- Командные рабочие процессы, которым нужна изоляция в стиле git: запишите данные в ветвь разработки, проверьте их, затем выполните
fast_forwardосновной ветви. - Воспроизводимое заполнение историческими данными и аудит с использованием
FOR VERSION AS OFили именованных тегов. - Потоковые задания, которым нужна компактация по расписанию.
rewrite_data_filesиexpire_snapshotsпомогают сдерживать проблему мелких файлов. - Миграция с Hive. Создайте таблицу Iceberg из Doris, записывайте данные параллельно в обе системы на время перехода, а затем выведите копию в Hive из эксплуатации.
Не подходит для следующих задач
- Частые обновления на уровне строк. Фиксация изменений в Iceberg основана на снимках, поэтому накладные расходы на каждый оператор значительно выше, чем у таблицы Unique Key в Doris. Используйте внутренние таблицы Doris как приёмники CDC, если важна задержка обработки отдельных строк.
- DELETE или UPDATE в таблицах Iceberg V1. Для DML на уровне строк требуется версия формата 2 или 3. Задайте
'format-version' = '2'при создании либо обновите версию формата таблицы. - Запись в Hudi. В настоящее время Doris поддерживает чтение Hudi. Для записи в Hudi используйте Spark или Flink.
- Транзакции между разными Catalog. Оператор, записывающий данные в два Catalog Iceberg (или в таблицу Iceberg и таблицу Doris), не образует единую транзакцию ACID. Сначала запишите данные в одну систему, затем реплицируйте их.
- Работа без обслуживания. Без
expire_snapshotsобъём хранилища и метаданных растёт неограниченно, а чтение с time travel замедляется. Настройте выполнение по расписанию. - Catalog на основе файловой системы (
hadoop) при одновременной записи несколькими процессами. У файловых Catalog нет службы блокировок. Для любой конфигурации с несколькими процессами записи используйте REST, HMS, Glue, JDBC или DLF.
Дополнительные материалы
- Справочник по Catalog Iceberg: полный синтаксис DDL, DML, работы с ветвями и тегами, time travel и операций над таблицами с указанием версий для каждой возможности.
- Управление таблицами озера данных: возможности записи и управления жизненным циклом, которые Doris предоставляет для Iceberg, Hive и Paimon.
- Работа с несколькими Catalog: как Doris объединяет Iceberg, Hive, JDBC, ES и внутреннее хранилище для федеративных запросов с использованием трёхчастных имён.
- Интеграции Catalog: особенности подключения к каждой серверной реализации: HMS, Glue, REST, S3 Tables, DLF, JDBC и Hadoop.
- Обзор lakehouse: место Iceberg в общей архитектуре федеративной аналитики Doris.
- Рекомендации по работе с Doris + Iceberg: рабочий пример REST + MinIO с преобразованиями партиций, time travel, DML V2 и взаимодействием с PyIceberg.
- Табличная функция iceberg_meta(): запросы к снимкам, манифестам, файлам, ссылкам и истории без обращения к Iceberg Java API.