Интеграция с Kafka и CDC
Кратко Apache Doris поддерживает три способа загрузки данных из топиков Kafka и потоков изменений CDC. Используйте Routine Load, если нужен потребитель Kafka, который работает внутри FE и не требует внешнего сервиса. Используйте Flink Doris Connector вместе с Flink CDC для синхронизации всей базы данных MySQL/Postgres/Oracle с гарантией exactly-once через Stream Load 2PC. Используйте Doris Kafka Connector, если Kafka Connect уже работает в вашей инфраструктуре, а данные поступают в формате Avro, Protobuf или Debezium. Все три способа загружают данные в одни и те же таблицы Unique Key Merge-on-Write, поэтому события, поступающие не по порядку, и удаления обрабатываются одинаково независимо от выбранного способа.
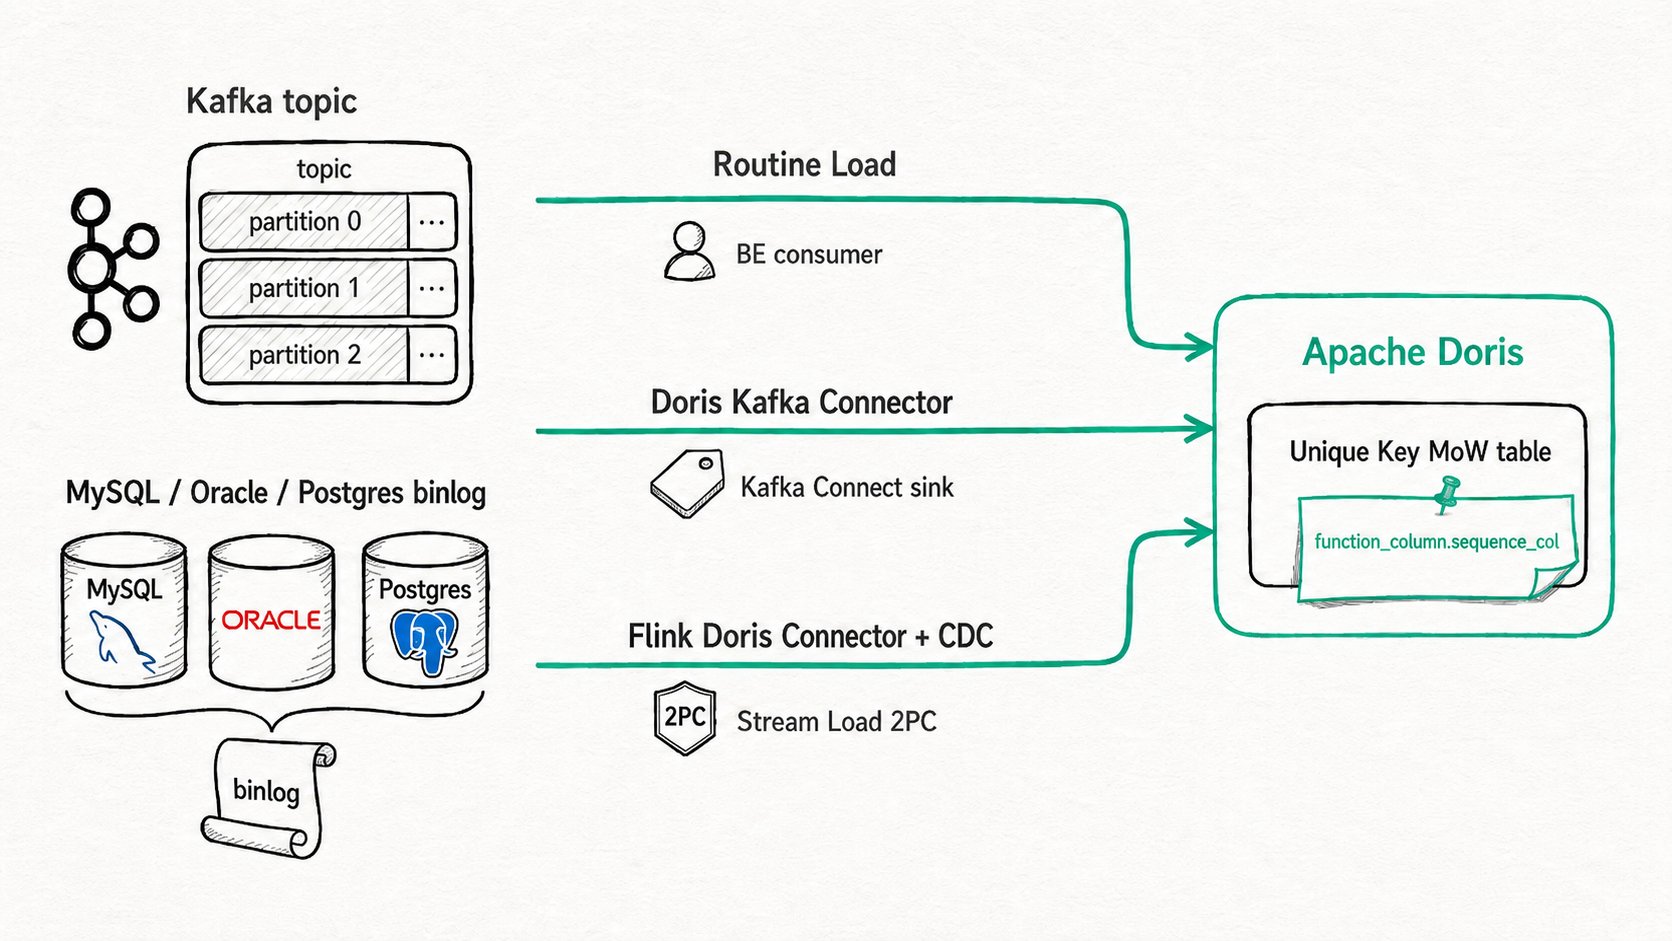
Зачем использовать интеграцию с Kafka и CDC в Apache Doris?
Интеграция Apache Doris с Kafka и CDC реализует потоковую загрузку, доставку с гарантией exactly-once и обработку событий, поступающих не по порядку, внутри самого движка. Благодаря этому путь от топика или binlog до строки, доступной для запросов, остаётся коротким. В большинстве хранилищ данных потоковую загрузку приходится организовывать отдельно. Вы запускаете потребителя Kafka, заново реализуете учёт смещений, повторные попытки, сопоставление схем и удаление данных, а затем надеетесь, что при сбое хранилища потребитель корректно завершит работу. Или ставите Flink перед хранилищем и оплачиваете дополнительный кластер. Или отказываетесь от «реального времени» и отправляете данные пятиминутными пакетами через пакетную загрузку.
- Конвейер CDC повторно обрабатывает последний пакет после сбоя контрольной точки и дублирует каждую строку из своего буфера.
- Обновление, поступившее не по порядку, в таблице Unique Key уступает более старой версии, поскольку движок не получил указания, какая запись новее.
- Топик Kafka с данными Avro или Protobuf несовместим с HTTP API загрузки, который поддерживает только JSON или CSV.
Doris переносит большую часть этих задач в движок, поэтому путь от топика Kafka или binlog MySQL до строки, доступной для запросов, остаётся коротким, а возможные сценарии сбоев понятны.
Что представляет собой интеграция Apache Doris с Kafka и CDC?
Интеграция Apache Doris с Kafka и CDC представляет собой набор способов потоковой загрузки и загрузки CDC с общей основой: транзакционные загрузки, идентифицируемые по Label, таблицы Unique Key Merge-on-Write для операций upsert и удаления, а также столбец последовательности, который определяет приоритетную версию, когда события поступают не по порядку. Способы различаются тем, кто запускает потребителя.
Основные термины
Routine Load: долговременно работающий потребитель Kafka под управлением FE. Достаточно одного оператораCREATE ROUTINE LOAD, и FE назначает BE задачи, которые получают пакеты данных и превращают каждый пакет в транзакционную загрузку.Stream Load 2PC: загрузка по HTTP, которая остаётся в состоянииPRECOMMITTED, пока последующий вызов не передастtxn_operation: commitилиtxn_operation: abort. Именно разделение на две фазы обеспечивает семантику exactly-once для внешних приёмников данных.Flink Doris Connector: внешний приёмник данных Flink, который управляет Stream Load 2PC и привязывает фиксацию транзакций к контрольным точкам Flink. В сочетании с Flink CDC он синхронизирует всю базу данных и переносит изменения DDL.Doris Kafka Connector: плагин приёмника данных для Kafka Connect. Использует экосистему конвертеров Kafka Connect, поэтому данные Avro, Protobuf и Debezium поддерживаются без специального сериализатора.function_column.sequence_col: свойство таблицы Unique Key MOW, которое выбирает столбец, определяющий по своему значению приоритетную версию строки. Защищает от последствий поступления событий CDC не по порядку.
Как работает интеграция Apache Doris с Kafka и CDC?
Все способы интеграции Apache Doris с Kafka и CDC сходятся к одному жизненному циклу после поступления данных в FE: получить пакет, обернуть его в транзакцию с меткой, зафиксировать после подтверждения, а затем опубликовать во всех репликах.
- Потребитель получает пакет. Routine Load назначает задачу на BE, которая получает данные из Kafka до достижения первого из ограничений:
max_batch_rows(по умолчанию 20M),max_batch_size(по умолчанию 1 GB) илиmax_batch_interval(по умолчанию 60 s). Flink CDC передаёт строки потоком через HTTP Stream Load с передачей данных частями; соединение остаётся открытым на протяжении интервала между контрольными точками. - Пакет становится транзакцией. BE открывает транзакцию с
Label. Routine Load генерирует метку, а Flink Doris Connector связывает её с идентификатором контрольной точки. В обоих случаях повторная отправка с той же меткой приводит к дедупликации. - Фиксация ожидает подтверждения. Routine Load фиксирует транзакцию сразу после загрузки пакета и продвигает смещение Kafka только в случае успеха. Flink CDC останавливается на
PRECOMMITTED; следующий барьер контрольной точки запускаетtxn_operation: commit, а сбой контрольной точки запускаетabort, который отбрасывает подготовленные данные. - Публикация делает строки видимыми. Фоновый процесс отправляет
PublishVersionкаждой реплике. Когда транзакция достигает состоянияVISIBLE, новые строки становятся доступны для запросов. Изменения в таблетах одной транзакции становятся видимыми атомарно. - При ошибках задача приостанавливается, а данные сохраняются. Если пакет Routine Load превышает порог
max_error_number(по умолчанию 0), задача переходит в состояниеPAUSED, а FE сохраняет URL последней ошибки. После исправления исходных данных возобновите задачу; смещения остаются на прежнем месте.
Быстрый старт
CREATE TABLE events (
  user_id BIGINT, event_type STRING, ts DATETIME
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 8;

CREATE ROUTINE LOAD events_kafka ON events
COLUMNS(user_id, event_type, ts)
PROPERTIES (
  "format" = "json",
  "jsonpaths" = "[\"$.user_id\",\"$.event_type\",\"$.ts\"]"
)
FROM KAFKA (
  "kafka_broker_list" = "localhost:9092",
  "kafka_topic" = "events",
  "property.kafka_default_offsets" = "OFFSET_BEGINNING"
);
Ожидаемый результат
+--------+--------------+---------+----------------------+
| Id     | Name         | State   | Statistic            |
+--------+--------------+---------+----------------------+
| 100123 | events_kafka | RUNNING | {"loadedRows":4821,..|
+--------+--------------+---------+----------------------+
SHOW ROUTINE LOAD FOR events_kafka показывает задачу в состоянии RUNNING, последнее прочитанное смещение для каждой партиции и количество загруженных строк. Команды PAUSE, RESUME и STOP работают так же, как для любой другой задачи Doris.
Для CDC замените потребителя на Flink Doris Connector в связке с Flink CDC (одна задача Flink, MySQL в качестве источника, Doris в качестве приёмника, sink.enable-2pc = true). Схема и столбец последовательности задаются на стороне Doris:
CREATE TABLE orders (
  order_id BIGINT, status STRING, updated DATETIME
)
UNIQUE KEY(order_id) DISTRIBUTED BY HASH(order_id) BUCKETS 8
PROPERTIES ("function_column.sequence_col" = "updated");
Строка с sequence_col защищает от ситуации, когда задержавшееся событие CDC приходит после более нового: версия с более старым значением updated уступает версии с более новым, и результат не зависит от порядка поступления событий.
Когда следует использовать интеграцию Apache Doris с Kafka и CDC?
Используйте интеграцию Apache Doris с Kafka и CDC, когда потоковые события или изменения в исходной базе данных должны поступать в Doris с гарантией exactly-once и корректным учётом порядка, без ожидания пятиминутных пакетов.
Подходит
- Данные из топика Kafka в формате CSV или JSON нужно загрузить в Doris без дополнительного сервиса. Routine Load обеспечивает самый короткий путь.
- CDC из MySQL, Postgres или Oracle в Doris с гарантией exactly-once и переносом изменений DDL. Используйте Flink Doris Connector вместе с Flink CDC.
- Kafka Connect уже работает в вашей инфраструктуре, а данные поступают в формате Avro, Protobuf или Debezium. Doris Kafka Connector решает проблему несовместимости форматов.
- Панелям мониторинга в реальном времени на основе таблиц Unique Key нужна корректная обработка записей, поступающих не по порядку. Дополните любой из перечисленных способов свойством
function_column.sequence_col.
Не подходит
- Avro из Kafka через Routine Load. Routine Load читает только CSV и JSON. Преобразуйте данные на стороне источника или используйте Doris Kafka Connector с подходящим конвертером.
- Выполнение
INSERT INTO ... VALUESдля каждого события из микросервиса. Это не задача Kafka или CDC; используйте Group Commit, чтобы BE объединял небольшие записи в пакеты на стороне сервера. - Routine Load для топика с коротким сроком хранения в Kafka. Если срок хранения составляет 24 ч, а задача приостановлена на двое суток, сохранённое смещение оказывается раньше самого раннего доступного смещения, и Kafka отклоняет возобновление с ошибкой "out of range". Увеличьте срок хранения или используйте коннектор с буферизацией.
- Мониторинг отставания смещений только через FE. В настоящее время FE не предоставляет метрику отставания (открытая задача). Собирайте метрики экспортера consumer-lag на стороне Kafka или следите за показателями скорости на стороне BE.
- Stream Load 2PC для таблиц Unique Key Merge-on-Write в облачных развёртываниях / развёртываниях с разделением хранения и вычислений: BE отклоняет эту комбинацию, поэтому способ Flink Connector с гарантией exactly-once в таком случае опирается на дедупликацию по
Labelи столбец последовательности. В кластерах на собственной инфраструктуре сохраняется полноценная поддержка Stream Load 2PC для MoW.
Производительность и показатели
Из статьи «Как Flink записывает данные в Apache Doris в реальном времени, сохраняя высокую скорость и семантику exactly-once» (публикация о выпуске в блоге за июль 2022 года): при 30 параллельных загрузках Stream Load сквозная задержка оставалась менее одной секунды; 20 задач Flink поддерживали входящий поток со скоростью около 100,000 событий в секунду; загрузка CPU на BE снизилась примерно на 25% по сравнению с прежним способом загрузки при высокой параллельности. Источник: блог Apache Doris.
Дополнительные материалы
- Справочник по Routine Load
- Flink Doris Connector и Flink CDC
- Doris Kafka Connector для Avro, Protobuf и Debezium
- Транзакции загрузки: модель, лежащая в основе 2PC
- Обновление и удаление данных: столбец последовательности и Merge-on-Write
- Changelog / Table Stream: поток изменений, работающий в обратном направлении и предоставляющий изменения строк Doris последующим потребителям.
- Iceberg: распространённый приёмник для конвейеров CDC с подготовленными данными. Обратная запись через SQL позволяет потребителям данных в других движках получать актуальные данные.
- Unique Key: модель таблиц, в которые записывают данные приёмники CDC. Используйте её со столбцом последовательности на основе LSN/временной метки фиксации в источнике.