SQL-функции для LLM
Кратко Apache Doris предоставляет семейство SQL-функций
AI_*, которые передают значение столбца строки внешней LLM и возвращают результат прямо в запросе. Вы один раз настраиваете провайдера в виде AI-ресурсаRESOURCE, а затем используетеAI_CLASSIFY(...),AI_EXTRACT(...)илиAI_GENERATE(...)везде, где допустимо значение. Cortex AISQL от Snowflake и AI Functions от Databricks решают те же задачи; семействоAI_*в Apache Doris служит их аналогом с открытым исходным кодом.
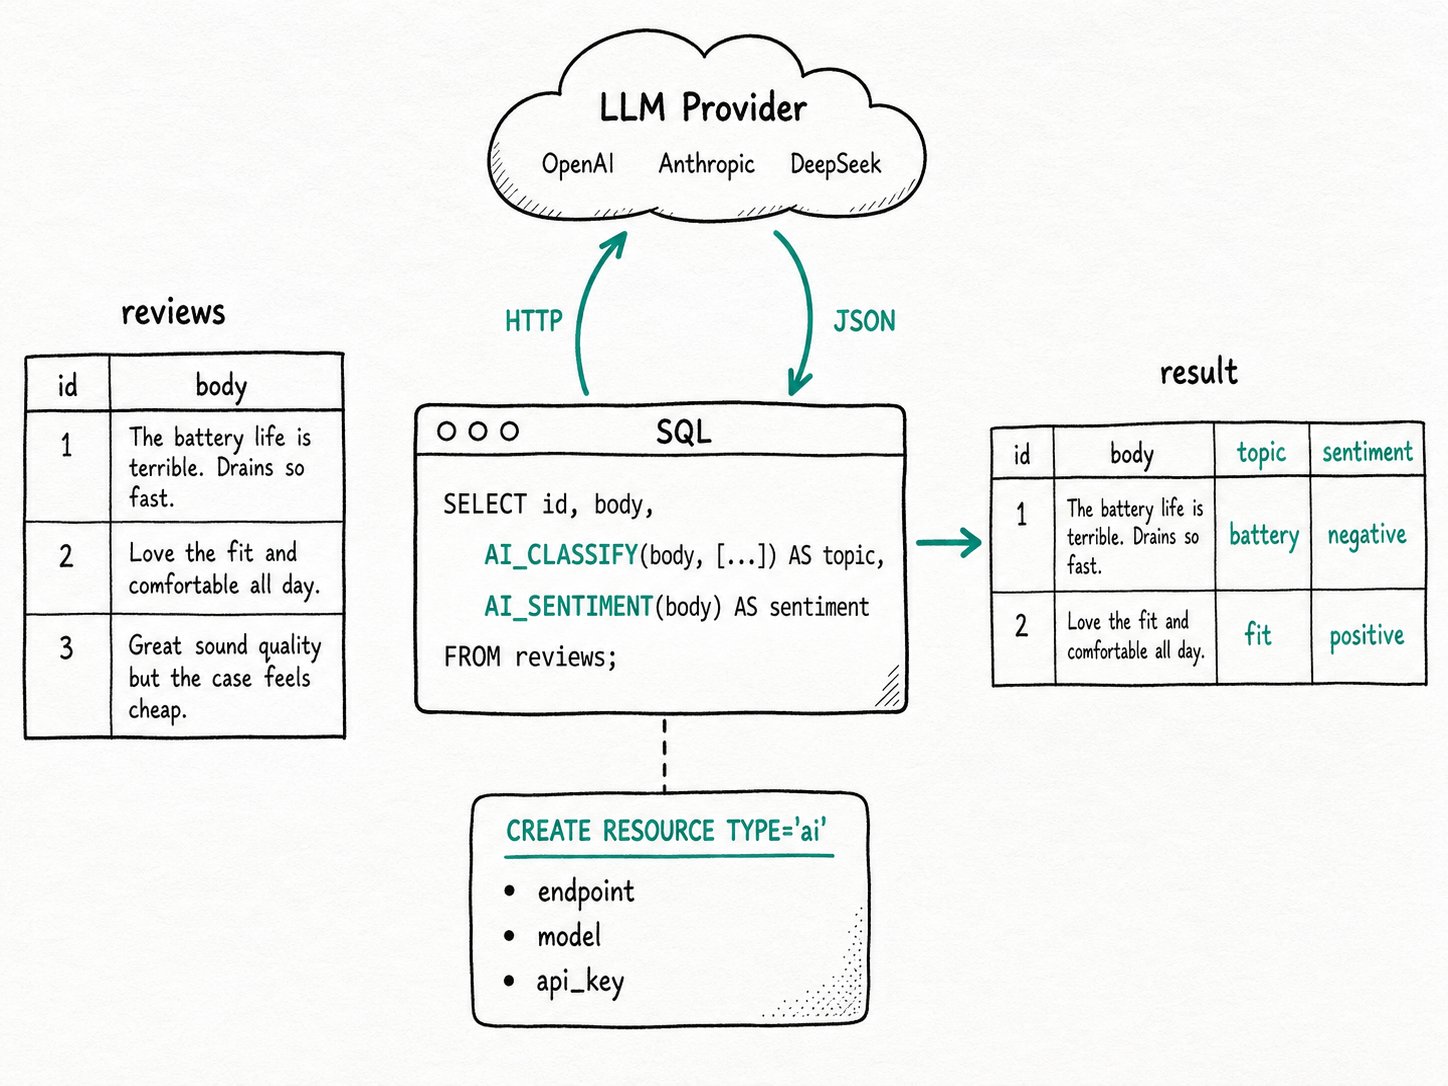
Зачем использовать SQL-функции AI_* в Apache Doris?
SQL-функции AI_* в Apache Doris избавляют от необходимости создавать внешний сервис на Python для классификации текстовых столбцов, извлечения данных, создания сводок или маскирования PII. Значительная часть аналитической работы с текстовыми столбцами на деле вовсе не аналитика. Кому-то приходится классифицировать обращения в поддержку по темам, определять тональность отзывов, извлекать названия товаров из жалоб в свободной форме, составлять сводки длинных заметок о звонках или скрывать PII перед экспортом. Работа повторяется, столбцы уже находятся в хранилище, и не хватает только модели. Apache Doris уже предоставляет эмбеддинги через EMBED() и сервер MCP для AI-клиентов, поэтому эта карточка дополняет набор возможностей, доступных через SQL.
Обычно для этого создают сервис на Python. Он забирает строки из Doris, вызывает OpenAI или Anthropic, разбирает ответ и записывает результат обратно. Такой сервис постепенно теряет синхронизацию с исходной таблицей, самостоятельно обрабатывает повторные попытки и находится вне механизмов управления доступом и наблюдаемости хранилища.
Функции AI_* переносят этот цикл в SQL. Модель становится зарегистрированным ресурсом. Вызов выполняется через функцию. Результат представляет собой столбец, который можно сохранить с помощью INSERT, использовать для фильтрации в WHERE или вычислять на лету. Один язык, одна граница транзакции, одно место для чтения журнала аудита.
Что представляют собой SQL-функции AI_* в Apache Doris?
Семейство AI_* в Apache Doris представляет собой набор функций, доступных из SQL и выполняющих HTTP-вызов к провайдеру LLM. Каждая функция подставляет входные столбцы в фиксированный шаблон промпта и возвращает типизированный результат, поэтому планировщик обрабатывает их как любые другие скалярные функции. Apache Doris обращается к провайдеру через AI-ресурс, который вы один раз создаёте с помощью CREATE RESOURCE ... TYPE='ai'. Десять скалярных функций покрывают наиболее распространённые задачи, а одна агрегатная функция, AI_AGG, объединяет несколько строк в единый ответ, созданный LLM.
Основные термины
- AI-ресурс: именованное подключение к провайдеру LLM. Хранит
provider_type, конечную точку, имя модели, ключ API и параметры настройки (temperature,max_token,max_retries,retry_delay_second). Поддерживаются двенадцать провайдеров: OpenAI, Anthropic, Gemini, DeepSeek, MoonShot, QWen, MiniMax, Zhipu, Baichuan, VoyageAI, Jina иlocalдля конечных точек, развёрнутых на собственной инфраструктуре. - Скалярные функции
AI_*:AI_GENERATE,AI_TRANSLATE,AI_SUMMARIZE,AI_SENTIMENT,AI_CLASSIFY,AI_EXTRACT,AI_FIXGRAMMAR,AI_MASK,AI_FILTER,AI_SIMILARITY. Каждая принимает имя ресурса первым аргументом, столбец вторым, а также небольшой набор аргументов для конкретной задачи, например набор меток или целевой язык. AI_AGG: агрегатная функция, которая объединяет все строки группы, отправляет их в LLM с пользовательским промптом и возвращает одну сводку для каждой группы. АналогAI_SUMMARIZEдля групп строк.default_ai_resource: переменная сеанса, которая выбирает ресурс на оставшуюся часть сеанса, позволяя опустить явный первый аргумент.
Как работают SQL-функции AI_* в Apache Doris?
SQL-функции AI_* в Apache Doris выполняются как скалярные UDF на BE: планировщик направляет каждый вызов на выполнение, BE объединяет строки в пакеты, и для каждого пакета провайдеру отправляется один HTTP-запрос, после чего типизированное значение возвращается в SQL.
- Регистрация модели.
CREATE RESOURCEпроверяет конечную точку пробным вызовом (проверка пропускается приprovider_type = 'local'илиai.validity_check = 'false'), маскирует ключ API в выводеSHOW RESOURCESи сохраняет конфигурацию в метаданных FE. - Планирование вызова. Когда планировщик встречает функцию
AI_*, он направляет работу на BE так же, как для любой скалярной UDF. Первый аргумент функции должен быть литералом с именем ресурса; выражение на этом месте планировщик отклоняет на этапе анализа. - Формирование пакетов на BE. BE накапливает входные строки в пакет, размер которого ограничен
embed_max_batch_size(по умолчанию 5) иai_context_window_size(по умолчанию 128 KB суммарного текста), затем отправляет один HTTP-запрос для каждого пакета. Слишком большая строка получает отдельный пакет, поэтому один длинный документ не задерживает выполнение остальной части запроса. - Повторные попытки и тайм-ауты. HTTP-вызов учитывает параметры ресурса
ai.max_retriesиai.retry_delay_second. Для каждого запроса действует оставшееся время изquery_timeoutсеанса, поэтому медленный провайдер не продлевает выполнение запроса сверх отведённого времени. - Возврат типизированного значения. Скалярные функции возвращают
STRING(илиBOOLEANдляAI_FILTER,DOUBLEдляAI_SIMILARITY). Значение можно сохранить, использовать для фильтрации или передать следующему оператору, не выходя за рамки SQL.
Быстрый старт
CREATE RESOURCE "deepseek_chat" PROPERTIES (
  "type" = "ai",                     "ai.provider_type" = "deepseek",
  "ai.endpoint"   = "https://api.deepseek.com/chat/completions",
  "ai.model_name" = "deepseek-chat", "ai.api_key" = "sk-xxx"
);
SET default_ai_resource = "deepseek_chat";

CREATE TABLE reviews (id INT, body STRING)
  DUPLICATE KEY(id) DISTRIBUTED BY HASH(id) BUCKETS 1;
INSERT INTO reviews VALUES
  (1, 'Battery dies in 4 hours. Returning it.'),
  (2, 'Fits perfectly, color is exactly as pictured. Love it.');

SELECT id, body, AI_SENTIMENT(body) AS sentiment,
       AI_CLASSIFY(body, ['battery', 'fit', 'price', 'shipping']) AS topic
FROM reviews;
Ожидаемый результат
+----+--------------------------------+-----------+---------+
| id | body                           | sentiment | topic   |
+----+--------------------------------+-----------+---------+
|  1 | Battery dies in 4 hours...     | negative  | battery |
|  2 | Fits perfectly, color is...    | positive  | fit     |
+----+--------------------------------+-----------+---------+
Запрос выполняет два обращения к LLM, по одному на функцию, причём при каждом обращении обе строки входят в один пакет. Выходные столбцы имеют строковый тип, поэтому последующие GROUP BY topic или соединение работают без разбора данных.
Когда следует использовать SQL-функции AI_* в Apache Doris?
Функции AI_* в Apache Doris подходят для пакетного обогащения данных, дозаполнения данных в ETL и агрегирования нескольких строк, но не для интерактивных запросов с временем ответа менее секунды или нагрузок, требующих строгой воспроизводимости.
Подходящие сценарии
- Пакетное обогащение текстовых столбцов: классификация обращений в поддержку каждую ночь, определение тональности новых отзывов или однократное извлечение структурированных полей из счетов при поступлении данных.
- Дозаполнение внутри базы данных:
UPDATE t SET topic = AI_CLASSIFY(body, [...]) WHERE topic IS NULLпозволяет выполнять всю работу в одном месте и использовать преимущества транзакций Doris. - Агрегирование нескольких строк через
AI_AGG: еженедельные сводки жалоб по каждому товару, краткие обзоры заметок встреч для руководства, тематические подборки новостных статей. - Семантическая фильтрация в
WHERE:AI_FILTER('Is this a security incident?', body)для разовой первичной сортировки, когда дообучать классификатор избыточно.
Неподходящие сценарии
- Вызов
AI_*для каждой строки при каждом обновлении дашборда. Каждая строка означает один вызов провайдера, а стоимость растёт с числом строк и частотой обновления. Сохраните результат в столбце, создайте для него индекс и выполняйте запросы к этому столбцу. О предварительном вычислении см. Инкрементальное материализованное представление. - Интерактивные запросы с временем ответа менее секунды. Даже в лучшем случае вывод LLM занимает сотни миллисекунд, а ограничения частоты запросов увеличивают задержки самых медленных запросов. Используйте
AI_*для пакетной обработки и ETL, а не для запросов, завершения которых пользователь ждёт после нажатия кнопки. - Задачи поиска похожих объектов. Столбец с эмбеддингами в сочетании с векторным индексом и
cosine_distanceобеспечивает более быстрый, дешёвый и воспроизводимый поиск. О реализации средствами SQL см. Эмбеддинги. - Любые задачи, требующие строгой воспроизводимости. Ответы провайдера недетерминированы, если не зафиксировать
temperature = 0, но даже тогда небольшие обновления на стороне модели меняют результаты. Сохраняйте снимок результата вместо повторного вычисления при каждом запросе. - Нагрузки, которым нужен провайдер вне поддерживаемого списка. Любой провайдер за пределами двенадцати значений
provider_typeдолжен предоставлять API, совместимый с OpenAI, Anthropic или Gemini, либо работать как конечная точкаlocal.
Дополнительные материалы
- AI в Doris: все возможности AI, в том числе то, как функции
AI_*, эмбеддинги, векторный поиск и сервер MCP работают вместе. - Обзор AI-функций: все поддерживаемые провайдеры, полный список свойств
CREATE RESOURCEи отдельные примеры для каждой функции. - Эмбеддинги:
EMBED()использует тот же механизм AI-ресурсов и подходит для случаев, когда следующим шагом будет векторный поиск. - Гибридный поиск: как сочетать столбцы, сгенерированные LLM, с предикатами полнотекстового поиска и ANN в одном запросе.
- Справочник Snowflake Cortex AISQL: ближайший аналог для сравнения возможностей разных хранилищ.
- Сервер MCP: другая сторона возможностей AI, позволяющая AI-клиентам выполнять запросы к Doris через инструменты Model Context Protocol.
- Тип данных VARIANT: естественный выбор для хранения JSON, который возвращают
AI_EXTRACTи аналогичные функции. - Databricks AI Functions: подход другого поставщика к той же идее.