Конвейерный движок выполнения
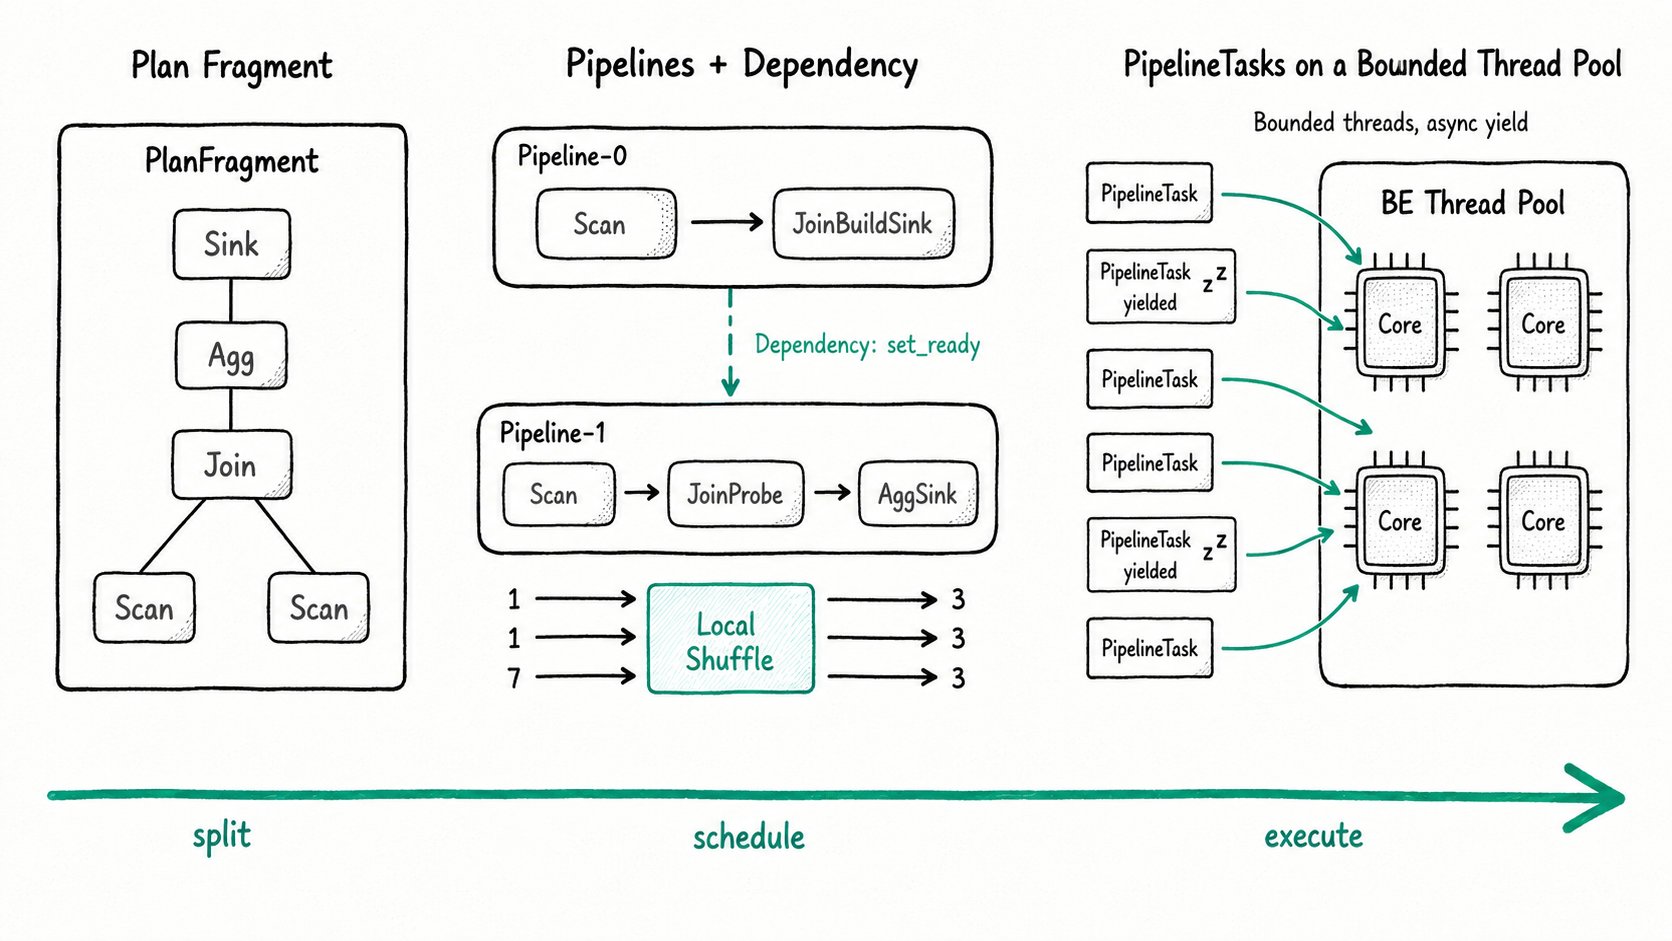
Кратко Начиная с v3.0 конвейерный движок выполнения Apache Doris стал единственным движком выполнения, заменив прежнюю модель volcano. Каждый фрагмент запроса разбивается на DAG конвейеров, которые начинаются с источника, заканчиваются приёмником и выполняются в виде PipelineTasks в пуле потоков BE фиксированного размера, ограниченного выделенными BE ресурсами CPU. Операторы уступают поток вместо блокировки, зависимости координируют выполнение DAG, а Local Shuffle выравнивает распределение данных внутри BE.
Зачем использовать конвейерный движок выполнения в Apache Doris?
Конвейерный движок выполнения Apache Doris решает три проблемы, с которыми не справлялась прежняя модель volcano: неограниченный рост числа потоков при одновременном выполнении запросов, простой ядер при соединениях и агрегациях с перекосом данных и настройку на уровне экземпляров фрагментов, при которой приходилось действовать наугад. В модели volcano, которую раньше использовал Apache Doris, каждому экземпляру фрагмента выделялся собственный поток ОС. При нескольких одновременных запросах это приемлемо. При сотне запросов начинаются проблемы: накапливаются тысячи потоков, большинство из которых заблокировано в ожидании IO или друг друга. В итоге BE перегружает планировщик ядра и исчерпывает память раньше, чем заканчиваются задачи.
Старый движок оставлял ещё две проблемы. Агрегации широких таблиц и соединения с перекосом данных не полностью использовали ядра: когда в одном бакете 7 строк, а в остальных по 1, задача на 7 строк определяет общую длительность выполнения, а остальная часть кластера простаивает в ожидании её завершения. Кроме того, настройка параллелизма на уровне экземпляров фрагментов сводилась к подбору слишком большого числа параметров наугад.
Pipeline решает все три проблемы. Число потоков ограничено и не растёт вместе с числом запросов. Когда операторы не могут продолжать работу, они уступают поток, освобождая его. А Local Shuffle перераспределяет данные внутри BE, сокращая время выполнения самой долгой задачи.
Что такое конвейерный движок выполнения Apache Doris?
Конвейерный движок выполнения Apache Doris представляет собой асинхронную модель выполнения запросов на основе push, которая превращает каждый PlanFragment в DAG конвейеров, выполняемых в ограниченном пуле потоков BE. FE компилирует запрос в Plan, разбивает его на PlanFragments (по одному на BE), а каждый BE разбивает каждый фрагмент на DAG из Pipelines. Pipeline представляет собой цепочку, которая начинается с одного SourceOperator (сканирование или обмен данными), заканчивается одним SinkOperator (сетевой shuffle или запись в хеш-таблицу) и может содержать любое число операторов между ними. Конвейеры, которым приходится ждать друг друга, координируются с помощью Dependencies. Для каждого Pipeline создаётся несколько PipelineTasks, по одной на каждый слот параллелизма. Они выполняются в общем для BE пуле потоков фиксированного размера.
Основные термины
PlanFragment: единица работы, которую FE отправляет одному BE. В запросе обычно несколько таких единиц.Pipeline: цепочка операторов на одном BE. Выполняется параллельно в виде нескольких PipelineTasks.PipelineTask: исполняемый экземпляр конвейера, привязанный к слоту параллелизма. При блокировке или истечении кванта времени уступает поток, освобождая его.Operator: узел в цепочке. Некоторые PlanNodes разделяются на пару Sink + Source, когда требуется материализация: Join превращается вJoinBuildOperator+JoinProbeOperator, Agg превращается вAggSinkOperator+AggSourceOperator, Sort превращается вSortSinkOperator+SortSourceOperator.Dependency: сигнал готовности между конвейерами. Когда Pipeline-0 завершает построение хеш-таблицы, он вызываетset_ready, и оператор probe в Pipeline-1 возобновляет работу.- Local Shuffle (Local Exchange): Pipeline Breaker, который локально перераспределяет данные по шардам внутри BE с помощью HASH или Round Robin, чтобы перекос данных при сканировании не приводил к перекосу при соединении.
parallel_pipeline_task_num: параметр сессии, задающий параллелизм на уровне фрагмента. Значение по умолчанию0означает половину числа ядер CPU; обычно его лучше не менять.
Как работает конвейерный движок выполнения Apache Doris?
Конвейерный движок выполнения Apache Doris работает в шесть этапов: FE планирует и отправляет фрагменты, каждый BE превращает фрагмент в DAG конвейеров, создаются PipelineTasks, они выполняются в ограниченном пуле потоков, Local Shuffle выравнивает распределение данных, а параллельное сканирование не позволяет медленным бакетам задерживать запрос.
- FE планирует, разбивает и отправляет. FE компилирует запрос, вставляет
ExchangeNodeиDataSinkдля shuffle между BE и отправляет каждый PlanFragment на BE. - BE превращает каждый фрагмент в DAG конвейеров. Блокирующие операторы (построение хеш-таблицы, сортировка, агрегация) превращаются в Sink, завершающий один конвейер, и Source, начинающий следующий. Dependencies связывают DAG воедино; этап probe оператора Join ожидает вызова
set_readyна этапе построения. - Создание PipelineTasks. Каждый Pipeline превращается в N PipelineTasks. Все N используют одну и ту же цепочку Operator; различается только LocalState каждой задачи (диапазон сканирования, раздел хеш-таблицы, выходной буфер).
- Выполнение в ограниченном пуле потоков. PipelineTasks поступают в пул фиксированного размера, который определяется выделенными BE ресурсами CPU (или параметром
pipeline_executor_size, если его значение задано явно). Задача выполняется в цикле, пока не истечёт её квант времени (pipeline_task_exec_time_slice, по умолчанию 100ms) или пока она не заблокируется на Dependency. В обоих случаях она уступает поток, и тот берёт следующую готовую к выполнению задачу. - Local Shuffle при необходимости. Если планировщик обнаруживает соединение, агрегацию или оконную функцию с потенциальным перекосом входных данных, он вставляет Local Exchange. Задачи на предыдущих этапах передают туда пакеты данных, а задачи на последующих этапах забирают перераспределённые пакеты. Это превращает
(1, 1, 7)в(3, 3, 3), чтобы все ядра завершали работу примерно одновременно. - Параллельное сканирование. ScanOperator динамически создаёт внутри себя несколько Scanners. Каждый Scanner берёт от 1 до 2 миллионов строк, распаковывает и фильтрует их на месте, а затем помещает результат в DataQueue, из которой ScanOperator забирает данные. Благодаря этому медленный бакет не задерживает весь запрос.
Быстрый старт
В v3.0+ движок Pipeline включён по умолчанию; дополнительно включать ничего не нужно. Единственный параметр, который может вам понадобиться, это parallel_pipeline_task_num.
-- Inspect the default (0 means "half the CPU cores")
SHOW VARIABLES LIKE 'parallel_pipeline_task_num';

-- Pin parallelism for one heavy query without touching the session
SELECT /*+ SET_VAR(parallel_pipeline_task_num=16) */
       l_orderkey, COUNT(*) AS lines, SUM(l_extendedprice) AS gross
FROM lineitem
GROUP BY l_orderkey
ORDER BY gross DESC
LIMIT 100;

-- See the resulting plan and Local Exchange placement
EXPLAIN SELECT /*+ SET_VAR(parallel_pipeline_task_num=16) */
        l_orderkey, COUNT(*) FROM lineitem GROUP BY l_orderkey;
Ожидаемый результат
+-------------+-------+----------------+
| l_orderkey  | lines | gross          |
+-------------+-------+----------------+
|     7382118 |     7 |  431295.18     |
|     ...                              |
+-------------+-------+----------------+
Подсказка применяется только к этому запросу. EXPLAIN показывает идентификаторы конвейеров, Local Exchange (если он предусмотрен планом) и цепочку операторов. При включённом профилировании профиль выполнения показывает для каждой PipelineTask показатели ExecTime, YieldCounts и MemoryReserveFailedTimes. Именно эти показатели помогают настраивать реальные рабочие нагрузки.
Когда следует использовать конвейерный движок выполнения Apache Doris?
В v3.0+ конвейерный движок выполнения Apache Doris по умолчанию выполняет каждый запрос, поэтому на практике вопрос состоит в том, когда его настраивать. Используйте настройки по умолчанию для смешанных нагрузок с одновременным выполнением запросов, запросов с большим числом соединений или перекосом данных и длительного сканирования; меняйте parallel_pipeline_task_num только тогда, когда профилирование выявляет реальное узкое место.
Подходящие сценарии
- Любая рабочая нагрузка Apache Doris в v3.0+. Другого движка нет.
- Смешанные нагрузки с одновременным выполнением запросов на общем BE: ограниченный пул потоков не даёт запросам мешать друг другу.
- Запросы с большим числом соединений или агрегаций при перекосе входных данных: Local Shuffle выравнивает распределение, чтобы самая долгая задача не увеличивала общее время выполнения.
- Длительное сканирование неравномерно заполненных бакетов: параллельное сканирование не позволяет медленному бакету задерживать остальную работу.
Неподходящие сценарии
- Настройка
parallel_pipeline_task_numдля каждого разового запроса. Значение по умолчанию уже подобрано. Повышайте его только тогда, когда профилирование показывает простой CPU при длительном выполнении фрагмента, а при высокой конкурентности или простых точечных запросах снижайте до1. - Следование старым рекомендациям, в которых упоминается включение
enable_pipeline_engineилиexperimental_enable_pipeline_x_engine. В линейке 2.x это были экспериментальные переключатели; в 3.0+ они ничего не делают, поскольку модель volcano удалена. - Смешение этого движка с векторизованным выполнением. Это разные уровни: векторизованное выполнение определяет, что оператор делает с пакетом данных; Pipeline определяет, как обработка этих пакетов распределяется между ядрами. Подробнее о другом уровне см. в разделе Векторизованное выполнение.
- Поиск одной строки по первичному ключу при нагрузке в тысячи QPS. При такой нагрузке затраты на запуск нескольких PipelineTasks не окупаются; используйте механизм Точечные запросы при высокой конкурентности, который обходит ресурсоёмкий планировщик.
Дополнительные материалы
- Справочник по конвейерному движку выполнения: полная архитектура, включая правила Dependency, планирование Local Shuffle и механизм параллельного сканирования.
- Настройка параллелизма: когда и как задавать
parallel_pipeline_task_numдля разных сценариев, с таблицей безопасных значений по умолчанию. - Обработка перекоса данных: практическое дополнение к Local Shuffle для запросов, которые планировщик не смог исправить автоматически.
- Векторизованное выполнение: уровень операторов, выполнение которых планирует Pipeline. Его часто путают с Pipeline, хотя эти механизмы независимы.
- Группа рабочей нагрузки (Workload Group): уровень, который привязывает потоки конвейеров к cgroups отдельных групп для ограничения CPU и конкурентности.
- Эволюция движка выполнения Apache Doris: история проектирования и перехода Doris от volcano к Pipeline, а затем к PipelineX.
- Архитектура MPP: уровень координации между BE, расположенный над движком Pipeline. Разбивает один SQL на DAG фрагментов и назначает каждый фрагмент узлам BE.