Предварительная агрегация и Rollup
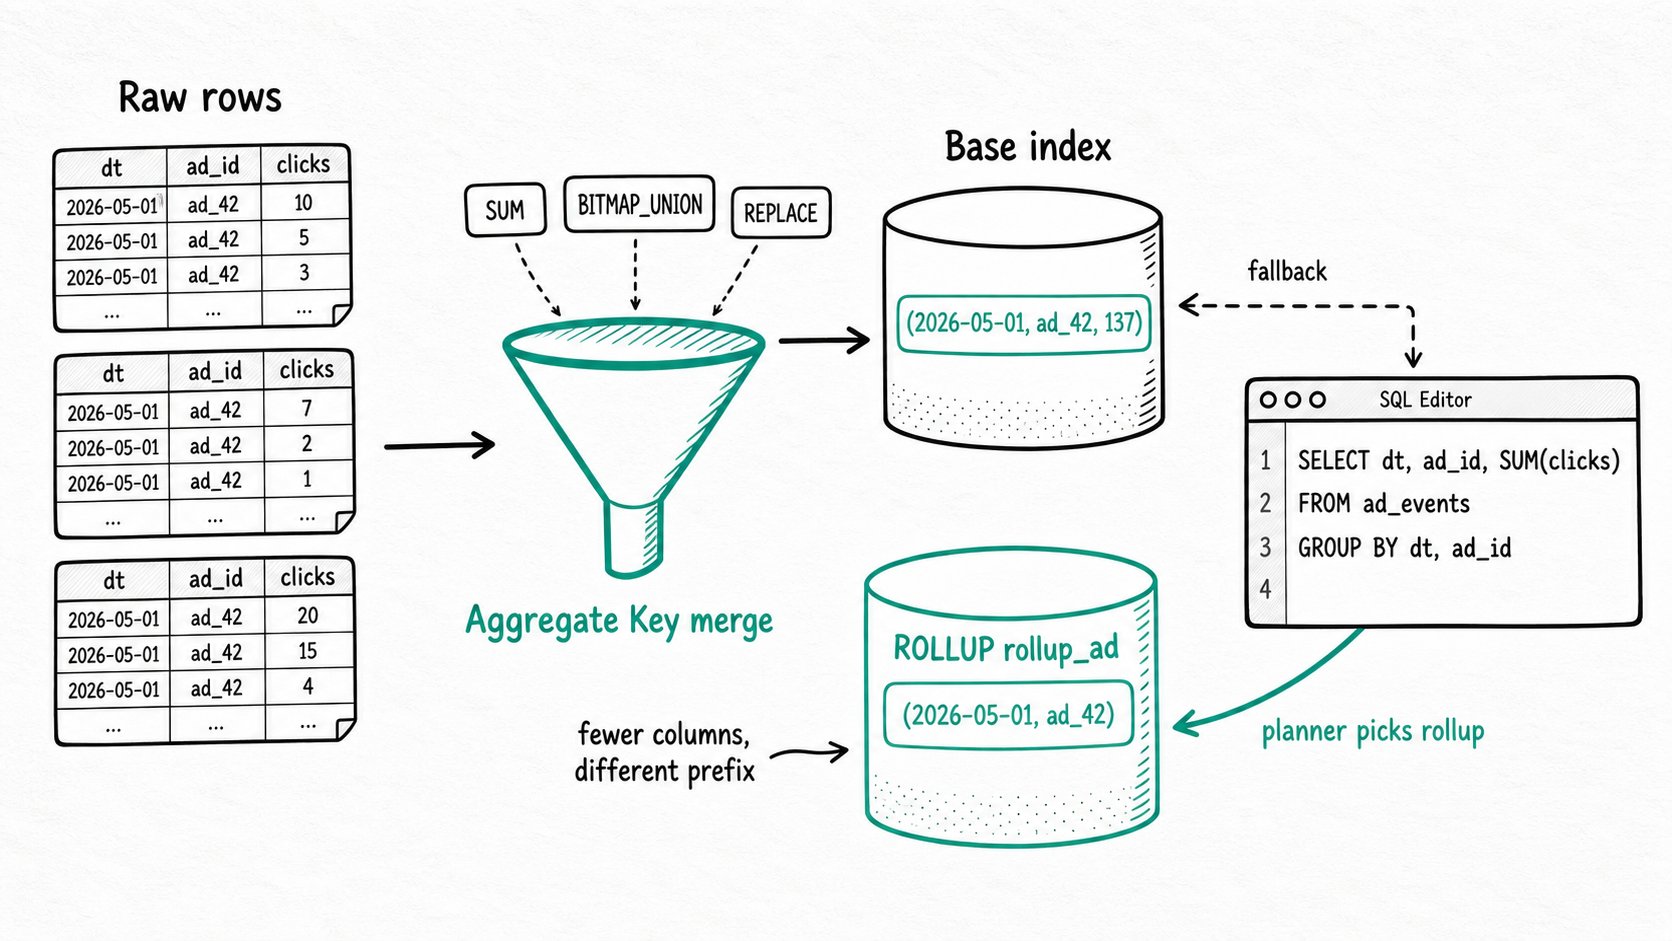
Кратко Предварительная агрегация в Apache Doris объединяет строки с одинаковым ключом при загрузке, используя модель Aggregate Key и функции для отдельных столбцов, такие как
SUM,MAX,REPLACEиBITMAP_UNION.ROLLUPпредставляет собой второй материализованный индекс с меньшим числом столбцов или другим порядком сортировки, который планировщик прозрачно выбирает для запросов, плохо обслуживаемых базовой таблицей. Запросы читают заранее вычисленные значения вместо того, чтобы группировать исходные строки при каждом обращении.
Зачем использовать предварительную агрегацию и rollup в Apache Doris?
Предварительная агрегация и rollup в Apache Doris переносят повторяющиеся операции GROUP BY с этапа выполнения запросов на этап загрузки, поэтому дашборды читают заранее вычисленные итоги вместо повторного сканирования исходной таблицы фактов при каждом обновлении. Типичная таблица фактов содержит много столбцов и подробные данные: отдельные события кликов по рекламе, записи журналов API для каждого запроса, ежесекундные показания устройств. При этом дашборду нужны итоги за день, top-N пользователей или число уникальных зрителей за месяц. Без предварительной агрегации каждый запрос повторно сканирует миллионы строк и выполняет ту же операцию GROUP BY, которую вы запускали вчера.
- Повторяющаяся работа. При каждом обновлении дашборда заново выполняется одна и та же агрегация одних и тех же исходных данных.
- Сканирование множества столбцов. Запрос с укрупнённой агрегацией читает все столбцы значений базовой таблицы, даже если ему нужны только два.
- Вычисление кардинальности обходится дорого.
COUNT(DISTINCT user_id)для таблицы с миллиардом строк превращается из запроса в отдельную вычислительную задачу.
Предварительная агрегация переносит затраты с этапа выполнения запросов на этап загрузки. ROLLUP добавляет второе заранее вычисленное представление для запросов, которым одной базовой таблицы недостаточно; для переписывания запросов с использованием нескольких таблиц или сопоставления разделов используйте инкрементальное материализованное представление.
Что такое предварительная агрегация и rollup в Apache Doris?
Предварительная агрегация в Apache Doris реализована моделью таблиц Aggregate Key, которая объединяет строки с одинаковым ключом с помощью функций агрегации для отдельных столбцов. Rollup представляет собой дополнительный материализованный индекс этой таблицы, который планировщик выбирает прозрачно. Модель Aggregate Key определяет тип таблицы. Вы указываете, какие столбцы являются ключевыми, и задаёте функцию агрегации для каждого столбца значений. Затем Apache Doris объединяет строки с одинаковым ключом как при загрузке, так и во время компактации, поэтому таблица не хранит дубликаты, для которых определено правило слияния.
ROLLUP представляет собой второй материализованный индекс той же базовой таблицы. Он содержит подмножество столбцов, возможно, в другом порядке сортировки, с применением тех же функций для отдельных столбцов. Планировщик запросов оценивает все доступные индексы для поступившего запроса и читает данные из наиболее подходящего.
Основные термины
- Модель Aggregate Key: модель таблиц, в которой строки с одинаковыми значениями ключа объединяются с помощью функций агрегации, заданных для столбцов значений.
- Функции агрегации:
SUM,MIN,MAX,REPLACE,REPLACE_IF_NOT_NULL,HLL_UNION,BITMAP_UNION,QUANTILE_UNION. Они также работают со столбцами значенийROLLUP. - Базовый индекс: структура хранения данных на диске, соответствующая вашему
CREATE TABLE. Присутствует всегда. - Индекс rollup: дополнительная материализованная структура хранения, из которой планировщик может читать данные вместо базового индекса.
- Синхронное материализованное представление: синтаксис
CREATE MATERIALIZED VIEW, который приходит на сменуALTER TABLE ADD ROLLUP. Использует тот же механизм, поддерживает более сложные выражения и рекомендуется для новых решений.
Как работают предварительная агрегация и rollup в Apache Doris?
Предварительная агрегация в Apache Doris состоит из пяти этапов: определение правил агрегации в DDL, объединение строк при загрузке и компактации, добавление rollup под особенности структуры запросов, выбор наиболее подходящего индекса для каждого запроса и использование синхронных материализованных представлений в новом коде.
- Определите правила агрегации. В
CREATE TABLEпредложениеAGGREGATE KEY(...)задаёт ключевые столбцы. Каждому другому столбцу назначается функция:clicks BIGINT SUM,last_seen DATETIME REPLACE,unique_users BITMAP BITMAP_UNION. Apache Doris использует эти функции для объединения любых двух строк с одинаковыми ключами. - Объединяйте строки при загрузке. При поступлении данных узлы Backend объединяют входящие строки с существующими строками с теми же ключами, а затем записывают новый неизменяемый rowset. Позднее фоновая компактация объединяет эти rowset по тем же правилам. Запросы видят результат объединения, а не исходные входные данные.
- Добавьте rollup для запросов с другой структурой.
ALTER TABLE ad_events ADD ROLLUP rollup_ad (dt, ad_id, clicks, cost)создаёт второй материализованный индекс с сортировкой по(dt, ad_id). Apache Doris строит его в рамках асинхронного изменения схемы, а затем поддерживает его актуальность при каждой последующей загрузке в той же транзакции, что и запись в базовую таблицу. - Выбирайте индекс для каждого запроса. Оптимизатор Nereids оценивает каждый индекс с учётом предикатов и ключей группировки запроса. Он отдаёт предпочтение индексам, в которых столбцы предикатов находятся в начале и для которых нужно сканировать меньше столбцов. Выбранный индекс отображается в
EXPLAINи в профиле BE. - Используйте синхронные MV в новом коде.
CREATE MATERIALIZED VIEWподдерживает всё, что делаетADD ROLLUP, а также выражения вродеbitmap_union(to_bitmap(user_id)). Комментарий в исходном коде Apache Doris говорит прямо: «В будущем mv полностью покроет функциональность rollup». Существующие индексы rollup продолжают работать.
Быстрый старт
CREATE TABLE ad_events (
  dt DATE,
  ad_id INT,
  user_id BIGINT,
  clicks BIGINT SUM,
  cost DECIMAL(10,2) SUM
)
AGGREGATE KEY(dt, ad_id, user_id)
DISTRIBUTED BY HASH(ad_id) BUCKETS 4;

ALTER TABLE ad_events ADD ROLLUP rollup_ad (dt, ad_id, clicks, cost);

SELECT dt, ad_id, SUM(clicks) FROM ad_events
WHERE dt = '2026-05-01' GROUP BY dt, ad_id;
Ожидаемый результат
EXPLAIN ... shows OlapScanNode: rollupName=rollup_ad
PREAGGREGATION: ON
Rollup исключает user_id, поэтому планировщик выбирает его для любого агрегирующего запроса, который группирует данные только по (dt, ad_id). При двукратной вставке одного и того же (dt, ad_id, user_id) получается одна строка с суммированными значениями clicks и cost, а в rollup в итоге остаётся одна строка на каждую комбинацию (dt, ad_id).
Когда следует использовать предварительную агрегацию и rollup в Apache Doris?
Предварительная агрегация в Apache Doris подходит для таблиц фактов, в которые преимущественно добавляются новые данные и для которых характерны устойчивые схемы агрегации, для rollup с подсчётом уникальных значений и квантилей с помощью BITMAP_UNION и HLL_UNION, а также для дашбордов, выполняющих один и тот же GROUP BY тысячи раз в день. Она не подходит для поиска отдельных исходных строк, соединений нескольких таблиц или частых точечных обновлений по первичному ключу.
Подходит
- Таблицы фактов, в которые преимущественно добавляются новые данные и которые агрегируются по небольшому стабильному набору измерений.
- Подсчёт уникальных значений и квантилей.
BITMAP_UNIONиHLL_UNIONпозволяют за миллисекунды объединять заранее вычисленные скетчи за разные дни или из разных разделов. - Отчёты Top-N или «по часам», построенные на данных отдельных событий, в которых один и тот же
GROUP BYвыполняется тысячи раз в день.
Не подходит
- Таблицы, в которых также нужен поиск отдельных исходных строк. Aggregate Key уже объединила исходные строки. Используйте модель Duplicate Key, а если нужны и предварительно агрегированные представления, добавьте асинхронное материализованное представление.
- Соединения нескольких таблиц. И
ROLLUP, и синхронные MV работают только с одной таблицей. Используйте асинхронные материализованные представления, если нужно переписывание запросов с использованием нескольких таблиц или обновление по разделам. - Частые точечные обновления по первичному ключу. Используйте модель Unique Key с merge-on-write.
- Проектирование с нуля с использованием
ALTER TABLE ADD ROLLUP. Вместо этого используйтеCREATE MATERIALIZED VIEW. Синтаксис различается, но механизм выполнения общий, а новые возможности появляются в MV.
Дополнительные материалы
- Модель данных: почему Aggregate Key является одной из трёх моделей таблиц и в каких случаях подходят Duplicate Key и Unique Key.
- Агрегатная модель: размещение данных, правила слияния и настройка
- Синхронное материализованное представление: современная замена
ADD ROLLUP - Асинхронное материализованное представление: предварительная агрегация нескольких таблиц с разными режимами обновления
- Справочник по синтаксису
ALTER TABLE ROLLUP