Кэш запросов Query Cache
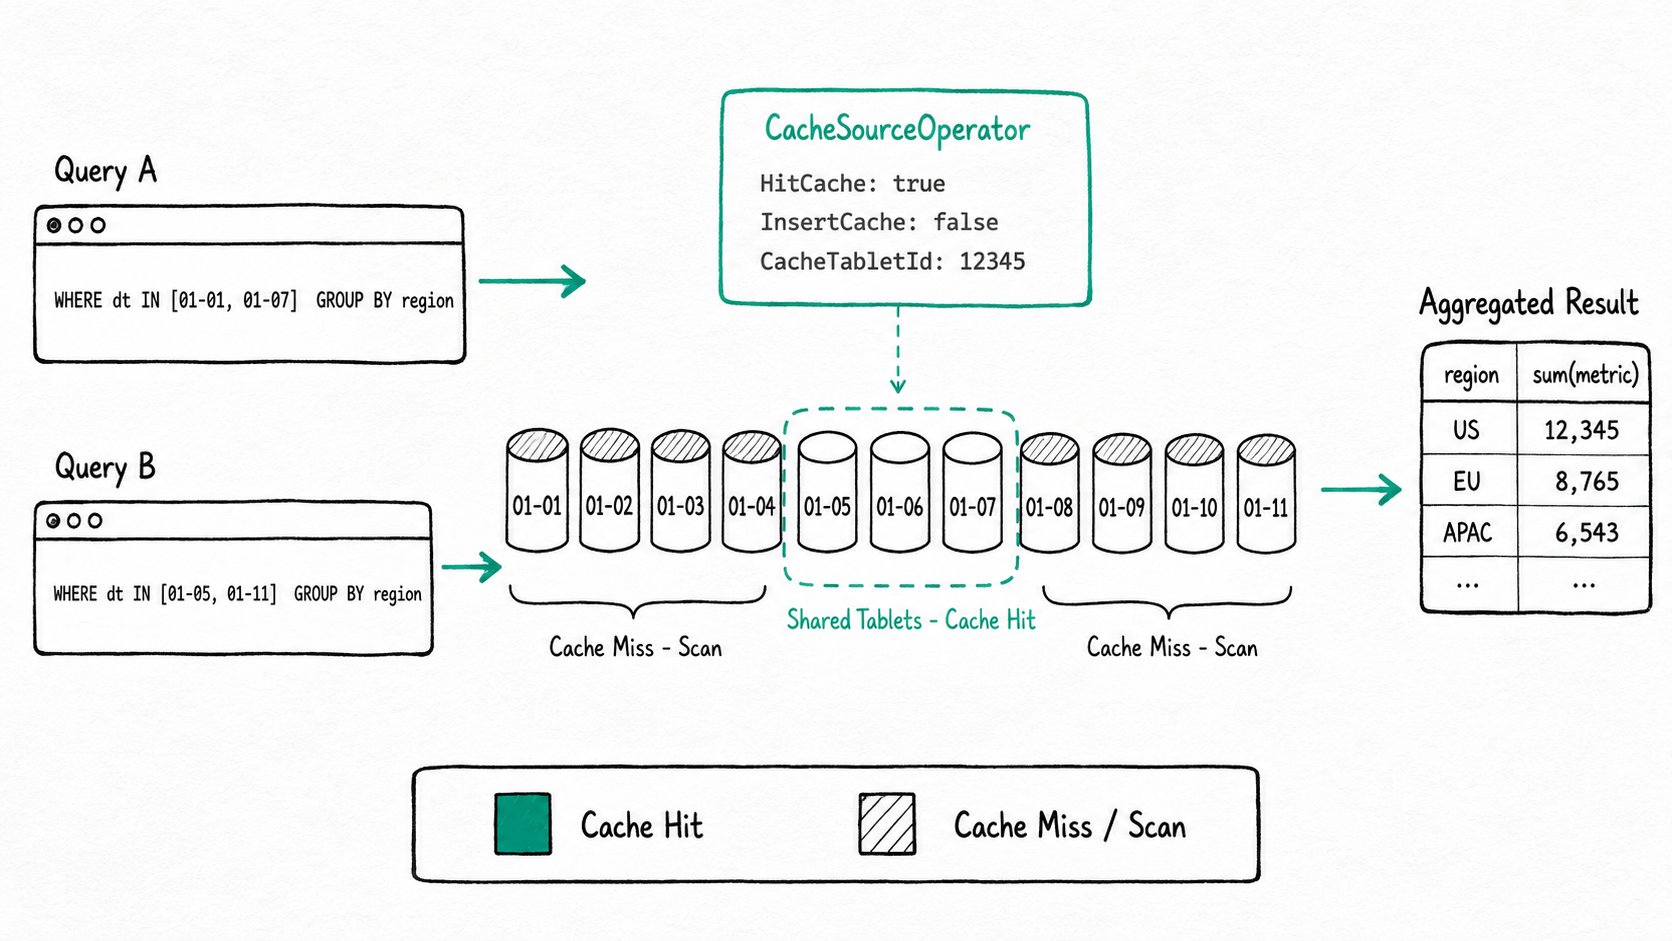
Кратко Query Cache в Apache Doris представляет собой кэш конвейерного движка для запросов агрегации к внутренним таблицам OLAP. Query Cache хранит частичные результаты агрегации на уровне tablet; ключ формируется из дайджеста плана, ID и версии tablet. Два запроса, обращающиеся к одному tablet, используют общий кэш для этого tablet, даже если их диапазоны дат пересекаются лишь частично. Поэтому дашборд, повторяющий один и тот же
GROUP BYкаждые 15 секунд, перестаёт заново сканировать те же tablet при каждом обновлении.
Зачем использовать Query Cache в Apache Doris?
Query Cache в Apache Doris устраняет повторную работу на уровне tablet, которую создают BI-дашборды, выполняя одну и ту же агрегацию по пересекающимся партициям каждые несколько секунд. Большую часть BI-нагрузки составляют повторяющиеся агрегации. Виджет дашборда при каждом обновлении заново выполняет один и тот же SUM/COUNT/AVG. Отчёт T+1 один раз агрегирует данные из партиции за прошлую ночь, а затем повторяет агрегацию каждый раз, когда сегодня кто-то открывает страницу. Панель трейдера каждые пять секунд выполняет один и тот же GROUP BY symbol по книге заявок, в которой за минуту меняются лишь несколько tablet.
Один и тот же tablet снова и снова даёт одинаковый частичный результат агрегации, а кластер каждый раз тратит ресурсы на полное сканирование и агрегацию.
SQL Cache помогает, когда текст SQL побайтово совпадает, но перестаёт помогать, как только сдвигается хотя бы один фильтр или один tablet получает новую версию. Материализованное представление фиксирует структуру запроса, но требует поддержки самого представления и расписания его обновления.
Query Cache работает на более мелком уровне, чем оба этих подхода: он кэширует вклад одного tablet в одну агрегацию. Именно на этом уровне вычисления при обновлении дашбордов действительно повторяются: диапазоны фильтрации сдвигаются на день вперёд, и при каждом обновлении появляются лишь одна или две новые партиции.
Что такое Query Cache в Apache Doris?
Query Cache в Apache Doris представляет собой оптимизацию конвейерного движка, которая включается, когда фрагмент соответствует структуре AggregationNode -> OlapScanNode или AggregationNode -> AggregationNode -> OlapScanNode для двухэтапной агрегации. Между ними допускаются узлы фильтрации и проекции. Узлы соединения, сортировки, объединения, оконных функций и обмена данными не допускаются. Если фрагмент подходит, BE проверяет кэш перед сканированием. При попадании диапазон сканирования пропускается, а кэшированные блоки выдаются напрямую. При промахе результат вычисляется обычным способом и записывается в кэш, отдельной записью для каждого tablet.
Основные термины
enable_query_cache: переменная сеанса. По умолчанию выключена; включайте её для отдельного сеанса или задавайте глобально для учётных записей дашбордов.CacheSourceOperator: оператор конвейера, который вставляется между агрегацией и сканированием. Его раздел в профиле содержит показателиHitCache,InsertCacheиCacheTabletIdдля каждого tablet.SQL digest: хеш SHA-256 нормализованного плана агрегации, включающего функции, ключи группировки, предикаты, не связанные с партиционированием, проецируемые столбцы и переменные сеанса, влияющие на результат. Семантически эквивалентные SQL-запросы дают одинаковый дайджест.Tablet range: диапазон, определяемый из предикатов по партициям. Включается в ключ кэша, чтобы два запроса могли повторно использовать кэш для общих партиций.LRU-K (K=2): политика добавления в кэш. К новой записи нужно обратиться как минимум дважды, прежде чем для неё будет выделено место, поэтому разовый ad-hoc-запрос не вытеснит записи, от которых зависит работа дашбордов.
Как работает Query Cache в Apache Doris?
Query Cache в Apache Doris выявляет в FE шаблон агрегации над сканированием, формирует для каждого tablet ключ кэша из дайджеста плана, ID и версии tablet и проверяет кэш перед сканированием на каждом BE. Описанный ниже процесс из пяти шагов включает проверку плана, построение ключа, поиск в кэше и обработку попадания или промаха.
- Проверка плана (FE). Nereids обходит каждый фрагмент в поисках шаблона агрегации над сканированием. Наличие соединений, сортировок, узлов, к которым применяются runtime-фильтры, сканирования внешних таблиц или недетерминированных выражений исключает использование кэша для фрагмента.
- Построение ключа кэша (FE). Для таблиц с партиционированием RANGE по одному столбцу планировщик извлекает предикаты по партициям и вычисляет пересечение диапазона предиката с каждой сканируемой партицией. Дайджест плана охватывает остальную часть запроса. Ключ для каждого tablet имеет вид
(digest, tablet_id, tablet_range). - Поиск в кэше для каждого tablet (BE). Для каждого назначенного tablet метод
QueryCache::lookup(key, version)проверяет и ключ кэша, и версию tablet. Любая операцияINSERT,DELETE,UPDATEили compaction после записи элемента в кэш приводит к промаху. - При попадании. Оператор сканирования пропускает диапазон, оператор агрегации ничего не выдаёт, а
CacheSourceOperatorвыдаёт кэшированные блоки. Если порядок проекции отличается от порядка в записи кэша (SELECT a, bиSELECT b, aпри одинаковом дайджесте), столбцы автоматически переупорядочиваются. - При промахе. Фрагмент вычисляет частичный результат агрегации, как обычно передаёт строки дальше по конвейеру и сохраняет копию в буфере. После завершения фрагмента результаты, не превышающие ограничения
query_cache_entry_max_bytes(5 MB) иquery_cache_entry_max_rows(500,000), записываются в кэш.
Быстрый старт
SET enable_query_cache = true;

-- Run 1: warms the cache for partitions 2024-01-01 .. 2024-01-07
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt >= '2024-01-01' AND dt < '2024-01-08'
GROUP BY region;

-- Run 2: overlapping window, three shared days
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt >= '2024-01-05' AND dt < '2024-01-12'
GROUP BY region;
Ожидаемый результат (фрагмент EXPLAIN PROFILE)
CacheSourceOperator
  HitCache:      true
  InsertCache:   false
  CacheTabletId: 12345
Первый запуск не находит в кэше ни одного tablet и записывает частичные результаты агрегации отдельно для каждого из них. При втором запуске для трёх общих дней (с 2024-01-05 по 2024-01-07) используется кэш, а сканируются только новые дни (с 2024-01-08 по 2024-01-11). Чтобы убедиться, что произошло попадание, найдите в профиле CacheSourceOperator: значение HitCache: true для конкретного tablet означает, что данные для него были получены из памяти.
Когда стоит использовать Query Cache в Apache Doris?
Используйте Query Cache в Apache Doris для BI-дашбордов, отчётов T+1 и агрегаций со скользящим окном на внутренних таблицах с партиционированием RANGE по одному столбцу. Избегайте его использования для запросов с JOIN/ORDER/UNION/оконными функциями, внешних таблиц lakehouse (для них используйте SQL Cache), таблиц с интенсивной записью и точечных запросов по первичному ключу.
Подходит
- BI-дашборды и виджеты, которые повторяют одну и ту же агрегацию много раз в минуту.
- Отчёты T+1. После завершения загрузки данных за день повторные чтения обслуживаются из кэша, пока завтрашняя загрузка не сделает запись для новой партиции недействительной.
- Запросы агрегации со скользящими диапазонами дат, в которых между обновлениями изменяется только самая свежая партиция.
- Таблицы с партиционированием
RANGEпо одному столбцу. Именно такая структура позволяет повторно использовать кэш на уровне tablet при разных диапазонах фильтрации.
Не подходит
- Запросы с
JOIN,ORDER BY,UNIONили оконными функциями в кэшируемом поддереве. Сначала выполните агрегацию, затем соединение или создайте асинхронное материализованное представление для плана с соединением. - Внешние таблицы (Hive, Iceberg, Hudi, Paimon, JDBC). Ключ кэша строится на ID и версии tablet, которых нет у внешних таблиц. Вместо него используйте SQL Cache.
- Таблицы с частой записью, в которые данные записываются каждые несколько секунд. Каждое изменение версии делает запись кэша для соответствующего tablet недействительной, поэтому доля попаданий остаётся низкой. Если вам нужно повторно использовать результаты фильтрации, обратите внимание на Condition Cache.
- Запросы с
now(),rand(),uuid()или недетерминированными UDF. План считается недетерминированным, и кэш отключается. Используйте вместо них выражения с привязкой к дню, напримерWHERE dt = date(now()). - Таблицы с партиционированием
RANGEпо нескольким столбцам илиLISTпри изменяющихся диапазонах фильтрации. Предикат по партициям включается в дайджест без изменений, поэтому разные диапазоны дают разные ключи. Повторное использование кэша на уровне tablet работает только для партиционированияRANGEпо одному столбцу. - Поиск по первичному ключу. Query Cache предназначен для агрегаций. Для шаблонов
WHERE pk = ?используйте точечные запросы при высокой конкурентной нагрузке.
Параметры настройки
| Параметр | Где задаётся | По умолчанию | Когда менять |
|---|---|---|---|
enable_query_cache | сеанс | false | Всегда: задавайте для отдельного сеанса или глобально для учётных записей дашбордов. |
query_cache_entry_max_bytes | сеанс | 5 MB | Увеличьте для группировок с большим числом столбцов; результаты сверх лимита не кэшируются без уведомления. |
query_cache_entry_max_rows | сеанс | 500,000 | Увеличьте при высокой кардинальности GROUP BY. |
query_cache_size | be.conf | 512 MB | Лимит памяти на BE. Увеличьте для дашбордов, ограниченных объёмом кэша. |
query_cache_force_refresh | сеанс | false | Установите true для одного запроса, если подозреваете, что результат в кэше устарел, затем сбросьте значение. |
Дополнительные материалы
- Руководство пользователя Query Cache
- SQL Cache: кэширование результатов любых запросов
- Condition Cache: кэширование результатов фильтрации на уровне сегментов
- Асинхронные материализованные представления: предварительная агрегация сложных конвейеров
- Кэширование в Doris: выбор подходящей стратегии
- Data Cache & Page Cache: кэши уровня хранения, расположенные ниже Query Cache и используемые при повторных сканированиях.
- Metadata Cache: кэш метаданных внешнего Catalog для федеративных запросов к lakehouse.
- Архитектура MPP: модель выполнения, в которой Query Cache пропускает вычисления в DAG фрагментов, если результат можно использовать повторно.