Выгрузка на диск
Кратко Механизм выгрузки на диск в Apache Doris позволяет операторам HashJoin, Aggregation, Sort и CTE записывать промежуточное состояние на локальный диск, когда запрос близок к превышению выделенного ему лимита памяти. Запрос выполняется медленнее, но завершается без OOM. Включите механизм командой
set enable_spill = trueдля сессии или на уровне Workload Group, укажите BE каталог для выгрузки и просматривайте счётчики выгрузки в профиле запроса.
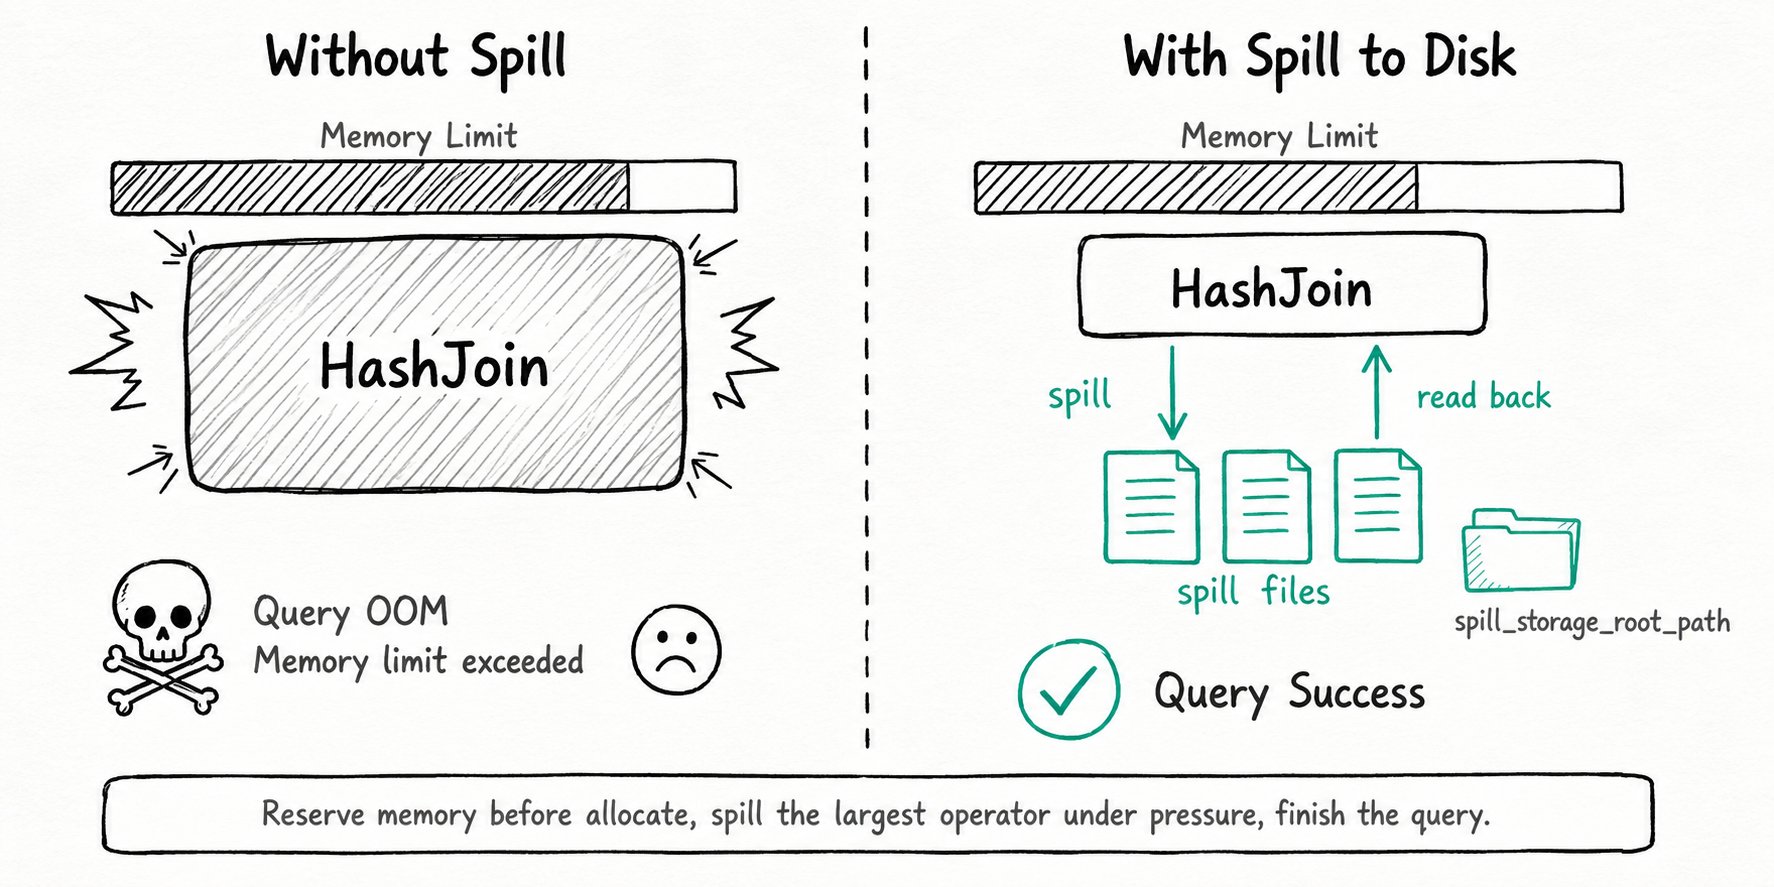
Зачем использовать выгрузку на диск в Apache Doris?
Выгрузка на диск позволяет запросам в Apache Doris завершаться при нехватке памяти, хотя и медленнее. Apache Doris использует архитектуру MPP: по умолчанию хеш-таблицы соединений, состояние агрегации и буфер сортировки находятся в памяти BE. Это обеспечивает низкую задержку, но становится проблемой, как только запросу требуется больше памяти, чем разрешено использовать узлу, запросу или группе рабочей нагрузки. Типичный сценарий сбоя: ночной ETL или разовый запрос в стиле TPC-DS обращается к широкой таблице фактов, строит хеш-таблицу на несколько гигабайт, а затем завершается с ошибкой Memory limit exceeded. Пользователь повторяет попытку, снова сталкивается с тем же ограничением и либо увеличивает exec_mem_limit, либо отказывается от запроса.
- Одного слишком большого HashJoin или Aggregation достаточно, чтобы прервать весь запрос.
- ETL для таблиц, объём которых значительно превышает RAM, работает ненадёжно или вообще невозможен.
- Увеличение
exec_mem_limitдля отдельного запроса оставляет остальных без нужного объёма памяти. - Тяжёлые запросы, выполняемые одновременно, приближают потребление памяти BE к общему пределу и вызывают экстренную отмену запросов.
Механизм выгрузки на диск в Apache Doris позволяет таким запросам завершаться успешно, хотя и медленнее. Тот же узел, на котором раньше возникал OOM при объёме данных 10x, теперь завершает запрос и при 50x, расплачиваясь дисковым IO вместо аварийного завершения.
Что такое выгрузка на диск в Apache Doris?
Выгрузка на диск в Apache Doris представляет собой механизм в Pipeline Execution Engine, который позволяет операторам с высоким потреблением памяти при её нехватке выгружать промежуточное состояние на локальный диск, а затем считывать его обратно для завершения запроса. Механизм работает на уровне операторов, а не всего запроса: выгружается состояние только тех операторов, которые действительно занимают много памяти, и запрос может продолжать выполнение, используя состояние как в памяти, так и на диске.
Основные термины
Spillable operator: оператор, способный по запросу освободить память. Сейчас это HashJoin (хеш-соединение с разбиением на разделы), Aggregation (агрегация с разбиением на разделы), Sort (внешняя сортировка слиянием) и CTE.Reserve memory: перед обработкой блока оператор оценивает необходимый объём памяти и резервирует её через трекер памяти. Неудачная попытка резервирования запускает выгрузку ещё до фактического выделения памяти.Revocable memory: часть памяти оператора, содержимое которой можно записать на диск, а саму память освободить. Планировщик первым выбирает для выгрузки оператор с наибольшим объёмом такой памяти.Force spill: режим отладки (enable_force_spill), при котором выгрузка выполняется даже при достаточном объёме свободной памяти. Используйте его, чтобы проверить корректность запросов при выгрузке на диск, прежде чем полагаться на этот механизм в рабочей среде.- Путь хранения файлов выгрузки: локальные каталоги, которые BE использует для файлов выгрузки. Они настраиваются отдельно от пути хранения таблиц.
Как работает выгрузка на диск в Apache Doris?
Механизм выгрузки на диск в Apache Doris резервирует память до её выделения, обнаруживает её нехватку, выбирает оператор с наибольшим объёмом освобождаемой памяти, записывает его состояние на диск по разделам и возобновляет запрос после освобождения памяти. Описанные ниже шесть шагов охватывают полный жизненный цикл.
- Резервирование до выделения. Каждая задача конвейера оценивает объём памяти, необходимый для следующего блока, и запрашивает резервирование у трекеров памяти запроса и процесса. Быстрая и точная оценка лучше, чем экстренная отмена запросов впоследствии.
- Обнаружение нехватки памяти. Резервирование не удаётся, если оно приведёт к превышению лимита запроса, группы рабочей нагрузки или процесса BE. Задача приостанавливается, а не отменяется.
- Выбор оператора для выгрузки. Планировщик запросов просматривает операторы приостановленного запроса и выбирает тот, у которого больше всего освобождаемой памяти: обычно это хеш-таблица стороны построения или текущая таблица агрегации.
- Выгрузка по разделам. Partitioned HashJoin и Partitioned Aggregation с помощью хеширования распределяют своё состояние по N разделам (
spill_hash_join_partition_count,spill_aggregation_partition_count) и через пул потоков IO для выгрузки записывают на диск разделы целиком. Sort записывает отсортированные серии, которые позднее объединяются слиянием. - Возобновление и завершение. Как только освобождается достаточно памяти, выполнение задачи возобновляется. Строки со стороны probe распределяются той же функцией разбиения, поэтому в каждом разделе соединение или агрегация выполняется с соответствующими данными на диске. Результат корректен; запрос просто тратит дополнительное время на дисковый IO.
- Учёт и очистка. В профиле фиксируются все счётчики выгрузки (объём записанных данных в байтах, количество файлов, ожидание IO, перекос распределения по разделам). Файлы выгрузки хранятся по пути
spill_storage_root_pathи удаляются фоновой задачей.
Быстрый старт
-- Enable spill for this session (or set it on a workload group).
SET enable_spill = true;
-- Spill paths do real disk IO, so give the query a longer budget.
SET query_timeout = 3600;
-- Run a query that would normally OOM.
SELECT l_orderkey, SUM(l_quantity)
FROM lineitem JOIN orders ON l_orderkey = o_orderkey
WHERE o_orderdate >= '1995-01-01'
GROUP BY l_orderkey
ORDER BY 2 DESC LIMIT 100;
-- Check that spill actually happened.
SELECT query_id, spill_write_bytes_to_local_storage
FROM information_schema.backend_active_tasks;
Ожидаемый результат
Запрос возвращает 100 строк с наибольшими значениями. В профиле запроса найдите Spilled: true у оператора PARTITIONED_HASH_JOIN_SINK_OPERATOR или AGGREGATION_SINK_OPERATOR, а также SpillWriteBlockBytes, SpillWriteFileBytes и SpillWriteTime. В журналы аудита для того же запроса добавляются SpillWriteBytesToLocalStorage и SpillReadBytesFromLocalStorage. Если эти счётчики равны нулю, запросу хватило памяти и выгрузка не потребовалась. Именно такой результат и желателен.
Когда стоит использовать выгрузку на диск в Apache Doris?
Используйте выгрузку на диск в Apache Doris для ресурсоёмкого ETL, пакетной аналитики и мультитенантных нагрузок, когда завершение запроса важнее задержки. Не используйте её для обслуживания запросов с задержкой менее секунды и запросов с неконтролируемым потреблением ресурсов.
Подходящие сценарии
- Ресурсоёмкий ETL для таблиц, объём которых значительно превышает память отдельного узла: агрегации и соединения должны завершаться за ночь при любом перекосе в распределении данных.
- TPC-DS, обновление материализованных представлений на основе нескольких таблиц и другие пакетные задания, которые выполняют несколько крупных хеш-соединений в одном плане.
- Запросы, у которых иногда резко возрастает потребление памяти при обработке широкого раздела. Вы соглашаетесь на увеличение задержки, чтобы пережить такой всплеск.
- Мультитенантные кластеры, где для каждой Workload Group установлены жёсткие ограничения, а превышение лимита должно вызывать выгрузку, а не отмену запросов.
Неподходящие сценарии
- Сценарии обслуживания, чувствительные к задержке (точечный поиск, дашборды со временем отклика менее секунды). Дисковый IO нарушит SLA, а такие запросы вообще не должны превышать лимит памяти. Корректно настройте
exec_mem_limitи оставьте выгрузку отключённой. - Нагрузки, для которых увеличение памяти обходится дешевле дискового IO. Если запрос превышает лимит на 10%, увеличение
exec_mem_limitилиmax_memory_percentпозволит завершить его быстрее, чем выгрузка. - Потоковая агрегация. Для потоковой агрегации выгрузка не предусмотрена. Переключитесь на непотоковую агрегацию или примите соответствующие затраты памяти.
- Кластеры без свободного места на локальных дисках и без SSD. При интенсивной выгрузке механические диски будут определять основную часть времени выполнения запроса и оставлять обычным сканированиям слишком мало пропускной способности IO.
- Попытки обойти проблему запросов с неконтролируемым потреблением ресурсов. Выгрузка позволяет работать с хеш-таблицей размером 100GB. Но
SELECT *по миллиарду строк по-прежнему требует ресурсов. Используйте выгрузку вместе с ограничениями и очередями Workload Group.
Дополнительные материалы
- Руководство администратора по выгрузке на диск: полная конфигурация BE, переменные сессии FE, выделение памяти на основе слотов и проверочный прогон TPC-DS 10TB.
- Workload Group: ограничения памяти для каждой группы и то, как верхний порог запускает выгрузку до отмены запроса.
- Pipeline Execution Engine: среда выполнения, которая отвечает за учёт резервирования памяти до её выделения и учёт освобождаемой памяти.
- Профиль запроса: как читать счётчики
Spill*для отдельных операторов, подтверждающие факт выгрузки. - Системная таблица
backend_active_tasks: актуальный объём выгрузки в байтах для каждого запроса, используемый для мониторинга и оповещений. - Архитектура MPP: распределённый уровень выполнения, который задаёт
exec_mem_limitдля каждого BE; выгрузка на диск соблюдает этот лимит.