Unique Key
Кратко Модель Unique Key в Apache Doris представляет собой модель таблицы с первичным ключом: одна строка на первичный ключ и поддержка SQL
UPDATEиDELETE, как в транзакционной базе данных. Upsert с частичным обновлением столбцов поступают прямо из Stream Load в таблицу. Начиная с версии 2.1 модель Unique Key по умолчанию использует Merge-on-Write, поэтому дубликаты устраняются при записи, а запросам не требуется объединять версии при чтении.
Зачем использовать модель Unique Key в Apache Doris?
Модель Unique Key в Apache Doris даёт OLAP-движку полноценную семантику первичного ключа: одна строка на ключ, немедленное обеспечение уникальности при записи и SQL UPDATE/DELETE, которые работают без перезаписи партиций. Большинство аналитических движков рассматривают таблицы как структуры, в которые можно только добавлять данные. А затем появляется CDC. Строка в MySQL обновляется, пользователь запрашивает удаление данных в соответствии с GDPR, запоздавшее событие должно перезаписать более старое. В модели таблицы, допускающей только добавление данных, можно записать эти изменения, но нельзя заставить хранилище забыть старую версию без перезаписи всей партиции.
- Задание Flink CDC отслеживает MySQL, и каждое обновление по первичному ключу должно попадать в таблицу за считаные секунды.
- В таблице статусов заказов состояния последовательно меняются с
createdнаpaid,shipped,delivered, а запросы должны видеть только последнее состояние. - Таблица профилей пользователей используется для соединений в реальном времени, и соединение никогда не должно видеть вчерашний адрес электронной почты.
Для этого и предназначена модель Unique Key. Новая запись с существующим ключом заменяет старую строку, UPDATE и DELETE выполняются как обычные операции SQL, а аналитические запросы по-прежнему работают со скоростью колоночного движка. Ближайший аналог в других OLAP-движках, ReplacingMergeTree в ClickHouse, не обеспечивает немедленную уникальность: строки-дубликаты остаются видимыми до фонового слияния, и даже после этого движок гарантирует лишь то, что дубликаты в конечном счёте будут устранены. Запрос сразу после записи всё ещё может увидеть старую версию, а обходной путь с SELECT ... FINAL принудительно выполняет дедупликацию при чтении, что требует ощутимых затрат. Unique Key позволяет обойтись без такого компромисса. Новая строка заменяет старую при записи, и следующий запрос видит одну строку на ключ.
Что такое модель Unique Key в Apache Doris?
Модель Unique Key в Apache Doris хранит ровно одну строку на первичный ключ; движок Merge-on-Write обеспечивает это при записи. Предложение UNIQUE KEY(...) в CREATE TABLE задаёт ключевые столбцы; все остальные являются столбцами значений. Две строки с одинаковым ключом не могут существовать одновременно. Новая запись с существующим ключом заменяет строку.
... UNIQUE KEY(order_id) ...
... UNIQUE KEY(tenant_id, user_id) ...
В Catalog FE эта модель обозначается как KeysType.UNIQUE_KEYS, и с этого момента движок хранения обеспечивает соблюдение её правил. Модель задаётся при создании таблицы и не может быть изменена позже.
Основные термины
- Первичный ключ: столбцы, указанные в
UNIQUE KEY(...). Они определяют порядок данных на диске и обеспечивают уникальность. - Столбцы значений: все остальные столбцы. Хранятся в том виде, в котором были записаны, без агрегации.
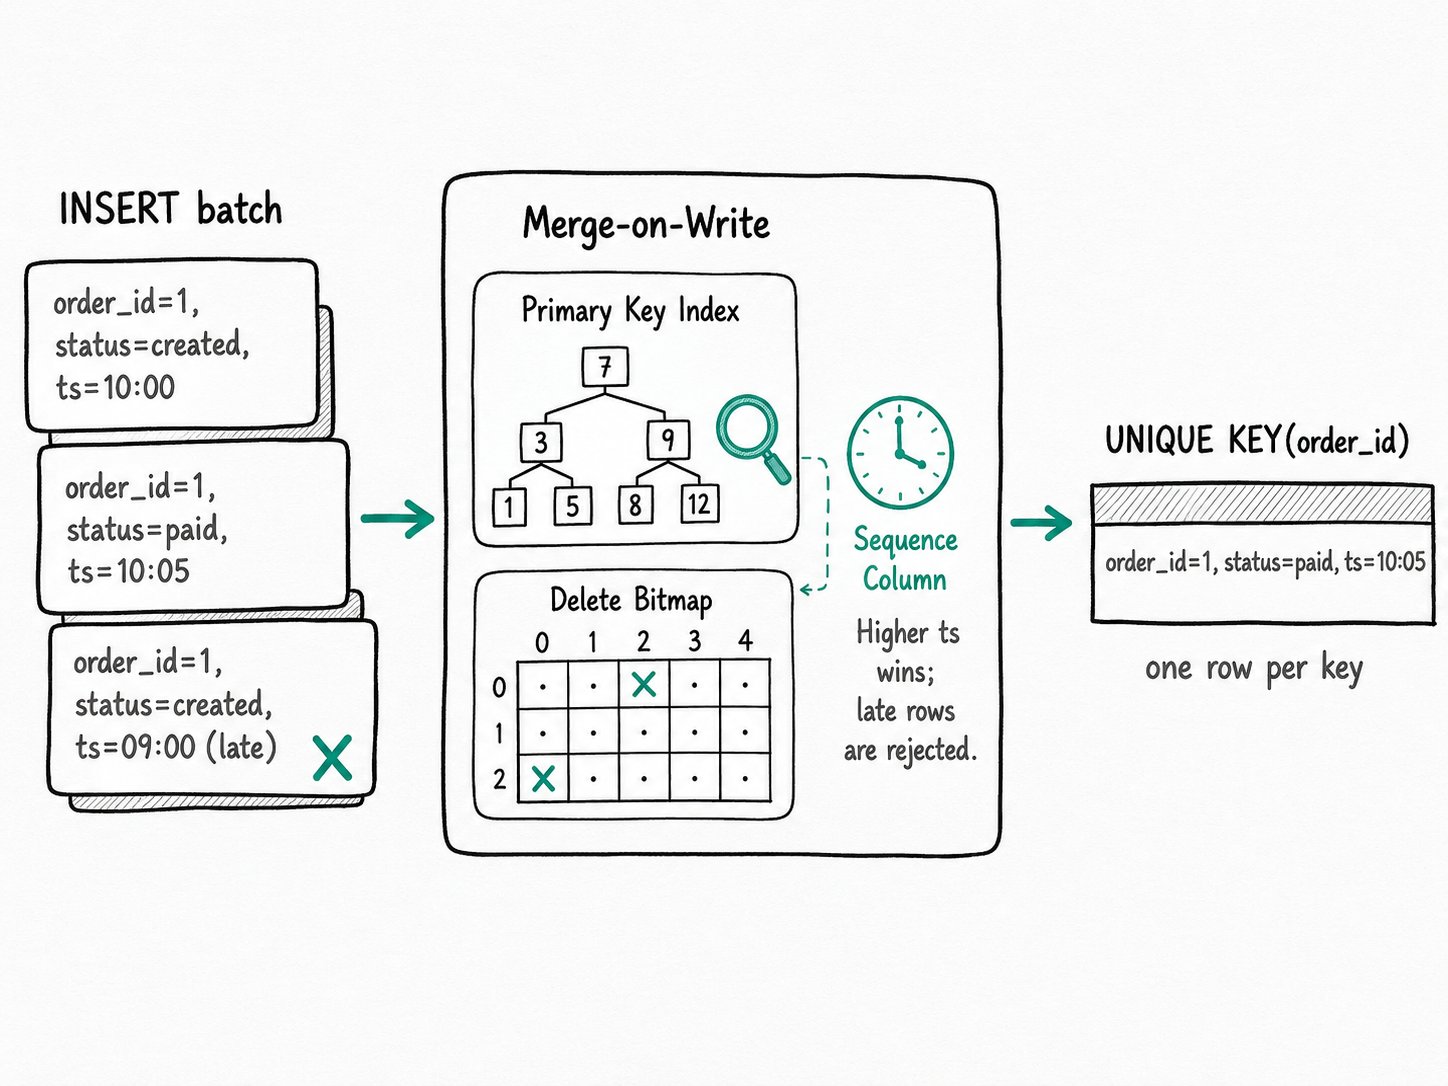
- Merge-on-Write (MoW): механизм хранения по умолчанию с версии 2.1. При новой записи выполняется поиск существующей строки, её идентификатор помечается в битовой карте удаления соответствующего rowset, а новая строка добавляется в новый rowset.
- Merge-on-Read (MoR): более старый механизм хранения. Запись добавляет данные; чтение объединяет несколько версий каждого ключа на лету. Его по-прежнему можно выбрать с помощью
enable_unique_key_merge_on_write = false. - Битовая карта удаления: битовая карта Roaring с ключом
(rowset_id, segment_id, version), содержащая идентификаторы строк, которые запросы должны пропускать. Эта структура MoW заменяет объединение версий при чтении. - Столбец последовательности (
function_column.sequence_col): столбец значений, который определяет, какая запись побеждает, если два обновления содержат одинаковый ключ. События CDC, поступающие не по порядку, используют его для сохранения более нового состояния. - Частичное обновление столбцов: upsert, при котором записывается только часть столбцов. Apache Doris читает остальные значения из существующей строки и записывает обратно полную строку.
__DORIS_DELETE_SIGN__: скрытый столбец типа tinyint. Установите его в1через любой способ загрузки, чтобы логически удалить строку.
Как работает модель Unique Key в Apache Doris?
Модель Unique Key в Apache Doris выполняет каждый upsert в пять этапов: буферизация пакета, поиск ключей в индексе первичного ключа каждого сегмента, установка битов удаления для старых строк, определение порядка с помощью столбца последовательности и публикация нового rowset.
Рассмотрим upsert в таблицу Unique Key с MoW.
- Буферизация пакета. Экземпляры BE собирают входящие строки в memtable и сортируют их по ключу.
- Поиск каждого ключа. Для каждого ключа в пакете BE обращается к индексу первичного ключа каждого сегмента (одно короткое чтение на ключ), чтобы найти существующий rowset и идентификатор строки. Индекс представляет собой отсортированную структуру с разбиением на страницы, которая создаётся при сбросе каждого сегмента и концептуально похожа на секционированный индекс RocksDB.
- Пометка старых строк. В битовой карте удаления каждого затронутого rowset устанавливаются биты, соответствующие идентификаторам старых строк. Битовая карта ведётся для каждого
(rowset_id, segment_id, version), а старые данные остаются на диске, пока компактация не освободит занимаемое ими место. - Определение порядка с помощью столбца последовательности. Если задано свойство
function_column.sequence_col, MoW сравнивает значение последовательности входящей строки со значением__DORIS_SEQUENCE_COL__текущей строки. Побеждает большее значение. При равных значениях используется порядок загрузки. Столбец последовательности должен иметь целочисленный тип либо типDATE/DATETIME/TIMESTAMP_NS. - Публикация нового rowset. Транзакция фиксируется, новая версия становится видимой, и с этого момента запросы фильтруют строки по объединённой битовой карте удаления. Объединять версии при чтении не требуется.
DELETE FROM ... WHERE проходит по тому же пути, но без нового rowset. Частичные обновления добавляют ещё один шаг: перед записью BE читает неизменённые столбцы для каждого ключа, чтобы сохранить полную строку.
Быстрый старт
CREATE TABLE orders (
  order_id BIGINT,
  status   VARCHAR(20),
  amount   DECIMAL(10, 2),
  updated  DATETIME
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 4
PROPERTIES ("function_column.sequence_col" = "updated");

INSERT INTO orders VALUES
  (1, 'created', 99.50, '2026-05-08 10:00:00'),
  (1, 'paid',    99.50, '2026-05-08 10:05:00'),
  (1, 'created', 99.50, '2026-05-08 09:00:00');  -- late event

SELECT * FROM orders;
Ожидаемый результат
+----------+--------+--------+---------------------+
| order_id | status | amount | updated             |
+----------+--------+--------+---------------------+
|        1 | paid   |  99.50 | 2026-05-08 10:05:00 |
+----------+--------+--------+---------------------+
Три вставки, одна строка. Вторая операция INSERT перезаписала первую, потому что ключи совпали. Третья попыталась снова перезаписать строку, но её значение updated было более ранним, чем текущее значение последовательности, поэтому MoW сохранил существующую строку. Если бы свойство function_column.sequence_col отсутствовало, третья строка победила бы исключительно за счёт порядка загрузки, что нежелательно для CDC.
Когда следует использовать модель Unique Key в Apache Doris?
Модель Unique Key в Apache Doris подходит для приёмников CDC, таблиц измерений и справочников реального времени, часто меняющихся таблиц заказов, пользователей и балансов, точечных запросов в стиле KV в сочетании с store_row_column, удаления отдельных строк по GDPR и сборки широких таблиц из нескольких исходных систем. Она не подходит для потоков событий, в которые данные только добавляются, циклов с частым обновлением отдельных строк, случайных или очень широких первичных ключей, а также нагрузок с большим числом count(*) при использовании более старого механизма Merge-on-Read.
Подходящие сценарии
- Приёмники CDC из MySQL, Postgres или любого источника с первичным ключом. Используйте столбец последовательности со временем фиксации транзакции или LSN источника. См. Интеграция с Kafka CDC.
- Таблицы измерений и справочники реального времени, которые используются в соединениях при запросах к таблицам фактов.
- Таблицы заказов, пользователей, балансов или состояний сеансов, которые часто меняются и используются в аналитических запросах.
- Точечные запросы в стиле KV при сочетании MoW с
store_row_columnи подготовленным запросом. См. Точечные запросы с высокой конкурентностью. - Удаление отдельных строк по идентификатору пользователя в соответствии с GDPR, включая логическое удаление через
__DORIS_DELETE_SIGN__при любом способе загрузки. - Сборка широких таблиц, при которой каждая исходная система отвечает за группу столбцов и записывает только свои столбцы через Stream Load с
partial_columns: true. См. Частичное обновление столбцов.
Неподходящие сценарии
- Потоки событий, в которые данные только добавляются (логи, потоки кликов, показания IoT). Вы несёте затраты на поиск в индексе ключа при каждой записи ради возможности, которой не пользуетесь. Выберите модель Duplicate Key. См. Модель данных.
- Циклы с частым выполнением однострочных операций
UPDATE. Каждый оператор выполняется в отдельной транзакции, и основную часть затрат составляет фиксация. Загружайте данные пакетами через Stream Load сpartial_columns: trueили используйте Group Commit. - Случайные или очень широкие первичные ключи (UUIDs, длинные составные ключи). Каждый пакет загрузки обращается к индексу первичного ключа, а случайные ключи нарушают локальность обращений к кешу. Предпочитайте целые числа, делайте ключ узким и используйте минимальный подходящий тип. Типы float и double, а также сложные типы, такие как
ARRAY,MAP,STRUCT,JSONиVARIANT, вообще не допускаются в качестве ключевых столбцов. - Использование ключа партиционирования как надмножества первичного ключа. Столбцы партиционирования должны быть подмножеством уникального ключа, а не наоборот. Иначе один и тот же ключ может попасть в две партиции, и дедупликация перестанет работать.
- Нагрузки с большим числом
count(*)при использовании MoR. MoR восстанавливает версии во время выполнения запроса, поэтому подсчёт строк обходится дорого. Либо включите Merge-on-Write (по умолчанию с версии 2.1), либо, если данные действительно только добавляются, перейдите на Duplicate.
Дополнительные материалы
- Модель Unique Key: подробное описание синтаксиса SQL, различий между Merge-on-Write и Merge-on-Read, правил партиционирования и свойств создания таблицы.
- Обновление и удаление данных: возможности SQL (
UPDATE,DELETE, upsert с частичным обновлением столбцов, атомарная замена партиций) и внутренние механизмы Merge-on-Write, которые обеспечивают их работу. - Модель данных: сравнение Unique Key с Duplicate и Aggregate и подходящие нагрузки для каждой модели.
- Управление конкурентными обновлениями с помощью столбца последовательности: допустимые типы, обработка NULL и разрешение записей, поступающих не по порядку.
- Точечные запросы с высокой конкурентностью: план short-circuit, который превращает таблицу Unique Key в KV-хранилище.
- Apache Doris 2.1.0: Merge-on-Write становится режимом по умолчанию для Unique Key