Векторизованное выполнение
Кратко Каждый запрос Apache Doris выполняется на векторизованном движке. Операторы передают данные в объектах
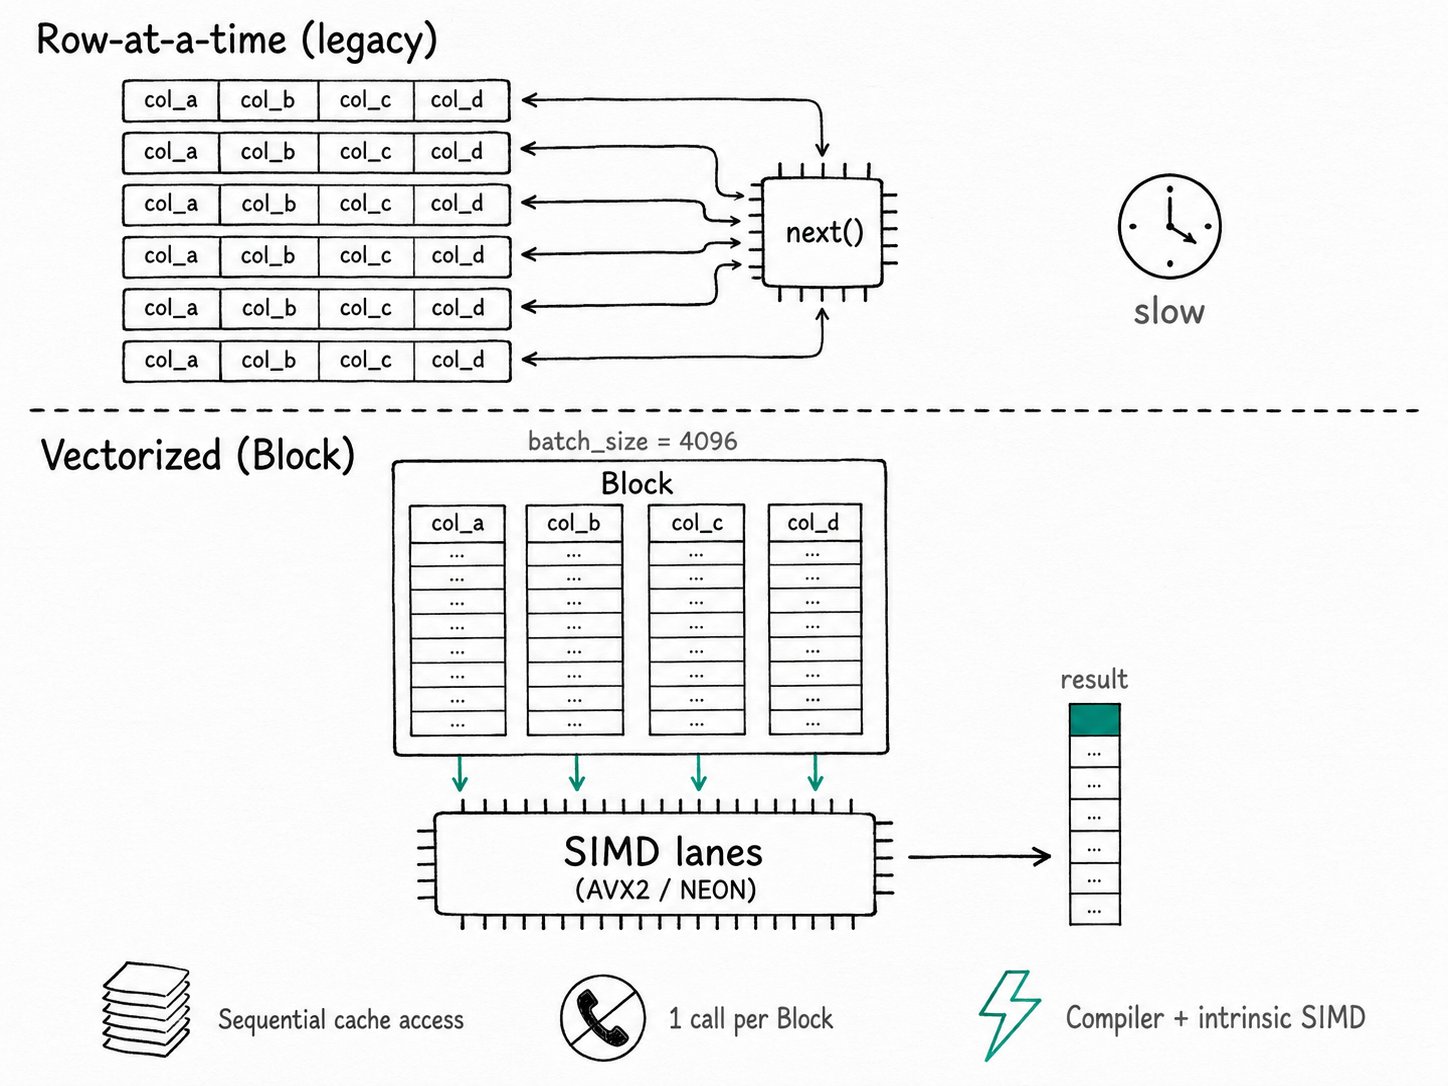
Block, содержащих до 4,096 строк в столбцовом представлении, а компактные внутренние циклы позволяют использовать SIMD благодаря компилятору и написанным вручную интринсикам. Построчный движок был полностью удалён в v2.0, поэтому включать ничего не нужно; единственный параметр, с которым столкнётся большинство пользователей, —batch_size.
Зачем использовать векторизованное выполнение в Apache Doris?
Векторизованное выполнение в Apache Doris заменяет виртуальные вызовы для каждой строки внутренними циклами пакетной обработки столбцов, чтобы CPU тратил время на арифметику, а не на косвенные обращения. Классический исполнитель в стиле Volcano вызывает next() для каждой строки, проходя по дереву виртуальных вызовов функций, чтобы получить один кортеж. На современном CPU сами арифметические операции занимают ничтожное время по сравнению с диспетчеризацией, ошибками предсказания переходов и промахами кеша. Построчная агрегация миллиарда строк превращает быструю машину в медленную.
- Один виртуальный вызов для каждой строки в каждом операторе в итоге превращается в миллионы косвенных переходов, с которыми предсказатель переходов не справляется.
- Разбросанное расположение строк в памяти оставляет в кешах CPU L1/L2 мало полезных данных.
- Компактные числовые циклы не поддаются автоматической векторизации, когда данные чередуются между строками.
Векторизованное выполнение меняет организацию внутреннего цикла. Оператор получает пакет значений столбцов, обрабатывает его простым циклом, и в результате горячий путь выглядит именно так, как предполагает AVX2.
Что такое векторизованное выполнение в Apache Doris?
Векторизованное выполнение в Apache Doris реализовано в виде движка запросов с пакетной обработкой столбцов: метод get_block() каждого оператора принимает один Block и возвращает другой, а Block представляет собой небольшой набор массивов столбцов, содержащий от 1 до batch_size строк. Интринсики SIMD ускоряют операции, которым это приносит наибольшую пользу: отбор строк по фильтру, десятичную арифметику, сравнение строк, разбор JSON. Эта модель восходит к MonetDB/X100 и Vectorwise. ClickHouse, StarRocks и DuckDB используют тот же подход.
Основные термины
Block: единица данных, передаваемая между операторами. Содержит типизированные массивы столбцов и метаданные столбцов. Реализована вbe/src/vec/core/block.h.Column: один типизированный массив внутри Block. Среди специализированных реализаций —ColumnVector,ColumnString,ColumnDecimal,ColumnNullableиColumnDictionary; каждая оптимизирована под структуру своих данных.batch_size: максимальное число строк в Block. По умолчанию 4,096, настраивается для каждого сеанса. Более крупные пакеты снижают удельные накладные расходы на вызовы; более мелкие уменьшают потребление памяти и задержки в хвосте распределения.- Путь SIMD: написанный вручную код в
be/src/util/simd/и циклы, автоматически векторизованные компилятором, с выбором AVX2 на x86 или NEON на ARM во время выполнения.
Как работает векторизованное выполнение в Apache Doris?
Векторизованное выполнение в Apache Doris объединяет операторы в цепочки, по которым передаются столбцовые объекты Block размером до 4,096 строк. Столбцы обрабатываются поочерёдно простыми циклами с использованием SIMD там, где это выгодно, а планировщик Pipeline чередует обработку этих пакетов на разных ядрах.
- От плана к цепочке операторов. Оптимизатор создаёт план, FE преобразует его в конвейер операторов, и каждый оператор реализует
get_block(state, block, eos). - Получение пакета. Оператор сканирования считывает до
batch_sizeстрок из столбцового хранилища планшета, заполняет Block на месте и возвращает его. Строки никогда не материализуются в структуры. - Обработка по столбцам. Операторы фильтрации, проекции, агрегации и соединения обходят каждый столбец простым циклом. Там, где это выгодно, цикл вызывает примитивы SIMD, например
bytes32_mask_to_bits32_maskдля сжатия фильтра или векторизованного сравнения десятичных чисел. - Передача дальше по конвейеру. Block перемещается по конвейеру как значение, а планировщик Pipeline чередует на разных ядрах этапы, ограниченные вычислениями CPU и операциями ввода-вывода. Несколько задач конвейера параллельно обрабатывают разные объекты Block.
- Возврат результата клиенту. Последний оператор сериализует итоговые объекты Block в сетевой протокол MySQL, после чего выполнение запроса завершается.
Движок Pipeline, появившийся в v2.0, построен поверх этой основы. Векторизация определяет, что оператор делает с пакетом; Pipeline определяет, как обработка этих пакетов распределяется между ядрами. Это разные уровни, которые часто путают.
Быстрый старт
Включать векторизованное выполнение не нужно: это единственный режим выполнения. Стоит знать лишь один параметр — batch_size.
-- Default; safe to leave alone for most workloads
SHOW VARIABLES LIKE 'batch_size';

-- Larger batches: better throughput on big aggregations, more memory per fragment
SET batch_size = 8192;

SELECT user_id, COUNT(*) AS events, SUM(bytes) AS total_bytes
FROM access_log
WHERE ts BETWEEN '2026-05-01' AND '2026-05-08'
GROUP BY user_id
ORDER BY total_bytes DESC
LIMIT 10;
Ожидаемый результат
+---------+--------+-------------+
| user_id | events | total_bytes |
+---------+--------+-------------+
|   42718 |  18374 |   924518127 |
|     ...                        |
+---------+--------+-------------+
Агрегация выполняется поочерёдно по столбцам в объектах Block из 8,192 строк. При сканировании широкой таблицы с миллионами подходящих строк более крупный пакет немного увеличивает потребление памяти BE, но сокращает число обращений к планировщику. Это обычно ускоряет длительные сканирования и замедляет небольшие точечные запросы.
Когда следует использовать векторизованное выполнение в Apache Doris?
Векторизованное выполнение в Apache Doris — единственный режим выполнения начиная с v2.0, поэтому на практике вопрос сводится к тому, когда стоит настраивать batch_size или использовать совершенно другой путь выполнения запроса.
Хорошо подходит
- Любые нагрузки, с которыми Doris уже работает. Агрегации с интенсивным сканированием, GROUP BY, хеш-соединения и сортировки выполняются на этом движке. «Невекторизованного» варианта для сравнения нет.
- Аналитика по широким таблицам и запросы дашбордов. Именно здесь циклы обработки отдельных столбцов и фильтры SIMD работают наиболее эффективно.
- Нагрузки на машинах с AVX2 или NEON. В контрольном списке установки Doris рекомендуются CPU x86 с поддержкой AVX2; NEON — стандартный путь для ARM. Более старые CPU также работают, но вместо путей с ускорением SIMD используется скалярный код.
Плохо подходит
- Поиск одной строки по первичному ключу с частотой в тысячи QPS. Затраты на подготовку каждого Block снижают эффективность, когда он содержит всего одну строку. Используйте путь точечных запросов с высокой конкурентностью.
- Настройка
batch_sizeдля нерегулярных запросов. Значение по умолчанию 4,096 выбрано не случайно, и его изменение обычно либо ничего не даёт, либо немного ухудшает результат. Меняйте его только тогда, когда профилирование показывает, что накладные расходы на обработку каждого пакета преобладают, или когда фрагментам не хватает памяти. - Следование старым рекомендациям, в которых упоминается
enable_vectorized_engine. Эта переменная сеанса перестала влиять на поведение в v1.2.1, а лежавший в её основе построчный код был удалён в v2.0. Если документ или статья в блоге предлагает её переключить, этот материал устарел. - Смешение этой возможности с векторным поиском. «Векторизованное выполнение» — это модель движка запросов. Векторный поиск на основе ANN относится к отдельному семейству индексов, описанному в
docs/ai/vector-search/.
Производительность
- Ускорение в 3–5 раз по сравнению с предыдущей версией, когда в v1.1 векторизованное выполнение стало режимом по умолчанию для всех запросов. Источник: примечания к выпуску Apache Doris 1.1.0.
- Ускорение агрегаций по широким таблицам в 5–10 раз благодаря сочетанию столбцового размещения данных в памяти и ускорения SIMD. Источник: концепции продукта Doris.
Дополнительные материалы
- Концепции продукта: векторизованный движок выполнения
- Движок выполнения Pipeline
- Обзор архитектуры системы
- Столбцовое хранение: дисковый формат, страницы и кодировки которого напрямую поступают в векторизованные столбцы.
- Оптимизация чтения Parquet: как декодированные данные внешнего формата Parquet поступают прямо в векторизованный движок без промежуточного преобразования в Arrow и обратно.
- Примечания к выпуску Apache Doris 2.0 (построчный движок удалён)
- Архитектура MPP: уровень, который планирует выполнение векторизованных операторов между BE, а не только внутри одного BE.