Вертикальная компактация
Кратко Вертикальная компактация Apache Doris разбивает схему широкой таблицы на небольшие группы столбцов и объединяет по одной группе за раз. При классической построчной компактации все столбцы находятся в памяти одновременно. Алгоритм сокращает потребление памяти при компактации примерно до 1/10 и работает примерно на 15% быстрее на широких таблицах. Чтобы результат оставался идентичным, для каждой строки используется маркер последовательности, сформированный на основе ключевых столбцов. Вертикальная компактация включена по умолчанию начиная с Apache Doris 1.2.2.
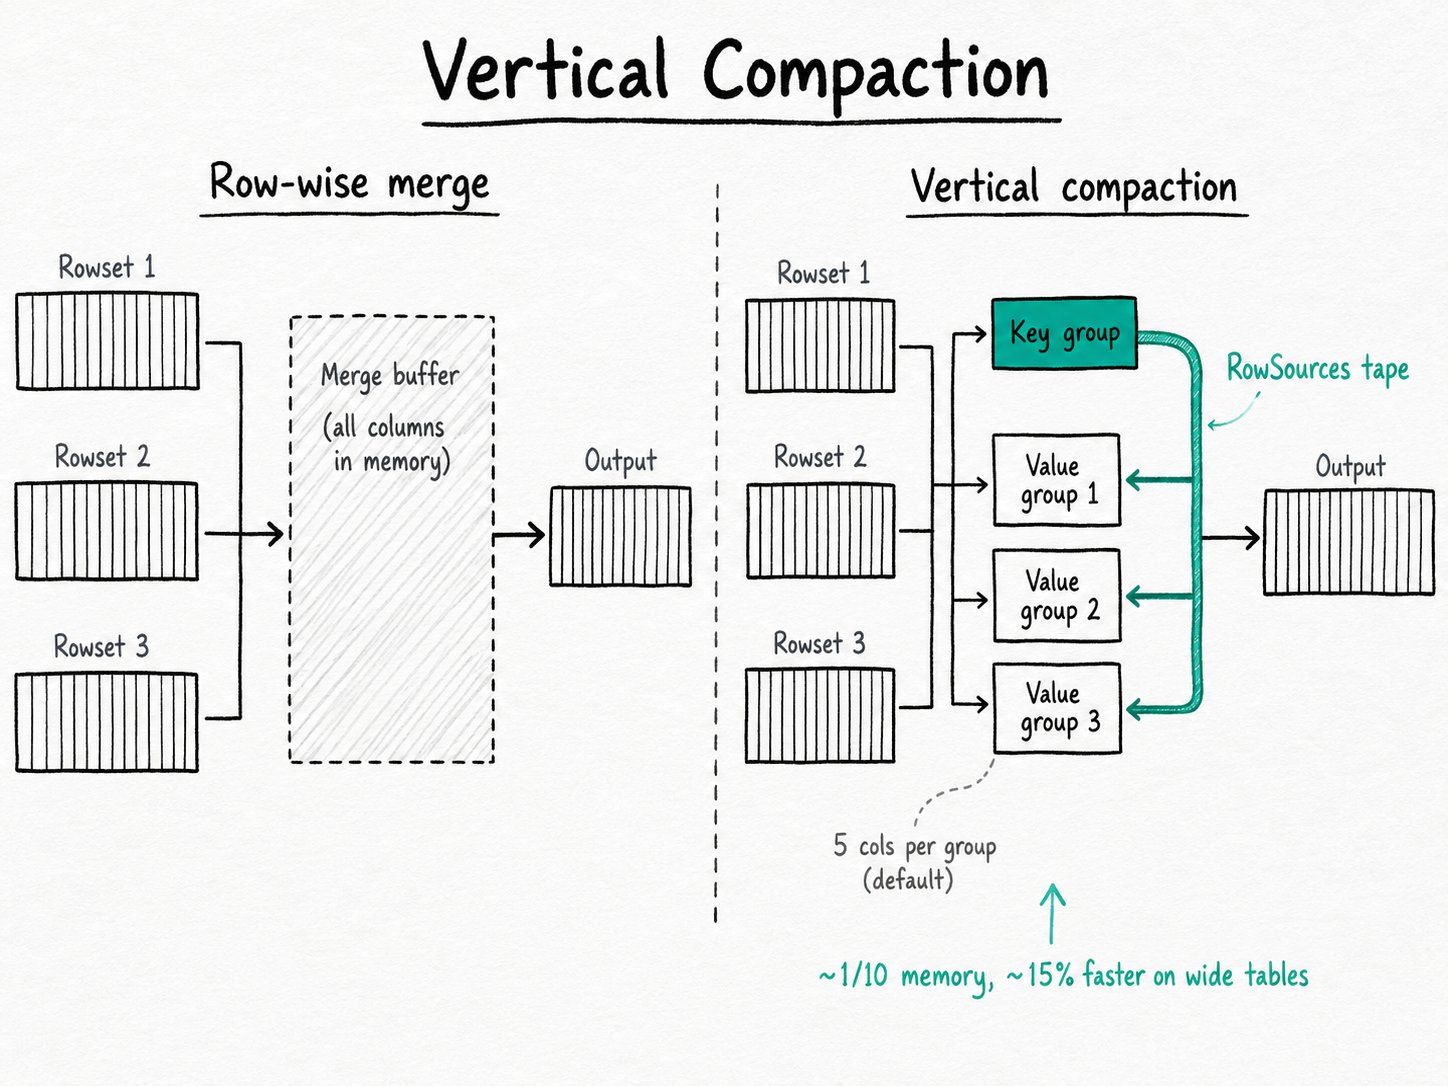
Зачем использовать вертикальную компактацию в Apache Doris?
Вертикальная компактация ограничивает потребление памяти при компактации широких таблиц в Apache Doris. При построчном слиянии все столбцы таких таблиц загружались бы в память одновременно, что приводило бы к OOM на BE. Сама компактация представляет собой фоновую задачу, которая объединяет rowset одного tablet в меньшее число более крупных rowset, чтобы при выполнении запросов не приходилось обходить сотни версий. Классический алгоритм считывает по одной строке из каждого входного rowset, выбирает итоговую строку, записывает её и повторяет процесс. Это хорошо работает для таблицы фактов с 5 столбцами. Для таблицы пользователей с 200 столбцами алгоритм уже не справляется, особенно если эти столбцы содержат объёмные данные VARIANT JSON:
- Блок слияния должен хранить все столбцы всех строк пакета. Потребление памяти растёт одновременно с числом столбцов и размером пакета.
- Backend (BE) выполняет множество задач компактации параллельно. Даже нескольких задач для широких таблиц может хватить, чтобы на узле возник OOM.
- Администраторы ограничивают пул потоков компактации, чтобы контролировать потребление памяти. В результате rowset накапливаются, и загрузки начинают завершаться с ошибкой -235, когда число версий tablet превышает
max_tablet_version_num.
Вертикальная компактация решает эту проблему. Она меняет единицу слияния с «одной строки по всем столбцам» на «одну группу столбцов по всем строкам за раз». Для этого требуется одна дополнительная структура: маркер последовательности для каждой строки.
Что такое вертикальная компактация Apache Doris?
Вертикальная компактация Apache Doris представляет собой алгоритм компактации, который объединяет столбцы группами вместо слияния строк. Backend разбивает схему таблицы на группу ключевых столбцов и несколько групп столбцов значений (по умолчанию по 5 столбцов в группе). Сначала он объединяет ключевую группу, чтобы задать единый порядок строк, затем объединяет каждую группу значений, воспроизводя этот порядок. Выходной rowset совпадает с результатом построчной компактации; меняется только характер потребления памяти.
Основные термины
Column group: фрагмент схемы фиксированного размера. По умолчанию в группе 5 столбцов; это значение настраивается отдельно для каждой таблицы.Key group: первая группа, сформированная из ключевых столбцов таблицы. Слияние этой группы определяет порядок строк в результате.RowSourcesBuffer: буфер с поддержкой хранения на диске, который для каждой выходной строки записывает, из какого входного rowset и какой его строки она получена. По умолчанию ограничен 1 GB.Vertical merge iterator: компонент BE, который сканирует одну группу столбцов во всех входных rowset и выдаёт объединённый столбец.enable_vertical_compaction: флаг конфигурации BE, по умолчанию равныйtrue. При его отключении используется построчная компактация.
Как работает вертикальная компактация Apache Doris?
Вертикальная компактация Apache Doris разбивает схему на группы столбцов, сначала объединяет ключевую группу, чтобы задать порядок строк, а затем воспроизводит этот порядок для каждой группы значений. Благодаря этому столбцы вне обрабатываемой группы не занимают память. Описанный ниже процесс состоит из пяти этапов: разбиение, слияние, воспроизведение порядка, сборка и сброс на диск.
- Разбить схему на группы. BE обходит схему tablet, помещает ключевые столбцы в группу 0 и разбивает оставшиеся столбцы на группы по
vertical_compaction_num_columns_per_groupстолбцов (по умолчанию 5). Когда включёнenable_vertical_compact_variant_subcolumns, BE использует тот же процесс и для подстолбцов VARIANT. - Объединить ключевую группу и записать порядок. Merger выполняет сортировку ключевых столбцов с помощью кучи по всем входным rowset. При извлечении каждой строки из кучи он добавляет в RowSourcesBuffer запись об источнике этой строки. Результат этого прохода: отсортированный ключевой столбец и единая лента RowSources.
- Воспроизвести ленту для каждой группы значений. Для каждой группы значений BE открывает те же входные rowset, но считывает только столбцы этой группы. Для выбора следующего источника он использует ленту RowSources вместо кучи. Сравнения не нужны, а столбцы вне группы не занимают память.
- Собрать группы в один rowset. Компонент записи результата собирает группы в единый файл сегмента. Результат побайтово совпадает с результатом построчной компактации, включая обновления delete-bitmap и inverted-index.
- Сбросить ленту на диск, если она разрастается. Размер RowSourcesBuffer ограничен параметром
vertical_compaction_max_row_source_memory_mb(1 GB). Если в результате слияния получается больше строк, чем позволяет лимит, буфер сбрасывается в каталог tablet и считывается потоком на этапе 3.
Есть один компромисс: вертикальная компактация считывает каждый входной rowset по одному разу для каждой группы, а не один раз за весь процесс. На кластерах, ограниченных производительностью дисков, затраты на IO возрастают примерно на (num_groups - 1). Экономия памяти обычно перевешивает эти затраты, поэтому алгоритм включён по умолчанию. На узких таблицах (5 столбцов или меньше) схема в любом случае образует ровно одну группу, и алгоритм сводится к построчному слиянию.
Быстрый старт
Вертикальная компактация включена по умолчанию. В примере ниже показана настройка для отдельной таблицы, которая определяет размер групп столбцов широкой таблицы:
CREATE TABLE user_profile (
  user_id BIGINT,
  name VARCHAR(64), age INT, country VARCHAR(32), city VARCHAR(64),
  attr_01 STRING, attr_02 STRING, attr_03 STRING, attr_04 STRING,
  attr_05 STRING, attr_06 STRING, attr_07 STRING, attr_08 STRING
)
DUPLICATE KEY(user_id)
DISTRIBUTED BY HASH(user_id) BUCKETS 4
PROPERTIES (
  "vertical_compaction_num_columns_per_group" = "3"
);

SHOW CREATE TABLE user_profile;
Ожидаемый результат
+--------------+--------------------------------------------------+
| Table        | Create Table                                     |
+--------------+--------------------------------------------------+
| user_profile | ... "vertical_compaction_num_columns_per_group" |
|              |     = "3" ...                                    |
+--------------+--------------------------------------------------+
Размер группы 3 немного увеличивает затраты на IO, но позволяет строже ограничить потребление памяти. Это полезно для таблиц с большим числом объёмных столбцов STRING или JSONB. Проверьте, что настройка применилась, с помощью SHOW CREATE TABLE. Чтобы вернуться к значениям по умолчанию, удалите свойство с помощью ALTER TABLE.
Когда следует использовать вертикальную компактацию Apache Doris?
Используйте вертикальную компактацию Apache Doris для широких схем, для tablet, на которых построчная компактация приводит к OOM, и для таблиц с разреженными подстолбцами VARIANT. Дополнительная настройка не нужна для узких таблиц и для кластеров, ограниченных производительностью дисков, где дополнительные проходы чтения обходятся дороже, чем выигрыш от экономии памяти.
Подходит
- Широкие схемы: десятки столбцов и более, особенно если большинство столбцов имеют переменную длину (
STRING,JSONB,ARRAY,MAP). Чем шире схема, тем больше выигрыш. - Tablet, на которых построчный алгоритм компактации приводит к OOM. Уменьшите размер группы с 5 до 2 или 3 вместо ограничения пула потоков.
- Таблицы с разреженными подстолбцами
VARIANT. Тот же путь выполнения используется дляenable_vertical_compact_variant_subcolumns, что позволяет не материализовывать отсутствующие подстолбцы во время слияния. - Медленная базовая компактация широких таблиц. Меньший рабочий набор данных каждой группы позволяет выполнять слияние в кэше CPU.
Не подходит
- Узкие таблицы (от одного до пяти столбцов). Схема образует единственную группу столбцов, и дополнительные операции учёта источников строк не приносят пользы. Это безвредно, но бессмысленно.
- Tablet со столбцом sequence-map. В этом случае текущая реализация пропускает вертикальную компактацию (см.
_tablet->tablet_schema()->has_seq_map()вcompaction.cpp); слияние автоматически выполняется построчно. - Кластеры, ограниченные производительностью дисков, где IO компактации уже составляет основную нагрузку. Дополнительные проходы чтения для каждой группы могут усугубить проблему. Либо увеличьте размер групп (повысьте
vertical_compaction_num_columns_per_group), либо сначала устраните ограничение IO. - Попытки решить проблему слишком частых загрузок с помощью вертикальной компактации. Нехватка памяти во время компактации часто является следствием накопления rowset, а не первопричиной. Способы оптимизации загрузки описаны в разделах Компактация данных и Group Commit.
Производительность / показатели
- Потребление памяти: примерно 1/10 от потребления при построчной компактации широких таблиц. Источник: документация по настройке компактации Doris.
- Пропускная способность: весь процесс примерно на 15% быстрее в том же тесте на широкой таблице. Источник: тот же.
- Доступна начиная с Doris 1.2.2; значение по умолчанию в текущих версиях:
true.
Дополнительные материалы
- Компактация данных: как кумулятивная, базовая и временная политики работают поверх вертикальной компактации.
- Настройка компактации: вертикальная, сегментная, однорепличная, для временных рядов: параметры администрирования для каждого варианта компактации.
- Принципы, типы и планирование компактации: логика оценки и планирования, которая определяет, какие tablet будут обработаны следующими.
- Справочник конфигурации BE: все флаги
vertical_compaction_*с их значениями по умолчанию и единицами измерения. - Разбираемся в компактации данных за 3 минуты (блог): исходная статья, которая знакомит с вертикальной компактацией с помощью схем.
- Unique Key: модель таблицы, которая создаёт для каждого rowset битовые карты удаления, требующие согласования при вертикальной компактации.