Группа рабочих нагрузок (Workload Group)
Кратко Workload Group в Apache Doris разделяет один кластер на именованные группы, каждая из которых получает собственную долю CPU, верхний предел потребления памяти, ограничение числа одновременно выполняемых запросов и лимит IO. Тяжёлые задачи ETL выполняются в одной группе, панели мониторинга работают в другой, а аналитики с разовыми запросами используют третью. Вышедший из-под контроля запрос в одной группе больше не нарушает работу остальных. За изоляцию CPU отвечают Linux cgroups, а за память, IO и число одновременно выполняемых запросов отвечает процесс BE.
Зачем использовать Workload Group в Apache Doris?
Workload Group в Apache Doris не позволяет разным рабочим нагрузкам лишать друг друга ресурсов в общем кластере. Производственный кластер Doris почти никогда не обслуживает только один вид нагрузки. Обычный день выглядит так: в 2 часа ночи конвейер ETL перезаписывает вчерашние партиции, в 9 утра финансовый отдел повторно запускает ежедневный отчёт, в рабочее время панель руководителя каждые пятнадцать секунд выполняет один и тот же GROUP BY region, а аналитик запускает SELECT *, потому что забыл условие WHERE.
Без управления ресурсами эти четыре нагрузки используют один общий пул. Задание ETL выполняется в тех же потоках, которые обслуживают панель мониторинга. Неудачный разовый запрос заполняет память BE и приводит к принудительной отмене запроса отчёта. Число одновременно выполняемых запросов не ограничено, поэтому внезапный всплеск обновлений панелей накладывается на нагрузку ETL и замедляет работу всех пользователей.
Workload Group решает эту проблему без дополнительного оборудования. Вы создаёте отдельную группу для каждого класса нагрузок, задаёте допустимые ограничения и привязываете пользователей к нужным группам. Кластер продолжает работать на том же наборе BE, но планировщики BE, механизм отслеживания памяти и контроллеры cgroup теперь распределяют ресурсы по заданным вами границам.
Что такое Workload Group в Apache Doris?
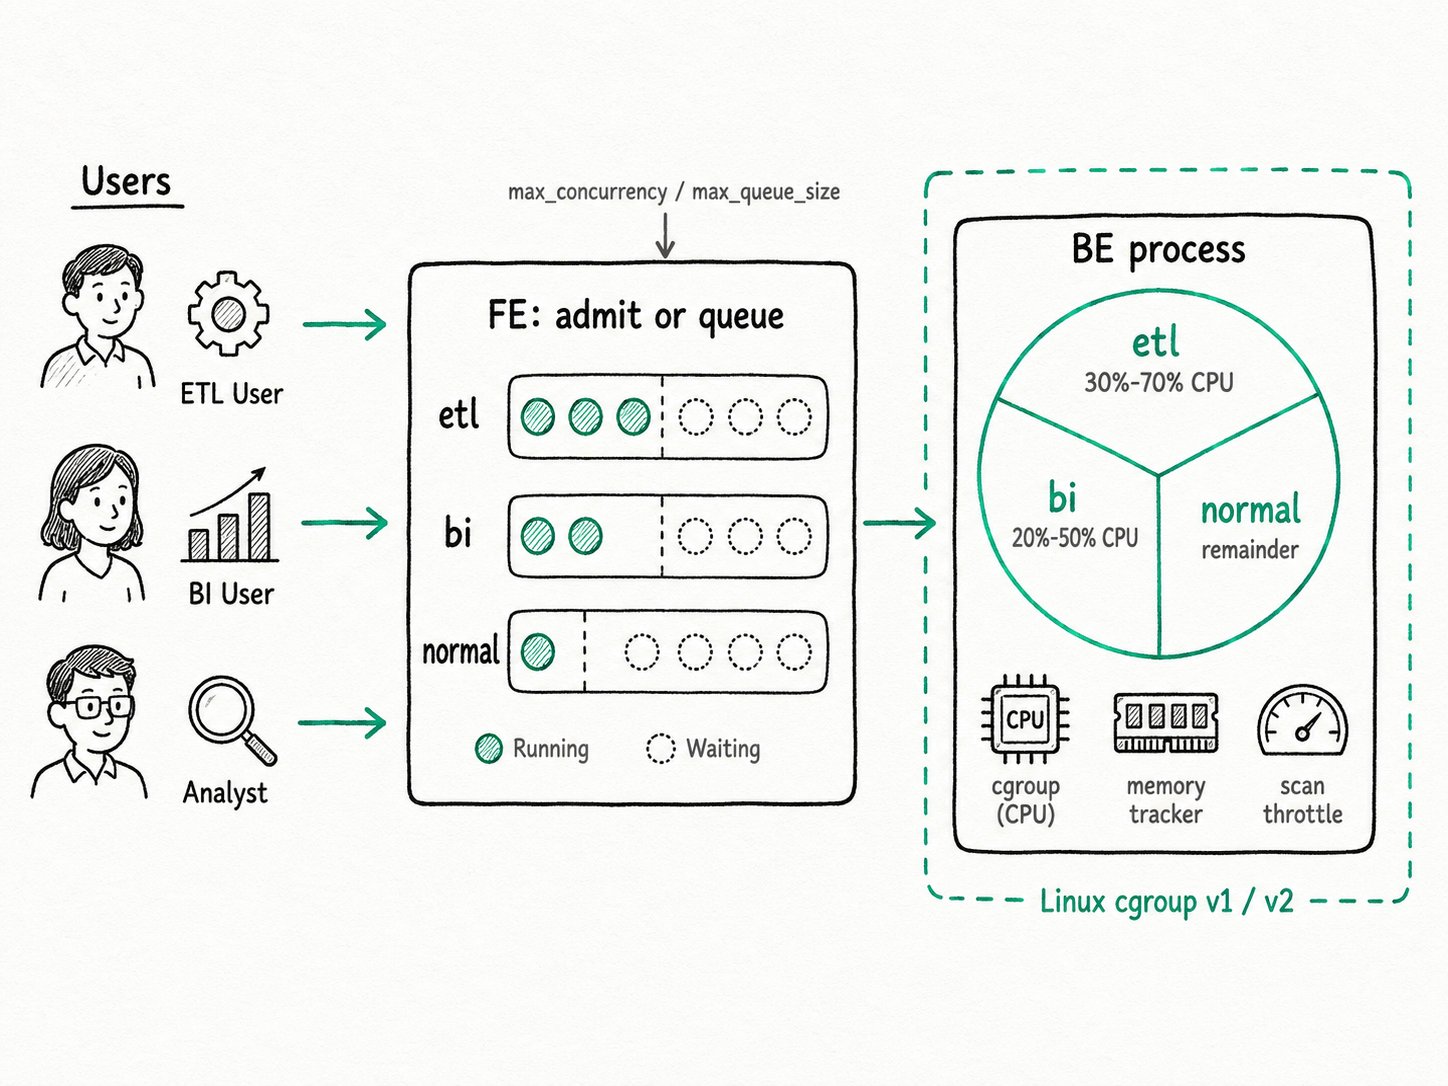
Workload Group в Apache Doris обеспечивает изоляцию внутри процесса: каждый процесс BE обслуживает все группы, но знает, какие потоки, слоты сканирования и выделенная память принадлежат каждой из них. Для изоляции CPU рабочие потоки BE помещаются в отдельные cgroups для каждой группы. Для изоляции памяти механизм отслеживания памяти BE учитывает потребление каждой группы и запускает сброс на диск или отмену запросов, когда группа превышает свой предел. Управление числом одновременно выполняемых запросов находится на FE: у каждой группы есть очередь, а запросы сверх лимита ожидают или сразу отклоняются.
Основные термины
min_cpu_percent/max_cpu_percent: доля процессорного времени, зарезервированная для группы (мягкая нижняя граница), и предел, который она не может превысить (жёсткая верхняя граница). Суммаmin_cpu_percentпо всем группам должна оставаться ниже 100%.min_memory_percent/max_memory_percent: гарантированная группе доля памяти BE и доля, до которой её потребление может вырасти, прежде чем запросы начнут сбрасывать данные на диск или будут принудительно отменены.max_concurrency/max_queue_size/queue_timeout: ограничение числа выполняемых запросов, размер очереди ожидания и допустимое время ожидания запроса в очереди. Все три параметра действуют отдельно на каждом FE, а не на уровне всего кластера.read_bytes_per_second/remote_read_bytes_per_second: ограничения IO для каждой группы, применяемые отдельно к каждому каталогу данных для локальных таблиц и к каждому BE для внешних источников.- Группа
normal: группа по умолчанию, автоматически создаваемая при первом запуске. Она используется для всех сеансов, не привязанных к другой группе. Удалить её нельзя.
Как работает Workload Group в Apache Doris?
Workload Group в Apache Doris определяет целевую группу на FE, допускает запрос к выполнению или ставит его в очередь, а затем обеспечивает соблюдение ограничений CPU, памяти и IO на BE.
- Определение группы (FE). FE выбирает группу в следующем порядке: явно заданная подсказка
/*+ SET_VAR(workload_group='...') */, переменная сеансаworkload_group, свойство пользователяdefault_workload_group, затемnormal. FE проверяет наличие права USAGE на выбранную группу. - Допуск к выполнению или постановка в очередь (FE). Очередь группы проверяет, сколько запросов этой группы уже выполняется на данном FE. Если их число ниже
max_concurrency, запрос получает слот и начинает выполняться. При превышении лимита он ожидает в очереди, размер которой ограничен параметромmax_queue_size, а время ожидания задаётся параметромqueue_timeout. Если очередь заполнена, запрос сразу отклоняется. - Привязка потоков к cgroup (BE). Каждый BE поддерживает отдельную cgroup для каждой группы по пути
/sys/fs/cgroup/doris/<wg_id>(cgroup v2) или/sys/fs/cgroup/cpu/doris/<wg_id>(v1). Когда запускается фрагмент запроса этой группы, его рабочие потоки присоединяются к соответствующей cgroup. Планировщик CFS ядра обеспечивает соблюдениеmin_cpu_percent(черезcpu.weight) иmax_cpu_percent(черезcpu.max). - Учёт памяти по группам (BE). Каждое выделение памяти помечается идентификатором группы. Когда учтённое потребление группы превышает
memory_low_watermark, операторы, поддерживающие сброс на диск, начинают сбрасывать данные. При превышенииmemory_high_watermarkBE приостанавливает запросы группы и может отменить запрос с наибольшим потреблением памяти, чтобы вернуть расход памяти ниже порога. - Ограничение сканирования (BE). Пулы потоков локального и удалённого сканирования имеют отдельные ограничения для каждой группы (
scan_thread_num,max_remote_scan_thread_num), аread_bytes_per_secondограничивает объём дискового IO, доступный сканированиям каждой группы. Этот параметр не позволяет полному сканированию таблицы без использования индекса занять всю пропускную способность SSD.
Быстрый старт
-- One group for ETL, one for BI dashboards
CREATE WORKLOAD GROUP etl PROPERTIES (
  'min_cpu_percent'='30','max_cpu_percent'='70',
  'min_memory_percent'='30','max_memory_percent'='70',
  'max_concurrency'='10');

CREATE WORKLOAD GROUP bi PROPERTIES (
  'min_cpu_percent'='20','max_cpu_percent'='50',
  'min_memory_percent'='20','max_memory_percent'='50',
  'max_concurrency'='50','max_queue_size'='100','queue_timeout'='3000');

-- Bind users persistently
SET PROPERTY FOR 'etl_user' 'default_workload_group'='etl';
SET PROPERTY FOR 'bi_user'  'default_workload_group'='bi';

-- One-off override for a single query
SELECT /*+ SET_VAR(workload_group='bi') */ region, SUM(revenue)
FROM orders WHERE dt = CURRENT_DATE() GROUP BY region;
Ожидаемый результат
+------+-------------------+-------------------+-----------------+
| name | running_query_num | waiting_query_num | max_concurrency |
+------+-------------------+-------------------+-----------------+
| etl  | 4                 | 0                 | 10              |
| bi   | 47                | 12                | 50              |
+------+-------------------+-------------------+-----------------+
SHOW WORKLOAD GROUPS (или SELECT ... FROM information_schema.workload_groups) показывает текущие значения счётчиков. Ожидающие 12 запросов в bi стоят в очереди за уже выполняющимися 47 запросами. Четыре запроса ETL гарантированно получают 30% CPU, даже когда BI создаёт высокую нагрузку, и не могут использовать более 70%.
Когда стоит использовать Workload Group в Apache Doris?
Используйте Workload Group в Apache Doris, когда один кластер обслуживает несколько классов нагрузок и вам нужно предсказуемое поведение под нагрузкой без покупки дополнительного оборудования.
Подходящие сценарии
- Кластеры со смешанной нагрузкой: ETL, отчёты по расписанию, панели мониторинга и разовые запросы аналитиков на общих BE.
- Развёртывания с несколькими арендаторами, где стоимость важнее полной изоляции: один кластер, несколько команд, предсказуемое поведение под нагрузкой.
- Ограничение известного источника проблем: привычка команды выполнять
SELECT *, дозагрузка исторических данных из Kafka, которая иногда превращается в поток чрезмерного объёма, и любые другие нагрузки, у которых нужно ограничить пики. - Совместное использование с группой вычислений (Compute Group) в режиме разделения хранения и вычислений. Compute Group предоставляет отдельный набор BE, а Workload Group распределяет ресурсы внутри него.
Неподходящие сценарии
- Вам нужна физическая изоляция: отдельные SLA, отдельные домены безопасности или арендаторы с раздельным выставлением счетов. Сбой BE или OOM на уровне ядра по-прежнему затрагивает все группы в одном процессе. Используйте группу ресурсов (Resource Group) или выделенную Compute Group.
- Вы ожидаете, что число одновременно выполняемых запросов будет ограничено единым значением для всего кластера. При трёх FE параметр
max_concurrency=10допускает до 30 одновременно выполняемых запросов во всём кластере. Либо задайте соответствующий лимит для каждого FE, либо разместите перед кластером балансировщик нагрузки, который закрепляет пользователей за одним FE. - Вы запускаете BE в непривилегированных контейнерах Docker или Kubernetes. Для соблюдения ограничений CPU процессу BE нужен доступ на чтение и запись к дереву cgroup хоста. Без привилегированного режима (или Doris Operator) ограничения CPU не действуют, причём ошибка не сообщается. Ограничения памяти и числа одновременно выполняемых запросов продолжают работать, но самый полезный механизм управления становится недоступен.
- Вы включаете перерасход памяти (memory overcommit) и позволяете сумме
max_memory_percentдостигнуть 100%. Тогда не остаётся запаса для обработки превышений мягкого лимита, и при достижении глобального предела BE отменяет запросы с наибольшим потреблением памяти внутри групп. Оставляйте запас от 10 до 20%. - Ваши нагрузки настолько кратковременны и неравномерны, что автоматически масштабируемый вычислительный склад в стиле Snowflake обойдётся дешевле фиксированного объёма ресурсов. Workload Group распределяет фиксированный пул и не выделяет новые вычислительные ресурсы.
Дополнительные материалы
- Справочник по Workload Group: полная таблица свойств, порядок настройки cgroup и примечания по миграции в связи с переименованием свойств в 4.0.
- Обзор управления рабочими нагрузками: как сочетаются Workload Group, Resource Group и Compute Group и в каких случаях выбирать каждую из них.
- Управление числом одновременно выполняемых запросов и очередями: поведение очереди на каждом FE, административный параметр обхода ограничений
bypass_workload_groupи особенности работы очередей при нескольких FE. - Сброс на диск: что происходит при достижении группой порога
memory_low_watermarkи как работают политики управления памятью на основе слотов. information_schema.workload_groups: системная таблица с текущим состоянием групп, используемая в примере выше.- Группа ресурсов (Resource Group): физическая изоляция узлов BE для более строгого соблюдения SLA.
- Группа вычислений (Compute Group): аналог для архитектуры с разделением вычислений и хранения, который добавляет изоляцию без копирования данных.
- Изоляция рабочих нагрузок нескольких арендаторов в Apache Doris: исходная статья о проектировании механизма с внутренними результатами тестирования мягких и жёстких ограничений CPU на BE с 16 ядрами.
- Архитектура MPP: модель выполнения, число экземпляров фрагментов которой Workload Group ограничивает для каждого запроса.