Использование Doris и Hudi
Новая открытая архитектура управления данными Data Lakehouse объединяет высокую производительность и возможности работы в реальном времени, свойственные хранилищам данных, с низкой стоимостью и гибкостью озёр данных. Это позволяет пользователям удобнее решать разнообразные задачи обработки и анализа данных. Такая архитектура всё шире применяется в корпоративных системах больших данных.
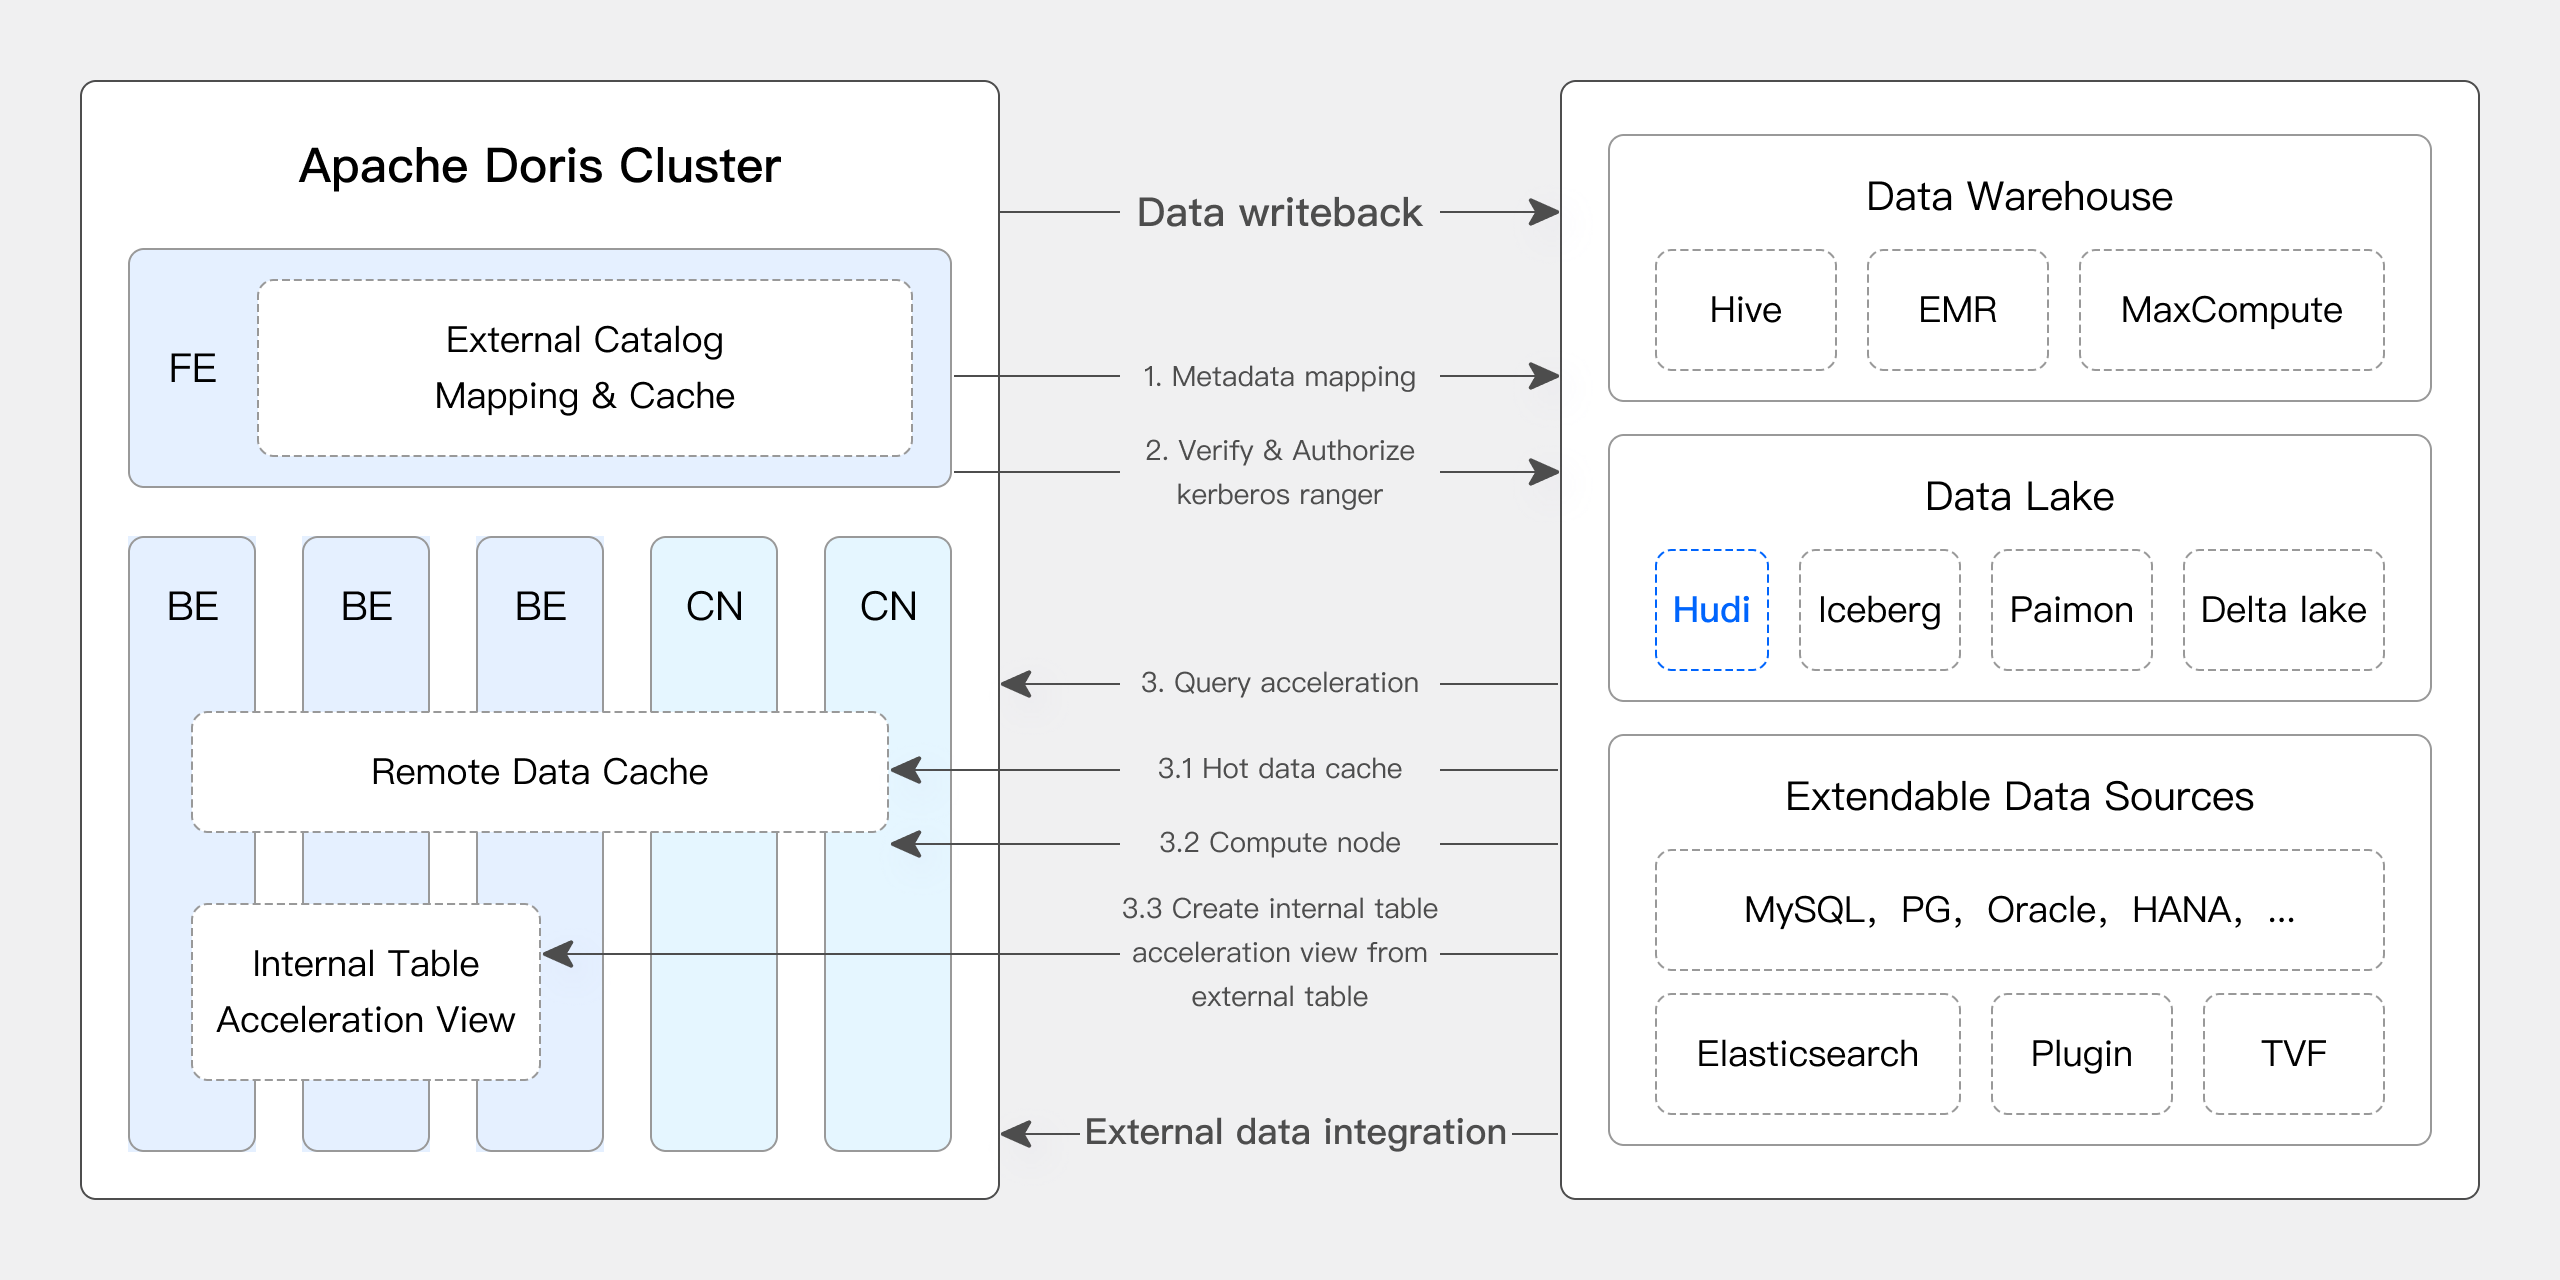
В последних версиях Apache Doris расширил интеграцию с озёрами данных и стал зрелым решением для построения Data Lakehouse.
- Начиная с версии 0.15, в Apache Doris появились внешние таблицы Hive и Iceberg, что позволило исследовать возможности совместного использования с Apache Iceberg для работы с озёрами данных.
- Начиная с версии 1.2, Apache Doris официально представил функцию Multi-Catalog, обеспечивающую автоматическое сопоставление метаданных и доступ к данным из различных источников, а также многочисленные оптимизации производительности чтения внешних данных и выполнения запросов. Теперь Doris обладает всеми возможностями для построения быстрой и удобной архитектуры Lakehouse.
- В версии 2.1 архитектура Data Lakehouse в Apache Doris была значительно улучшена: расширены возможности чтения и записи основных форматов озёр данных (Hudi, Iceberg, Paimon и др.), добавлены совместимость с несколькими диалектами SQL и возможность беспрепятственной миграции из существующих систем в Apache Doris. Для задач науки о данных и чтения больших объёмов данных в Doris интегрирован высокоскоростной интерфейс чтения Arrow Flight, благодаря чему эффективность передачи данных выросла в 100 раз.
Apache Doris и Hudi
Apache Hudi сегодня является одним из самых популярных открытых форматов озёр данных и платформой управления транзакционными озёрами данных. Он поддерживает различные распространённые движки запросов, включая Apache Doris.
Apache Doris также расширил возможности чтения таблиц данных Apache Hudi:
- Поддержка таблиц Copy on Write: Snapshot Query
- Поддержка таблиц Merge on Read: Snapshot Queries, Read Optimized Queries
- Поддержка Time Travel
- Поддержка Incremental Read
Высокая производительность выполнения запросов в Apache Doris в сочетании с возможностями Apache Hudi по управлению данными в реальном времени позволяет эффективно, гибко и с низкими затратами выполнять запросы и анализировать данные. Это сочетание также обеспечивает надёжные возможности отслеживания происхождения данных, аудита и инкрементальной обработки. Совместное использование Apache Doris и Apache Hudi уже проверено и внедрено несколькими пользователями сообщества в реальных бизнес-сценариях:
- Анализ и обработка данных в реальном времени: типичные сценарии, такие как обновление данных и выполнение аналитических запросов в реальном времени в финансовой сфере, рекламе и электронной коммерции, требуют обработки данных в реальном времени. Hudi обеспечивает обновление данных и управление ими в реальном времени, сохраняя их согласованность и надёжность. Doris эффективно обрабатывает запросы к большим объёмам данных в реальном времени. Вместе они позволяют успешно решать задачи анализа и обработки данных в реальном времени.
- Отслеживание происхождения данных и аудит: в отраслях с высокими требованиями к безопасности и точности данных, таких как финансы и здравоохранение, отслеживание происхождения данных и аудит имеют решающее значение. Hudi предоставляет функцию Time Travel для просмотра исторических состояний данных. В сочетании с эффективным выполнением запросов в Apache Doris это позволяет быстро анализировать данные на любой момент времени для точного отслеживания их происхождения и аудита.
- Инкрементальное чтение и анализ данных: при масштабном анализе данных часто возникают трудности из-за больших объёмов данных и частых обновлений. Hudi поддерживает инкрементальное чтение, позволяя пользователям обрабатывать только изменённые данные без полного обновления всего набора. Функция Incremental Read в Apache Doris дополнительно улучшает этот процесс, значительно повышая эффективность обработки и анализа данных.
- Федеративные запросы к разным источникам данных: во многих компаниях данные поступают из множества источников и хранятся в разных базах данных. Функция Multi-Catalog в Doris поддерживает автоматическое сопоставление и синхронизацию различных источников данных, позволяя выполнять федеративные запросы к ним. Это существенно сокращает путь передачи данных и повышает эффективность работы компаний, которым необходимо извлекать и объединять данные из нескольких источников для анализа.
В этой статье мы покажем, как быстро развернуть тестовую и демонстрационную среду Apache Doris + Apache Hudi в Docker, и рассмотрим различные операции, которые помогут быстро приступить к работе.
Дополнительные сведения см. в разделе Hudi Catalog
Руководство пользователя
Все скрипты и код, упомянутые в этой статье, доступны по адресу: https://github.com/apache/doris/tree/master/samples/datalake/hudi
01 Подготовка среды
В этой статье для развёртывания используется Docker Compose со следующими компонентами и версиями:
| Компонент | Версия |
|---|---|
| Apache Doris | По умолчанию 2.1.4, можно изменить |
| Apache Hudi | 0.14 |
| Apache Spark | 3.4.2 |
| Apache Hive | 2.1.3 |
| MinIO | 2022-05-26T05-48-41Z |
02 Развёртывание среды
-
Создайте сеть Docker
sudo docker network create -d bridge hudi-net -
Запустите все компоненты
sudo ./start-hudi-compose.shПримечание: перед запуском можно изменить значения
DORIS_PACKAGEиDORIS_DOWNLOAD_URLвstart-hudi-compose.sh, чтобы выбрать нужную версию Doris. Рекомендуется использовать версию 2.1.4 или выше. -
После запуска можно использовать следующий скрипт для входа в командную строку Spark или Doris:
-- Spark
sudo ./login-spark.sh

-- Doris
sudo ./login-doris.sh
03 Подготовка данных
Теперь создадим данные Hudi с помощью Spark. Как показано в коде ниже, в кластере уже есть таблица Hive с именем customer. На её основе можно создать таблицу Hudi:
-- ./login-spark.sh
spark-sql> use default;

-- create a COW table
spark-sql> CREATE TABLE customer_cow
USING hudi
TBLPROPERTIES (
  type = 'cow',
  primaryKey = 'c_custkey',
  preCombineField = 'c_name'
)
PARTITIONED BY (c_nationkey)
AS SELECT * FROM customer;

-- create a MOR table
spark-sql> CREATE TABLE customer_mor
USING hudi
TBLPROPERTIES (
  type = 'mor',
  primaryKey = 'c_custkey',
  preCombineField = 'c_name'
)
PARTITIONED BY (c_nationkey)
AS SELECT * FROM customer;
04 Запросы к данным
Как показано ниже, в кластере Doris уже создан Catalog с именем hudi (его можно просмотреть с помощью SHOW CATALOGS). Ниже приведён оператор создания этого Catalog:
-- Already created, no need to execute again
CREATE CATALOG `hudi` PROPERTIES (
    "type"="hms",
    'hive.metastore.uris' = 'thrift://hive-metastore:9083',
    "s3.access_key" = "minio",
    "s3.secret_key" = "minio123",
    "s3.endpoint" = "http://minio:9000",
    "s3.region" = "us-east-1",
    "use_path_style" = "true"
);
-
Вручную обновите этот Catalog, чтобы синхронизировать созданную таблицу Hudi:
-- ./login-doris.sh
doris> REFRESH CATALOG hudi; -
Операции с данными Hudi, выполняемые через Spark, сразу видны в Doris без необходимости обновлять Catalog. Вставим по строке данных в таблицы COW и MOR с помощью Spark:
spark-sql> insert into customer_cow values (100, "Customer#000000100", "jD2xZzi", "25-430-914-2194", 3471.59, "BUILDING", "cial ideas. final, furious requests", 25);
spark-sql> insert into customer_mor values (100, "Customer#000000100", "jD2xZzi", "25-430-914-2194", 3471.59, "BUILDING", "cial ideas. final, furious requests", 25); -
Через Doris можно напрямую запросить только что вставленные данные:
doris> use hudi.default;
doris> select * from customer_cow where c_custkey = 100;
doris> select * from customer_mor where c_custkey = 100; -
Вставьте с помощью Spark данные с уже существующим значением c_custkey=32, перезаписав тем самым существующие данные:
spark-sql> insert into customer_cow values (32, "Customer#000000032_update", "jD2xZzi", "25-430-914-2194", 3471.59, "BUILDING", "cial ideas. final, furious requests", 15);
spark-sql> insert into customer_mor values (32, "Customer#000000032_update", "jD2xZzi", "25-430-914-2194", 3471.59, "BUILDING", "cial ideas. final, furious requests", 15); -
С помощью Doris можно запросить обновлённые данные:
doris> select * from customer_cow where c_custkey = 32;
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
| c_custkey | c_name                    | c_address | c_phone         | c_acctbal | c_mktsegment | c_comment                           | c_nationkey |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
|        32 | Customer#000000032_update | jD2xZzi   | 25-430-914-2194 |   3471.59 | BUILDING     | cial ideas. final, furious requests |          15 |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
doris> select * from customer_mor where c_custkey = 32;
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
| c_custkey | c_name                    | c_address | c_phone         | c_acctbal | c_mktsegment | c_comment                           | c_nationkey |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
|        32 | Customer#000000032_update | jD2xZzi   | 25-430-914-2194 |   3471.59 | BUILDING     | cial ideas. final, furious requests |          15 |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
05 Incremental Read
Incremental Read — одна из функций Hudi. Она позволяет получать инкрементальные данные за указанный временной диапазон и выполнять их инкрементальную обработку. В данном примере Doris может запросить данные, изменённые после вставки c_custkey=100. Как показано ниже, мы вставили данные с c_custkey=32:
doris> select * from customer_cow@incr('beginTime'='20240603015018572');
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
| c_custkey | c_name                    | c_address | c_phone         | c_acctbal | c_mktsegment | c_comment                           | c_nationkey |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
|        32 | Customer#000000032_update | jD2xZzi   | 25-430-914-2194 |   3471.59 | BUILDING     | cial ideas. final, furious requests |          15 |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
spark-sql> select * from hudi_table_changes('customer_cow', 'latest_state', '20240603015018572');

doris> select * from customer_mor@incr('beginTime'='20240603015058442');
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
| c_custkey | c_name                    | c_address | c_phone         | c_acctbal | c_mktsegment | c_comment                           | c_nationkey |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
|        32 | Customer#000000032_update | jD2xZzi   | 25-430-914-2194 |   3471.59 | BUILDING     | cial ideas. final, furious requests |          15 |
+-----------+---------------------------+-----------+-----------------+-----------+--------------+-------------------------------------+-------------+
spark-sql> select * from hudi_table_changes('customer_mor', 'latest_state', '20240603015058442');
06 TimeTravel
Doris поддерживает запросы к определённым версиям снимков данных Hudi, обеспечивая тем самым функцию Time Travel. Сначала можно запросить историю коммитов двух таблиц Hudi с помощью Spark:
spark-sql> call show_commits(table => 'customer_cow', limit => 10);
20240603033556094        20240603033558249        commit        448833        0        1        1        183        0        0
20240603015444737        20240603015446588        commit        450238        0        1        1        202        1        0
20240603015018572        20240603015020503        commit        436692        1        0        1        1        0        0
20240603013858098        20240603013907467        commit        44902033        100        0        25        18751        0        0

spark-sql> call show_commits(table => 'customer_mor', limit => 10);
20240603033745977        20240603033748021        deltacommit        1240        0        1        1        0        0        0
20240603015451860        20240603015453539        deltacommit        1434        0        1        1        1        1        0
20240603015058442        20240603015100120        deltacommit        436691        1        0        1        1        0        0
20240603013918515        20240603013922961        deltacommit        44904040        100        0        25        18751        0        0
Затем с помощью Doris можно выполнить запрос с условием c_custkey=32, чтобы получить снимок данных до вставки. Как показано ниже, данные с c_custkey=32 ещё не обновлены:
Примечание: новый оптимизатор пока не поддерживает синтаксис Time Travel. Сначала необходимо выполнить
set enable_nereids_planner=false;, чтобы отключить новый оптимизатор. Эта проблема будет исправлена в будущих версиях.
doris> select * from customer_cow for time as of '20240603015018572' where c_custkey = 32 or c_custkey = 100;
+-----------+--------------------+---------------------------------------+-----------------+-----------+--------------+--------------------------------------------------+-------------+
| c_custkey | c_name             | c_address                             | c_phone         | c_acctbal | c_mktsegment | c_comment                                        | c_nationkey |
+-----------+--------------------+---------------------------------------+-----------------+-----------+--------------+--------------------------------------------------+-------------+
|        32 | Customer#000000032 | jD2xZzi UmId,DCtNBLXKj9q0Tlp2iQ6ZcO3J | 25-430-914-2194 |   3471.53 | BUILDING     | cial ideas. final, furious requests across the e |          15 |
|       100 | Customer#000000100 | jD2xZzi                               | 25-430-914-2194 |   3471.59 | BUILDING     | cial ideas. final, furious requests              |          25 |
+-----------+--------------------+---------------------------------------+-----------------+-----------+--------------+--------------------------------------------------+-------------+
-- compare with spark-sql
spark-sql> select * from customer_mor timestamp as of '20240603015018572' where c_custkey = 32 or c_custkey = 100;

doris> select * from customer_mor for time as of '20240603015058442' where c_custkey = 32 or c_custkey = 100;
+-----------+--------------------+---------------------------------------+-----------------+-----------+--------------+--------------------------------------------------+-------------+
| c_custkey | c_name             | c_address                             | c_phone         | c_acctbal | c_mktsegment | c_comment                                        | c_nationkey |
+-----------+--------------------+---------------------------------------+-----------------+-----------+--------------+--------------------------------------------------+-------------+
|       100 | Customer#000000100 | jD2xZzi                               | 25-430-914-2194 |   3471.59 | BUILDING     | cial ideas. final, furious requests              |          25 |
|        32 | Customer#000000032 | jD2xZzi UmId,DCtNBLXKj9q0Tlp2iQ6ZcO3J | 25-430-914-2194 |   3471.53 | BUILDING     | cial ideas. final, furious requests across the e |          15 |
+-----------+--------------------+---------------------------------------+-----------------+-----------+--------------+--------------------------------------------------+-------------+
spark-sql> select * from customer_mor timestamp as of '20240603015058442' where c_custkey = 32 or c_custkey = 100;
Оптимизация запросов
Данные в Apache Hudi можно условно разделить на две категории: базовые и инкрементальные. Базовые данные обычно представляют собой объединённые файлы Parquet, а инкрементальные данные содержат изменения, созданные операциями INSERT, UPDATE или DELETE. Базовые данные можно читать напрямую, а инкрементальные необходимо читать через Merge on Read.
При запросах к таблицам Hudi COW или выполнении запросов Read Optimized к таблицам MOR используются базовые данные. Их можно читать напрямую с помощью встроенного в Doris Parquet Reader, что обеспечивает быстрое выполнение запросов. Для чтения инкрементальных данных Doris необходимо обращаться к Java SDK Hudi через вызовы JNI. Чтобы обеспечить оптимальную производительность запросов, Apache Doris разделяет данные запроса на базовую и инкрементальную части и читает их описанными выше способами.
Чтобы проверить этот подход к оптимизации, воспользуемся оператором EXPLAIN и посмотрим, сколько базовых и инкрементальных данных содержится в приведённом ниже примере запроса. Для таблицы COW все 101 фрагмент данных относятся к базовым данным (hudiNativeReadSplits=101/101), поэтому всю таблицу COW можно прочитать напрямую с помощью Parquet Reader в Doris, обеспечив наилучшую производительность запроса. Для таблицы ROW большинство фрагментов содержат базовые данные (hudiNativeReadSplits=100/101), а один фрагмент содержит инкрементальные данные, что также обеспечивает хорошую производительность запроса.
-- COW table is read natively
doris> explain select * from customer_cow where c_custkey = 32;
|   0:VHUDI_SCAN_NODE(68)                                        |
|      table: customer_cow                                       |
|      predicates: (c_custkey[#5] = 32)                          |
|      inputSplitNum=101, totalFileSize=45338886, scanRanges=101 |
|      partition=26/26                                           |
|      cardinality=1, numNodes=1                                 |
|      pushdown agg=NONE                                         |
|      hudiNativeReadSplits=101/101                              |

-- MOR table: because only the base file contains `c_custkey = 32` that is updated, 100 splits are read natively, while the split with log file is read by JNI.
doris> explain select * from customer_mor where c_custkey = 32;
|   0:VHUDI_SCAN_NODE(68)                                        |
|      table: customer_mor                                       |
|      predicates: (c_custkey[#5] = 32)                          |
|      inputSplitNum=101, totalFileSize=45340731, scanRanges=101 |
|      partition=26/26                                           |
|      cardinality=1, numNodes=1                                 |
|      pushdown agg=NONE                                         |
|      hudiNativeReadSplits=100/101                              |
Чтобы подробнее проследить изменения базовых и инкрементальных данных Hudi, можно выполнить несколько операций удаления с помощью Spark:
-- Use delete statement to see more differences
spark-sql> delete from customer_cow where c_custkey = 64;
doris> explain select * from customer_cow where c_custkey = 64;

spark-sql> delete from customer_mor where c_custkey = 64;
doris> explain select * from customer_mor where c_custkey = 64;
Кроме того, можно дополнительно сократить объём читаемых данных, используя условия по разделам для их отсечения, и тем самым ускорить запрос. В примере ниже отсечение разделов выполняется по условию c_nationkey=15, благодаря чему запрос обращается к данным только одного раздела (partition=1/26).
-- customer_xxx is partitioned by c_nationkey, we can use the partition column to prune data
doris> explain select * from customer_mor where c_custkey = 64 and c_nationkey = 15;
|   0:VHUDI_SCAN_NODE(68)                                        |
|      table: customer_mor                                       |
|      predicates: (c_custkey[#5] = 64), (c_nationkey[#12] = 15) |
|      inputSplitNum=4, totalFileSize=1798186, scanRanges=4      |
|      partition=1/26                                            |
|      cardinality=1, numNodes=1                                 |
|      pushdown agg=NONE                                         |
|      hudiNativeReadSplits=3/4                                  |