Query Cache
Query Cache — это механизм конвейерного движка выполнения Apache Doris, который кеширует промежуточные результаты агрегации на уровне таблетов и ускоряет повторяющиеся запросы с агрегацией.
Что проверить перед началом работы
Перед использованием Query Cache убедитесь, что:
- Запрос обращается к внутренней таблице OLAP, а не к внешней таблице, например Hive/JDBC/Iceberg/Hudi/Paimon
- Запрос содержит агрегацию (
GROUP BYили агрегатные функции) - План запроса соответствует схеме
AggregationNode → OlapScanNode - Запрос не содержит узлов
JOIN,SORT,UNIONилиWINDOW - Запрос не зависит от недетерминированных функций, таких как
now(),rand()илиuuid() - Установлено
enable_query_cache = true
Определение в одном предложении
Query Cache кеширует результаты агрегации на уровне таблетов в конвейерном движке выполнения. Если контекст выполнения последующего запроса совпадает, механизм возвращает кешированные данные напрямую, исключая повторное сканирование и вычисления.
Зачем нужен Query Cache
В аналитических сценариях один и тот же запрос с агрегацией часто выполняется многократно, хотя исходные данные не меняются. Например:
SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-01' GROUP BY region;
SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-01' GROUP BY region;
При каждом выполнении одни и те же таблеты сканируются повторно, а результат вычисляется заново, напрасно расходуя ресурсы CPU и ввода-вывода. Query Cache кеширует промежуточные результаты агрегации и при попадании в кеш возвращает их напрямую, значительно сокращая задержку.
- Эта возможность применима только к запросам с агрегацией к внутренним таблицам OLAP. Простое сканирование, JOIN, сортировка и подобные операции не используют Query Cache.
- Внешние таблицы не поддерживаются (Hive, JDBC, Iceberg, Hudi, Paimon и т. д.).
Принцип работы
Поддерживаемые схемы запросов
Использовать кеш могут только фрагменты, дерево плана выполнения которых соответствует одной из следующих схем:
AggregationNode → OlapScanNode: одноэтапная агрегация непосредственно над сканированием.AggregationNode → AggregationNode → OlapScanNode: двухэтапная агрегация над сканированием.
Между узлом агрегации и узлом сканирования допускаются промежуточные узлы, такие как FilterNode и ProjectNode. Однако кешируемое поддерево не должно содержать JoinNode, SortNode, UnionNode, WindowNode или ExchangeNode.
Три компонента ключа кеша
| Компонент | Описание |
|---|---|
| Дайджест SQL | Хеш SHA-256, вычисляемый по нормализованному дереву плана выполнения: агрегатным функциям, выражениям группировки, предикатам фильтрации не по партициям, проецируемым столбцам и переменным сеанса, влияющим на результат. Семантически эквивалентные запросы формируют одинаковый дайджест. |
| Список ID таблетов | Отсортированный список ID таблетов, назначенных текущему экземпляру конвейера. |
| Диапазон таблета | Допустимый диапазон сканирования для каждого таблета, определяемый по предикатам партиционирования (см. Работа с партициями и фильтрами). |
Условия инвалидации кеша
| Условие | Описание |
|---|---|
| Изменение данных | INSERT, DELETE, UPDATE или компактация увеличивают номер версии таблета; последующие запросы сравнивают версии, и несовпадение означает промах кеша. Если включено инкрементальное слияние, запись с более старой версией может использоваться повторно со сканированием только дельты. |
| Изменение схемы | ALTER TABLE изменяет структуру таблицы, что приводит к изменению плана выполнения и дайджеста. |
| Вытеснение LRU | Когда объем памяти кеша превышает лимит, записи вытесняются по алгоритму LRU-K (K=2); для включения новой записи в кеш к ней нужно обратиться как минимум дважды. |
| Удаление устаревших записей | Записи старше 24 часов автоматически удаляются периодической задачей очистки. |
| Принудительное обновление | При установке query_cache_force_refresh = true кеш игнорируется, а запрос выполняется заново. |
Порядок выполнения
Первое выполнение (промах кеша):
- Оператор сканирования считывает данные из таблетов обычным образом.
- Оператор агрегации вычисляет результат.
- Результат передается последующим потребителям и накапливается для записи в кеш.
- После завершения выполнения результат записывается в кеш, если накопленные данные не превышают лимиты размера и количества строк для одной записи.
Последующее выполнение (попадание в кеш):
- Оператор сканирования обнаруживает попадание в кеш и пропускает диапазон сканирования. Данные таблетов не считываются.
- Оператор агрегации не получает входных данных и ничего не выдает.
- Оператор источника кеша напрямую предоставляет кешированные блоки данных.
- Если порядок столбцов отличается от порядка в кешированной записи (например,
SELECT a, bиSELECT b, aформируют одинаковый дайджест), столбцы автоматически переставляются.
Работа с партициями и фильтрами
Чтобы добиться высокой доли попаданий в кеш, необходимо понимать, как предикаты партиционирования и выражения фильтрации взаимодействуют с Query Cache.
Предикаты одноколоночного партиционирования RANGE
Для таблиц с одноколоночным партиционированием RANGE предикаты партиционирования обрабатываются особым образом:
- Предикаты партиционирования исключаются из дайджеста. Система вычисляет пересечение диапазона предиката с фактическими границами диапазона каждой партиции и добавляет его в ключ кеша в виде строки диапазона таблета.
- Два запроса, отличающиеся только диапазоном фильтрации по партициям, могут совместно использовать кеш для общих таблетов.
Пример: таблица orders разбита на ежедневные партиции по столбцу dt.
-- Query A
SELECT region, SUM(revenue) FROM orders
WHERE dt >= '2024-01-01' AND dt < '2024-01-03' GROUP BY region;

-- Query B
SELECT region, SUM(revenue) FROM orders
WHERE dt >= '2024-01-02' AND dt < '2024-01-04' GROUP BY region;
- Запрос A сканирует партиции
2024-01-01и2024-01-02. - Запрос B сканирует партиции
2024-01-02и2024-01-03. - Дайджест и диапазон таблета для партиции
2024-01-02совпадают, поэтому запрос B повторно использует кеш запроса A для2024-01-02и требует пересчета только партиции2024-01-03.
Таблицы с многоколоночным партиционированием RANGE, партиционированием LIST или без партиционирования
Для таблиц с многоколоночным партиционированием RANGE, партиционированием LIST или без партиционирования предикаты партиционирования нельзя выделить отдельно, поэтому они включаются непосредственно в дайджест. Даже небольшие различия в этих предикатах приводят к разным дайджестам и промахам кеша.
Выражения фильтрации не по партициям
Выражения фильтрации не по партициям (например, WHERE status = 'active') включаются в дайджест нормализованного плана выполнения. Два запроса могут совместно использовать кеш, только если их нормализованные выражения фильтрации семантически идентичны.
| Запрос 1 | Запрос 2 | Совместное использование кеша |
|---|---|---|
WHERE status = 'active' | WHERE status = 'active' | Да (одинаковый дайджест) |
WHERE status = 'active' | WHERE status = 'inactive' | Нет (разные дайджесты) |
WHERE status = 'active' AND region = 'ASIA' | WHERE region = 'ASIA' AND status = 'active' | Да (после нормализации порядок не имеет значения) |
Переменные сеанса
Переменные сеанса, влияющие на результаты запроса (например, time_zone, sql_mode и sql_select_limit), включаются в дайджест. Изменение любой из этих переменных между двумя запросами приводит к другому ключу кеша и промаху.
Условия, при которых Query Cache отключается
| Условие | Причина |
|---|---|
| Фрагмент является целью фильтра времени выполнения | Значения фильтра времени выполнения неизвестны на этапе планирования, поэтому кеширование привело бы к неверным результатам. |
Содержатся недетерминированные выражения (rand(), now(), uuid(), UDF и т. д.) | Даже при одинаковых входных данных результаты меняются от выполнения к выполнению. |
| Кешируемое поддерево содержит узел JOIN, SORT, UNION или WINDOW | Поддерживается только схема «агрегация со сканированием». |
Узел сканирования не является OlapScanNode (например, сканирование внешней таблицы) | Кеш опирается на ID и версии таблетов, которых нет у внешних таблиц. |
Почему Query Cache не поддерживает внешние таблицы
Query Cache опирается на три свойства, присущих только внутренним таблицам OLAP:
- Организация данных на основе таблетов: ключ кеша содержит ID таблетов и диапазон сканирования для каждого из них. Внешние таблицы хранятся во внешних системах, таких как HDFS, S3 или JDBC, где нет понятия таблета.
- Инвалидация на основе версий: каждый внутренний таблет имеет монотонно возрастающий номер версии, по которому кеш определяет устаревание данных. Внешние таблицы не предоставляют Doris такой механизм версий.
- Требование OlapScanNode: логика нормализации плана выполнения распознает только
OlapScanNodeкак допустимый узел сканирования под точкой кеширования агрегации.
Для кеширования запросов к внешним таблицам используйте SQL Cache.
Инкрементальное слияние (экспериментальная возможность)
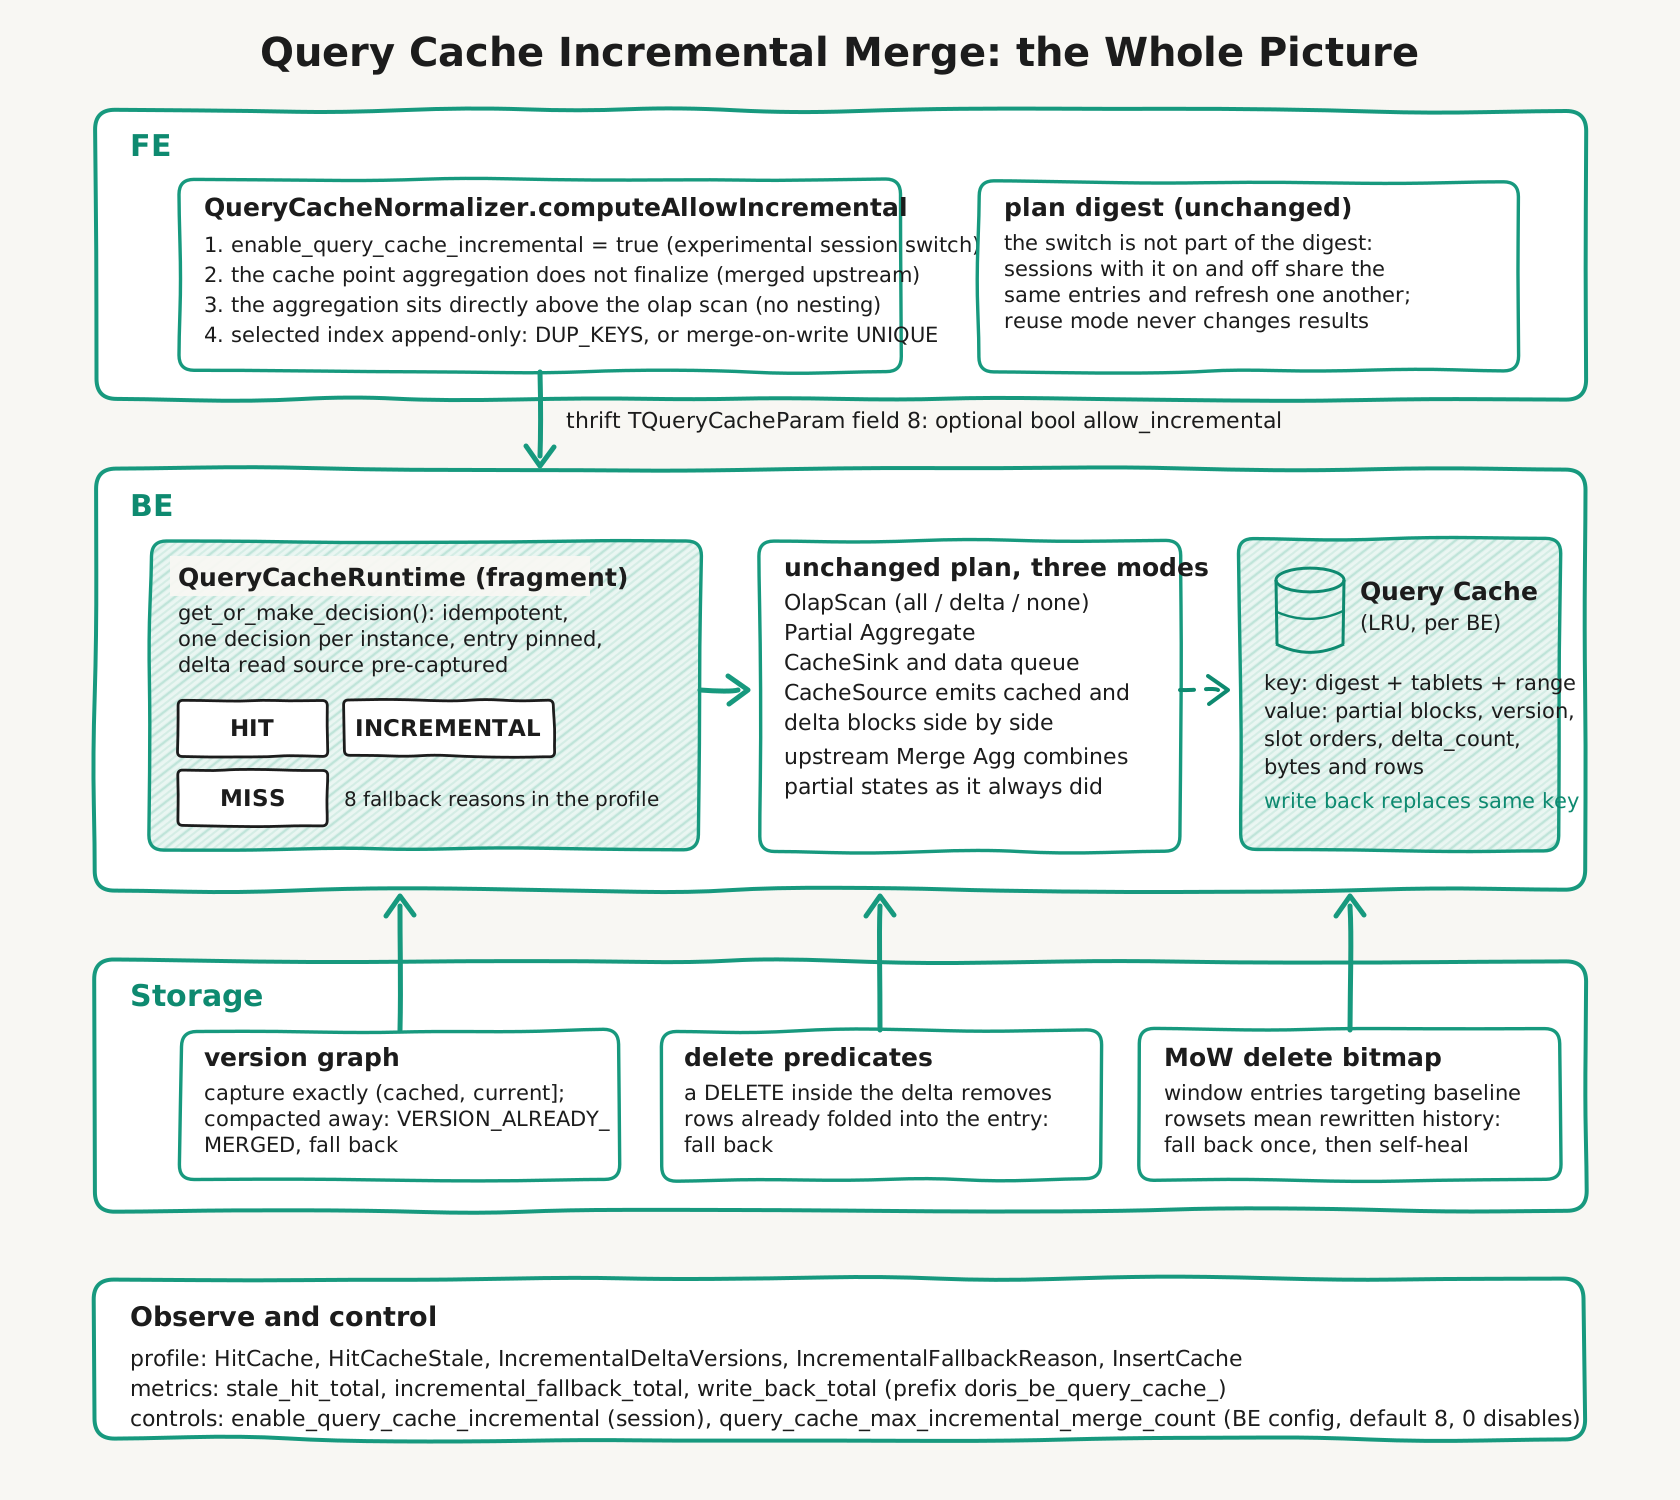
По умолчанию запись кеша с отставшей версией (например, для текущей партиции таблицы, в которую данные загружаются каждый час) отбрасывается, а весь экземпляр конвейера пересчитывается на основе полного сканирования. Если включено инкрементальное слияние, BE повторно использует устаревшую запись: сканирует только наборы rowset дельты в диапазоне (cached_version, current_version], выдает их частичное состояние агрегации вместе с кешированными частичными блоками (расположенный выше оператор слияния агрегаций объединяет их) и записывает объединенную запись обратно в кеш с новой версией. При ежечасной загрузке это сокращает затраты на сканирование активной партиции с «вся партиция каждый час» до «новые данные за один час».
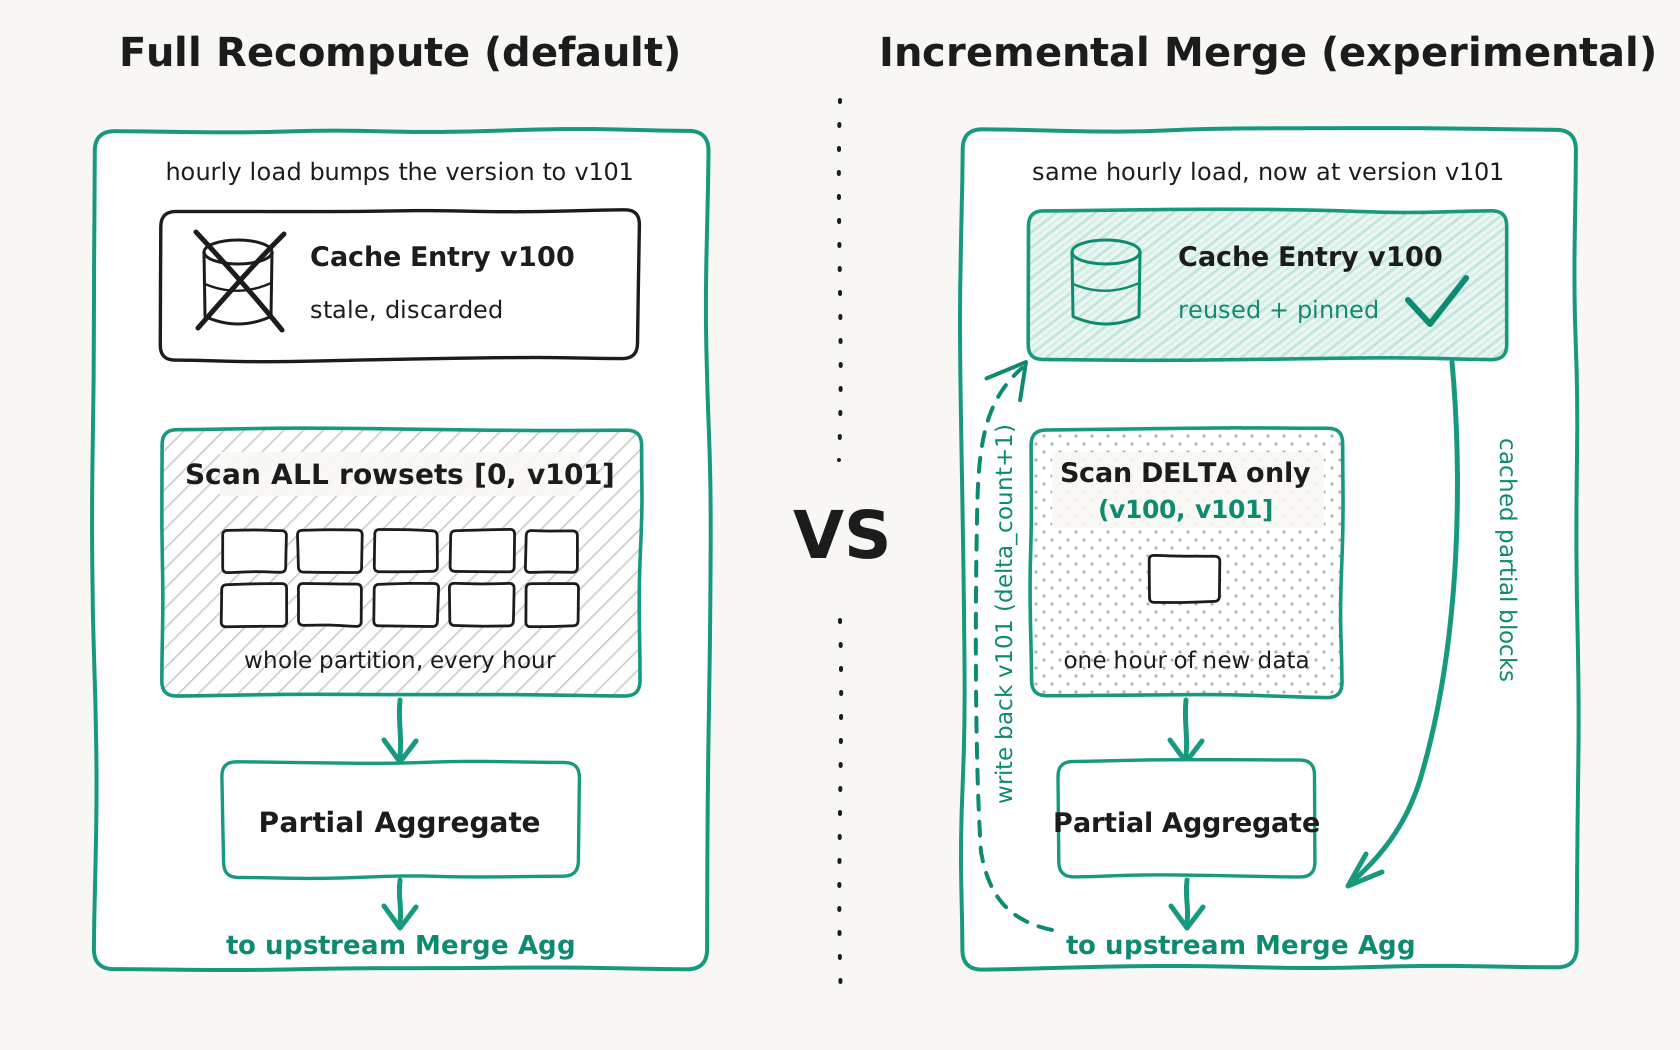
SET enable_query_cache = true;
SET enable_query_cache_incremental = true;  -- shown as experimental_enable_query_cache_incremental in SHOW VARIABLES
Предварительные условия
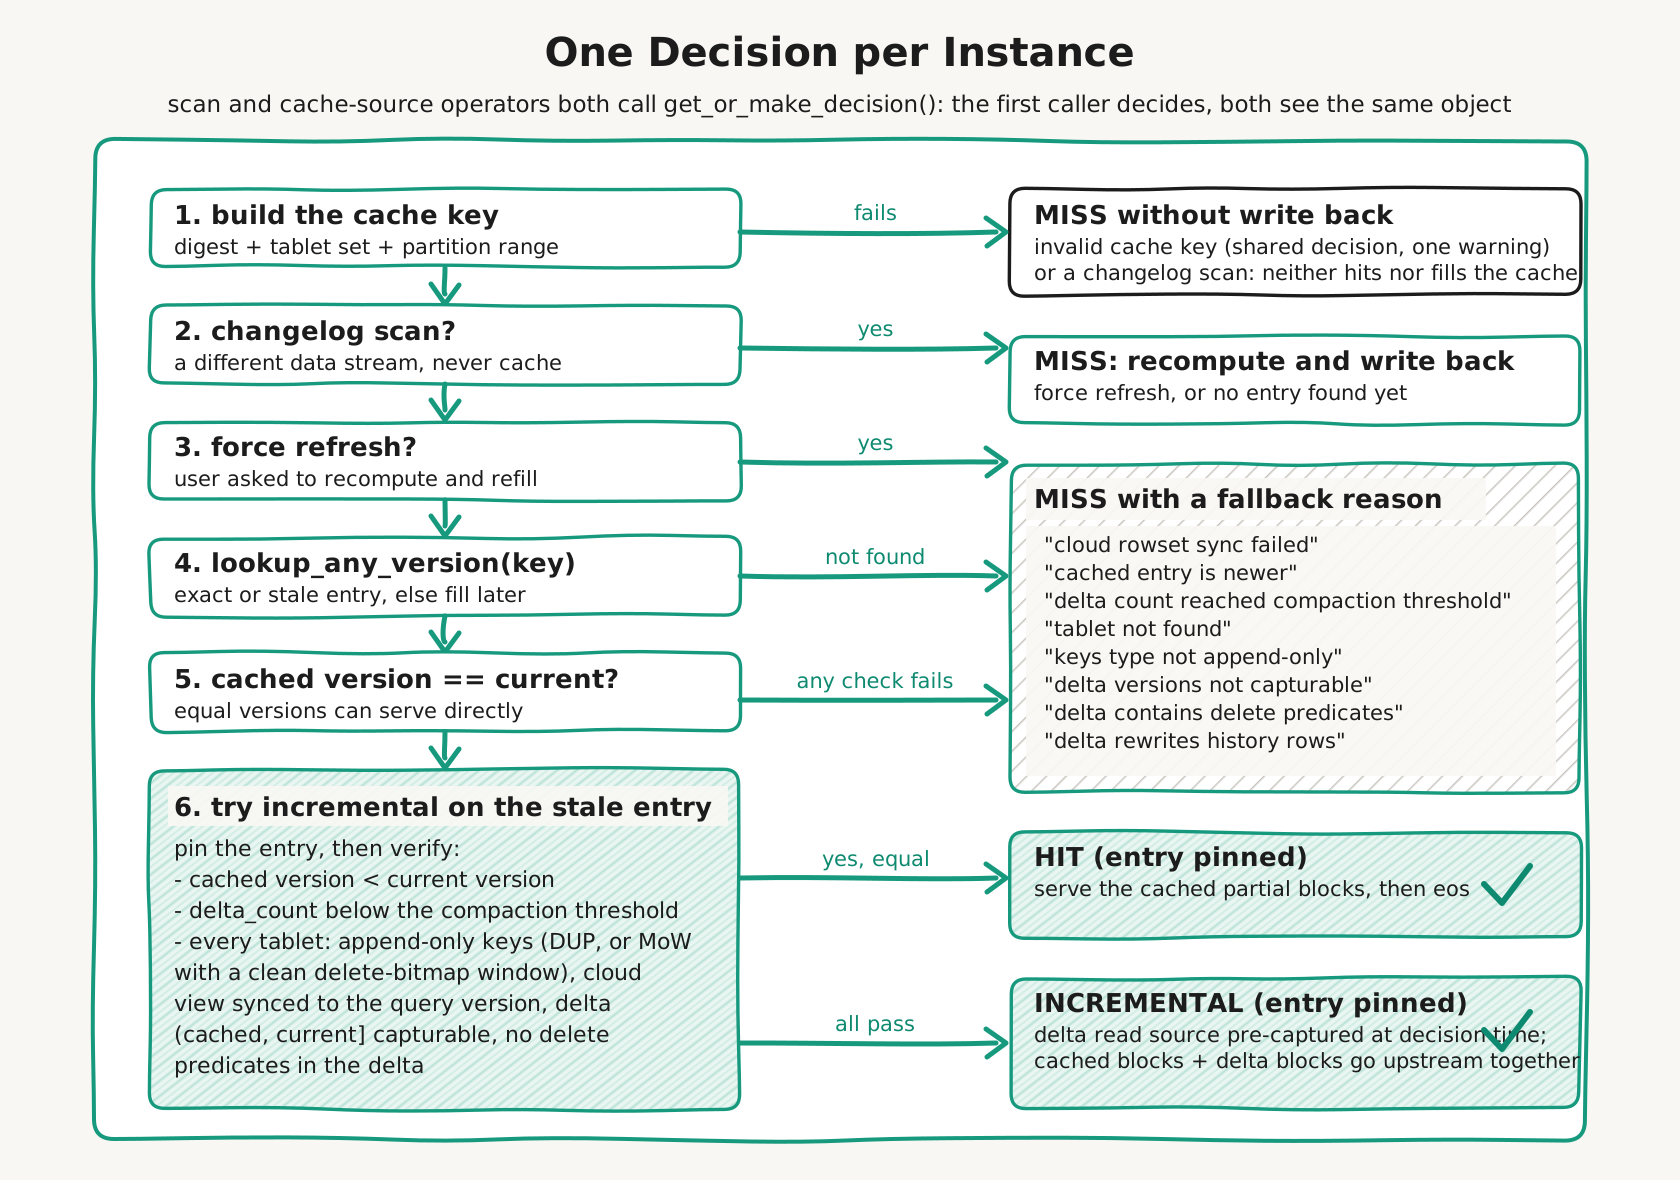
Инкрементальное слияние применяется, только если выполнены все следующие условия. Во всех остальных случаях запрос без дополнительных уведомлений переходит к полному пересчету, поэтому результаты всегда остаются корректными:
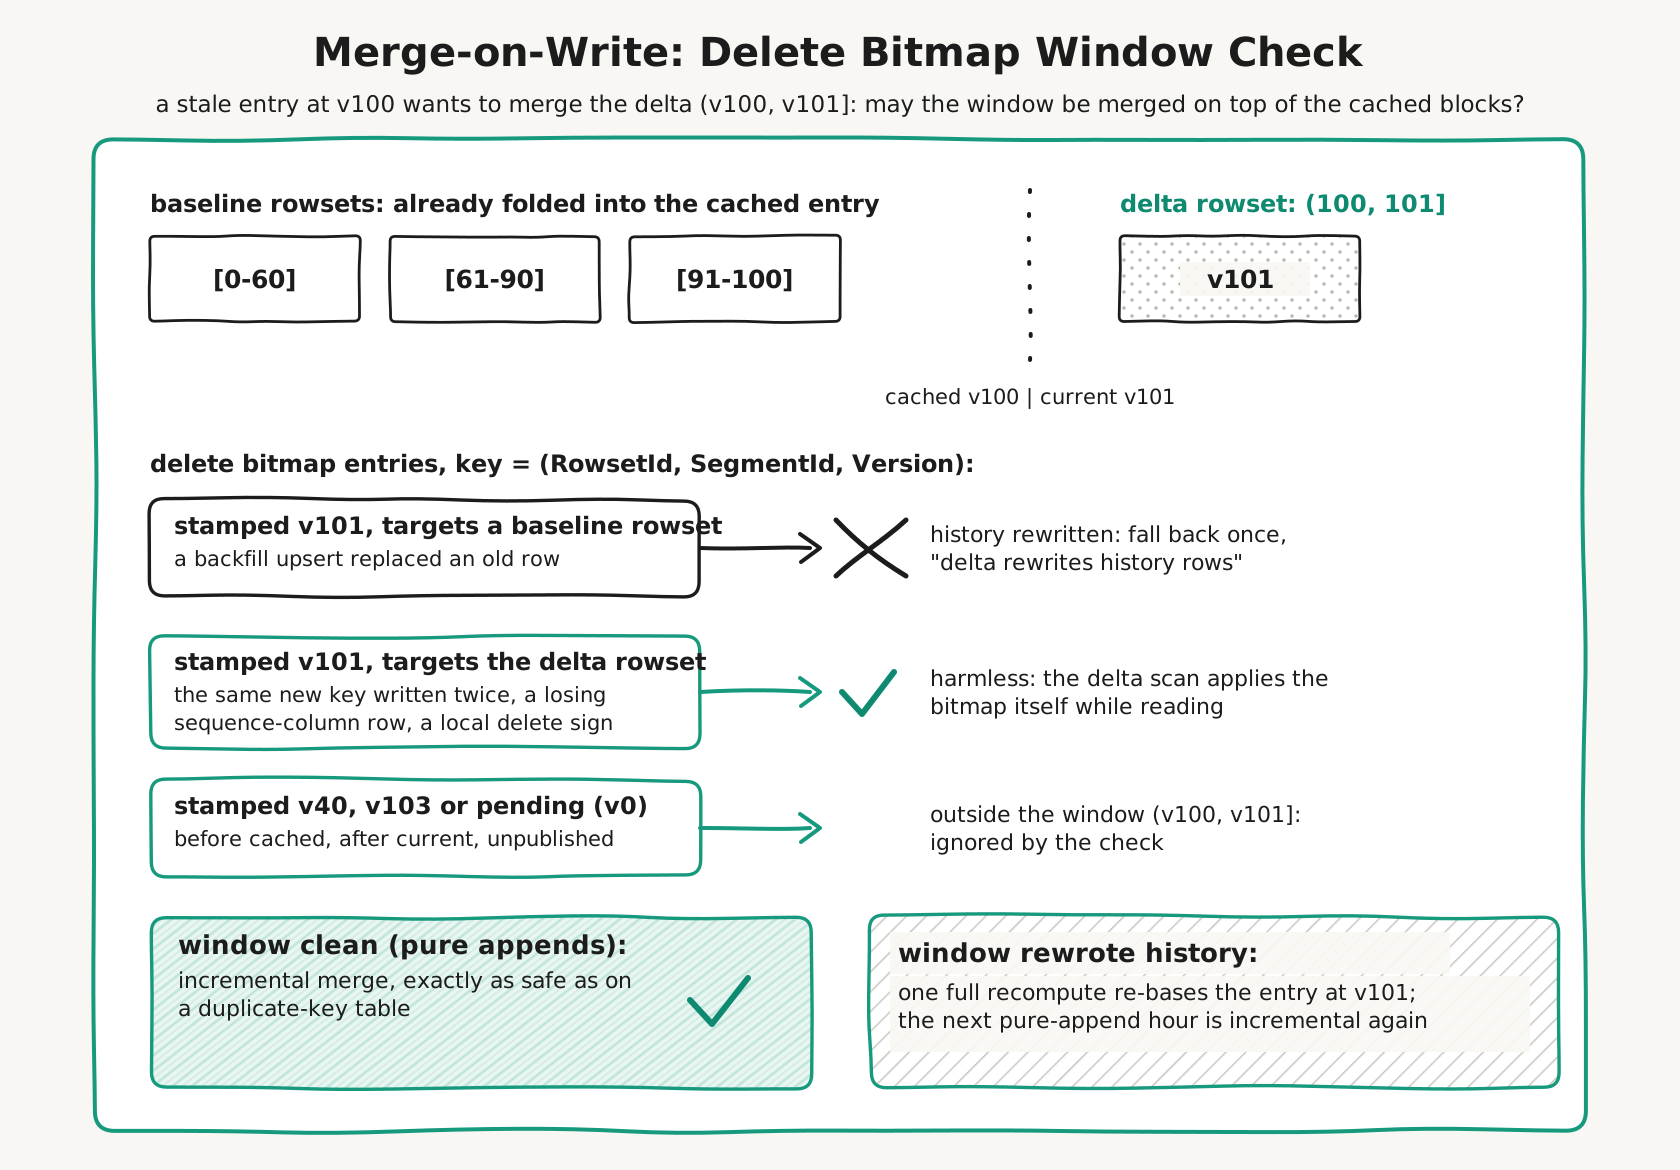
- Сканируемый индекс (базовая таблица или выбранный rollup) работает в режиме append-only: это либо модель DUP_KEYS, либо таблица merge-on-write UNIQUE_KEYS, в окне дельты которой не перезаписывался ни один ранее существовавший ключ. Для таблиц merge-on-write BE проверяет битовую карту удалений в диапазоне
(cached_version, current_version]для каждого таблета: если в окне только добавлялись совершенно новые ключи (типичный сценарий «ежечасной загрузки» в таблицу с первичным ключом), выполняется инкрементальное слияние. Если же upsert, частичное обновление или признак удаления затронули старый ключ, выполняется один полный пересчет. Он обновляет базовую запись кеша, поэтому следующая загрузка, содержащая только добавления, снова обрабатывается инкрементально. Таблицы merge-on-read UNIQUE устраняют дубликаты при чтении, а таблицы AGG объединяют строки на уровне хранения, поэтому равенство «кешированный снимок + дельта = новый снимок» для них не выполняется. Агрегированные материализованные представления исключаются по той же причине. - Точка кеширования представляет собой агрегацию без финализации непосредственно над сканированием (типичная схема двухфазной агрегации, например
GROUP BYпо столбцу, который не используется для распределения). Однофазные агрегации и вложенные точки кеширования агрегации не допускаются. - Представление таблета можно синхронизировать с запрошенной версией. В режиме с совмещенными вычислениями и хранением это условие выполняется автоматически. В режиме с разделенными вычислениями и хранением (облачном) при принятии решения для каждого таблета сначала обновляется локальное представление (наборы rowset, а для таблиц merge-on-write также битовая карта удалений) до запрошенной версии. Обычно это не требует дополнительных затрат: если представление уже актуально, никаких действий не выполняется; в противном случае лишь заранее выполняется синхронизация, которая в любом случае потребовалась бы при сканировании. Если синхронизация завершается ошибкой или превышает короткий лимит ожидания для быстрого отказа (
query_cache_decision_sync_timeout_ms, параметр BE, не позволяющий медленному сервису метаданных блокировать поток допуска, в котором принимается решение), выполняется один полный пересчет. - Цепочка версий дельты по-прежнему доступна (не объединена компактацией) и не содержит предикатов DELETE, поскольку удаление внутри дельты логически удаляет строки, уже включенные в кешированные блоки, а слияние не позволяет отменить их вклад.
Для таблиц merge-on-write проверка окна битовой карты удалений выполняется следующим образом:
В кластерах с разделенными вычислениями и хранением (облачных) две переменные сеанса позволяют пожертвовать точностью версии ради скорости: query_freshness_tolerance_ms позволяет сканированию остановиться на уже подготовленной версии ниже запрошенной, а enable_prefer_cached_rowset позволяет использовать уже подготовленную структуру rowset. При включении любого из этих параметров обход может также выйти за пределы запрошенной версии (подготовленный rowset компактации, охватывающий эту версию, продлевает цепочку за ее пределы). Поэтому запрос с любым из этих параметров может прочитать представление, не соответствующее точной версии, и не использует инкрементальное слияние: дельта всегда извлекается строго для запрошенной версии, что лишило бы такой параметр смысла. Независимо от инкрементального слияния, в облачном режиме BE также пропускает запись результата такого запроса в Query Cache, поэтому запись, содержимое которой не соответствует указанной в ней версии, никогда не создается. При этом запрос по-прежнему может получить точное попадание HIT по записи, заполненной обычным выполнением. Сам запрет на инкрементальное слияние действует во всех режимах развертывания (проверка намеренно не зависит от режима). При локальном хранении эти параметры не действуют, поэтому проверка лишь исключает инкрементальную оптимизацию для запроса, выбравшего компромисс, доступный только в облачном режиме; в любом случае результаты остаются корректными.
Компактация объединенных записей
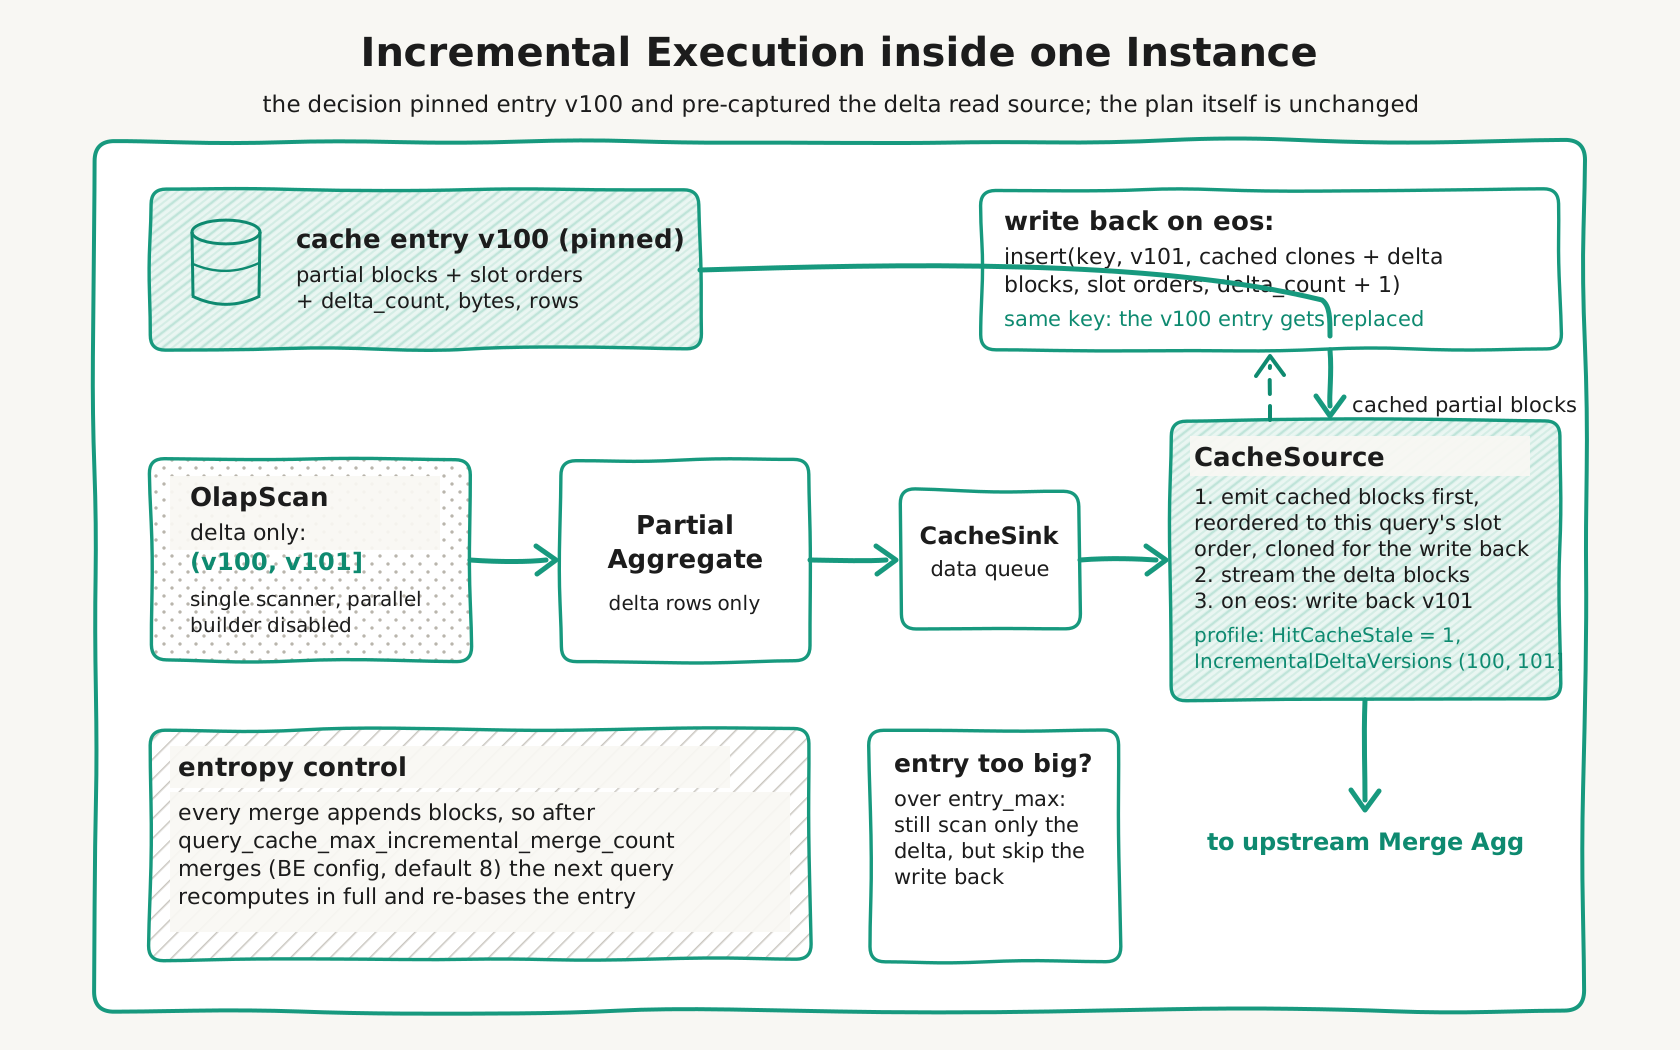
Каждое инкрементальное слияние добавляет блоки дельты к записи, поэтому со временем запись становится более фрагментированной. Когда запись накапливает query_cache_max_incremental_merge_count слияний (параметр BE, по умолчанию 8, можно менять во время работы), следующий запрос пересчитывает ее на основе полного сканирования, естественным образом уплотняя запись.
Поток данных внутри одного экземпляра, включая обратную запись в кеш и оба механизма контроля энтропии:
Наблюдаемость
- В профиле запроса оператора CACHE_SOURCE:
HitCacheStale = 1указывает на инкрементальное слияние;IncrementalDeltaVersionsпоказывает диапазон дельты (например,(100, 114514]); если устаревшую запись не удалось использовать повторно,IncrementalFallbackReasonобъясняет причину (delta versions not capturable,delta contains delete predicates,delta rewrites history rows,keys type not append-only,cloud rowset sync failed,cloud rowset sync timed outи т. д.). - Метрики BE:
doris_be_query_cache_stale_hit_total,doris_be_query_cache_incremental_fallback_total,doris_be_query_cache_write_back_totalиdoris_be_query_cache_decision_sync_time_ms(увеличивается только в режиме с разделенными вычислениями и хранением: суммарное фактически затраченное время синхронизации представлений таблетов с запрошенной версией при принятии решения об инкрементальном слиянии перед извлечением дельты).
Как BE выбирает между HIT, INCREMENTAL и MISS и откуда берется каждая причина перехода к полному пересчету:
Общая схема: от разрешения на стороне FE до защитных проверок на уровне хранения:
Параметры настройки
Переменные сеанса (FE)
| Параметр | Описание | По умолчанию |
|---|---|---|
enable_query_cache | Главный переключатель, включающий или отключающий Query Cache. | false |
query_cache_force_refresh | Если установлено значение true, кешированный результат игнорируется, а запрос выполняется заново; новый результат по-прежнему записывается в кеш. | false |
query_cache_entry_max_bytes | Максимальный размер одной записи кеша в байтах; результаты фрагмента, превышающие этот лимит, не кешируются. | 5242880 (5 MB) |
query_cache_entry_max_rows | Максимальное количество строк в одной записи кеша; результаты фрагмента, превышающие этот лимит, не кешируются. | 500000 |
enable_query_cache_incremental | (Экспериментальная возможность) Позволяет BE повторно использовать устаревшую запись кеша, сканируя только наборы rowset дельты после кешированной версии и объединяя их с кешированными блоками частичной агрегации. См. Инкрементальное слияние. | false |
Конфигурация BE (be.conf)
| Параметр | Описание | По умолчанию |
|---|---|---|
query_cache_size | Общий объем памяти Query Cache на каждом BE (MB). | 512 |
query_cache_max_incremental_merge_count | Максимальное количество инкрементальных слияний, накапливаемых в одной записи кеша перед принудительным полным пересчетом для ее уплотнения. Значение 0 отключает инкрементальное слияние во время работы. | 8 |
query_cache_decision_sync_timeout_ms | (Только в облачном режиме) Лимит ожидания в миллисекундах для быстрого отказа при синхронизации представления каждого таблета с запрошенной версией в ходе принятия решения об инкрементальном слиянии перед извлечением дельты; если синхронизация не завершается за это время, запрос переходит к одному полному пересчету. Значение <= 0 отключает инкрементальное слияние в облачном режиме (любая ожидающая синхронизация приводит к полному пересчету). Можно менять во время работы. | 2000 |
Параметры query_cache_max_size_mb и query_cache_elasticity_size_mb в be.conf управляют устаревшим SQL Result Cache. Они не относятся к Query Cache на уровне конвейера, описанному в этой статье. Не путайте эти механизмы.
Примеры использования
Шаг 1: включите Query Cache
Цель: включить главный переключатель Query Cache.
SET enable_query_cache = true;
Описание: эта переменная действует в пределах сеанса, поэтому ее нужно включать в каждом соединении. Также можно задать ее значение по умолчанию как глобальную переменную FE.
Шаг 2: выполните типичный запрос с агрегацией
Цель: инициировать запись в кеш и чтение из него.
-- First execution: cache miss, compute the result and write it to the cache
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt = '2024-01-15' AND status = 'completed'
GROUP BY region;

-- Second execution: cache hit, return the result directly from the cache
SELECT region, SUM(revenue), COUNT(*)
FROM orders
WHERE dt = '2024-01-15' AND status = 'completed'
GROUP BY region;
Описание: дайджест SQL, список ID таблетов и диапазон таблета при втором выполнении совпадают с первым, поэтому происходит попадание в кеш.
Шаг 3: проверьте попадание в кеш по профилю
Цель: убедиться, что запрос действительно использует кеш.
После выполнения запроса откройте профиль и найдите раздел CacheSourceOperator:
| Поле профиля | Значение |
|---|---|
HitCache: true | Запрос получил результат из кеша. |
HitCache: false, InsertCache: true | Произошел промах, но результат успешно записан в кеш. |
HitCache: false, InsertCache: false | Произошел промах, а результат слишком велик для кеширования. |
CacheTabletId | ID таблета, к которому относится запись кеша. |
Шаг 4: принудительно обновите кеш
Цель: проигнорировать существующий кеш и пересчитать результат (например, если вы подозреваете, что кешированные данные неверны).
-- Force the next query to skip the cache and recompute the result
SET query_cache_force_refresh = true;

SELECT region, SUM(revenue) FROM orders WHERE dt = '2024-01-15' GROUP BY region;

-- Reset
SET query_cache_force_refresh = false;
Описание: после принудительного обновления новый результат по-прежнему записывается в кеш.
Сравнение сценариев использования
| Сценарий | Применимость | Причина |
|---|---|---|
| Дашборды или инструменты BI, многократно выполняющие один и тот же SQL-запрос с агрегацией | Да | Дайджест и таблеты полностью совпадают, обеспечивая высокую долю попаданий. |
| Отчеты T+1 (данные загружаются раз в день) | Да | Последующие запросы в тот же день могут попадать в кеш. |
| Запросы с агрегацией с пересекающимися диапазонами дат | Да | Одноколоночное партиционирование RANGE позволяет совместно использовать записи на уровне таблетов. |
| Простое сканирование SELECT, JOIN, сортировка и оконные функции | Нет | Поддерживается только схема «агрегация со сканированием». |
| Внешние таблицы (Hive, JDBC, Iceberg, Hudi, Paimon) | Нет | Нет механизма таблетов и версий. Используйте SQL Cache. |
| Часто обновляемые таблицы | Нет | Версии таблетов быстро меняются, что приводит к низкой доле попаданий. |
Запросы, содержащие now(), rand(), uuid() или UDF | Нет | Недетерминированные результаты отключают кеширование. |
| Запросы, зависящие от фильтров времени выполнения | Нет | Значения фильтров времени выполнения неизвестны на этапе планирования. |
Примечания
- Кеш не сохраняется между перезапусками: Query Cache находится в памяти BE и очищается при перезапуске BE.
- Потребление памяти: кешированные блоки данных занимают память BE. Следите за использованием памяти и при необходимости настраивайте
query_cache_size. - Допуск в кеш по LRU-K: когда кеш заполнен, для включения новой записи к ней нужно обратиться как минимум дважды (K=2), что предотвращает заполнение кеша результатами редких запросов.
Устранение неполадок
| Симптом | Возможная причина | Решение |
|---|---|---|
Постоянно отображается HitCache: false | Не включен enable_query_cache. | Выполните SET enable_query_cache = true. |
HitCache: false, InsertCache: false | Результат для одной записи слишком велик и превышает query_cache_entry_max_bytes или _max_rows. | Увеличьте соответствующий порог или добавьте фильтры для уменьшения размера результата. |
В плане отсутствует CacheSourceOperator | План содержит JOIN/SORT/UNION/WINDOW или является целью фильтра времени выполнения. | Перепишите SQL так, чтобы он соответствовал схеме «агрегация со сканированием». |
| Таблица является внешней | Query Cache не поддерживает внешние таблицы. | Используйте SQL Cache. |
| Данные не изменились, но кеш по-прежнему дает промахи | Изменилась схема, переменная сеанса или установлено query_cache_force_refresh = true. | Проверьте историю ALTER, сравните переменные сеанса и сбросьте query_cache_force_refresh. |
| Доля попаданий в кеш очень низкая | Таблет часто обновляется или подвергается компактации. | Уменьшите частоту записи или включайте кеш только для редко обновляемых таблиц. |
| Возрастает нагрузка на память BE | Установлено слишком высокое значение query_cache_size. | Уменьшите query_cache_size и перезапустите BE. |
Часто задаваемые вопросы
Вопрос 1: чем Query Cache отличается от SQL Cache?
| Критерий | Query Cache | SQL Cache |
|---|---|---|
| Гранулярность кеширования | Промежуточные результаты агрегации на уровне таблетов. | Итоговый результат всего SQL-запроса. |
| Поддерживаемые запросы | Только запросы с агрегацией к внутренним таблицам OLAP. | Любые запросы, в том числе к внешним таблицам. |
| Совместное использование | Разные SQL-запросы могут совместно использовать записи кеша на уровне таблетов. | Попадание возможно только при точном совпадении текста SQL. |
| Инвалидация | Происходит сразу при изменении версии таблета. | Основана на версиях партиций или времени. |
Вопрос 2: произойдет ли попадание в кеш сразу после его включения?
Нет. Первое выполнение представляет собой «промах кеша с записью в кеш»; попадание возможно только при втором и последующих выполнениях. Кроме того, LRU-K (K=2) требует как минимум двух обращений к новой записи, прежде чем она действительно будет включена в кеш.
Вопрос 3: можно ли кешировать агрегации, в которых участвует JOIN?
Это зависит от положения агрегации относительно JOIN. Если агрегация находится непосредственно над JOIN (в кешируемом поддереве присутствует JoinNode), такой фрагмент не кешируется независимо от фильтров времени выполнения. Но если переписать запрос так, чтобы сначала выполнялась агрегация, а затем JOIN (опустив агрегацию к сканированию каждой таблицы), агрегация на уровне таблетов каждой таблицы может кешироваться отдельно. При этом остается независимое ограничение: JOIN передает фильтр времени выполнения в сканирование на стороне probe, из-за чего фрагмент этой стороны не подлежит кешированию. Поэтому при включенных фильтрах времени выполнения кешируется только сторона build; чтобы разрешить кеширование каждой таблицы в JOIN, также установите runtime_filter_mode=OFF. Еще один вариант — использовать материализованное представление.
Вопрос 4: нужно ли прогревать кеш после перезапуска BE?
Да. Query Cache хранится в оперативной памяти и очищается при перезапуске. Для его прогрева можно выполнить основные SQL-запросы с агрегацией в часы низкой нагрузки.
Вопрос 5: как убедиться, что попадание в кеш действительно произошло?
После выполнения SQL проверьте поле HitCache оператора CacheSourceOperator в профиле.
Итоги
Query Cache — это механизм оптимизации Doris на уровне конвейера, который кеширует промежуточные результаты агрегации на уровне таблетов. Его основные характеристики:
- Применяется только к запросам с агрегацией к внутренним таблицам OLAP.
- Автоматически выполняет инвалидацию кеша на основе версий таблетов.
- Выделяет предикаты партиционирования из дайджеста, позволяя запросам с пересекающимися диапазонами партиций совместно использовать кеш.
- Предоставляет лимиты размера и количества строк для одной записи, чтобы слишком большие результаты не занимали память кеша.
- Использует политику вытеснения LRU-K (K=2) для поддержания эффективности кеша.