Автоматическое партиционирование
Автоматическое партиционирование (AUTO PARTITION) позволяет Doris автоматически создавать партиции при загрузке данных на основе значений столбца партиционирования. Оно решает следующие проблемы:
- Столбец партиционирования содержит разрозненные, трудно предсказуемые данные, поэтому при создании таблицы невозможно точно перечислить все необходимые партиции.
- Партиций слишком много, чтобы создавать их вручную.
- Столбец партиционирования не связан с системным временем, поэтому динамическое партиционирование не подходит для такого сценария.
Doris поддерживает два типа автоматического партиционирования:
| Тип | Способ партиционирования | Функция партиционирования | Поддерживаемые типы столбцов партиционирования |
|---|---|---|---|
| AUTO RANGE PARTITION | Автоматическое партиционирование по диапазону | date_trunc | DATE, DATETIME, TIMESTAMP_NS |
| AUTO LIST PARTITION | Автоматическое партиционирование по перечисляемым значениям | Вызовы функций не поддерживаются | BOOLEAN, TINYINT, SMALLINT, INT, BIGINT, LARGEINT, DATE, DATETIME, TIMESTAMP_NS, CHAR, VARCHAR |
Сценарии использования
Рассмотрим столбец партиционирования с временным типом данных:
- При динамическом партиционировании Doris может автоматически создавать новые партиции через фиксированные промежутки времени для хранения данных, поступающих в реальном времени. Для таких сценариев, как журналы действий пользователей в реальном времени, этой возможности обычно достаточно.
- Однако в более сложных сценариях (например, при обработке данных, поступающих не в реальном времени) столбец партиционирования никак не связан с текущим системным временем и содержит множество разрозненных значений. Партиционирование по этому столбцу по-прежнему необходимо, но нужные партиции невозможно определить заранее либо их требуется слишком много.
В таких случаях ни динамическое партиционирование, ни создание партиций вручную не решают задачу, а автоматическое партиционирование хорошо подходит для этих сценариев.
Пример сценария: таблица истории сделок
Предположим, в компании есть таблица истории сделок, партиционированная по дате сделки. При создании партиций вручную DDL обычно выглядит следующим образом:
CREATE TABLE `DAILY_TRADE_VALUE`
(
    `TRADE_DATE`              datev2 NOT NULL COMMENT 'Trade date',
    `TRADE_ID`                varchar(40) NOT NULL COMMENT 'Trade ID',
    ......
)
UNIQUE KEY(`TRADE_DATE`, `TRADE_ID`)
PARTITION BY RANGE(`TRADE_DATE`)
(
    PARTITION p_2000 VALUES [('2000-01-01'), ('2001-01-01')),
    PARTITION p_2001 VALUES [('2001-01-01'), ('2002-01-01')),
    PARTITION p_2002 VALUES [('2002-01-01'), ('2003-01-01')),
    PARTITION p_2003 VALUES [('2003-01-01'), ('2004-01-01')),
    PARTITION p_2004 VALUES [('2004-01-01'), ('2005-01-01')),
    PARTITION p_2005 VALUES [('2005-01-01'), ('2006-01-01')),
    PARTITION p_2006 VALUES [('2006-01-01'), ('2007-01-01')),
    PARTITION p_2007 VALUES [('2007-01-01'), ('2008-01-01')),
    PARTITION p_2008 VALUES [('2008-01-01'), ('2009-01-01')),
    PARTITION p_2009 VALUES [('2009-01-01'), ('2010-01-01')),
    PARTITION p_2010 VALUES [('2010-01-01'), ('2011-01-01')),
    PARTITION p_2011 VALUES [('2011-01-01'), ('2012-01-01')),
    PARTITION p_2012 VALUES [('2012-01-01'), ('2013-01-01')),
    PARTITION p_2013 VALUES [('2013-01-01'), ('2014-01-01')),
    PARTITION p_2014 VALUES [('2014-01-01'), ('2015-01-01')),
    PARTITION p_2015 VALUES [('2015-01-01'), ('2016-01-01')),
    PARTITION p_2016 VALUES [('2016-01-01'), ('2017-01-01')),
    PARTITION p_2017 VALUES [('2017-01-01'), ('2018-01-01')),
    PARTITION p_2018 VALUES [('2018-01-01'), ('2019-01-01')),
    PARTITION p_2019 VALUES [('2019-01-01'), ('2020-01-01')),
    PARTITION p_2020 VALUES [('2020-01-01'), ('2021-01-01')),
    PARTITION p_2021 VALUES [('2021-01-01'), ('2022-01-01'))
)
DISTRIBUTED BY HASH(`TRADE_DATE`) BUCKETS 10
PROPERTIES (
  "replication_num" = "1"
);
У этого подхода есть следующие недостатки:
- При создании таблицы необходимо вручную перечислить все партиции.
- При изменении диапазона значений столбца партиционирования (например, при добавлении данных за 2022 год) партиции приходится изменять с помощью ALTER-TABLE-PARTITION, что неудобно.
- Если требуется изменить партиции или использовать более мелкую гранулярность, это потребует значительных усилий.
При использовании AUTO PARTITION DDL можно упростить до следующего:
CREATE TABLE `DAILY_TRADE_VALUE`
(
    `TRADE_DATE`              datev2 NOT NULL,
    `TRADE_ID`                varchar(40) NOT NULL,
    ......
)
UNIQUE KEY(`TRADE_DATE`, `TRADE_ID`)
AUTO PARTITION BY RANGE (date_trunc(`TRADE_DATE`, 'year'))
(
)
DISTRIBUTED BY HASH(`TRADE_DATE`) BUCKETS 10
PROPERTIES (
  "replication_num" = "1"
);
В только что созданной таблице нет партиций по умолчанию:
show partitions from `DAILY_TRADE_VALUE`;
Empty set (0.12 sec)
После вставки данных соответствующие партиции создаются автоматически:
insert into `DAILY_TRADE_VALUE` values ('2012-12-13', 1), ('2008-02-03', 2), ('2014-11-11', 3);

show partitions from `DAILY_TRADE_VALUE`;
+-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+
| PartitionId | PartitionName   | VisibleVersion | VisibleVersionTime  | State  | PartitionKey | Range                                                                          | DistributionKey | Buckets | ReplicationNum | StorageMedium | CooldownTime        | RemoteStoragePolicy | LastConsistencyCheckTime | DataSize | IsInMemory | ReplicaAllocation       | IsMutable |
+-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+
| 180060      | p20080101000000 | 2              | 2023-09-18 21:49:29 | NORMAL | TRADE_DATE   | [types: [DATEV2]; keys: [2008-01-01]; ..types: [DATEV2]; keys: [2009-01-01]; ) | TRADE_DATE      | 10      | 1              | HDD           | 9999-12-31 23:59:59 |                     | NULL                     | 0.000    | false      | tag.location.default: 1 | true      |
| 180039      | p20120101000000 | 2              | 2023-09-18 21:49:29 | NORMAL | TRADE_DATE   | [types: [DATEV2]; keys: [2012-01-01]; ..types: [DATEV2]; keys: [2013-01-01]; ) | TRADE_DATE      | 10      | 1              | HDD           | 9999-12-31 23:59:59 |                     | NULL                     | 0.000    | false      | tag.location.default: 1 | true      |
| 180018      | p20140101000000 | 2              | 2023-09-18 21:49:29 | NORMAL | TRADE_DATE   | [types: [DATEV2]; keys: [2014-01-01]; ..types: [DATEV2]; keys: [2015-01-01]; ) | TRADE_DATE      | 10      | 1              | HDD           | 9999-12-31 23:59:59 |                     | NULL                     | 0.000    | false      | tag.location.default: 1 | true      |
+-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+----------+------------+-------------------------+-----------+
Партиции, созданные автоматически, функционально идентичны партициям, созданным вручную.
Синтаксис
Используйте следующий синтаксис в части partitions_definition оператора CREATE-TABLE.
AUTO RANGE PARTITION
[AUTO] PARTITION BY RANGE(<partition_expr>)
<origin_partitions_definition>
Где:
partition_expr ::= date_trunc(<partition_column>, '<interval>')
В AUTO RANGE PARTITION ключевое слово AUTO можно опустить; автоматическое партиционирование при этом сохраняется.
Пример:
CREATE TABLE `date_table` (
    `TIME_STAMP` datev2 NOT NULL
) ENGINE=OLAP
DUPLICATE KEY(`TIME_STAMP`)
AUTO PARTITION BY RANGE (date_trunc(`TIME_STAMP`, 'month'))
(
)
DISTRIBUTED BY HASH(`TIME_STAMP`) BUCKETS 10
PROPERTIES (
    "replication_allocation" = "tag.location.default: 1"
);
AUTO LIST PARTITION
AUTO PARTITION BY LIST(`partition_col1` [, `partition_col2`, ...])
<origin_partitions_definition>
Автоматическое партиционирование LIST поддерживает партиционирование по нескольким столбцам с тем же синтаксисом, что и обычное партиционирование LIST: AUTO PARTITION BY LIST(col1, col2, ...). Для каждого значения столбца партиционирования, у которого ещё нет соответствующей партиции, создаётся отдельная новая партиция.
Пример:
CREATE TABLE `str_table` (
    `str` varchar not null
) ENGINE=OLAP
DUPLICATE KEY(`str`)
AUTO PARTITION BY LIST (`str`)
()
DISTRIBUTED BY HASH(`str`) BUCKETS 10
PROPERTIES (
    "replication_allocation" = "tag.location.default: 1"
);
Сравнение ограничений
| Ограничение | AUTO RANGE PARTITION | AUTO LIST PARTITION |
|---|---|---|
| Поддерживаемые функции партиционирования | Только date_trunc | Вызовы функций не поддерживаются |
| Поддерживаемые типы столбцов партиционирования | DATE, DATETIME, TIMESTAMP_NS | BOOLEAN, TINYINT, SMALLINT, INT, BIGINT, LARGEINT, DATE, DATETIME, TIMESTAMP_NS, CHAR, VARCHAR |
| Поддержка партиционирования по нескольким столбцам | Нет | Да |
| Ограничение длины имени партиции | - | Не более 50 символов (имя формируется путём конкатенации и экранирования содержимого столбцов партиционирования; фактически допустимая длина может быть меньше) |
| Правило определения значений партиций | Разбиение по временному диапазону, полученному усечением с помощью date_trunc | Для каждого нового перечисляемого значения, у которого ещё нет партиции, создаётся отдельная новая партиция |
Партиционирование значений NULL
После включения переменной сеанса allow_partition_column_nullable два типа автоматического партиционирования различаются по поддержке столбцов NULLABLE:
| Тип автоматического партиционирования | Поддержка столбца партиционирования NULLABLE |
|---|---|
| AUTO LIST PARTITION | Поддерживается. При записи NULL создаётся обычная партиция для NULL. |
| AUTO RANGE PARTITION | Не поддерживается |
AUTO LIST PARTITION: поддержка столбцов NULLABLE
create table auto_null_list(
    k0 varchar null
)
auto partition by list (k0)
(
)
DISTRIBUTED BY HASH(`k0`) BUCKETS 1
properties("replication_num" = "1");

insert into auto_null_list values (null);

select * from auto_null_list;
+------+
| k0   |
+------+
| NULL |
+------+

select * from auto_null_list partition(pX);
+------+
| k0   |
+------+
| NULL |
+------+
AUTO RANGE PARTITION: столбцы NULLABLE не поддерживаются
CREATE TABLE `range_table_nullable` (
    `k1` INT,
    `k2` DATETIMEV2(3),
    `k3` DATETIMEV2(6)
) ENGINE=OLAP
DUPLICATE KEY(`k1`)
AUTO PARTITION BY RANGE (date_trunc(`k2`, 'day'))
()
DISTRIBUTED BY HASH(`k1`) BUCKETS 16
PROPERTIES (
    "replication_allocation" = "tag.location.default: 1"
);

ERROR 1105 (HY000): errCode = 2, detailMessage = AUTO RANGE PARTITION doesn't support NULL column
Управление жизненным циклом
Doris поддерживает совместное использование автоматического и динамического партиционирования для управления жизненным циклом, но такое сочетание больше не рекомендуется.
В таблицах AUTO RANGE PARTITION можно управлять жизненным циклом исторических партиций с помощью свойства partition.retention_count. Это свойство принимает положительное целое число N, означающее, что сохраняются только N исторических партиций с наибольшими значениями партиций; все текущие и будущие партиции сохраняются.
Ограничения использования:
- Это свойство можно задать только для таблиц AUTO RANGE PARTITION. В противном случае оператор завершается ошибкой
Only AUTO RANGE PARTITION table could set partition.retention_count. - Его нельзя использовать совместно с уже включённым динамическим партиционированием (
dynamic_partition.enable = true). В противном случае оператор завершается ошибкойCan not use partition.retention_count and dynamic_partition properties at the same time. Создание партиций посредством динамического партиционирования и очистка партиций по заданному количеству сохраняемых партиций являются взаимоисключающими режимами планирования. Это ограничение действует начиная с версии 4.1.4 как в режиме с совместным размещением вычислений и хранения, так и в режиме с их разделением. - Начиная с версии 4.1.4, режим с разделением вычислений и хранения также поддерживает изменение этого свойства с помощью
ALTER TABLE ... SET ("partition.retention_count" = "N"). До версии 4.1.4 эта операцияALTERотклонялась или не давала эффекта в режиме с разделением вычислений и хранения.
Определения понятий
- Историческая партиция: партиция, верхняя граница которой меньше или равна текущему времени.
- Текущая или будущая партиция: партиция, нижняя граница которой больше или равна текущему времени.
- Сравнение значений партиций: поскольку партиции RANGE никогда не перекрываются, выражение «значение партиции A больше значения партиции B» эквивалентно выражению «нижняя граница партиции A больше верхней границы партиции B», которое также эквивалентно выражению «верхняя граница партиции A больше верхней границы партиции B».
Пример
create table auto_recycle(
    k0 datetime(6) not null
)
AUTO PARTITION BY RANGE (date_trunc(k0, 'day')) ()
DISTRIBUTED BY HASH(`k0`) BUCKETS 1
properties(
    "partition.retention_count" = "3"
);
Такая конфигурация означает, что сохраняются только 3 исторические партиции с наибольшими значениями дат. Пусть текущая дата равна 2025-10-21, а данные вставляются за каждый день с 2025-10-16 по 2025-10-23. После одного цикла очистки остаётся 6 партиций, как показано ниже:
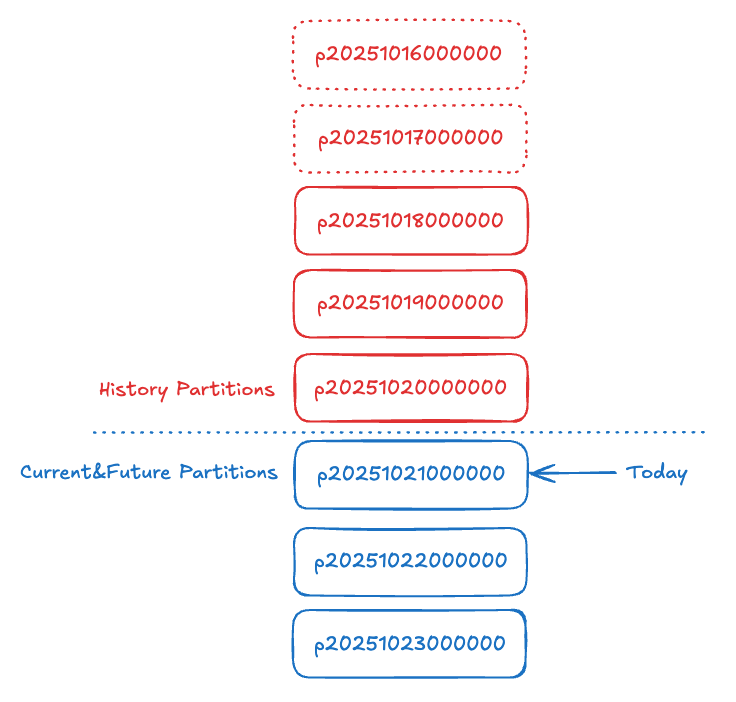
Список оставшихся партиций:
- p20251018000000
- p20251019000000
- p20251020000000 (эта партиция и партиции выше: сохраняются только три исторические партиции)
- p20251021000000 (эта партиция и партиции ниже: текущие и будущие партиции остаются без изменений)
- p20251022000000
- p20251023000000
Совместное использование с автоматическим распределением по бакетам
Только AUTO RANGE PARTITION можно использовать совместно с функцией автоматического распределения по бакетам.
При использовании этого сочетания Doris предполагает, что данные добавляются в таблицу в хронологическом порядке и каждая загрузка затрагивает только одну партицию. Поэтому это сочетание рекомендуется только для таблиц с инкрементальной пакетной загрузкой.
Если способ загрузки данных не соответствует описанной выше модели и одновременно используются автоматическое партиционирование и автоматическое распределение по бакетам, число бакетов в новых партициях может оказаться крайне неудачным, что может существенно повлиять на производительность запросов.
Управление партициями
После включения автоматического партиционирования можно точно находить партиции с помощью следующих двух средств:
- Функция
auto_partition_name: сопоставляет значение столбца партиционирования с именем партиции. - Табличная функция
partitions: получает подробные сведения о партиции по её имени.
Продолжая пример с таблицей DAILY_TRADE_VALUE, после вставки данных выполним запрос, чтобы найти партицию, к которой относится конкретная запись:
select * from partitions("catalog"="internal","database"="optest","table"="DAILY_TRADE_VALUE") where PartitionName = auto_partition_name('range', 'year', '2008-02-03');
+-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+-----------+------------+-------------------------+-----------+--------------------+--------------+
| PartitionId | PartitionName   | VisibleVersion | VisibleVersionTime  | State  | PartitionKey | Range                                                                          | DistributionKey | Buckets | ReplicationNum | StorageMedium | CooldownTime        | RemoteStoragePolicy | LastConsistencyCheckTime | DataSize  | IsInMemory | ReplicaAllocation       | IsMutable | SyncWithBaseTables | UnsyncTables |
+-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+-----------+------------+-------------------------+-----------+--------------------+--------------+
|      127095 | p20080101000000 |              2 | 2024-11-14 17:29:02 | NORMAL | TRADE_DATE   | [types: [DATEV2]; keys: [2008-01-01]; ..types: [DATEV2]; keys: [2009-01-01]; ) | TRADE_DATE      |      10 |              1 | HDD           | 9999-12-31 23:59:59 |                     | \N                       | 985.000 B |          0 | tag.location.default: 1 |         1 |                  1 | \N           |
+-------------+-----------------+----------------+---------------------+--------+--------------+--------------------------------------------------------------------------------+-----------------+---------+----------------+---------------+---------------------+---------------------+--------------------------+-----------+------------+-------------------------+-----------+--------------------+--------------+
Этот подход позволяет точно выбрать идентификатор и значение каждой партиции для последующих операций над конкретными партициями (например, insert overwrite partition).
Подробное описание синтаксиса:
Примечания
| Примечание | Описание |
|---|---|
| Поддержка партиционирования по нескольким столбцам | AUTO LIST PARTITION поддерживает партиционирование по нескольким столбцам с тем же синтаксисом, что и обычное партиционирование LIST. |
| Партиции, созданные при неудачных загрузках, не очищаются автоматически | Если при вставке или загрузке данных создаются партиции, но вся загрузка не завершается (завершается ошибкой или отменяется), созданные партиции не удаляются автоматически. |
| Использование аналогично обычным партициям | Для таблицы, использующей AUTO PARTITION, меняется только способ создания партиций: они создаются автоматически вместо создания вручную. В остальном использование таблицы и её партиций не отличается от таблиц без AUTO PARTITION. |
| Ограничение максимального количества партиций | Максимальное количество партиций в таблице определяется параметром max_auto_partition_num в конфигурации FE. Настройте его по необходимости, чтобы избежать случайного создания слишком большого количества партиций. |
| Интервал опроса при отправке данных | При загрузке данных в таблицу AUTO PARTITION интервал опроса, с которым Coordinator отправляет данные, отличается от интервала для обычных таблиц. Он определяется параметром olap_table_sink_send_interval_auto_partition_factor в конфигурации BE. После включения memtable на узле sink (enable_memtable_on_sink_node = true) эта переменная не действует. |
| Поведение INSERT OVERWRITE | Особенности поведения таблиц AUTO PARTITION при вставке данных с помощью insert-overwrite описаны в документации INSERT OVERWRITE. |
| Конфликты метаданных могут приводить к сбоям загрузки | Если при создании партиций в ходе загрузки над таблицей выполняются другие операции с метаданными (например, Schema Change или Rebalance), загрузка может завершиться ошибкой. |