Оптимизации, лежащие в основе тестов производительности
Обзор
Apache Doris прошёл путь от инвертированного текстового поиска в 2.x к разделению хранения и вычислений в 3.x, а затем к векторной индексации в 4.x, полноценно вступив в эпоху аналитики данных с ИИ. Эта статья предназначена для следующих читателей:
- Архитекторов и разработчиков, которые хотят понять, почему векторная индексация Doris 4.x достигает одного из лучших в отрасли уровней производительности.
- Специалистов, принимающих технические решения и оценивающих векторные базы данных, которым важно понять причины различий в производительности Doris и специализированных векторных баз данных.
- Инженеров по эксплуатации и производительности, которые планируют настраивать поиск ANN в Doris.
Статья посвящена двум основным этапам векторного поиска:
| Этап | Основная цель | Основные оптимизации |
|---|---|---|
| Индексация | Ускорить построение индекса без потери качества | Многоуровневое шардирование, двухуровневый параллелизм, вычисление расстояний с помощью SIMD |
| Выполнение запросов | Контролировать задержку P99 при большом числе одновременных запросов | Prepare Statement, Index Only Scan, виртуальные столбцы, параллелизм Scan, глобальная отложенная материализация TopN |
Этап индексации
Производительность на этапе индексации тесно связана с гиперпараметрами индекса: чем выше качество, тем медленнее построение. Doris оптимизирует процесс загрузки данных, существенно повышая пропускную способность загрузки и сохраняя высокое качество индекса.
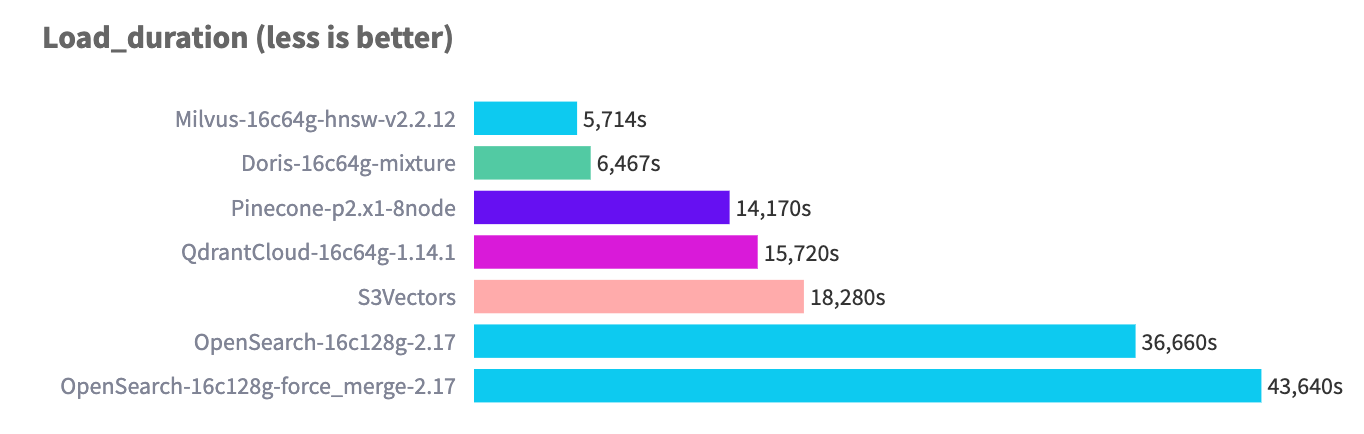
При размерности 768 и объёме 10M строк производительность загрузки Doris достигает одного из лучших в отрасли уровней:
Многоуровневое шардирование
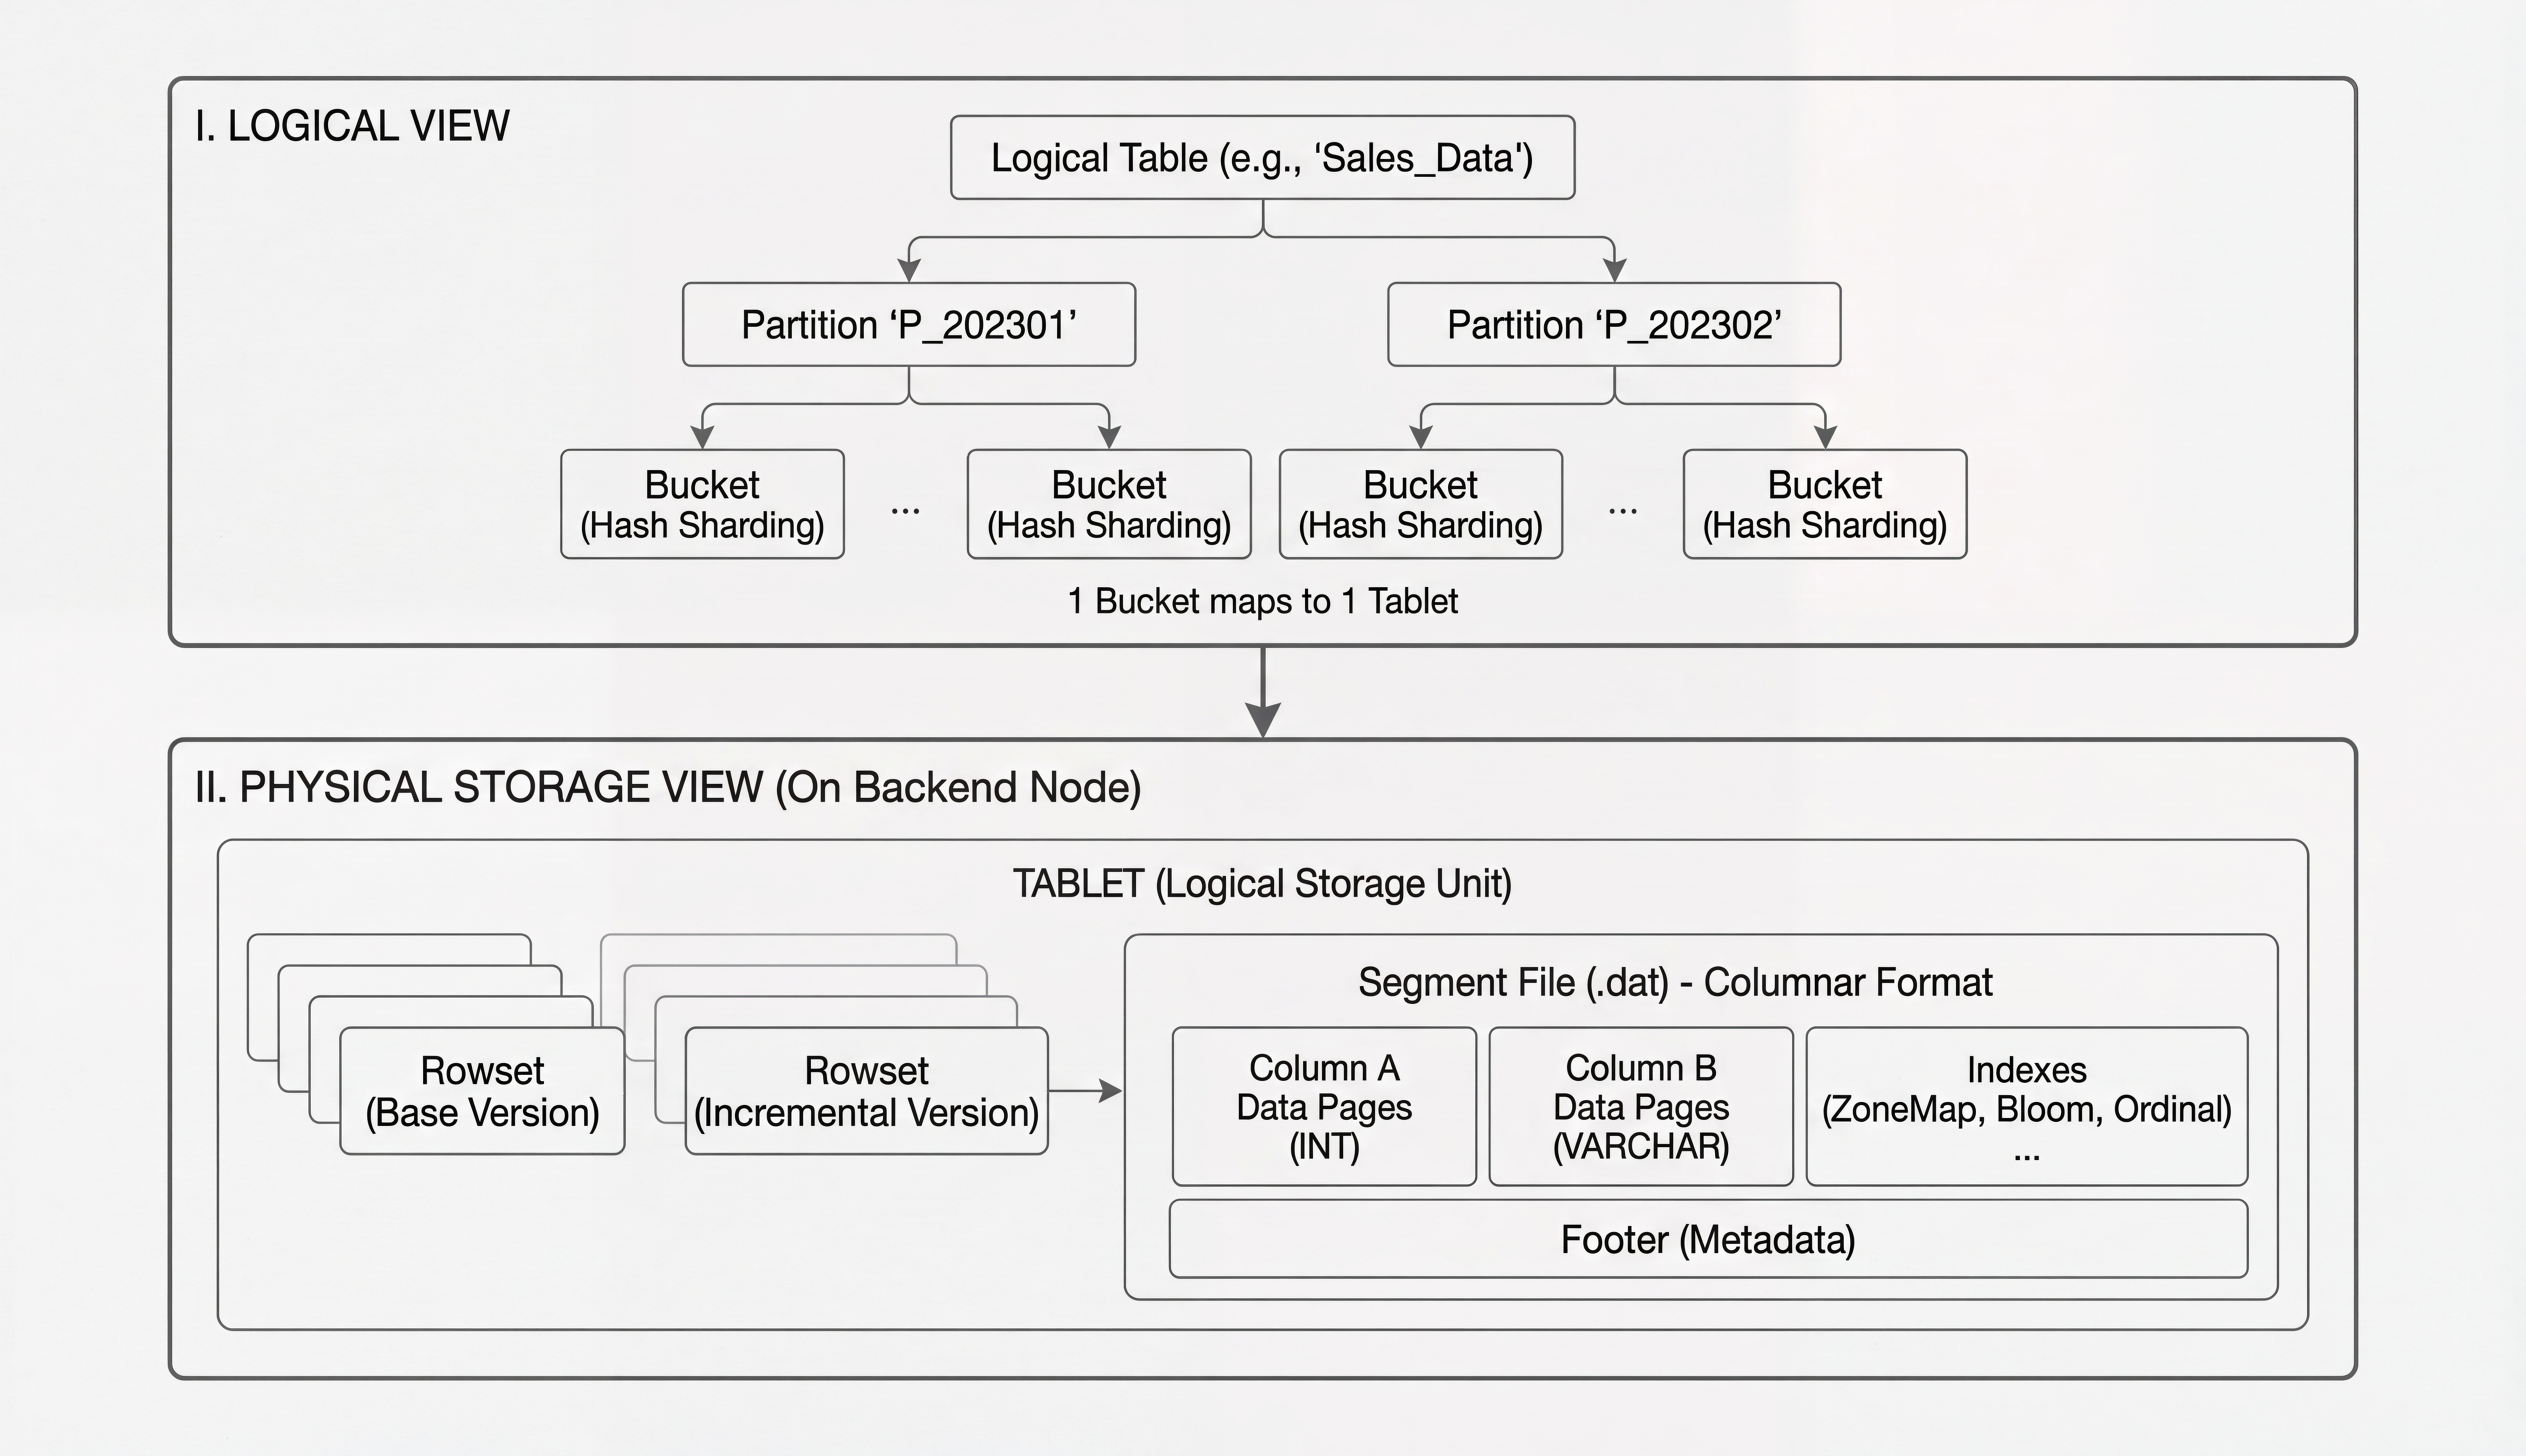
Внутренние таблицы Doris изначально распределены. При выполнении запросов или загрузке данных пользователи видят лишь одну логическую таблицу (Table), а ядро Doris автоматически создаёт физические шарды в соответствии с определением таблицы и направляет данные в соответствующие tablet на BE на основе ключа партиционирования и ключа бакетирования.
Связи между уровнями представлены ниже:
| Уровень | Роль |
|---|---|
| Table | Логическая таблица, которую видит пользователь |
| Tablet | Физический шард, соответствующий требованиям по объёму данных |
| Rowset | Единица управления версиями, создаваемая каждой транзакцией загрузки данных в tablet |
| Segment | Файл в составе rowset, в котором непосредственно хранятся данные. Индекс ANN работает на уровне segment |
Векторные индексы, такие как HNSW, зависят от нескольких ключевых гиперпараметров. Эти параметры напрямую определяют качество индекса и производительность запросов и обычно дают оптимальные результаты только при фиксированном объёме данных.
Многоуровневое шардирование Doris отделяет «параметры индекса» от «общего объёма данных таблицы»: пользователям не нужно перестраивать индекс из-за роста общего объёма данных. Достаточно учитывать размер каждого загружаемого пакета и соответствующие настройки параметров.
По результатам измерений получены следующие эмпирические параметры индекса HNSW для разных размеров пакетов:
| batch_size | max_degree | ef_construction | ef_search | recall@100 |
|---|---|---|---|---|
| 250000 | 100 | 200 | 50 | 89% |
| 250000 | 100 | 200 | 100 | 93% |
| 250000 | 100 | 200 | 150 | 95% |
| 250000 | 100 | 200 | 200 | 98% |
| 500000 | 120 | 240 | 50 | 91% |
| 500000 | 120 | 240 | 100 | 94% |
| 500000 | 120 | 240 | 150 | 96% |
| 500000 | 120 | 240 | 200 | 99% |
| 1000000 | 150 | 300 | 50 | 90% |
| 1000000 | 150 | 300 | 100 | 93% |
| 1000000 | 150 | 300 | 150 | 96% |
| 1000000 | 150 | 300 | 200 | 98% |
Иными словами, пользователям достаточно учитывать «объём данных в каждом загружаемом пакете» и подбирать под него параметры индекса, чтобы получать стабильную производительность запросов при сохранении качества индекса.
Высокопроизводительное построение индекса
Параллельное построение индекса высокого качества
Для ускорения построения индекса Doris использует «двухуровневый параллелизм»:
- Параллелизм на уровне кластера: параллельное построение на нескольких узлах BE.
- Параллелизм внутри узла: в каждом BE расстояния для сгруппированных данных из одного пакета вычисляются в нескольких потоках, что ускоряет построение структуры данных индекса.
Наряду с высокой скоростью Doris повышает качество индекса благодаря объединению данных в пакеты в памяти: если при фиксированном общем числе векторов пакеты слишком малы и индекс пополняется слишком часто, структура графа становится разреженной, а полнота поиска снижается.
Например, для векторных данных 768D / 10M:
- При построении индекса за 10 пакетов полнота поиска составляет около 99%.
- При построении индекса за 100 пакетов полнота поиска может снизиться примерно до 95%.
Объединяя данные в пакеты в памяти, Doris лучше балансирует потребление памяти и качество графа при тех же гиперпараметрах, избегая ухудшения качества из-за чрезмерного дробления на пакеты.
Вычисление расстояний с помощью SIMD
Основные затраты при построении индекса ANN приходятся на массовое вычисление расстояний — типичную задачу с высокой нагрузкой на CPU. Doris выполняет эти вычисления на узлах BE. Соответствующая реализация написана на C++ и в полной мере использует автоматическую и ручную векторизацию Faiss.
Рассмотрим расстояние L2. Faiss задействует автоматическую векторизацию через макросы с директивами компилятора:
FAISS_PRAGMA_IMPRECISE_FUNCTION_BEGIN
float fvec_L2sqr(const float* x, const float* y, size_t d) {
    size_t i;
    float res = 0;
    FAISS_PRAGMA_IMPRECISE_LOOP
    for (i = 0; i < d; i++) {
        const float tmp = x[i] - y[i];
        res += tmp * tmp;
    }
    return res;
}
FAISS_PRAGMA_IMPRECISE_FUNCTION_END
Макросы FAISS_PRAGMA_IMPRECISE_* указывают компилятору выполнить автоматическую векторизацию:
#define FAISS_PRAGMA_IMPRECISE_LOOP \
    _Pragma("clang loop vectorize(enable) interleave(enable)")
Одновременно Faiss использует инструкции _mm* / _mm256* / _mm512* внутри условных блоков #ifdef SSE3/AVX2/AVX512F для явной векторизации. В сочетании с шаблонами ElementOpL2 / ElementOpIP (реализующими поэлементные операции для L2 и скалярного произведения соответственно) и специализациями по размерности fvec_op_ny_D{1,2,4,8,12} это обеспечивает:
- Пакетную обработку нескольких образцов (например, 8 или 16) с транспонированием матриц в регистрах (например,
transpose_8x2/16x4/...) для повышения локальности доступа. - Инструкции FMA (например,
_mm512_fmadd_ps), объединяющие умножение и сложение для сокращения числа инструкций. - Горизонтальное суммирование для быстрого получения скалярного результата.
- Ветвления с масками для обработки оставшихся элементов, число которых не кратно 4/8/16.
Эти оптимизации эффективно сокращают затраты на инструкции и доступ к памяти при вычислении расстояний, значительно повышая пропускную способность построения индекса.
Этап выполнения запросов
Поисковые сценарии крайне чувствительны к задержкам. При десятках миллионов строк данных и большом числе одновременных запросов задержку P99 обычно требуется удерживать ниже 500 мс. Это предъявляет повышенные требования к оптимизатору Doris, движку выполнения и реализации индекса.
Тесты без дополнительной настройки показывают, что производительность запросов Doris достигла уровня распространённых специализированных векторных баз данных. На рисунке ниже Doris сравнивается с другими базами данных, поддерживающими векторный поиск, на наборе данных Performance768D10M. Данные для других баз данных получены с помощью открытого фреймворка VectorDBBench от Zilliz:
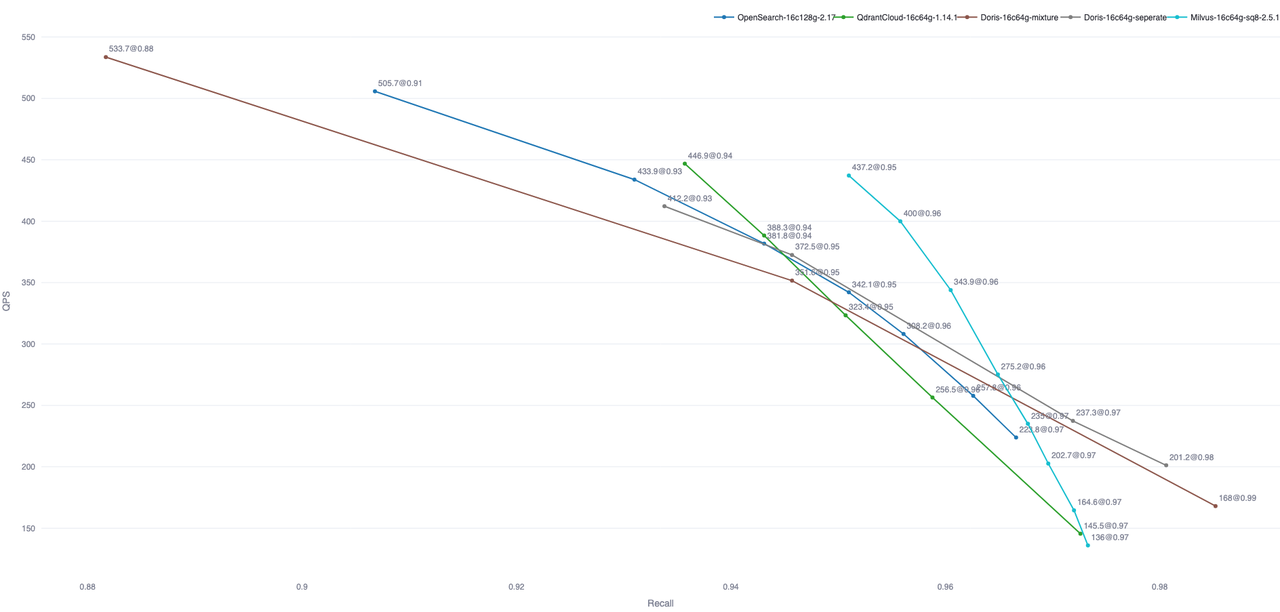
Примечание: на рисунке приведены результаты тестов без дополнительной настройки лишь для некоторых баз данных. Производительность запросов OpenSearch и Elastic Cloud можно дополнительно повысить, оптимизировав количество файлов индекса.
Оптимизации на этапе выполнения запросов подчинены одной основной цели: устранить избыточные вычисления и ненужный дисковый ввод-вывод и добиться максимальной производительности при одновременной обработке запросов. Далее описаны конкретные методы:
Prepare Statement
В традиционном процессе выполнения Doris проходит полный цикл оптимизации (синтаксический разбор, семантический анализ, RBO, CBO) для каждого SQL-оператора. Это необходимо в общих сценариях OLAP, однако для простых и часто повторяющихся запросов, характерных для поиска, такой подход создаёт заметные дополнительные затраты.
Doris 4.0 расширяет возможности Prepare Statement: теперь поддерживаются не только точечные запросы, но и все типы SQL, включая векторный поиск. Основные идеи:
- Разделение компиляции и выполнения
- На этапе Prepare разбор, семантический анализ и оптимизация выполняются один раз, после чего создаётся логический план (Logical Plan), пригодный для повторного использования.
- На этапе Execute подставляются только фактические параметры и непосредственно выполняется сформированный план, полностью минуя оптимизатор.
- Кеш планов
- Возможность повторного использования плана определяется по отпечатку SQL (нормализованный SQL + версия схемы).
- Если значения параметров отличаются, но структура остаётся прежней, план можно использовать напрямую, избегая повторной оптимизации.
- Проверка версии схемы
- Для обеспечения корректности плана версия схемы таблицы проверяется во время выполнения.
- Если схема не изменилась, план используется повторно. Если изменилась, план автоматически признаётся недействительным и подготавливается заново.
- Пропуск оптимизатора даёт существенное ускорение
- Execute больше не запускает RBO/CBO, и временные затраты на оптимизатор практически полностью устраняются.
- Для шаблонных запросов, таких как векторный поиск, Prepare может значительно сократить общее время выполнения.
Index Only Scan
Векторный индекс Doris реализован как присоединённый индекс. Присоединёнными индексами легко управлять, их удобно строить асинхронно, но они также создают сложности с производительностью: как избежать избыточных вычислений и ненужного ввода-вывода.
Помимо идентификаторов подходящих строк, индекс ANN может возвращать расстояния между векторами. Чтобы эффективно использовать эту дополнительную информацию, движок выполнения досрочно завершает вычисление выражений, связанных с расстояниями, в операторе Scan. Doris делает это автоматически с помощью механизма «виртуальных столбцов» и использует Ann Index Only Scan для полного устранения операций чтения, связанных с вычислением расстояний.
Прямолинейный процесс: Scan передаёт предикат на уровень индекса, индекс возвращает идентификаторы строк, Scan читает страницы данных по этим идентификаторам, затем вычисляет выражение и передаёт выше N строк результата.
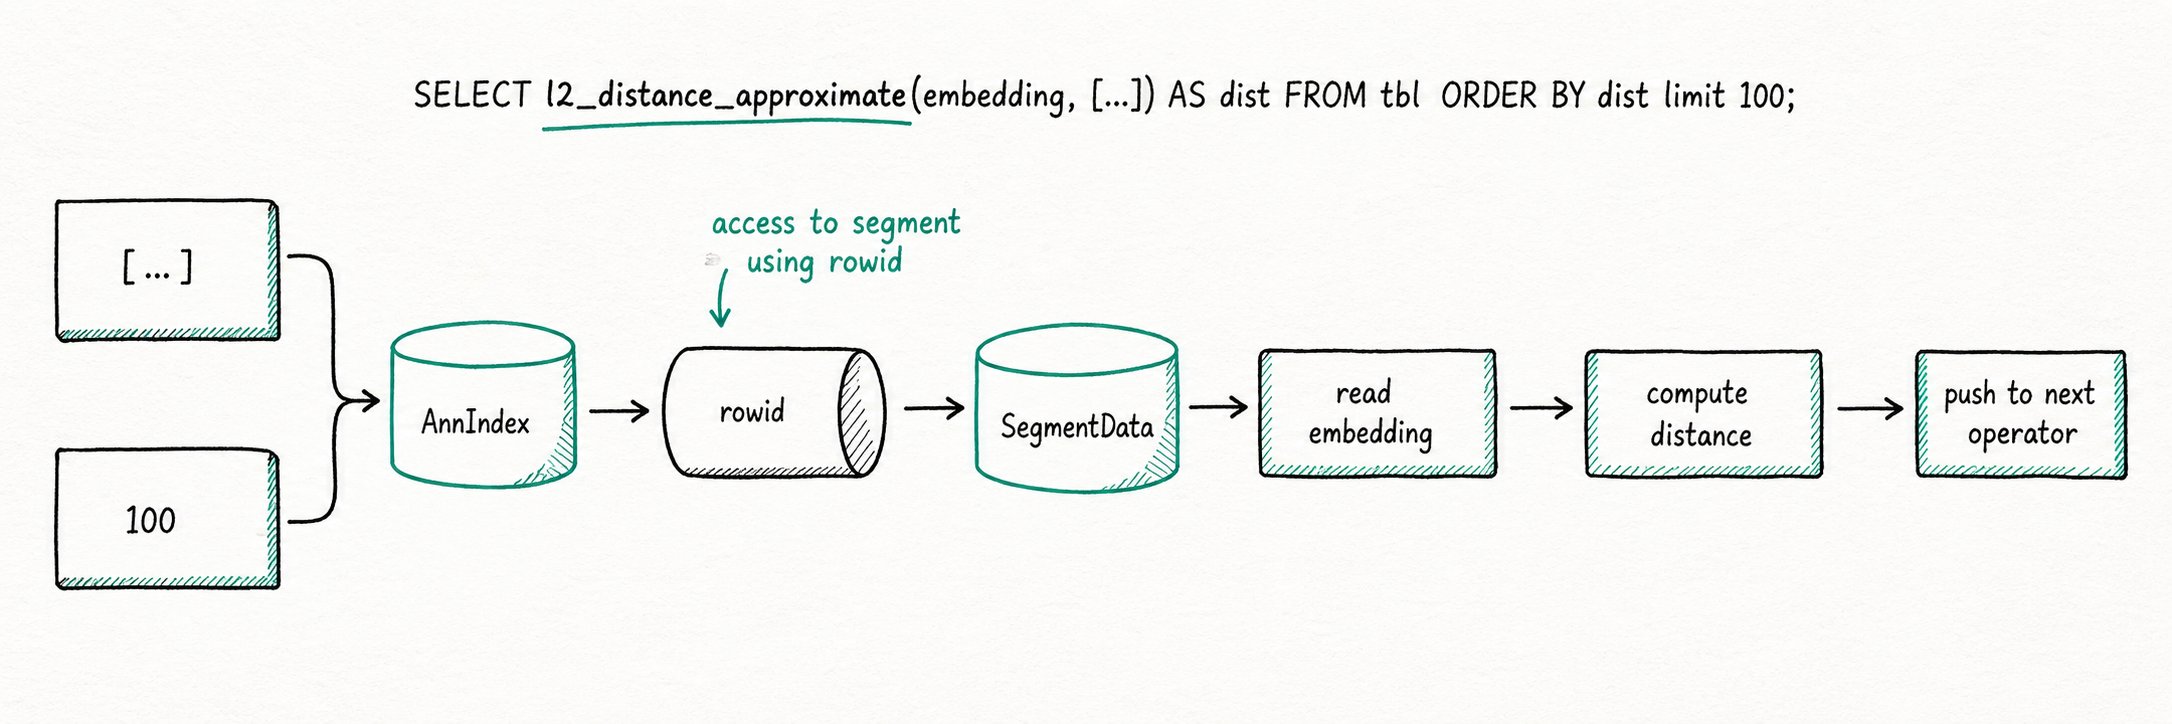
С применением Index Only Scan:
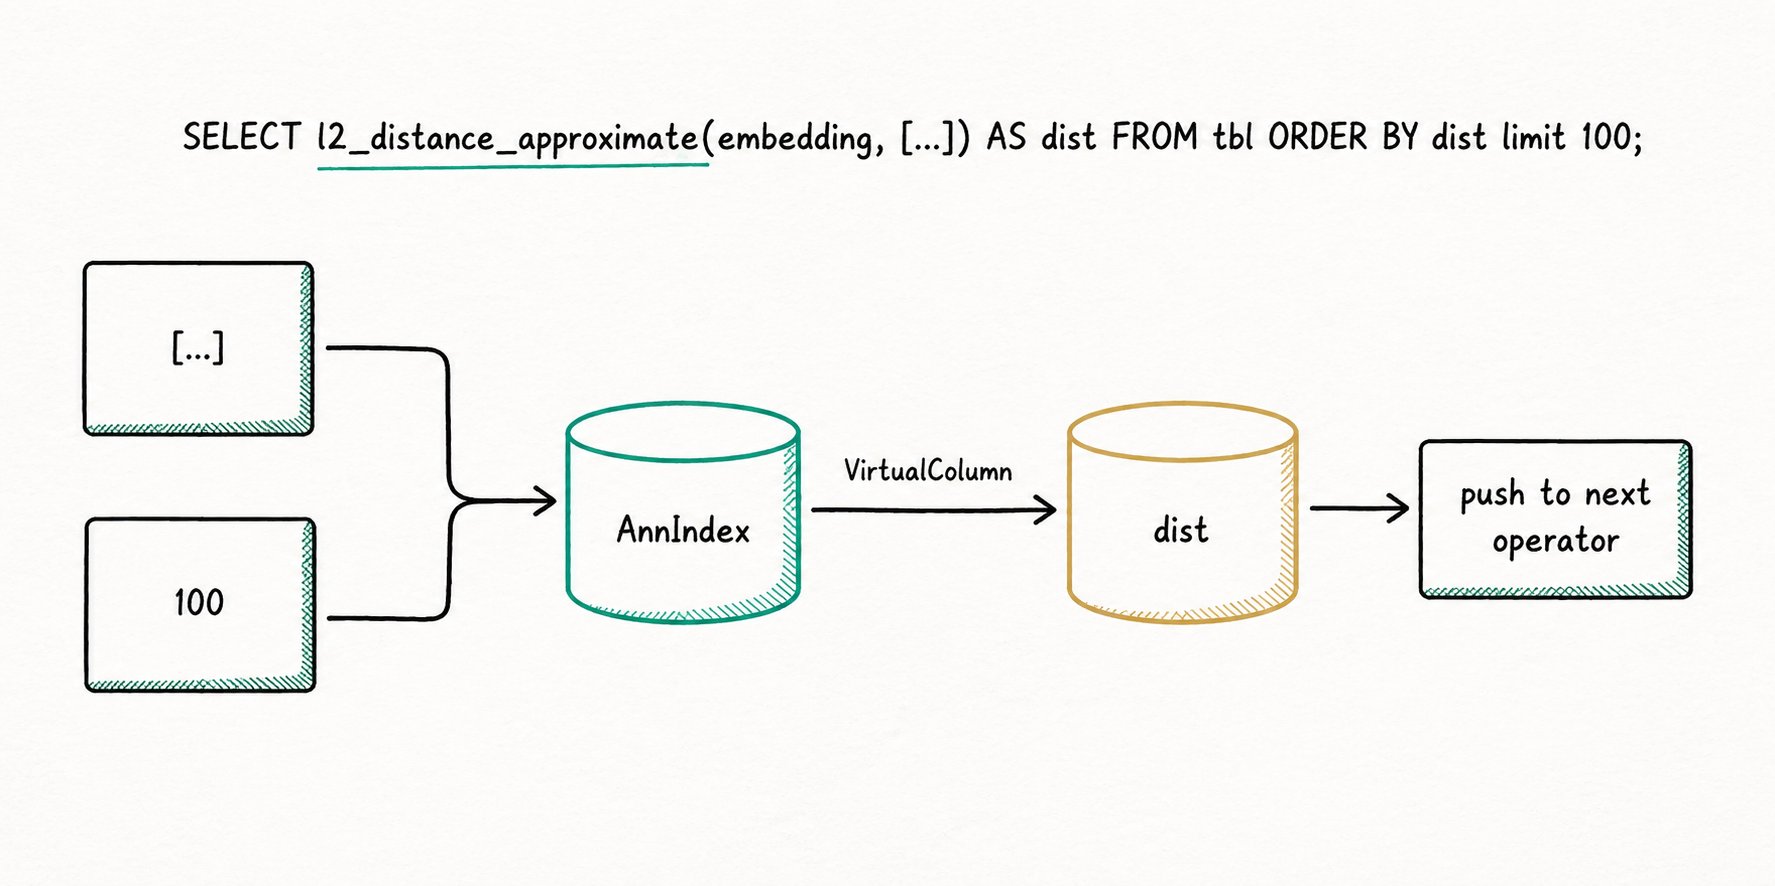
Например:
SELECT l2_distance_approximate(embedding, [...]) AS dist
FROM tbl
ORDER BY dist
LIMIT 100;
В ходе выполнения больше не требуется обращаться к файлам данных.
Типы запросов, поддерживаемые Index Only Scan
Помимо Ann TopN Search, аналогичные оптимизации используются для Range Search и Compound Search, поддерживающих ускорение с помощью индекса. Range Search сложнее, чем TopN: возможность возврата dist из индекса зависит от операции сравнения. В таблице ниже обобщены типы запросов, связанные с Ann Index Only Scan:
| № | Шаблон | Использует IndexScan | Основная причина |
|---|---|---|---|
| Sql1 | Range + proj, dist <= 10 | True | Индекс может вернуть dist, а виртуальный столбец для cse позволяет избежать повторного вычисления dist в proj |
| Sql2 | Range + no-proj, dist <= 10 | True | Индекс может вернуть dist |
| Sql3 | Range + proj, dist > 10 | False | Индекс не может вернуть dist, а proj требует dist, поэтому embedding необходимо прочитать повторно |
| Sql4 | Range + proj, dist > 10, proj не требует dist | True | proj не требует dist, поэтому повторно читать embedding не нужно |
| Sql5 | TopN | True | Индекс возвращает dist, а виртуальный слот передаётся выше в proj |
| Sql6 | TopN + IndexFilter | True | Чтение столбца comment уже оптимизировано сканированием инвертированного индекса, а embedding не читается |
| Sql7 | TopN + Range | True | Сочетание Sql1 и Sql5 |
| Sql8 | TopN + Range + IndexFilter | True | Сочетание Sql6 и Sql7 |
| Sql9 | TopN + Range + CommonFilter (dist < 10) | False | Из-за оставшегося общего фильтра embedding всё ещё материализуется (низкий ROI, пока не оптимизировано) |
| Sql10 | Вариант Sql9 (dist > 10) | False | Индекс не может вернуть embedding, поэтому для вычисления abs его необходимо материализовать |
| Sql11 | Вариант Sql9 (array_size(embedding) > 10) | False | array_size требует материализации embedding |
Полный SQL с подробными комментариями приведён ниже:
-- Sql1
-- Range + proj
-- The Ann index can return dist, so dist does not need to be computed again.
-- At the same time, virtual column for cse avoids the dist computation in proj.
-- IndexScan: True
select id, dist(embedding, [...]) from tbl where dist <= 10;

-- Sql2
-- Range + no-proj
-- The Ann index can return dist, so dist does not need to be computed again.
-- IndexScan: True
select id from tbl where dist <= 10 order by id limit N;

-- Sql3
-- Range + proj + no-dist-from index
-- The Ann index cannot return dist (the index can only update the rowid map).
-- Since proj requires dist to be returned, embedding must be re-read.
-- IndexScan: False
select id, dist(embedding, [...]) from tbl where dist > 10;

-- Sql4
-- Range + proj + no-dist-from index
-- The Ann index cannot return dist (the index can only update the rowid map).
-- However, proj does not need dist, so embedding does not need to be re-read.
-- IndexScan: True
select id from tbl where dist > 10;

-- Sql5
-- TopN
-- AnnIndex returns dist, and virtual slot for cse ensures that the dist from the index is passed up to proj,
-- so the embedding column does not need to be read.
-- IndexScan: True
select id[, dist(embedding, [...])] from tbl order by dist(embedding, [...]) asc limit N;

-- Sql6
-- TopN + IndexFilter
-- 1. The comment column does not need to be read; the inverted index scan has already done this optimization.
-- 2. The embedding column does not need to be read, for the same reason as Sql5.
-- IndexScan: True
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql7
-- TopN + Range
-- IndexScan: True, because this is a combination of Sql1 and Sql5.
select id[, dist(embedding, [...])] from tbl where dist(embedding, [...]) > 10 order by dist(embedding, [...]) limit N;

-- Sql8
-- TopN + Range + IndexFilter
-- IndexScan: True, because this is a combination of Sql7 and Sql6.
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql9
-- TopN + Range + CommonFilter
-- The key points here: 1. dist < 10, not dist > 10; 2. the common filter does not read embedding directly, but reads dist.
-- The Ann index can return dist, and virtual slot ref for cse ensures that all reads of dist refer to the same column.
-- In this case, although Ann TopN cannot be applied, in theory the embedding column does not need to be materialized at any point.
-- However, in practice, embedding is still materialized, because whether a column can skip reading is currently judged by whether predicates on this column still have residuals;
-- the common filter itself cannot be eliminated, so the current code still considers it necessary to materialize the column.
-- The ROI of this optimization is low, so it is not done.
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) < 10 AND abs(dist(embedding) + 10) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql10
-- A variant of Sql9: dist < 10 becomes dist > 10. In this case the index cannot return embedding,
-- so embedding must be materialized in order to compute abs(dist(embedding, [...])).
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) > 10 AND abs(dist(embedding) + 10) > 10 ORDER BY dist(embedding, [...]) LIMIT N;

-- Sql11
-- A variant of Sql9: abs(dist(embedding) + 10) > 10 becomes array_size(embedding) > 10. The difference is that array_size forces embedding to be materialized.
-- To compute array_size(embedding, [...]), embedding must be materialized.
-- IndexScan: False
select id[, dist(embedding, [...])] from tbl where comment match_any 'olap' and dist(embedding, [...]) < 10 AND array_size(embedding) > 10 ORDER BY dist(embedding, [...]) LIMIT N;
Виртуальные столбцы для оптимизации общих подвыражений
Index Only Scan в первую очередь решает проблему ввода-вывода и позволяет избежать большого количества случайных чтений embedding. Для дальнейшего устранения избыточных вычислений Doris вводит на уровне вычислений механизм «виртуальных столбцов», который передаёт возвращаемое индексом значение dist исполнителю выражений в виде столбца.
Основные принципы устройства виртуальных столбцов:
- Вводится узел выражения
VirtualSlotRef, представляющий специальный столбец, «вычисляемый во время выполнения»: он материализуется некоторым выражением и может совместно использоваться несколькими выражениями. Его значение вычисляется только один раз, при первом обращении, что устраняет дублирование общих подвыражений (CSE) между Projection и предикатами. - Вводится итератор столбца
VirtualColumnIterator, который материализует возвращаемые индексом расстояния для использования в выражениях, избегая повторных вычислений функций расстояния.
Изначально этот механизм применялся для устранения CSE в запросах, связанных с ANN, а затем был распространён на общие сочетания Projection + Scan + Filter.
Результаты измерений
На наборе данных ClickBench определим 20 сайтов с наибольшим числом переходов из Google:
set experimental_enable_virtual_slot_for_cse=true;

SELECT counterid,
       COUNT(*)               AS hit_count,
       COUNT(DISTINCT userid) AS unique_users
FROM   hits
WHERE  ( UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) = 'GOOGLE.COM'
         OR UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) = 'GOOGLE.RU'
         OR UPPER(regexp_extract(referer, '^https?://([^/]+)', 1)) LIKE '%GOOGLE%' )
       AND ( LENGTH(regexp_extract(referer, '^https?://([^/]+)', 1)) > 3
              OR regexp_extract(referer, '^https?://([^/]+)', 1) != ''
              OR regexp_extract(referer, '^https?://([^/]+)', 1) IS NOT NULL )
       AND eventdate = '2013-07-15'
GROUP  BY counterid
HAVING hit_count > 100
ORDER  BY hit_count DESC
LIMIT  20;
Основное выражение regexp_extract(referer, '^https?://([^/]+)', 1) требует значительных ресурсов CPU и используется в нескольких местах. Сравним результаты при выключенной и включённой оптимизации виртуальных столбцов:
| Состояние | Время |
|---|---|
| Оптимизация выключена | 1.50 с |
Оптимизация включена (set experimental_enable_virtual_slot_for_cse=true) | 0.57 с |
Производительность запроса в целом повышается примерно в 3 раза.
Оптимизация параллелизма Scan
Doris переработал стратегию параллелизма Scan специально для Ann TopN Search.
| Аспект | Прежняя стратегия | Новая стратегия |
|---|---|---|
| Основа определения параллелизма | Число строк (по умолчанию 2,097,152 строки на Scan Task) | Строго одна Scan Task на каждый segment |
| Поведение при работе с векторами высокой размерности | Число строк в одном segment значительно ниже порога, поэтому несколько segment сканируются последовательно | Параллелизм повышается на этапе анализа индекса |
| Влияние обращения к таблице | - | Ann TopN отфильтровывает большую долю строк, поэтому последовательное обращение к таблице не влияет на общую производительность |
Возьмём SIFT 1M: после включения set optimize_index_scan_parallelism=true; время выполнения одиночного запроса TopN сокращается с 230 мс до 50 мс.
Кроме того, в 4.0 введена «динамическая корректировка параллелизма»: перед каждым циклом планирования число задач, которые можно отправить на выполнение, динамически определяется по нагрузке на пул потоков Scan. При высокой нагрузке параллелизм снижается, а при наличии свободных ресурсов — повышается. Это позволяет сбалансировать использование ресурсов и затраты на планирование как при последовательном выполнении запросов, так и при большом числе одновременных запросов.
Глобальная отложенная материализация TopN
Типичный запрос Ann TopN состоит из двух этапов:
- Первый этап: оператор Scan получает через индекс расстояния TopN для каждого segment.
- Второй этап: узел глобальной сортировки объединяет и сортирует TopN отдельных segment, чтобы получить итоговый TopN.
Если проекция возвращает несколько столбцов или содержит объёмные столбцы (например, String), чтение N строк из каждого segment на первом этапе может приводить к большому объёму дискового ввода-вывода. При этом на втором этапе эти строки могут быть отброшены при глобальной сортировке, поскольку они не входят в итоговый TopN. Doris использует «глобальную отложенную материализацию TopN», чтобы свести объём чтения на первом этапе к минимуму.
Рассмотрим следующий пример:
SELECT id, l2_distance_approximate(embedding, [...]) AS dist
FROM tbl
ORDER BY dist
LIMIT 100;
Процесс выполнения:
- Первый этап: каждый segment использует Ann Index Only Scan + виртуальный столбец, чтобы вывести только 100 значений
distи соответствующие имrowid. - Второй этап: если всего имеется M segment, выполняется глобальная сортировка
100 * Mзначенийdistдля получения итогового TopN и соответствующихrowid. - Наконец, оператор Materialize материализует нужные столбцы в соответствующих tablet/rowset/segment на основе этих
rowid.