HNSW
HNSW (Hierarchical Navigable Small World, Malkov & Yashunin, 2016) стал фактическим стандартом высокопроизводительного векторного поиска в реальном времени благодаря высокой полноте и низкой задержке при умеренных затратах ресурсов в промышленной эксплуатации. Apache Doris поддерживает индексы ANN (Approximate Nearest Neighbor, приближённый поиск ближайших соседей) на основе HNSW начиная с версии 4.0. В этой статье рассматриваются принципы работы алгоритма, его параметры и практические аспекты использования и настройки индексов HNSW в промышленном кластере Apache Doris.
Быстрая навигация
- Впервые знакомитесь с HNSW? Начните с разделов До появления HNSW и Иерархический навигируемый малый мир, чтобы понять, как развивался алгоритм.
- Хотите сразу перейти к практике? Откройте раздел HNSW в Apache Doris с примерами создания таблиц, построения индексов и выполнения запросов.
- Важна точность результатов? См. разделы Оптимизация полноты и Тестирование производительности.
- Важны затраты ресурсов? См. раздел Потребление памяти и производительность.
До появления HNSW
Алгоритм HNSW был предложен в статье Эффективный и надёжный приближённый поиск ближайших соседей с использованием иерархических графов навигируемого малого мира. До появления HNSW уже существовало множество алгоритмов приближённого поиска KNN, но у каждого были свои недостатки.
Граф близости
Основные этапы алгоритма на основе графа близости:
- Начать с некоторой точки входа в граф (случайной вершины или вершины, выбранной по определённой стратегии) и итеративно обходить граф.
- На каждом шаге вычислять расстояние между вектором запроса и всеми соседями текущего базового узла, затем выбирать соседа с наименьшим расстоянием в качестве следующего базового узла.
- Поддерживать множество лучших соседей-кандидатов, найденных к текущему моменту.
- Остановиться при выполнении условия остановки (например, если за одну итерацию не найден более близкий узел) и выбрать Top K из множества кандидатов в качестве окончательного результата.
Алгоритм на основе графа близости по сути является приближением графа Делоне, поскольку граф Делоне обладает важным свойством: жадный поиск всегда находит ближайшего соседа.
Однако у такого алгоритма есть два очевидных недостатка:
| Недостаток | Последствие |
|---|---|
| Число итераций на этапе маршрутизации запроса растёт полиномиально с объёмом данных | На больших объёмах данных затраты на выполнение запроса резко возрастают |
| Построить качественный граф близости сложно, часто возникают локальные скопления узлов | Графу не хватает глобальной связности, и до некоторых узлов трудно добраться |
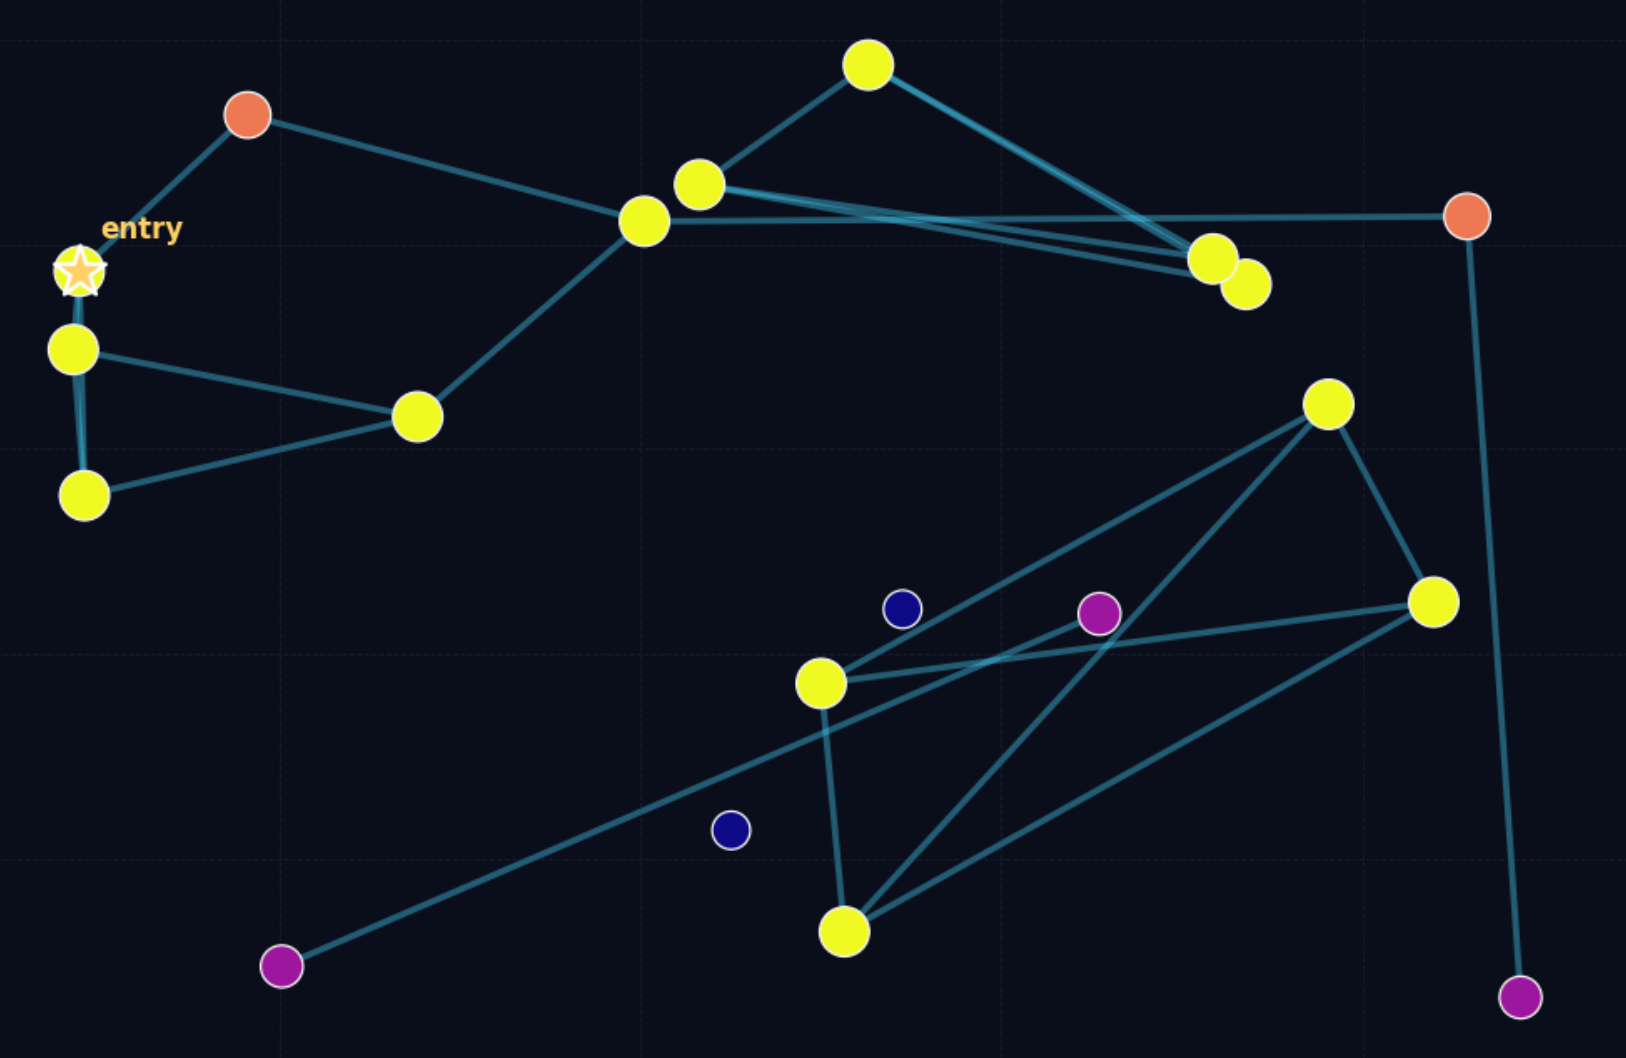
На рисунке выше показан граф близости неудовлетворительного качества: чем темнее точки, тем хуже их связность. Некоторые точки с трудом находят собственных соседей, поэтому на этапе поиска до них трудно добраться.
Навигируемый малый мир
Для решения этих проблем были предложены два подхода:
- Гибридные алгоритмы: перед поиском по графу смежности выполнить предварительное грубое ранжирование, чтобы найти более подходящую точку входа, а затем запустить жадный поиск.
- Структуры навигируемого малого мира: ограничить сложность поиска за счёт хорошей связности и ограничения максимального числа соседей у каждого узла.
NSW (Navigable Small World) использует второй подход.
Модель NSW впервые предложил J. Kleinberg в рамках социальных экспериментов для изучения связей между людьми в обществе, то есть известной теории шести рукопожатий.
В контексте алгоритмов на основе графов K-NN все сети малого мира с логарифмической или полилогарифмической сложностью поиска называют сетями навигируемого малого мира. Существует множество их реализаций, которые здесь не рассматриваются.
В своё время NSW показывал передовую производительность поиска на некоторых наборах данных. Однако из-за того, что его сложность не является строго логарифмической, он уступает другим подходам на таких тестовых наборах, как векторные пространства низкой размерности.
Иерархический навигируемый малый мир
Поиск в алгоритме NSW состоит из двух этапов:
| Этап | Поведение |
|---|---|
| zoom-out (укрупнение масштаба) | В качестве точки входа случайным образом выбирается вершина с низкой степенью. Во время поиска предпочтение отдаётся узлам с высокой степенью, пока среднее расстояние от узла до его соседей не превысит расстояние от этого узла до вектора запроса |
| zoom-in (детализация) | После нахождения подходящего узла с высокой степенью выполняется жадный поиск до получения наилучшего TopN |
Сложность NSW полилогарифмическая, поскольку общее число вычислений расстояния примерно пропорционально произведению «числа переходов x средней степени пройденных вершин». И среднее число переходов, и средняя степень растут логарифмически с объёмом данных, поэтому общая сложность получается полилогарифмической.
HNSW снижает временную сложность запроса до логарифмической за счёт ускорения этапа zoom-out.
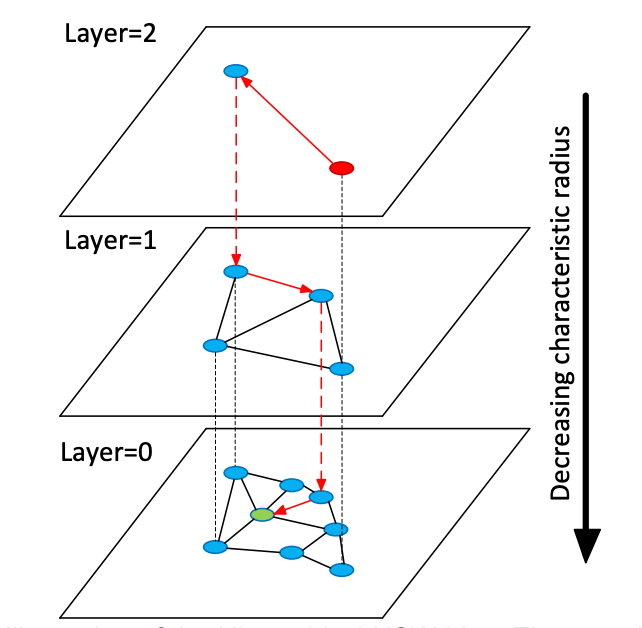
В HNSW «иерархия» означает, что вершины графа NSW распределены по слоям в соответствии с характерным радиусом их рёбер. Поиск выполняется следующим образом:
- Выбрать точку входа на самом верхнем слое.
- Выполнить жадный поиск на текущем слое, чтобы найти ближайшую точку этого слоя.
- Спуститься на слой ниже и повторить жадный поиск.
- Продолжать до достижения нижнего слоя, где формируется окончательный результат.
Поскольку максимальное число связей у каждого узла ограничено на каждом слое, общая временная сложность остаётся логарифмической.
Для построения иерархии при вставке каждого узла HNSW вычисляет его слой l в соответствии с геометрическим распределением, что ограничивает общее число слоёв. HNSW не требует перемешивания данных перед загрузкой (в NSW перемешивание обязательно, иначе качество графа снижается), поскольку случайное назначение слоя при построении индекса само по себе обеспечивает рандомизацию. Благодаря этому HNSW также поддерживает полноценные инкрементальные обновления.
HNSW в Apache Doris
Doris поддерживает построение индексов ANN на основе алгоритма HNSW начиная с версии 4.0.
Построение индекса
Создать индекс ANN можно двумя способами:
| Способ | Момент построения | Преимущества | Недостатки |
|---|---|---|---|
| Указать при создании таблицы | Строится синхронно при создании сегмента во время загрузки данных | Индекс доступен для ускорения запросов сразу после завершения загрузки | Синхронное построение замедляет загрузку, а при компактации индекс многократно перестраивается |
CREATE/BUILD INDEX | Строится асинхронно после загрузки данных | Не влияет на скорость загрузки и упрощает настройку параметров | Пока индекс строится, ускорение ANN недоступно |
Способ 1: указать индекс при создании таблицы
Подходит для стабильных сценариев, когда параметры индекса известны и не требуют частой настройки.
CREATE TABLE sift_1M (
    id int NOT NULL,
    embedding array<float>  NOT NULL  COMMENT "",
    INDEX ann_index (embedding) USING ANN PROPERTIES(
        "index_type"="hnsw",
        "metric_type"="l2_distance",
        "dim"="128"
    )
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
    "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
    "format" = "csv");
Способ 2: CREATE / BUILD INDEX
Подходит для сценариев, требующих гибкой настройки и чувствительных к производительности загрузки данных.
Шаг 1: создайте таблицу без индекса и загрузите данные.
CREATE TABLE sift_1M (
    id int NOT NULL,
    embedding array<float>  NOT NULL  COMMENT ""
) ENGINE=OLAP
DUPLICATE KEY(id) COMMENT "OLAP"
DISTRIBUTED BY HASH(id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
);

INSERT INTO sift_1M
SELECT *
FROM S3(
    "uri" = "https://selectdb-customers-tools-bj.oss-cn-beijing.aliyuncs.com/sift_database.tsv",
    "format" = "csv");
Шаг 2: добавьте определение индекса с помощью CREATE INDEX. На этом этапе существует только определение индекса; сам индекс для имеющихся данных ещё не построен.
CREATE INDEX idx_test_ann ON sift_1M (`embedding`) USING ANN PROPERTIES (
    "index_type"="hnsw",
    "metric_type"="l2_distance",
    "dim"="128"
);

SHOW DATA ALL FROM sift_1M;
Пример вывода:
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| TableName | IndexName | ReplicaCount | RowCount | LocalTotalSize | LocalDataSize | LocalIndexSize | RemoteTotalSize | RemoteDataSize | RemoteIndexSize |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
| sift_1M   | sift_1M   | 1            | 1000000  | 170.001 MB     | 170.001 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
|           | Total     | 1            |          | 170.001 MB     | 170.001 MB    | 0.000          | 0.000           | 0.000          | 0.000           |
+-----------+-----------+--------------+----------+----------------+---------------+----------------+-----------------+----------------+-----------------+
2 rows in set (0.01 sec)
Шаг 3: запустите построение индекса с помощью BUILD INDEX.
BUILD INDEX idx_test_ann ON sift_1M;
BUILD INDEX выполняется асинхронно. Проверить состояние задачи можно с помощью SHOW BUILD INDEX:
SHOW BUILD INDEX WHERE TableName = "sift_1M";
Пример вывода:
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| JobId         | TableName | PartitionName | AlterInvertedIndexes                                                                                                               | CreateTime              | FinishTime              | TransactionId | State    | Msg  | Progress |
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
| 1763603913428 | sift_1M   | sift_1M       | [ADD INDEX idx_test_ann (`embedding`) USING ANN PROPERTIES("dim" = "128", "index_type" = "hnsw", "metric_type" = "l2_distance")],  | 2025-11-20 11:14:55.253 | 2025-11-20 11:15:10.622 | 126128        | FINISHED |      | NULL     |
+---------------+-----------+---------------+------------------------------------------------------------------------------------------------------------------------------------+-------------------------+-------------------------+---------------+----------+------+----------+
DROP INDEX
При настройке может потребоваться проверить разные сочетания параметров. Используйте DROP INDEX для гибкого управления индексами:
ALTER TABLE sift_1M DROP INDEX idx_test_ann;
Выполнение запросов
Индекс ANN поддерживает ускорение как поиска TopN, так и диапазонного поиска.
При высокой размерности векторного столбца сама строка, описывающая вектор запроса, создаёт дополнительные затраты на синтаксический разбор. В промышленной среде, особенно при большом числе параллельных запросов, не выполняйте векторный поиск напрямую через обычные SQL-запросы. Используйте подготовленные выражения, чтобы выполнить синтаксический разбор SQL заранее.
Doris официально предоставляет библиотеку Python для векторного поиска. Она инкапсулирует операции для работы с подготовленными выражениями и включает конвейер преобразования данных, который сразу превращает результаты запроса в pandas DataFrame, упрощая разработку приложений ИИ на основе Doris.
from doris_vector_search import DorisVectorClient, AuthOptions

auth = AuthOptions(
    host="localhost",
    query_port=9030,
    user="root",
    password="",
)

client = DorisVectorClient(database="demo", auth_options=auth)

tbl = client.open_table("sift_1M")

query = [0.1] * 128  # Example 128-dimensional vector

# SELECT id FROM sift_1M ORDER BY l2_distance_approximate(embedding, query) LIMIT 10;
result = tbl.search(query, metric_type="l2_distance").limit(10).select(["id"]).to_pandas()

print(result)
Пример результата выполнения:
       id
0  123911
1   11743
2  108584
3  123739
4   73311
5  124746
6  620941
7  124493
8  177392
9  153178
Оптимизация полноты
Важнейшая метрика векторного поиска — полнота. Показатели производительности имеют смысл только при достижении определённого уровня полноты. На полноту в основном влияют следующие факторы:
- Параметры HNSW на этапе построения индекса (
max_degree,ef_construction) и на этапе выполнения запроса (ef_search) - Квантование векторов индекса
- Размер и количество сегментов
В этом разделе рассматриваются пункты 1 и 3. Квантование векторов описано в других статьях.
Гиперпараметры индекса
Индекс HNSW организует векторы в виде иерархического графа. Этап построения состоит главным образом из трёх шагов:
- Случайное распределение по нескольким слоям: каждый вектор случайным образом назначается нескольким слоям. Верхние слои более разрежены и используются для быстрой навигации.
- Поиск соседей-кандидатов с помощью
ef_construction: на каждом слое HNSW выполняет локальный поиск в ширину с очередью кандидатов, максимальная длина которой равнаef_construction. Чем больше значение, тем точнее выбираются соседи и тем лучше структура графа, но тем дольше длится построение. - Ограничение связей с помощью
max_degree: число соседей у каждого узла ограничивается параметромmax_degree, чтобы граф не становился слишком плотным.
Этап выполнения запроса состоит из двух шагов:
- Жадный поиск на верхних слоях (грубый поиск): начиная с точки входа, жадный поиск проходит верхние слои сверху вниз и быстро приближается к целевой области.
- Поиск в ширину на нижнем слое (детальный поиск): на слое 0 выполняется более тщательное расширение окрестности с очередью кандидатов, максимальная длина которой равна
ef_search.
Назначение трёх основных параметров и связанные с ними компромиссы:
| Параметр | Назначение | Значение по умолчанию | Эффект увеличения |
|---|---|---|---|
max_degree | Число двунаправленных рёбер, хранящихся для каждого узла графа | 32 | Полнота и потребление памяти увеличиваются, производительность запросов снижается |
ef_construction | Максимальная длина очереди кандидатов на этапе построения индекса | 40 | Качество графа улучшается, полнота увеличивается, время построения растёт |
ef_search | Максимальная длина очереди кандидатов на этапе выполнения запроса | 32 | Полнота увеличивается, число вычислений расстояния растёт, задержка запросов и затраты CPU повышаются |
В таблице ниже приведены результаты измерений на наборе данных SIFT_1M:
| max_degree | ef_construction | ef_search | recall@1 | recall@100 |
|---|---|---|---|---|
| 32 | 80 | 32 | 0.955 | 0.75335 |
| 32 | 80 | 64 | 0.98 | 0.88015 |
| 32 | 80 | 96 | 0.995 | 0.9328 |
| 32 | 120 | 32 | 0.96 | 0.7736 |
| 32 | 120 | 64 | 0.975 | 0.89865 |
| 32 | 120 | 96 | 0.99 | 0.94575 |
| 32 | 160 | 32 | 0.955 | 0.78745 |
| 32 | 160 | 64 | 0.98 | 0.9097 |
| 32 | 160 | 96 | 0.995 | 0.95485 |
| 48 | 80 | 32 | 0.985 | 0.85895 |
| 48 | 80 | 64 | 0.99 | 0.9453 |
| 48 | 80 | 96 | 1 | 0.97325 |
| 48 | 120 | 32 | 0.97 | 0.78335 |
| 48 | 120 | 64 | 1 | 0.9089 |
| 48 | 120 | 96 | 1 | 0.95325 |
| 48 | 160 | 32 | 0.975 | 0.79745 |
| 48 | 160 | 64 | 0.995 | 0.9192 |
| 48 | 160 | 96 | 0.995 | 0.9601 |
| 64 | 80 | 32 | 1 | 0.9026 |
| 64 | 80 | 64 | 1 | 0.97025 |
| 64 | 80 | 96 | 1 | 0.9862 |
| 64 | 120 | 32 | 0.985 | 0.8548 |
| 64 | 120 | 64 | 0.99 | 0.94755 |
| 64 | 120 | 96 | 0.995 | 0.97645 |
| 64 | 160 | 32 | 0.97 | 0.80585 |
| 64 | 160 | 64 | 0.99 | 0.91925 |
| 64 | 160 | 96 | 0.995 | 0.96165 |
Как видно, одинакового уровня полноты можно достичь при разных сочетаниях параметров. Например, для целевого значения recall@100 > 95% подходят следующие сочетания:
| max_degree | ef_construction | ef_search | recall@1 | recall@100 |
|---|---|---|---|---|
| 32 | 160 | 96 | 0.995 | 0.95485 |
| 48 | 80 | 96 | 1 | 0.97325 |
| 48 | 120 | 96 | 1 | 0.95325 |
| 48 | 160 | 96 | 0.995 | 0.9601 |
| 64 | 80 | 64 | 1 | 0.97025 |
| 64 | 80 | 96 | 1 | 0.9862 |
| 64 | 120 | 96 | 0.995 | 0.97645 |
| 64 | 160 | 96 | 0.995 | 0.96165 |
Практический способ подбора гиперпараметров:
- Создайте таблицу
table_multi_indexбез индексов с несколькими векторными столбцами (от 2 до 3 векторных столбцов). - Загрузите данные в эту таблицу с помощью Stream Load или другими способами.
- Постройте индексы для всех векторных столбцов с помощью
CREATE INDEXиBUILD INDEX, используя разные сочетания параметров для каждого столбца. - После построения индексов вычислите полноту отдельно для каждого столбца и выберите наиболее подходящее сочетание гиперпараметров.
Число строк, охватываемых индексом
Данные во внутренней таблице Doris организованы иерархически:
| Уровень | Значение |
|---|---|
| Таблица | Понятие верхнего уровня |
| Tablet | Основная единица миграции и перебалансировки данных. Данные таблицы равномерно распределяются по N tablet на основе ключа бакетирования |
| Rowset | Основная единица управления версиями. Каждая загрузка или компактация добавляет новый rowset в tablet |
| Сегмент | Файлы, в которых непосредственно хранятся данные |
Как и инвертированный индекс, векторный индекс также работает на уровне сегментов. Размер сегмента определяется параметрами конфигурации BE write_buffer_size и vertical_compaction_max_segment_size. Во время загрузки и компактации, когда memtable достигает определённого размера, его содержимое сбрасывается в файл сегмента, и для этого сегмента строится векторный индекс (по одному индексу на каждый индексируемый столбец).
Согласно механизму поиска и построения HNSW, для заданного набора параметров индекса объём данных, который он может эффективно охватить, ограничен. Когда объём данных превышает порог, полнота перестаёт соответствовать требованиям.
Эмпирические значения некоторых гиперпараметров и числа строк в сегменте, которое они позволяют охватить:
| max_degree | ef_construction | ef_search | num_segment | recall@100 |
|---|---|---|---|---|
| 32 | 160 | 96 | 1M | 0.95485 |
| 48 | 80 | 96 | 1M | 0.97325 |
| 32 | 160 | 32 | 3M | 0.66983 |
| 128 | 512 | 128 | 3M | 0.9931 |
Выполните
SHOW TABLETS FROM <table>, чтобы посмотреть состояние компактации таблицы. Перейдите по соответствующему URL, чтобы увидеть число сегментов.
Влияние компактации на полноту
Компактация иногда создаёт более крупные сегменты, из-за чего исходные гиперпараметры индекса больше не обеспечивают достаточный охват новых сегментов увеличенного размера.
Рекомендуемый подход: запустите FULL COMPACTION перед выполнением BUILD INDEX. Построение индекса на полностью скомпактированных сегментах даёт сразу два преимущества:
- Стабильная полнота
- Меньшее усиление записи при построении индекса
Производительность запросов
Холодная загрузка файлов индекса
Индекс ANN в Doris реализован на основе библиотеки faiss с открытым исходным кодом от Meta. Индекс HNSW может ускорять запросы только после загрузки всей структуры графа в память.
Прежде чем выполнять большое число параллельных запросов, запустите первый запрос на холодном кеше, чтобы загрузить в память файлы индексов задействованных сегментов. Иначе производительность запросов значительно снизится.
Потребление памяти и производительность
Индекс HNSW без сжатия квантованием занимает примерно в 1.3 раза больше памяти, чем индексируемые векторы.
Например, для набора данных из 1M векторов размерности 128 индексу HNSW FLAT потребуется около 128 x 4 x 1,000,000 x 1.3 ~= 650 MB.
Оценка потребления памяти при разных объёмах данных:
| dim | rows | Оценка объёма памяти |
|---|---|---|
| 128 | 1M | 650 MB |
| 768 | 10M | 48 GB |
| 768 | 100M | 110 GB |
Для обеспечения производительности запросов узлы BE должны располагать достаточным объёмом памяти. Иначе частые операции ввода-вывода индекса приведут к значительному снижению производительности запросов.
Тестирование производительности
Оборудование для тестирования: машина 16C 64GB. Среда тестирования: VectorDBBench. Клиент нагрузки: другая машина 16C.
Типичная схема развёртывания промышленного кластера Doris — раздельное размещение FE и BE, для которого требуются две машины 16C 64GB. В таблице ниже наряду с типичным развёртыванием приведены результаты тестов для совместного размещения FE и BE.
Performance768D1M
Команда тестирования:
NUM_PER_BATCH=1000000 python3.11 -m vectordbbench doris --host 127.0.0.1 --port 9030 --case-type Performance768D1M --db-name Performance768D1M --search-concurrent --search-serial --num-concurrency 10,40,80 --stream-load-rows-per-batch 500000 --index-prop max_degree=128,ef_construction=512 --session-var hnsw_ef_search=128
Сравнение результатов тестирования:
| Doris (FE/BE раздельно) | Doris (FE/BE совместно) | |
|---|---|---|
| Параметры индекса | max_degree=128, ef_construction=512, hnsw_ef_search=128 | max_degree=128, ef_construction=512, hnsw_ef_search=156 |
| Recall@100 | 0.9931 | 0.9929 |
| Параллелизм (клиент) | 10, 40, 80 | 10, 40, 80 |
| QPS в тесте | 163.1567 (10) 606.6832 (40) 859.3842 (80) | 162.3002 (10) 542.3488 (40) 607.7951 (80) |
| Средняя задержка (с) | 0.06123 (10) 0.06579 (40) 0.09281 (80) | 0.06154 (10) 0.07351 (40) 0.13093 (80) |
| Задержка P95 (с) | 0.06560 (10) 0.07747 (40) 0.12967 (80) | 0.06726 (10) 0.08789 (40) 0.18719 (80) |
| Задержка P99 (с) | 0.06889 (10) 0.08618 (40) 0.14605 (80) | 0.06154 (10) 0.07351 (40) 0.13093 (80) |