Обзор алгоритмов векторного квантования и рекомендации по выбору
В этом документе распространённые алгоритмы векторного квантования рассматриваются с теоретической и инженерной точек зрения, а также приводятся рекомендации по выбору с учётом сценариев использования ANN в Apache Doris. В настоящее время Apache Doris использует оптимизированную версию Faiss как основу реализации векторной индексации и поиска ANN, поэтому приведённые ниже описания механизмов SQ/PQ напрямую соответствуют фактическому поведению Doris.
Быстрая навигация
Задачи читателей и соответствующие разделы:
| Задача | Перейти к разделу |
|---|---|
| Понять, зачем нужно квантование | Зачем нужно векторное квантование |
| Быстро выбрать квантователь | Рекомендации по выбору для Doris |
| Разобраться, как работают SQ8/SQ4 | Скалярное квантование (SQ) |
| Понять принципы и преимущества PQ | Продуктовое квантование (PQ) |
| Провести корректное сравнительное тестирование | Что учитывать при тестировании производительности |
| Найти ответы на распространённые вопросы | Часто задаваемые вопросы |
Определения в одном предложении
- Векторное квантование: кодирование высокоточных векторов (например, float32) в представление с пониженной точностью, позволяющее сократить потребление памяти и ускорить поиск ценой допустимого снижения полноты поиска.
- SQ (скалярное квантование): независимое снижение точности каждого измерения.
- PQ (продуктовое квантование): разбиение вектора на несколько подвекторов с последующим кодированием на основе кластеризации в каждом подпространстве.
Зачем нужно векторное квантование
В сценариях ANN (особенно HNSW) индексы часто ограничены доступной памятью. Основная идея квантования состоит в кодировании высокоточных векторов, например float32, в представление с пониженной точностью, чтобы сократить потребление памяти ценой допустимого снижения полноты поиска.
В Doris метод квантования индекса ANN задаётся через quantizer:
| quantizer | Значение | Степень сжатия относительно float32 |
|---|---|---|
flat | Без квантования (максимальное качество, максимальное потребление памяти) | 1x |
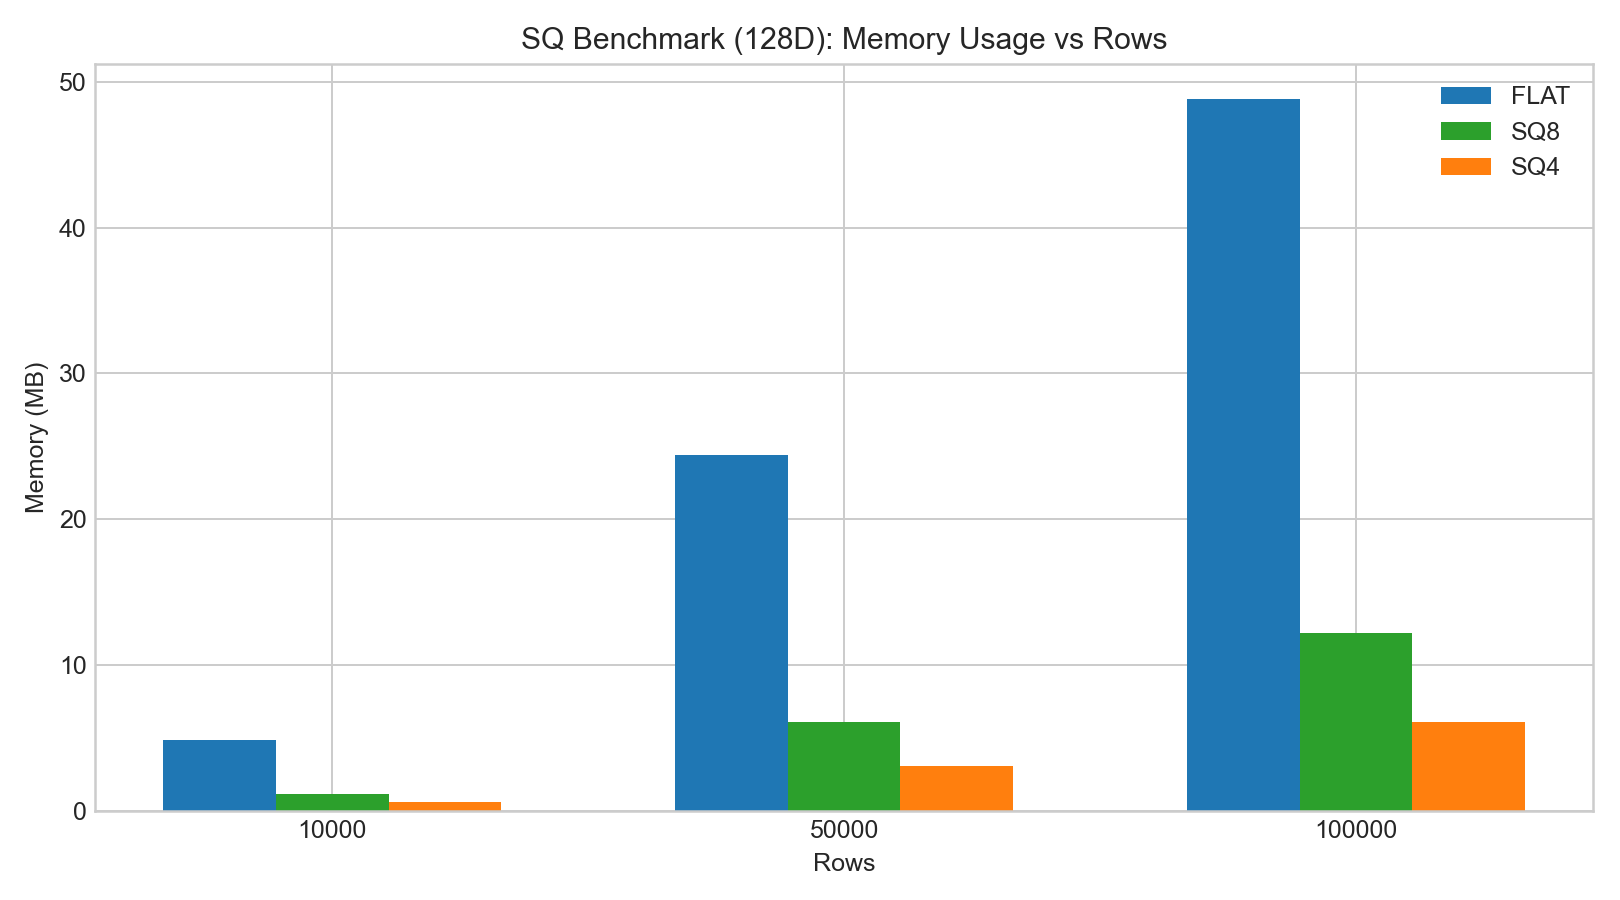
sq8 | 8-битное скалярное квантование | Около 4x |
sq4 | 4-битное скалярное квантование | Около 8x |
pq | Продуктовое квантование | Зависит от pq_m и pq_nbits |
Минимальный пример (HNSW + квантователь):
CREATE TABLE vector_tbl (
    id BIGINT,
    embedding ARRAY<FLOAT>,
    INDEX ann_idx (embedding) USING ANN PROPERTIES (
        "index_type" = "hnsw",
        "metric_type" = "l2_distance",
        "dim" = "768",
        "quantizer" = "sq8"
    )
)
DUPLICATE KEY(id)
DISTRIBUTED BY HASH(id) BUCKETS 8
PROPERTIES ("replication_num" = "3");
Обзор алгоритмов
| Метод | Основная идея | Типичное преимущество | Основные затраты |
|---|---|---|---|
| SQ (скалярное квантование) | Независимое квантование каждого измерения | Значительное сокращение потребления памяти, простота реализации | Затраты на построение выше, чем у FLAT; более сильное сжатие обычно снижает полноту поиска |
| PQ (продуктовое квантование) | Разбиение на подвекторы и квантование по группам | Более удачный баланс сжатия и скорости запросов в распространённых сценариях | Более высокие затраты на обучение и кодирование, параметры требуют настройки |
Скалярное квантование (SQ)
Принцип работы
SQ не меняет размерность вектора. Оно лишь снижает точность числового представления каждого измерения.
Типичное отображение для квантования min-max:
max_code = (1 << b) - 1scale = (max_val - min_val) / max_codecode = round((x - min_val) / scale)
В Faiss используются два основных типа SQ:
| Тип | Способ определения диапазона | Сценарий применения |
|---|---|---|
| Равномерное | Все измерения используют общий набор min/max | Масштабы числовых значений близки во всех измерениях |
| Неравномерное | Статистика собирается отдельно для каждого измерения | Масштабы числовых значений заметно различаются между измерениями; ошибка восстановления меньше |
Характеристики
Преимущества:
- Простая реализация со стабильным поведением.
- Предсказуемая степень сжатия (относительно значений float32: около 4x для
sq8и около 8x дляsq4).
Ограничения:
- В основе по-прежнему лежит разбиение на интервалы с фиксированным шагом.
- Если распределение отдельного измерения явно неравномерно (например, имеет длинный хвост), ошибка увеличивается.
Ключевые фрагменты исходного кода Faiss (SQ)
В оптимизированной реализации Faiss, используемой Doris, при обучении SQ сначала вычисляются минимум и максимум, затем диапазон при необходимости немного расширяется, чтобы снизить риск выхода значений за его пределы на последующем этапе добавления. Упрощённый вариант выглядит так:
void train_Uniform(..., const float* x, std::vector<float>& trained) {
    trained.resize(2);
    float& vmin = trained[0];
    float& vmax = trained[1];
    // Scan samples to obtain min/max
    // Then expand the range based on rs_arg
}
Для неравномерного SQ Faiss вычисляет статистику отдельно для каждого измерения, а не использует единый глобальный диапазон. Обычно это даёт лучшие результаты на данных, в которых масштабы числовых значений заметно различаются между измерениями.
Практические наблюдения
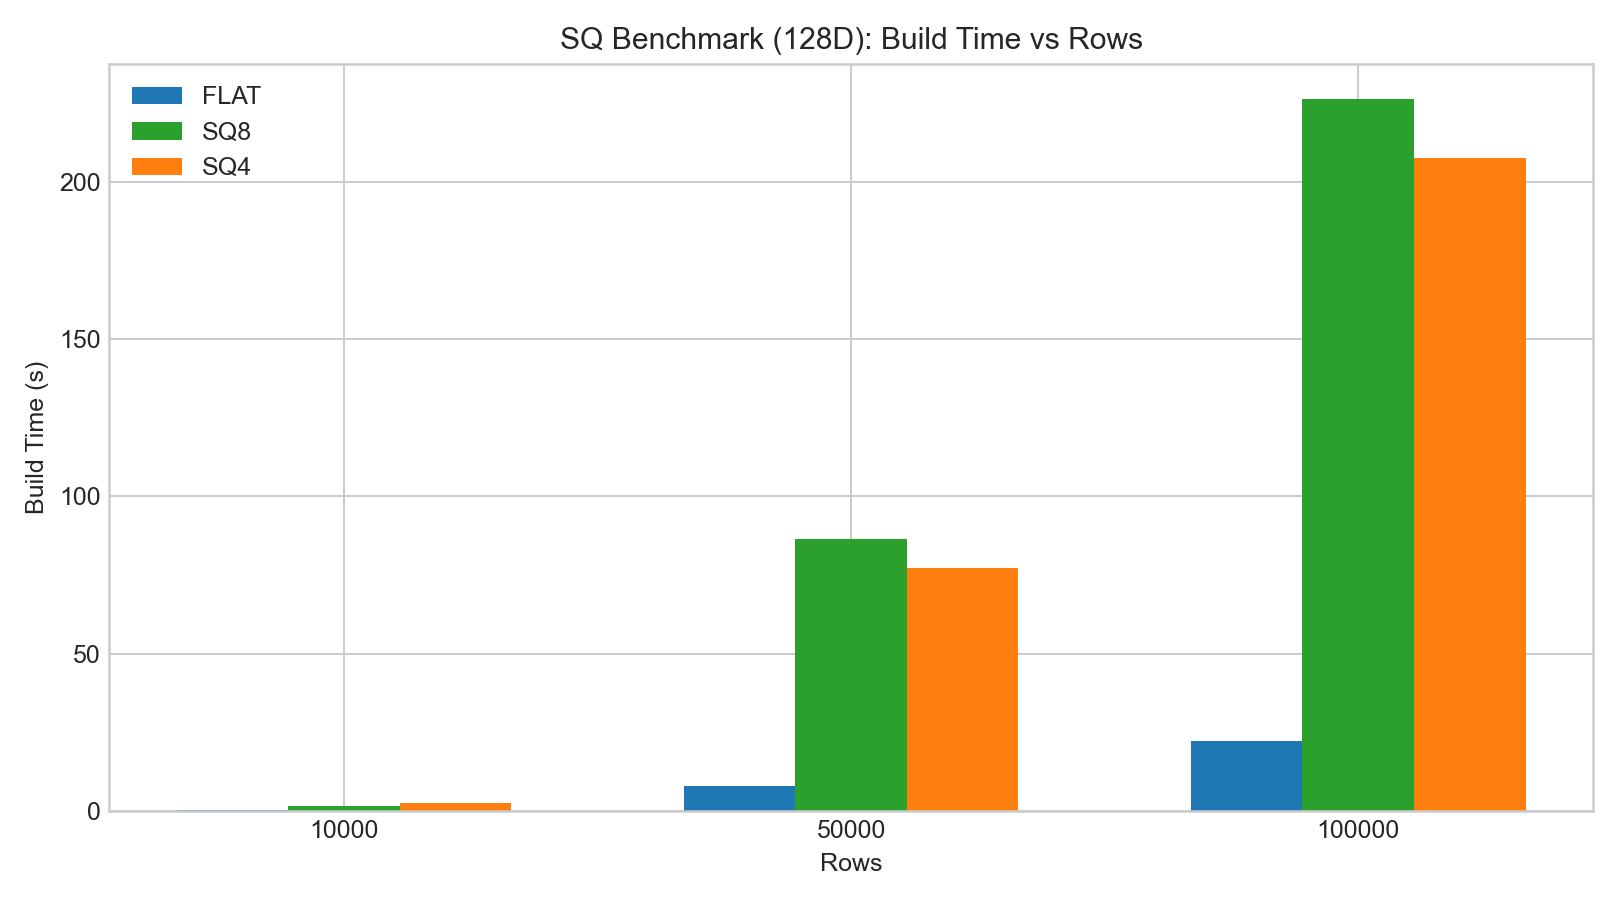
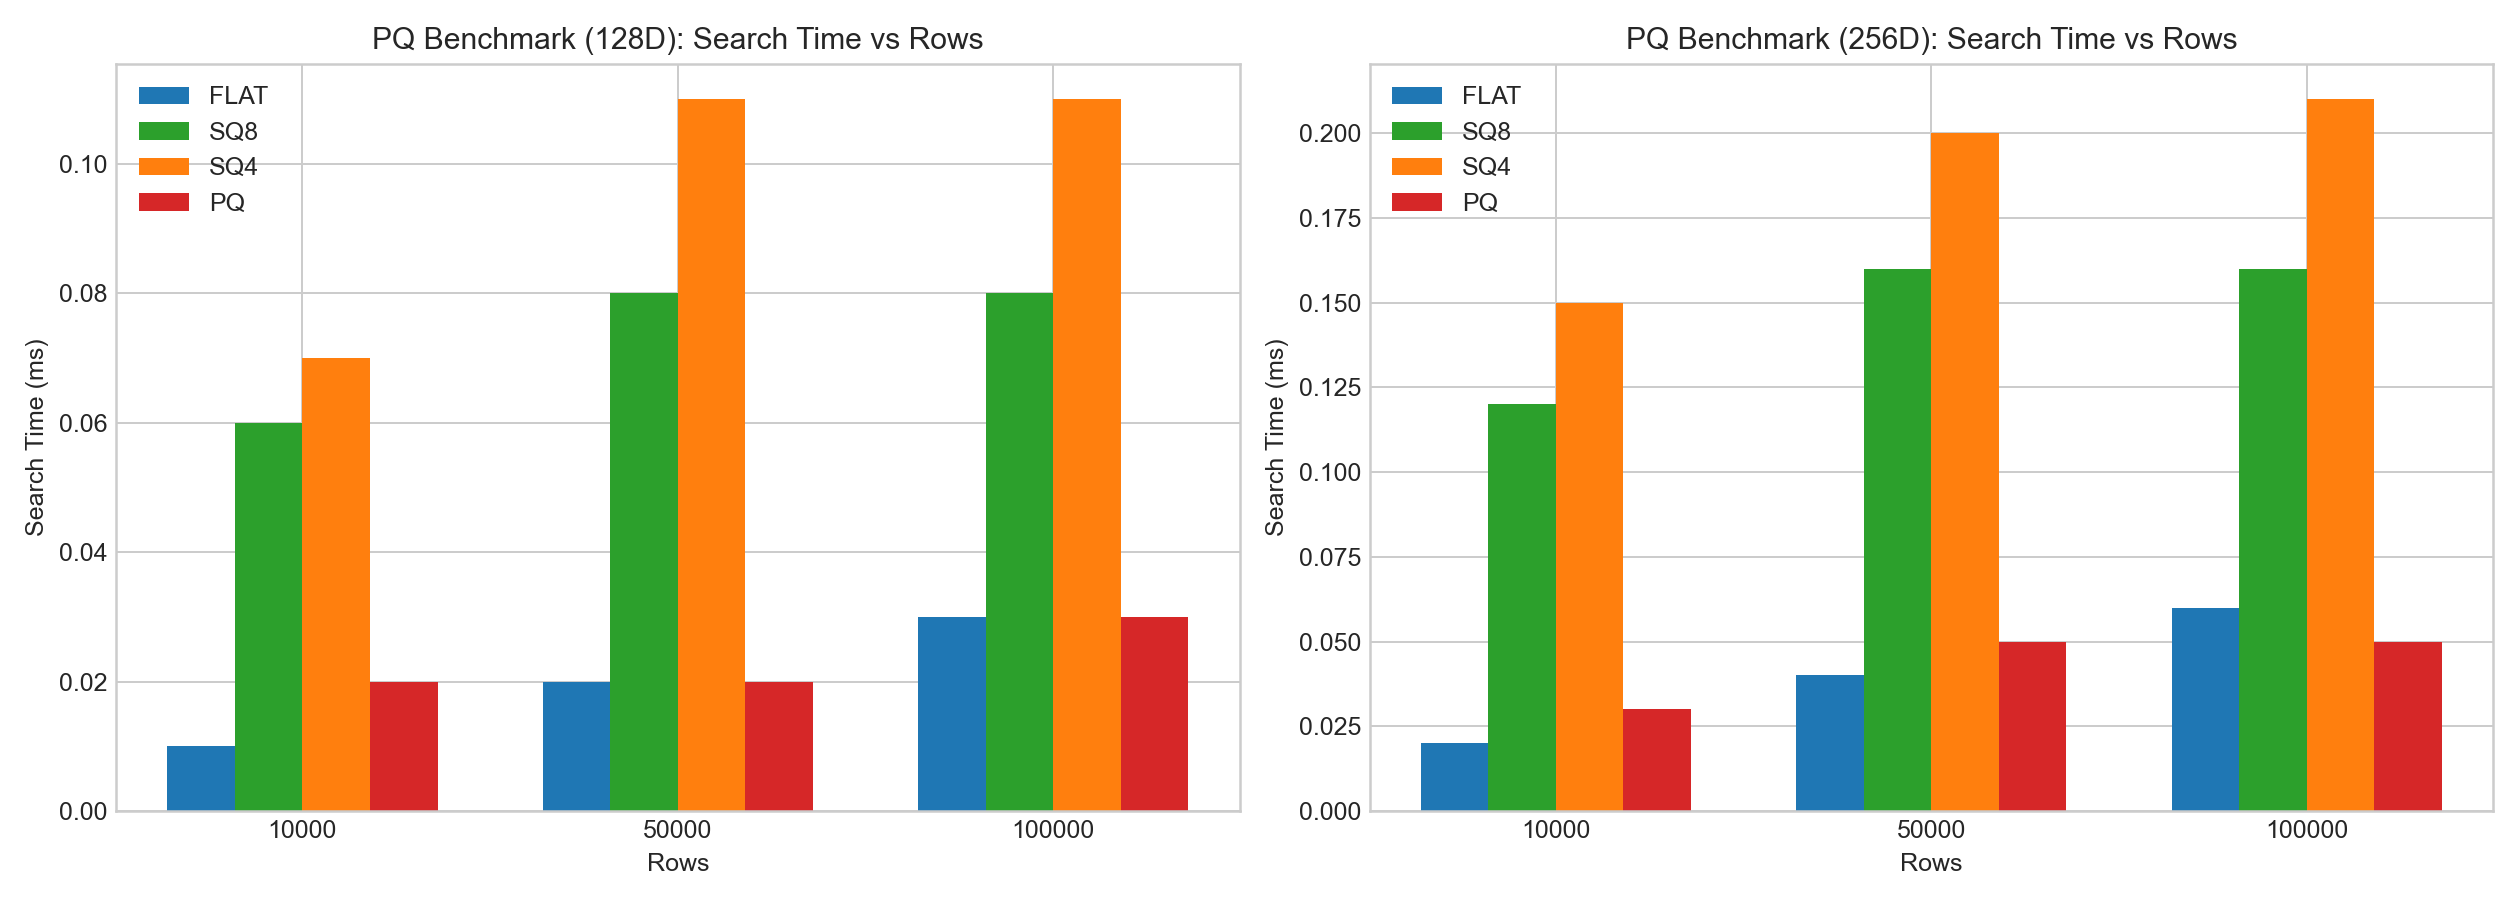
Во внутренних тестах HNSW с размерностями 128D/256D:
- Полнота поиска у
sq8обычно заметно выше, чем уsq4. - Время построения индекса и кодирования для SQ значительно больше, чем для FLAT.
- При использовании
sq8задержка запросов обычно меняется незначительно, тогда как уsq4снижение полноты поиска выражено сильнее.
Приведённые ниже столбчатые диаграммы построены на примерах данных тестирования производительности:
Продуктовое квантование (PQ)
Принцип работы
PQ разбивает вектор размерности D на M подвекторов (размерность каждого подвектора равна D/M) и применяет квантование на основе k-means в каждом подпространстве.
Основные параметры:
| Параметр | Значение | Направление настройки |
|---|---|---|
pq_m | Число подквантователей | Увеличение значения повышает точность, но увеличивает затраты на обучение и кодирование |
pq_nbits | Число бит для кодирования каждого подвектора | Определяет размер кодовой книги каждого подпространства (2^pq_nbits) |
Почему запросы с PQ могут выполняться быстрее
PQ может использовать LUT (таблицу поиска) для приближённого вычисления расстояний:
- Заранее вычислить расстояния от каждого подвектора запроса до центроидов каждого подпространства.
- При выполнении запроса оценить общее расстояние с помощью обращений к таблице и суммирования.
Это позволяет избежать полного восстановления векторов и во многих сценариях снижает нагрузку на CPU на этапе поиска.
Ключевые фрагменты исходного кода Faiss (PQ)
В той же реализации Faiss ProductQuantizer обучает кодовую книгу для каждого подпространства и хранит центроиды в непрерывной области памяти. Упрощённый вариант выглядит так:
void ProductQuantizer::train(size_t n, const float* x) {
    Clustering clus(dsub, ksub, cp);
    IndexFlatL2 index(dsub);
    clus.train(n * M, x, index);
    for (int m = 0; m < M; m++) {
        set_params(clus.centroids.data(), m);
    }
}
Расположение центроидов можно представить как (M, ksub, dsub):
M: число подквантователей.ksub: размер кодовой книги каждого подпространства (2^pq_nbits).dsub: размерность подвектора (D / M).
Практические наблюдения
В тех же внутренних тестах:
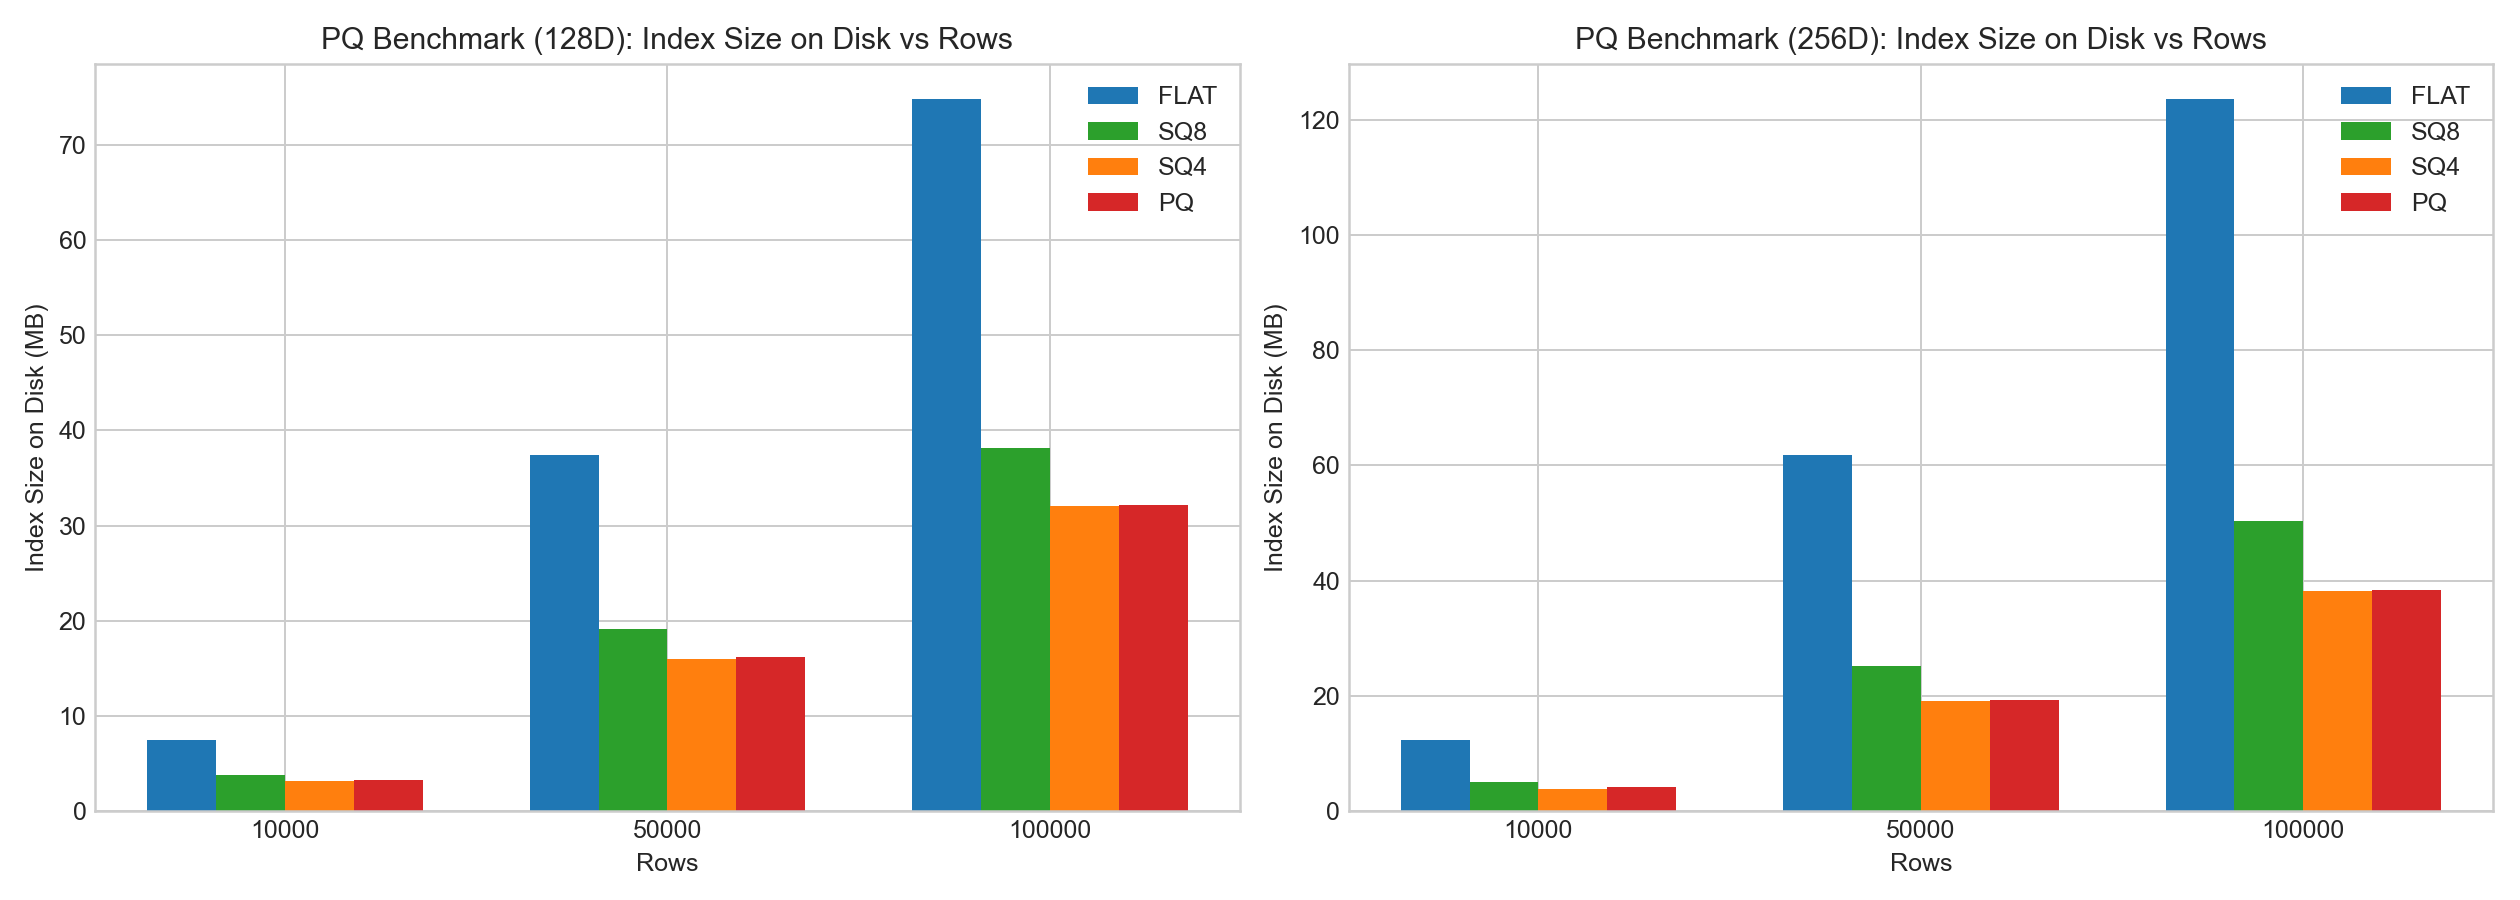
- PQ обеспечивает заметный выигрыш в сжатии.
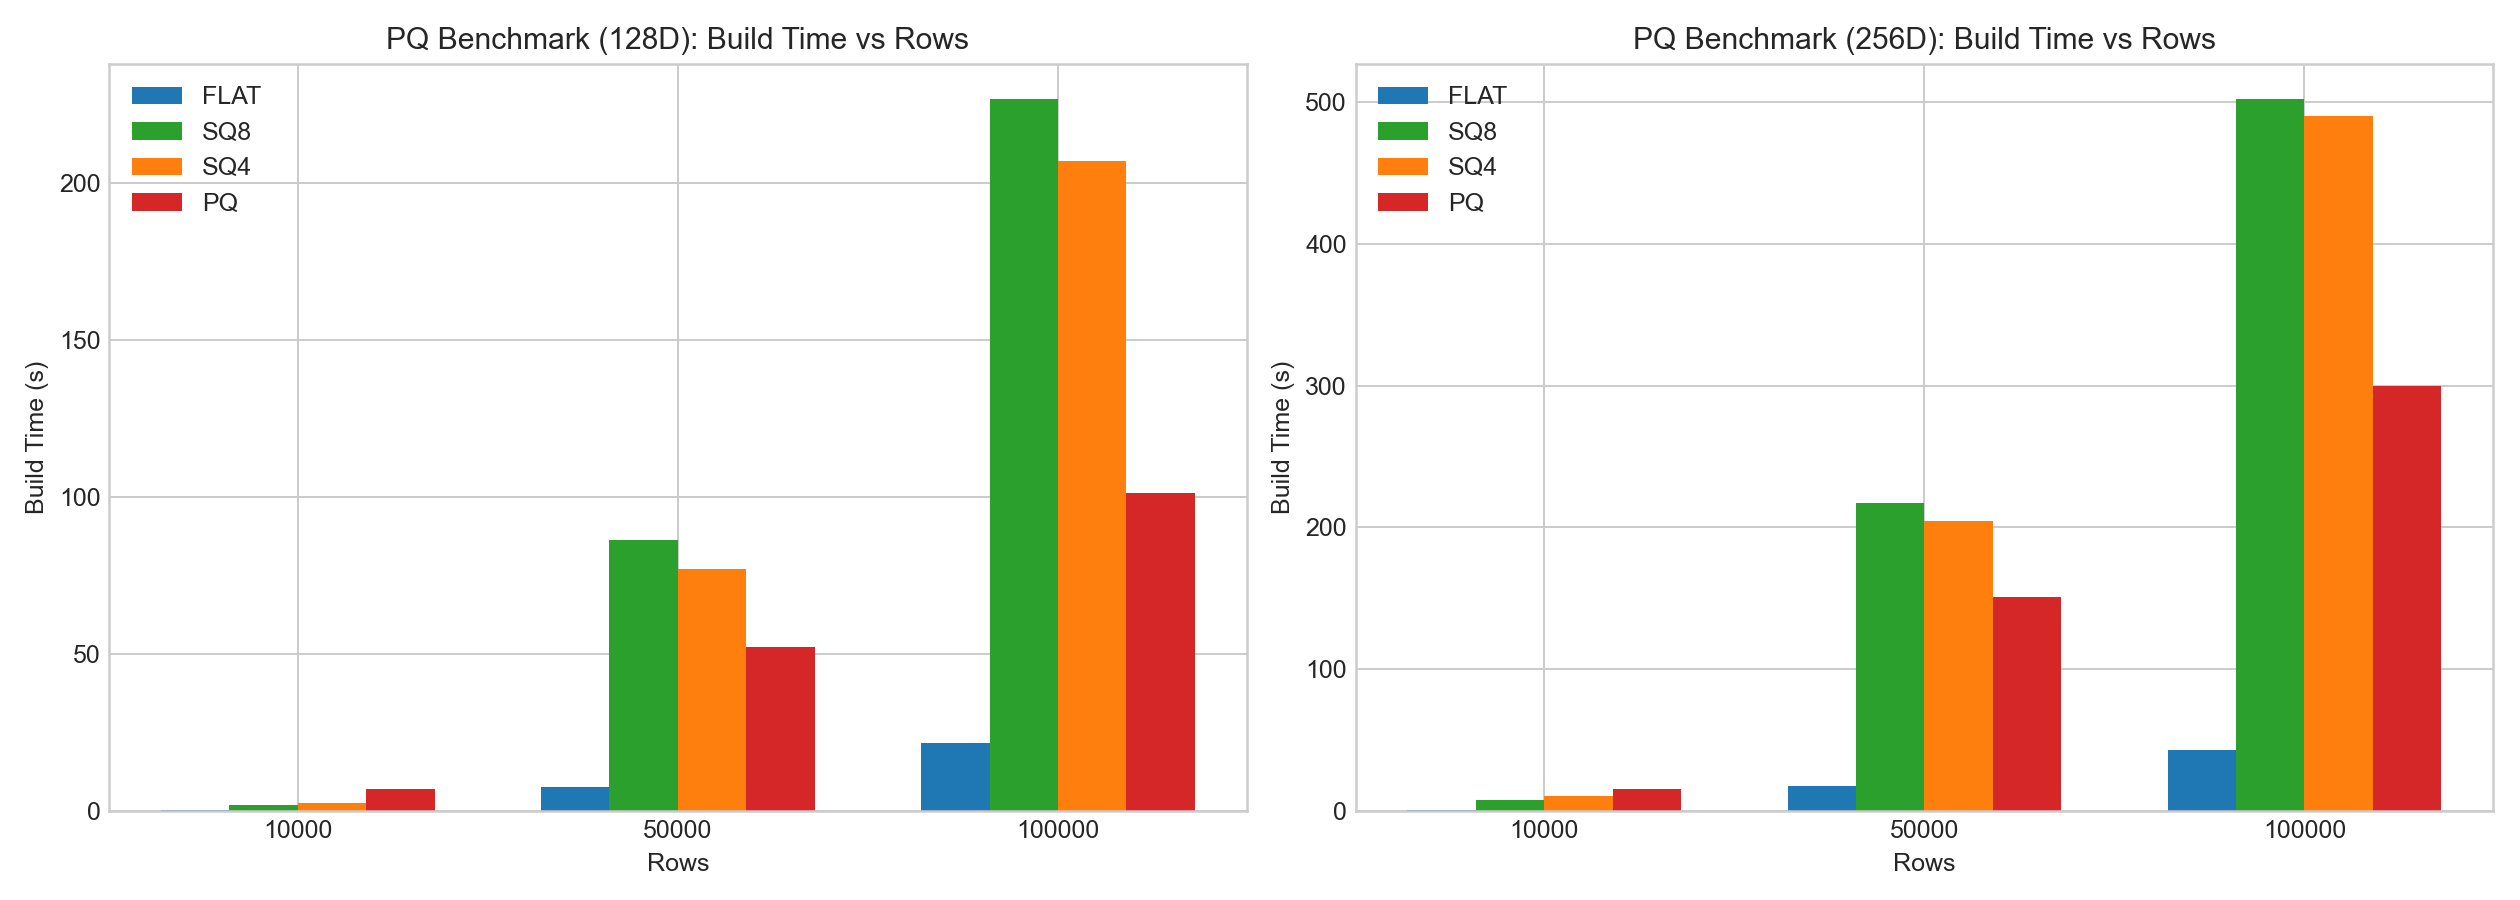
- PQ требует более высоких затрат на обучение и кодирование.
- По сравнению с SQ, PQ часто позволяет ускорить выполнение запросов благодаря LUT, однако полнота поиска и затраты на построение по-прежнему зависят от распределения данных и сочетания параметров.
Приведённые ниже столбчатые диаграммы построены на примерах данных тестирования производительности:
Рекомендации по выбору для Doris
Выбор по сценарию
| Сценарий | Рекомендуемый квантователь | Обоснование |
|---|---|---|
| Памяти достаточно, приоритетом является полнота поиска | flat | Нет потери точности, максимально достижимое качество |
| Нужно сократить потребление памяти с низким риском и более стабильным качеством | sq8 | Сжатие около 4x, контролируемое снижение полноты поиска |
| Острая нехватка памяти, допустимо снижение полноты поиска | sq4 | Сжатие около 8x, но полнота поиска снижается заметнее |
| Нужен баланс сжатия и производительности, есть готовность настраивать параметры | pq | LUT ускоряет запросы, требуется настройка параметров |
Рекомендуемый порядок проверки
- Сначала создайте базовый вариант с
flatи зафиксируйте Recall@K и задержку запросов. - Первым протестируйте
sq8и сопоставьте Recall с задержками P95/P99. - Если памяти по-прежнему недостаточно, протестируйте
pq(можно начать сpq_m = D/2). - Рассматривайте
sq4, только если экономия памяти важнее полноты поиска.
Что учитывать при тестировании производительности
Абсолютная задержка сильно зависит от оборудования, числа потоков и набора данных. При сравнительном тестировании зафиксируйте следующие переменные, чтобы результаты были сопоставимы:
| Категория | Какие переменные зафиксировать |
|---|---|
| Данные | Размерность векторов, распределение данных, число строк |
| Индекс | Параметры индекса, размер сегмента |
| Запрос | Набор запросов и набор эталонных результатов |
При оценке следует одновременно учитывать все следующие показатели:
- Recall@K
- Размер индекса
- Время построения
- Задержка запросов (P50/P95/P99)
Часто задаваемые вопросы
Вопрос 1: Как выбрать между sq8 и sq4?
Предпочтительнее sq8. sq8 обеспечивает сжатие около 4x с контролируемым снижением полноты поиска. sq4 обеспечивает сжатие около 8x, но полнота поиска снижается заметнее, поэтому используйте его только при крайне ограниченной памяти.
Вопрос 2: Когда стоит предпочесть PQ вместо SQ?
Выбирайте PQ, если нужна более высокая степень сжатия или вы хотите ускорить выполнение запросов с помощью LUT. Компромисс заключается в более высоких затратах на обучение и кодирование; кроме того, pq_m и pq_nbits необходимо настраивать с учётом распределения данных.
Вопрос 3: Влияет ли квантование на время построения?
Да. Время построения индекса и кодирования у любого квантователя значительно больше, чем у flat, а этап обучения PQ требует наибольших затрат. При оценке фиксируйте время построения отдельно.
Вопрос 4: Всегда ли неравномерное SQ лучше равномерного?
Не обязательно. Когда масштабы числовых значений заметно различаются между измерениями (например, если значения в некоторых измерениях изначально больше по величине), неравномерное квантование даёт меньшую ошибку восстановления. Если масштабы близки во всех измерениях, разница между этими подходами невелика.
Вопрос 5: Как задать начальное значение pq_m?
Можно начать с pq_m = D/2, а затем увеличивать или уменьшать значение с учётом Recall@K и задержки запросов. Увеличение pq_m повышает точность, но увеличивает затраты на обучение и кодирование.