Peer 读:跨 BE / 跨计算组 File Cache 读取配置指南(存算分离)
Peer 读是存算分离架构下 File Cache 的未命中处理策略:本 BE 的 File Cache 没有某个数据块时,先向其他 BE(同计算组或其他计算组)的 File Cache 要,其他 BE 也没有再回源对象存储。它只作用于冷读路径,命中本地缓存的读取不受影响。本文中的"计算组"指 Compute Group。
Peer 读自 4.2.0 版本起支持,默认开启。不需要这项能力时,在 BE 上设置 enable_cache_read_from_peer = false 关闭。
适用场景
| 场景 | Peer 读做了什么 | 收益 |
|---|---|---|
| 同计算组扩缩容 | 扩容或 tablet 均衡后,新 BE 首次读取先从原来负责该 tablet 的 BE 拉缓存块,不直接请求对象存储 | 缩短均衡后的性能抖动窗口,减少回源流量 |
| 跨计算组冷读 | 本计算组没有缓存、其他计算组已经读热过同一份数据时,直接从对方 BE 的 File Cache 读 | 冷查询延迟下降,对象存储回源流量下降 |
| 跨计算组回源填充 | 指定一个"填充计算组":对方 BE 自己也没有缓存时,代为回源对象存储、写入自己的 File Cache,再把数据返回给发起查询的 BE | 回源成本由指定计算组承担,数据顺带留在它的缓存里 |
性能参考
在 TPC-H 1 TB 数据集的冷读测试中,Peer 读的冷读性能约为直接读取对象存储的 2 倍。实际收益取决于其他 BE 是否已经缓存了所需数据,以及 Peer 网络延迟与对象存储延迟的差距。
前置条件
- 存算分离部署。存算一体模式下 Peer 读不生效。
- 所有 BE 已开启 File Cache(
enable_file_cache = true)。 enable_cache_read_from_peer保持默认值true。- 使用回源填充时,需要知道填充计算组的 ID(
compute_group_id),获取方法见指定回源填充计算组。
限制
- 只支持 Doris 内表。外表(Hive、Iceberg 等)的数据缓存不走 Peer 读。
- 只在本地 File Cache 未命中的路径上触发。缓存预热任务的读取,以及回源填充时服务端自己的对象存储读取,都不会再走 Peer 读。
enable_cache_read_from_peer同时控制同计算组和跨计算组两种 Peer 读,目前不能只保留同计算组 Peer 读、关闭跨计算组 Peer 读。候选节点由 FE 给出,天然包含其他计算组的 BE。- 回源填充的服务端暂不支持小文件合并(Packed File)产生的文件,这类请求会按正常流程回退到对象存储。
- 跨可用区(AZ)部署时,跨计算组 Peer 读会产生跨 AZ 网络流量,可能带来额外费用。
- Peer 读不保证一定发生。是否走 Peer、走哪个 BE,由候选节点、超时和回退逻辑决定。
工作原理
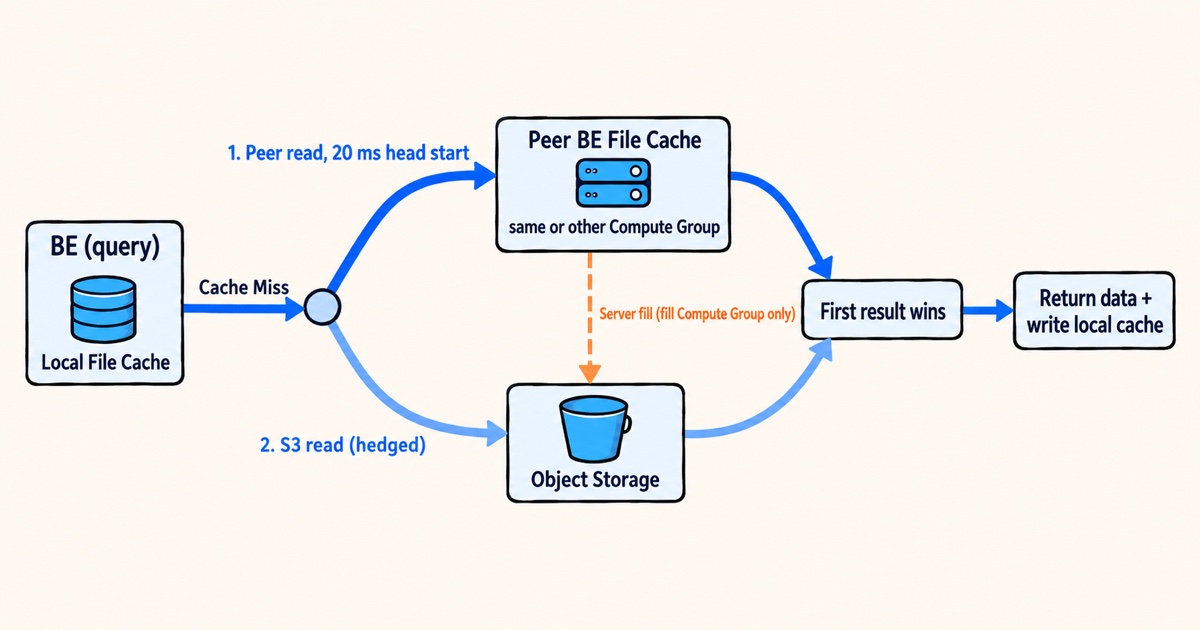
读取流程
- 查询读取数据块时先查本地 File Cache,命中则直接返回。
- 未命中时,查看该 tablet 在本 BE 是否已有 Peer 候选节点。没有候选节点时,本次读取直接回源对象存储,同时后台异步向 FE 拉取候选节点,当前请求不等待。
- 有候选节点时,Peer 读与对象存储读并发竞速(
enable_peer_s3_race,默认开启):先向候选节点发起 Peer 读,并给它peer_race_hedge_delay_ms(默认 20 毫秒)的先手时间。Peer 在先手时间内返回,对象存储读就不再发起。 - 先返回的一方胜出。无论数据来自 Peer 还是对象存储,都会写入本地 File Cache,后续读取直接命中本地。
- Peer 读失败时自动回退到对象存储,查询不会因此报错。失败的原因包括候选节点上没有该数据块、RPC 失败、并发槽位已满或超时。
关闭 enable_peer_s3_race,或同时进行的竞速数超过 max_concurrent_peer_races(默认 64)时,改为串行:依次尝试候选节点,全部失败再读对象存储。
一次冷查询通常包含大量并发读取。第一次读取 Segment footer 时就会触发候选节点拉取,同一查询后续对该 tablet 的读取就能用上 Peer 读,所以"第一次冷读"仍然请求对象存储是预期行为。
候选节点从哪里来
| 来源 | 说明 | 优先级 |
|---|---|---|
| 均衡迁移的源 BE | 计算组扩缩容或 tablet 均衡时,FE 发给目标 BE 的预热请求会把源 BE 记录为候选节点。balance_type 为 without_warmup 时不发预热请求,也就不会记录 | 最高 |
| FE 返回的 tablet 分布 | 本地没有候选节点时,BE 后台向 FE 拉取该 tablet 在所有计算组中的 BE,追加到候选列表末尾 | 较低 |
| 手工设置 | 通过 HTTP 接口 /api/peer_cache?op=set 强制写入(见查看和调整 tablet 的 Peer 信息),一般只用于测试和排障 | 按写入顺序 |
候选节点的选择与轮转
- BE 记住每个 tablet 上次成功读取的计算组,后续优先尝试该计算组的候选节点。
- 候选节点上没有所需数据块时,它被移到列表末尾,下次换一个节点。连续 RPC 失败达到
peer_rpc_failure_eviction_threshold(默认 3)次的节点会被剔除。 - 某个 tablet 连续
peer_all_miss_cooldown_threshold(默认 5)次"所有候选节点都没有数据"后进入冷却期,冷却peer_all_miss_cooldown_duration_s(默认 300 秒)期间直接走对象存储。 - 候选节点信息
peer_candidate_expiry_s(默认 3600 秒)内没有被使用就从内存清理,下次未命中时重新向 FE 拉取。
跨计算组回源填充
在发起读取的 BE 上配置 peer_cache_fill_compute_group_id 后,如果本次选中的候选节点属于该计算组,请求会带上填充标记。收到请求的 BE 自己也没有该数据块,且 enable_peer_server_cache_fill 开启(默认开启)时,就会代为从对象存储读取,写入自己的 File Cache 后再返回。
填充受 max_concurrent_peer_server_fills(默认 32)和 peer_server_cache_fill_timeout_ms(默认 6000 毫秒)限制,超限或超时时请求方回退到对象存储。
配置方式
以下参数都是 BE 配置。除线程池参数外都支持动态修改,见动态修改。
确认或关闭 Peer 读
Peer 读默认开启,只要 File Cache 已开启就会生效,同计算组和跨计算组同时生效,候选节点由 FE 自动给出。通过 MySQL 客户端确认当前值:
SHOW BACKEND CONFIG LIKE 'enable_cache_read_from_peer';
需要关闭时,在所有 BE 的 be.conf 中设置:
enable_cache_read_from_peer = false
关闭后本地未命中的数据块直接回源对象存储,peer_read_async_warmup 这类依赖 Peer 读的均衡策略也随之失去效果。
指定回源填充计算组
希望跨计算组冷读时由指定计算组负责回源并填充缓存,按下面三步配置。
-
查询目标计算组的 ID。
SHOW BACKENDS结果Tag列中的compute_group_id就是计算组 ID,注意不是compute_group_name:SHOW BACKENDS\G*************************** 1. row ***************************
BackendId: 10001
Host: 10.0.0.1
...
Tag: {"cloud_unique_id" : "1:xxx:yyy", "compute_group_id" : "cg_write_01", "compute_group_name" : "write_group", "compute_group_status" : "NORMAL", "location" : "default"} -
在发起查询的计算组的所有 BE 上配置:
peer_cache_fill_compute_group_id = cg_write_01 -
确认填充计算组的 BE 上
enable_peer_server_cache_fill为true(默认值)。
动态修改
除线程池参数外,本文的参数都可以在运行时修改,加 persist=true 可持久化到 be_custom.conf:
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?enable_cache_read_from_peer=false&persist=true"
curl -X POST "http://<be_host>:<be_webserver_port>/api/update_config?peer_race_hedge_delay_ms=30"
配置参数
开关与竞速
| 参数 | 默认值 | 说明 |
|---|---|---|
enable_cache_read_from_peer | true | Peer 读总开关。开启时本地 File Cache 未命中先尝试从其他 BE 读取,同计算组和跨计算组同时生效 |
enable_peer_s3_race | true | 是否让 Peer 读与对象存储读并发竞速。关闭后改为串行:先依次尝试候选节点,全部失败再读对象存储 |
peer_race_hedge_delay_ms | 20 | 竞速时给 Peer 的先手时间(毫秒)。Peer 在该时间内返回则不再发起对象存储读取;设为 0 表示两路同时发起 |
max_concurrent_peer_races | 64 | 单个 BE 上同时进行的竞速数上限。超过后新的未命中请求改为串行 |
回源填充
| 参数 | 默认值 | 说明 |
|---|---|---|
peer_cache_fill_compute_group_id | "" | 请求方配置。负责回源填充的计算组 ID(compute_group_id,不是名称)。选中的候选节点属于该计算组时,请求带上填充标记 |
enable_peer_server_cache_fill | true | 服务方配置。是否接受带填充标记的请求:本机也未缓存时,代为从对象存储读取并写入本机 File Cache 后返回 |
peer_server_cache_fill_timeout_ms | 6000 | 服务方一次填充的最长等待时间(毫秒),超时后请求方回退到对象存储 |
max_concurrent_peer_server_fills | 32 | 服务方同时进行的填充数上限。超过后直接拒绝,请求方回退到对象存储 |
候选节点管理
| 参数 | 默认值 | 说明 |
|---|---|---|
peer_rpc_failure_eviction_threshold | 3 | 候选节点连续 RPC 失败达到该次数后被剔除 |
peer_all_miss_cooldown_threshold | 5 | tablet 连续多少次"所有候选节点都未命中"后进入冷却期 |
peer_all_miss_cooldown_duration_s | 300 | 冷却时长(秒)。冷却期内该 tablet 的读取直接走对象存储 |
peer_candidate_expiry_s | 3600 | 候选节点信息的过期时间(秒),按最近一次使用时间计算。过期后清理,下次未命中时重新向 FE 拉取 |
peer_candidate_cleanup_interval_s | 3600 | 后台清理过期候选节点的周期(秒) |
线程池与队列
| 参数 | 默认值 | 说明 |
|---|---|---|
peer_fetch_queue_timeout_ms | 100 | 服务方:Peer 读请求在处理队列中等待超过该时间(毫秒)即拒绝,让请求方尽快回退到对象存储 |
brpc_peer_fetch_pool_threads | -1 | 服务方处理 Peer 读请求的线程数,与导入等重负载 RPC 隔离。-1 表示取 max(64, 2 × CPU 核数)。静态参数,修改后需重启 BE |
brpc_peer_fetch_pool_max_queue_size | -1 | 上述线程池的队列长度。-1 表示取 max(4096, 128 × CPU 核数)。静态参数 |
min_peer_race_s3_thread_num / max_peer_race_s3_thread_num | 0 / 32 | 请求方竞速时执行对象存储读取的线程池大小。静态参数 |
副作用与注意事项
跨计算组 Peer 读会打破计算组之间的隔离:一个计算组的查询会占用另一个计算组的网络、磁盘和 File Cache 读取能力,配置回源填充后还会让对方替你消耗对象存储带宽。查询的资源消耗不再局限在当前计算组。
回源填充会把数据写进服务端 BE 的本地 File Cache,可能挤掉它自己的热点数据。
竞速开启时,一部分未命中请求会在短时间内同时产生 Peer RPC 和对象存储读取。20 毫秒的先手时间能减少这种重复,但不能完全消除。
Peer 命中不保证成功。服务方并发槽位满、填充槽位满、数据块不存在或超时,都会自动回退到对象存储。竞速开启时冷查询通常不会比直接读对象存储更慢,但也不一定更快。
跨可用区部署时,跨计算组 Peer 读会产生跨 AZ 流量费。
观测与排障
Query Profile 指标
Peer 读相关指标与其他 File Cache 指标一样位于 Profile 的 SegmentIterator 节点下。获取和阅读 Profile 的方法见 Query Profile 分析指南。
| 指标 | 含义 | 诊断用途 |
|---|---|---|
NumPeerIOTotal | 通过 Peer 读取数据的总次数 | 判断查询是否真的用到了 Peer 读 |
PeerIOUseTimer | Peer 读路径的总耗时 | 判断 Peer 路径本身是否慢 |
SameCGPeerIOTotal / SameCGPeerBytesRead / SameCGPeerIOTime | 同计算组 Peer 读的次数、字节数和耗时 | 判断 Peer 读是否主要发生在计算组内 |
CrossCGPeerIOTotal / CrossCGPeerBytesRead / CrossCGPeerIOTime | 跨计算组 Peer 读的次数、字节数和耗时 | 判断是否发生了跨计算组读取以及流量规模 |
PeerRaceWin / S3RaceWin | 竞速中 Peer / 对象存储胜出的次数,仅在 enable_peer_s3_race = true 时有意义 | S3RaceWin 明显更高说明当前环境下 Peer 不占优 |
PeerLazyFetch / PeerLazyFetchTime | 本地没有候选节点、触发后台向 FE 拉取的次数和耗时 | 解释为什么第一次读取没有走 Peer |
PeerCacheNodes | 本次查询实际用到的 Peer 节点列表 | 定位数据具体从哪些 BE 拉取 |
InvertedIndexNumPeerIOTotal / InvertedIndexPeerIOUseTimer 和 SegmentFooterIndexNumPeerIOTotal / SegmentFooterIndexPeerIOUseTimer 分别统计倒排索引文件和 Segment footer / 内部索引的 Peer 读次数与耗时,可用于判断索引读取是否也命中了 Peer。
BE bvar 指标
通过 curl http://<be_host>:<brpc_port>/vars 查看,brpc_port 默认为 8060。请求方(发起读取的 BE)指标:
| 指标 | 含义 |
|---|---|
cached_remote_reader_peer_read | 发起 Peer 读的次数 |
cached_remote_reader_s3_read | 发起对象存储读取的次数 |
peer_race_peer_win / peer_race_s3_win | 竞速中 Peer / 对象存储胜出的次数 |
peer_same_compute_group_read / peer_cross_compute_group_read | 同计算组 / 跨计算组 Peer 读成功的次数 |
peer_lazy_fetch_triggered | 触发后台向 FE 拉取候选节点的次数 |
peer_cache_reader_peer_latency | Peer RPC 延迟 |
服务方(提供缓存的 BE)指标:
| 指标 | 含义 |
|---|---|
file_cache_get_by_peer_num / file_cache_get_by_peer_success_num / file_cache_get_by_peer_failed_num | 收到的 Peer 读请求数及成功、失败数 |
file_cache_get_by_peer_queue_timeout_num | 因排队超过 peer_fetch_queue_timeout_ms 而被拒绝的请求数 |
peer_server_fill_requested / peer_server_fill_success | 触发回源填充的次数和成功次数 |
peer_server_fill_timeout / peer_server_fill_rejected | 回源填充超时、因槽位不足被拒绝的次数 |
判读方法:
cached_remote_reader_peer_read高、cached_remote_reader_s3_read低:Peer 读整体生效。peer_race_s3_win明显高于peer_race_peer_win:当前环境下 Peer 不占优,可以增大peer_race_hedge_delay_ms,或者关闭 Peer 读。peer_cross_compute_group_read高:已经发生跨计算组流量,需要关注隔离被打破的影响。peer_server_fill_requested高但peer_server_fill_success低、peer_server_fill_timeout高:填充计算组压力大或配置不合适。
查看和调整 tablet 的 Peer 信息
BE 提供 /api/peer_cache 接口(BE 的 webserver_port,默认 8040)查看和修改单个 tablet 的候选节点,一般用于排障。
查看单个 tablet 的候选节点、上次成功的计算组、连续未命中次数和冷却状态:
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show&tablet_id=<tablet_id>"
{
    "tablet_id": 10086,
    "candidates": [
        {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01", "last_access_time_ms": 1758441600000, "consecutive_rpc_failures": 0}
    ],
    "last_successful_compute_group_id": "cg_write_01",
    "fetching_from_fe": false,
    "consecutive_all_miss": 0,
    "cooldown_until_ms": 0
}
查看本 BE 上所有有候选节点的 tablet,limit 默认 1000:
curl "http://<be_host>:<be_webserver_port>/api/peer_cache?op=show_all&limit=100"
强制写入某个 tablet 的候选节点(请求体为 JSON):
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=set&tablet_id=<tablet_id>" \
    -H "Content-Type: application/json" \
    -d '{
        "candidates": [
            {"host": "10.0.0.2", "brpc_port": 8060, "compute_group_id": "cg_write_01"}
        ],
        "last_successful_compute_group_id": "cg_write_01",
        "consecutive_all_miss": 0,
        "cooldown_until_ms": 0
    }'
删除某个 tablet 的候选节点,或清除其冷却状态:
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=remove&tablet_id=<tablet_id>"
curl -X POST "http://<be_host>:<be_webserver_port>/api/peer_cache?op=reset_cooldown&tablet_id=<tablet_id>"
最佳实践
- 和缓存预热配合使用。预热是主动把数据从对象存储拉到本地,Peer 读是查询时被动从其他 BE 读取:预热覆盖已知热点,Peer 读兜底预热没覆盖到的冷读。
- 扩缩容前不要关闭 Peer 读。计算组扩缩容或 tablet 均衡后,Peer 读让新 BE 直接复用源 BE 的缓存;配合
balance_type = peer_read_async_warmup可以在均衡时立即切换映射,靠 Peer 读平滑过渡,详见计算组扩缩容。 - 读写分离场景把写入计算组指定为填充计算组。只读计算组冷读时,写入计算组承担回源并保留一份缓存,详见读写分离场景 File Cache 缓存优化最佳实践。
- 对计算组之间的资源隔离有硬性要求,或跨 AZ 部署且对流量费敏感时,设置
enable_cache_read_from_peer = false关闭。 - 先看指标再调参。通过
PeerRaceWin/S3RaceWin和 bvar 判断 Peer 是否占优,再决定是否调整peer_race_hedge_delay_ms或关闭竞速。
常见问题
Q:为什么第一次冷读还是访问了对象存储?
本地还没有该 tablet 的候选节点时,当前请求不会等待 FE 返回,而是直接回源,同时后台异步拉取候选节点。同一查询后续对该 tablet 的读取,以及之后的查询,就会走 Peer 读。Profile 中 PeerLazyFetch 大于 0 就对应这种情况。
Q:如何确认某个查询用到了 Peer 读?
查看 Profile 中的 NumPeerIOTotal、SameCGPeerIOTotal、CrossCGPeerIOTotal 和 PeerCacheNodes,也可以在 BE 上观察 cached_remote_reader_peer_read 是否增长。
Q:可以只允许同计算组内的 Peer 读、禁止跨计算组吗?
目前不支持。enable_cache_read_from_peer 同时控制两种 Peer 读,候选节点由 FE 返回,包含所有计算组的 BE。
Q:如何关闭 Peer 读?
在所有 BE 上设置 enable_cache_read_from_peer = false,支持动态修改。关闭后本地未命中的读取直接回源对象存储。
Q:S3RaceWin 远高于 PeerRaceWin 怎么办?
说明当前环境下从 Peer 读取并不比对象存储快,常见于 Peer 网络延迟高或 Peer BE 负载高。可以增大 peer_race_hedge_delay_ms 观察变化,或者关闭 Peer 读。
Q:某个 tablet 一直不走 Peer 读?
用 /api/peer_cache?op=show&tablet_id=<tablet_id> 查看:candidates 为空说明还没有候选节点;cooldown_until_ms 不为 0 说明处于冷却期,可用 op=reset_cooldown 清除。
Q:回源填充没有生效?
依次确认:请求方配置的 peer_cache_fill_compute_group_id 是计算组 ID 而不是名称;选中的候选节点确实属于该计算组(op=show 中的 compute_group_id);填充方 enable_peer_server_cache_fill 为 true;peer_server_fill_rejected / peer_server_fill_timeout 是否在增长。
