物化视图增量维护(IVM)
物化视图增量维护(Incremental View Maintenance,IVM)根据基表的行级变化维护异步物化视图。普通异步物化视图会重算全部数据或受影响的整个分区;IVM 只计算基表两次刷新之间的新增、更新和删除,并把这些变化应用到物化视图。
IVM 从 Doris 5.0.0 开始支持,目前处于实验阶段,默认关闭。使用前需要在 FE 配置中开启 Row Binlog 和 Table Stream,详见 前置条件。
适用场景
先比较每次变化的行数、受影响分区的大小和数据一致性要求,再选择刷新方式。
| 场景 | 建议 | 原因 |
|---|---|---|
| 基表频繁增删改,变化行数只占全表或分区的一小部分 | 使用 IVM | 只计算两次刷新之间的行级变化,避免重算完整分区 |
| 变化集中在少量分区,重算这些分区的成本可接受 | 使用 PARTITIONS | 配置更简单,按受影响分区重算 |
| 首次建立基线、数据量较小或需要恢复 IVM 基线 | 使用 COMPLETE | 重新计算物化视图的全部数据 |
| 要求与基表事务同步、实时一致 | 不使用异步物化视图 | IVM 仍通过异步任务刷新,不提供实时一致性 |
与分区增量刷新的区别
Doris 支持四种异步物化视图刷新方式。IVM 对应 INCREMENTAL,不要把它与 PARTITIONS 的分区增量刷新混淆。
| 刷新方式 | 计算粒度 | 适用场景 | 不满足条件时的行为 |
|---|---|---|---|
INCREMENTAL | 行级变化 | 变化行数远小于全表或受影响分区 | 默认直接失败;指定 FALLBACK 后可回退 |
PARTITIONS | 受影响的整个物化视图分区 | 变化集中在少量分区,且重算这些分区的成本可接受 | 默认直接失败;指定 FALLBACK 后回退到 COMPLETE |
COMPLETE | 全部数据 | 数据量较小、首次建立基线或需要恢复 IVM 基线 | 始终完整重算 |
AUTO | Doris 自动选择 | 希望 Doris 自动选择可用策略 | 依次尝试可用的 IVM、分区刷新和完整刷新 |
INCREMENTAL FALLBACK 只改变刷新运行时的失败处理。创建物化视图时,定义 SQL 仍必须满足 IVM 要求;FALLBACK 不会让不支持 IVM 的定义通过创建检查。
工作原理
IVM 复用 Doris 的 Row Binlog 和 Table Stream 能力:
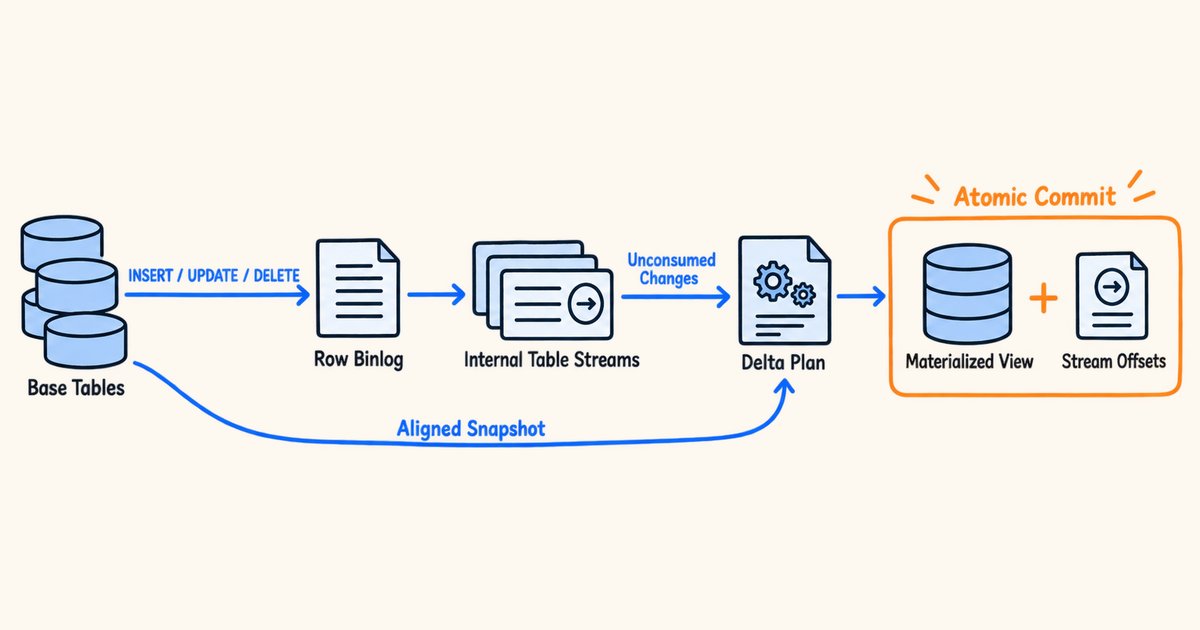
创建支持 IVM 的物化视图时,Doris 为每张参与增量维护的基表创建一个内部 Table Stream。内部 Stream 的名称以 __doris_ivm_stream_ 开头。用户不需要创建、消费或删除这些 Stream。
刷新时,Doris 根据每张基表的未消费变化生成增量计划。关联查询还会读取与消费位点对齐的基表快照,保证多表计算使用一致的数据边界。物化视图数据和消费位点在同一个事务中提交;事务失败时,两者都不会提交。
前置条件
版本和 FE 配置
-
使用 Doris 5.0.0 或更高版本。
-
在所有 FE 的
fe.conf中设置以下配置并重启 FE:enable_feature_binlog = true
enable_table_stream = true
这两个配置均为非动态配置。enable_feature_binlog 开启 Row Binlog 和全局提交时间戳,enable_table_stream 开启 Table Stream DDL 和内部 Stream 管理。
基表要求
参与增量维护的基表必须是 Internal Catalog 中的 Doris OLAP 内表,并满足以下要求:
| 基表模型 | 是否支持 | 要求与行为 |
|---|---|---|
| Unique Key Merge-on-Write | 支持 | 必须开启 Row Binlog 和 before 镜像,可处理新增、更新和删除 |
| Duplicate Key | 支持 | 必须开启 Row Binlog;只提供追加变化,不记录通过删除谓词执行的删除 |
| Unique Key Merge-on-Read | 不支持 | 请改用 Merge-on-Write |
| Aggregate Key | 不支持增量维护 | 仅可作为 excluded_trigger_tables 中不参与增量触发的表 |
| 外表 | 不支持 | IVM 的增量基表必须是 Doris 内表 |
对于需要处理更新和删除的业务,建议使用 Unique Key Merge-on-Write 表,并在建表时设置:
PROPERTIES (
    "enable_unique_key_merge_on_write" = "true",
    "binlog.enable" = "true",
    "binlog.format" = "ROW",
    "binlog.need_historical_value" = "true"
);
Row Binlog 只能在建表时开启,开启后不能关闭。完整的表模型、列类型、写入方式和 DDL 限制见 Row Binlog。
快速上手
下面的示例创建一个按订单状态聚合的 IVM。第一次使用 COMPLETE 建立完整基线,之后使用 INCREMENTAL FALLBACK 处理行级变化。
执行流程如下:
- 创建开启 Row Binlog 的 Unique Key Merge-on-Write 基表。
- 使用
REFRESH INCREMENTAL FALLBACK创建 IVM。 - 执行
COMPLETE刷新,建立完整基线。 - 修改基表数据并执行增量刷新。
- 查询刷新任务,确认执行结果和回退原因。
第 1 步:创建基表并写入初始数据
创建支持更新和删除的基表,同时开启 Row Binlog 和 before 镜像:
CREATE DATABASE IF NOT EXISTS ivm_demo;
USE ivm_demo;

CREATE TABLE orders (
    order_id BIGINT,
    order_status VARCHAR(16),
    amount DECIMAL(10, 2)
)
UNIQUE KEY(order_id)
DISTRIBUTED BY HASH(order_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "binlog.enable" = "true",
    "binlog.format" = "ROW",
    "binlog.need_historical_value" = "true"
);

INSERT INTO orders VALUES
    (1, 'created', 100.00),
    (2, 'created', 200.00),
    (3, 'paid',    300.00);
第 2 步:创建 IVM
在 CREATE MATERIALIZED VIEW 中指定 REFRESH INCREMENTAL。本例同时指定 FALLBACK,当某次变化无法安全地增量计算时,Doris 可以回退到分区刷新或完整刷新。触发方式使用 ON MANUAL,便于逐步观察每次刷新的结果;生产环境通常改为定时或提交触发,见 设置自动刷新间隔。
CREATE MATERIALIZED VIEW orders_by_status
BUILD DEFERRED
REFRESH INCREMENTAL FALLBACK ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
)
AS
SELECT
    order_status,
    COUNT(*) AS order_count,
    SUM(amount) AS total_amount
FROM orders
GROUP BY order_status;
创建成功后,Doris 会自动创建对应的内部 Table Stream。可以通过 mv_infos 查看映射关系:
SELECT Name, RefreshInfo, IvmBaseTableStreams
FROM mv_infos("database" = "ivm_demo")
WHERE Name = "orders_by_status";
第 3 步:建立完整基线
首次刷新使用 COMPLETE,为后续增量维护建立基线:
REFRESH MATERIALIZED VIEW orders_by_status COMPLETE;
刷新任务异步执行。任务成功后,查询物化视图:
SELECT order_status, order_count, total_amount
FROM orders_by_status
ORDER BY order_status;
+--------------+-------------+--------------+
| order_status | order_count | total_amount |
+--------------+-------------+--------------+
| created      |           2 |       300.00 |
| paid         |           1 |       300.00 |
+--------------+-------------+--------------+
第 4 步:写入变化并执行增量刷新
下面依次更新订单 1、删除订单 2,并新增订单 4:
INSERT INTO orders VALUES (1, 'paid', 100.00);
DELETE FROM orders WHERE order_id = 2;
INSERT INTO orders VALUES (4, 'created', 400.00);

REFRESH MATERIALIZED VIEW orders_by_status INCREMENTAL FALLBACK;
刷新任务成功后,IVM 只处理上述行级变化。物化视图结果为:
SELECT order_status, order_count, total_amount
FROM orders_by_status
ORDER BY order_status;
+--------------+-------------+--------------+
| order_status | order_count | total_amount |
+--------------+-------------+--------------+
| created      |           1 |       400.00 |
| paid         |           2 |       400.00 |
+--------------+-------------+--------------+
第 5 步:确认刷新方式和回退原因
查询最新刷新任务,确认请求方式、实际刷新范围和回退原因:
SELECT Status, TaskContext, RefreshMode, IvmFallbackReason, ErrorMsg
FROM tasks("type" = "mv")
WHERE MvDatabaseName = "ivm_demo"
  AND MvName = "orders_by_status"
ORDER BY CreateTime DESC, TaskId DESC
LIMIT 1;
TaskContext记录本次请求的刷新方式,例如INCREMENTAL。RefreshMode记录任务实际刷新的分区范围,可取COMPLETE、PARTIAL或NOT_REFRESH。IvmFallbackReason为空表示没有发生 IVM 回退;非空时记录稳定的回退原因。ErrorMsg记录严格增量刷新失败的具体信息。
支持的查询
IVM 在创建物化视图时检查定义 SQL。使用显式 REFRESH INCREMENTAL 时,不支持的定义会直接创建失败。本节列出支持的关系运算和聚合函数,并为每一项给出可以直接运行的示例,最后列出不支持的查询形式。
示例表
本节示例使用三张基表:客户表 customers、销售表 sales 和退款表 refunds。三张表都是开启了 Row Binlog 和 before 镜像的 Unique Key Merge-on-Write 表,可以在 快速上手 创建的 ivm_demo 数据库中执行:
CREATE TABLE customers (
    customer_id BIGINT,
    name VARCHAR(32),
    city VARCHAR(16)
)
UNIQUE KEY(customer_id)
DISTRIBUTED BY HASH(customer_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "binlog.enable" = "true",
    "binlog.format" = "ROW",
    "binlog.need_historical_value" = "true"
);

CREATE TABLE sales (
    sale_id BIGINT,
    customer_id BIGINT,
    channel VARCHAR(16),
    amount DECIMAL(10, 2)
)
UNIQUE KEY(sale_id)
DISTRIBUTED BY HASH(sale_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "binlog.enable" = "true",
    "binlog.format" = "ROW",
    "binlog.need_historical_value" = "true"
);

CREATE TABLE refunds (
    refund_id BIGINT,
    sale_id BIGINT,
    amount DECIMAL(10, 2)
)
UNIQUE KEY(refund_id)
DISTRIBUTED BY HASH(refund_id) BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "enable_unique_key_merge_on_write" = "true",
    "binlog.enable" = "true",
    "binlog.format" = "ROW",
    "binlog.need_historical_value" = "true"
);

INSERT INTO customers VALUES
    (1, 'Alice', 'Beijing'),
    (2, 'Bob',   'Shanghai'),
    (3, 'Carol', 'Beijing');

INSERT INTO sales VALUES
    (101, 1,    'web',   120.00),
    (102, 1,    'app',    80.00),
    (103, 2,    'web',   200.00),
    (104, NULL, 'store',  50.00);

INSERT INTO refunds VALUES
    (9001, 102, 80.00),
    (9002, 103, 50.00);
数据中有两处特意安排的情况,连接和聚合示例会用到:门店订单 104 没有关联客户,customer_id 为 NULL;客户 Carol 还没有订单。
每个示例的执行步骤相同:执行示例中的 CREATE MATERIALIZED VIEW,再执行 REFRESH MATERIALIZED VIEW <mv_name> COMPLETE 建立基线;刷新任务成功后,执行 SELECT * FROM <mv_name> 查看结果。文中展示的结果已按前几列排序。
支持的关系运算
| 运算 | 说明 |
|---|---|
| 列和表达式 | 选择部分列,或者用确定性表达式计算新列 |
WHERE 过滤 | 按条件过滤基表的行 |
FROM 子查询 | FROM 子句中带别名的子查询,可以多层嵌套,内部不能包含聚合 |
| 常量行 | 不带 FROM 的 SELECT,结果固定为一行常量,例如 SELECT -1, 'unknown'。可以作为 UNION ALL 的分支或 Join 的一侧,也可以单独作为定义 |
GROUP BY 聚合 | 聚合必须位于查询最外层,之上只能有投影,且不能在聚合结果外再套表达式 |
GROUPING SETS、ROLLUP、CUBE | 可以配合 GROUPING()、GROUPING_ID() 使用,限制与 GROUP BY 相同 |
SELECT DISTINCT | 按不带聚合函数的 GROUP BY 处理,限制与 GROUP BY 相同 |
INNER JOIN、CROSS JOIN | 支持多表连接和自连接 |
LEFT OUTER JOIN、RIGHT OUTER JOIN、FULL OUTER JOIN | 保留全部行的一侧(LEFT JOIN 的左侧、RIGHT JOIN 的右侧、FULL JOIN 的两侧)不能是 excluded_trigger_tables 中未开启 Row Binlog 的 Duplicate Key 表,这类表的行没有固定的行标识 |
| 嵌套外连接 | 外连接中可能被补 NULL 的一侧本身又是一个 Join。这一侧越复杂,增量刷新计划越大 |
UNION ALL | 分支可以来自不同的表、同一张表或常量行 |
| 链式 IVM | 以另一个 IVM 作为基表。作为基表的 IVM 需要开启 Row Binlog 和 before 镜像 |
下面按类别给出示例。
单表查询
- 列和表达式
- WHERE 过滤
- FROM 子查询
- 常量行
选择需要的列,或者用表达式计算新列。表达式需要是确定性的,即相同的输入总是得到相同的结果,例如不能使用 NOW()、RAND()。
CREATE MATERIALIZED VIEW mv_sales_projection
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT sale_id, channel, amount, amount * 0.9 AS discounted_amount
FROM sales;
查询结果:
+---------+---------+--------+-------------------+
| sale_id | channel | amount | discounted_amount |
+---------+---------+--------+-------------------+
|     101 | web     | 120.00 |           108.000 |
|     102 | app     |  80.00 |            72.000 |
|     103 | web     | 200.00 |           180.000 |
|     104 | store   |  50.00 |            45.000 |
+---------+---------+--------+-------------------+
只保留满足条件的行。基表中的行被更新后,Doris 按新值重新判断:不再满足条件的行从物化视图中删除,开始满足条件的行加入物化视图。
CREATE MATERIALIZED VIEW mv_large_sales
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT sale_id, customer_id, amount
FROM sales
WHERE amount >= 100;
查询结果:
+---------+-------------+--------+
| sale_id | customer_id | amount |
+---------+-------------+--------+
|     101 |           1 | 120.00 |
|     103 |           2 | 200.00 |
+---------+-------------+--------+
在 FROM 子句中使用带别名的子查询,例如先筛选出 web 渠道的订单,再与客户表连接。子查询可以多层嵌套,内部同样只能使用本节列出的运算,并且不能包含聚合。
CREATE MATERIALIZED VIEW mv_web_sales
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT w.sale_id, c.name, w.amount
FROM (
    SELECT sale_id, customer_id, amount
    FROM sales
    WHERE channel = 'web'
) AS w
INNER JOIN customers AS c ON w.customer_id = c.customer_id;
查询结果:
+---------+-------+--------+
| sale_id | name  | amount |
+---------+-------+--------+
|     101 | Alice | 120.00 |
|     103 | Bob   | 200.00 |
+---------+-------+--------+
常量行是不带 FROM 的 SELECT,结果固定为一行常量。常见用法是给维表补一行“未知”成员,供关联不到维表的数据使用:
CREATE MATERIALIZED VIEW mv_customers_with_unknown
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT customer_id, name, city
FROM customers
UNION ALL
SELECT -1, 'unknown', 'unknown';
查询结果:
+-------------+---------+----------+
| customer_id | name    | city     |
+-------------+---------+----------+
|          -1 | unknown | unknown  |
|           1 | Alice   | Beijing  |
|           2 | Bob     | Shanghai |
|           3 | Carol   | Beijing  |
+-------------+---------+----------+
常量行也可以作为 Join 的一侧,例如 CROSS JOIN (SELECT 0.14 AS usd_rate) r 为每一行附加一个参数;还可以单独作为物化视图的定义,例如 SELECT 1 AS id, 'x' AS name。
常量行不会产生变化数据。包含常量行的物化视图第一次刷新时,Doris 总是执行 COMPLETE,即使请求的是 INCREMENTAL;之后的增量刷新只处理基表的变化。
聚合
- GROUP BY
- GROUPING SETS / ROLLUP / CUBE
- SELECT DISTINCT
按分组计算聚合结果。聚合的输入可以是单表、Join、UNION ALL 或 FROM 子查询,但聚合本身必须位于查询最外层。下面的示例先连接 sales 和 customers,再按城市聚合;订单 104 没有关联客户,不参与统计。
CREATE MATERIALIZED VIEW mv_city_sales
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.city, COUNT(*) AS sale_cnt, SUM(s.amount) AS total_amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id
GROUP BY c.city;
查询结果:
+----------+----------+--------------+
| city     | sale_cnt | total_amount |
+----------+----------+--------------+
| Beijing  |        2 |       200.00 |
| Shanghai |        1 |       200.00 |
+----------+----------+--------------+
聚合之上的投影可以给列改名、调整列顺序,或者对分组列做计算。HAVING、写在子查询或 Join 输入中的聚合,以及在聚合结果外再套表达式的写法都不支持,见 不支持的查询形式。
在一次聚合中同时计算多种维度组合。下面的示例用 ROLLUP(c.city, s.channel) 同时得到“城市 + 渠道”的明细、每个城市的小计和总计,小计和总计行中被汇总掉的列为 NULL。GROUPING SETS、CUBE,以及用于区分汇总行的 GROUPING()、GROUPING_ID() 函数同样支持。
CREATE MATERIALIZED VIEW mv_city_channel_rollup
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.city, s.channel, SUM(s.amount) AS total_amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id
GROUP BY ROLLUP(c.city, s.channel);
查询结果:
+----------+---------+--------------+
| city     | channel | total_amount |
+----------+---------+--------------+
| NULL     | NULL    |       400.00 |
| Beijing  | NULL    |       200.00 |
| Beijing  | app     |        80.00 |
| Beijing  | web     |       120.00 |
| Shanghai | NULL    |       200.00 |
| Shanghai | web     |       200.00 |
+----------+---------+--------------+
SELECT DISTINCT 按不带聚合函数的 GROUP BY 处理,限制与 GROUP BY 相同。注意 UNION(即 UNION DISTINCT)仍然不支持。
CREATE MATERIALIZED VIEW mv_channels
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT DISTINCT channel
FROM sales;
查询结果:
+---------+
| channel |
+---------+
| app     |
| store   |
| web     |
+---------+
多表连接
- INNER JOIN
- CROSS JOIN
- 外连接
- 嵌套外连接
只保留两侧都能匹配上的行。订单 104 没有关联客户,因此不在结果中。
CREATE MATERIALIZED VIEW mv_sales_customer
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT s.sale_id, c.name, c.city, s.amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id;
查询结果:
+---------+-------+----------+--------+
| sale_id | name  | city     | amount |
+---------+-------+----------+--------+
|     101 | Alice | Beijing  | 120.00 |
|     102 | Alice | Beijing  |  80.00 |
|     103 | Bob   | Shanghai | 200.00 |
+---------+-------+----------+--------+
返回两侧所有行的组合(笛卡尔积)。下面的示例对 customers 做自连接,列出所有客户的两两组合。
CREATE MATERIALIZED VIEW mv_customer_pairs
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT a.name AS customer_a, b.name AS customer_b
FROM customers a
CROSS JOIN customers b
WHERE a.customer_id < b.customer_id;
查询结果:
+------------+------------+
| customer_a | customer_b |
+------------+------------+
| Alice      | Bob        |
| Alice      | Carol      |
| Bob        | Carol      |
+------------+------------+
外连接保留一侧的全部行,另一侧没有匹配时补 NULL。LEFT OUTER JOIN 保留左侧,RIGHT OUTER JOIN 保留右侧,FULL OUTER JOIN 保留两侧。
LEFT OUTER JOIN:保留所有订单。订单 104 没有匹配的客户,name 为 NULL。
CREATE MATERIALIZED VIEW mv_sales_left
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT s.sale_id, s.amount, c.name
FROM sales s
LEFT OUTER JOIN customers c ON s.customer_id = c.customer_id;
查询结果:
+---------+--------+-------+
| sale_id | amount | name  |
+---------+--------+-------+
|     101 | 120.00 | Alice |
|     102 |  80.00 | Alice |
|     103 | 200.00 | Bob   |
|     104 |  50.00 | NULL  |
+---------+--------+-------+
RIGHT OUTER JOIN:保留所有客户。还没有订单的 Carol 也在结果中。
CREATE MATERIALIZED VIEW mv_sales_right
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.name, s.sale_id, s.amount
FROM sales s
RIGHT OUTER JOIN customers c ON s.customer_id = c.customer_id;
查询结果:
+-------+---------+--------+
| name  | sale_id | amount |
+-------+---------+--------+
| Alice |     101 | 120.00 |
| Alice |     102 |  80.00 |
| Bob   |     103 | 200.00 |
| Carol |    NULL |   NULL |
+-------+---------+--------+
FULL OUTER JOIN:同时保留没有客户的订单 104 和没有订单的客户 Carol。
CREATE MATERIALIZED VIEW mv_sales_full
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.name, s.sale_id, s.amount
FROM customers c
FULL OUTER JOIN sales s ON c.customer_id = s.customer_id;
查询结果:
+-------+---------+--------+
| name  | sale_id | amount |
+-------+---------+--------+
| NULL  |     104 |  50.00 |
| Alice |     101 | 120.00 |
| Alice |     102 |  80.00 |
| Bob   |     103 | 200.00 |
| Carol |    NULL |   NULL |
+-------+---------+--------+
外连接中可能被补 NULL 的一侧称为空值产生端,例如 LEFT JOIN 的右侧。嵌套外连接是指空值产生端本身又是一个 Join。下面的示例先用 sales LEFT JOIN refunds 关联退款,再把这个 Join 整体作为 customers LEFT JOIN 的右侧。
CREATE MATERIALIZED VIEW mv_customer_refunds
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT c.name, s.sale_id, r.refund_id, r.amount AS refund_amount
FROM customers c
LEFT OUTER JOIN (
    sales s
    LEFT OUTER JOIN refunds r ON s.sale_id = r.sale_id
) ON c.customer_id = s.customer_id;
查询结果:
+-------+---------+-----------+---------------+
| name  | sale_id | refund_id | refund_amount |
+-------+---------+-----------+---------------+
| Alice |     101 |      NULL |          NULL |
| Alice |     102 |      9001 |         80.00 |
| Bob   |     103 |      9002 |         50.00 |
| Carol |    NULL |      NULL |          NULL |
+-------+---------+-----------+---------------+
增量刷新需要同时计算空值产生端在变化前后的结果,这一侧越复杂,刷新计划越大。规划或刷新开销过高时,可以先把这一侧创建为下层 IVM,再基于它创建当前物化视图,见 合并与链式 IVM 中的链式 IVM 示例。
合并与链式 IVM
- UNION ALL
- 链式 IVM
合并多个查询的结果,不去重。分支可以来自不同的表、同一张表或常量行。下面的示例把销售和退款合并为一张流水表,退款金额记为负数。
CREATE MATERIALIZED VIEW mv_ledger
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT sale_id AS doc_id, 'sale' AS doc_type, amount
FROM sales
UNION ALL
SELECT refund_id, 'refund', -amount
FROM refunds;
查询结果:
+--------+----------+--------+
| doc_id | doc_type | amount |
+--------+----------+--------+
|    101 | sale     | 120.00 |
|    102 | sale     |  80.00 |
|    103 | sale     | 200.00 |
|    104 | sale     |  50.00 |
|   9001 | refund   | -80.00 |
|   9002 | refund   | -50.00 |
+--------+----------+--------+
以一个 IVM 作为另一个 IVM 的基表,把复杂计算拆成多层,例如下层 IVM 负责 Join,上层 IVM 负责聚合。作为基表的 IVM 本身是 Unique Key Merge-on-Write 表,需要像其他 Merge-on-Write 基表一样开启 Row Binlog 和 before 镜像,否则无法创建上层 IVM,例如未开启 Row Binlog 时报错 row binlog is not enabled for table。
CREATE MATERIALIZED VIEW mv_sales_city_detail
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES (
    "replication_num" = "1",
    "binlog.enable" = "true",
    "binlog.format" = "ROW",
    "binlog.need_historical_value" = "true"
)
AS
SELECT s.sale_id, c.city, s.amount
FROM sales s
INNER JOIN customers c ON s.customer_id = c.customer_id;

CREATE MATERIALIZED VIEW mv_city_total
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT city, COUNT(*) AS sale_cnt, SUM(amount) AS total_amount
FROM mv_sales_city_detail
GROUP BY city;
上层 IVM 只能读取下层已经刷新的结果,因此应先刷新下层,再刷新上层。依次刷新后,mv_city_total 的查询结果:
+----------+----------+--------------+
| city     | sale_cnt | total_amount |
+----------+----------+--------------+
| Beijing  |        2 |       200.00 |
| Shanghai |        1 |       200.00 |
+----------+----------+--------------+
普通异步物化视图(非 IVM)不能作为 IVM 的基表。
支持的聚合函数
IVM 支持以下聚合函数,参数可以是列或确定性表达式:
COUNT(*)、COUNT(expr)SUMAVGMINMAXBITMAP_UNIONBITMAP_UNION_COUNTARRAY_AGGCOLLECT_LIST(仅支持单参数形式)
下面的示例都按 sales 表的渠道分组:
- COUNT
- SUM
- AVG
- MIN / MAX
- Bitmap 聚合
- 数组聚合
COUNT(*) 统计行数;COUNT(expr) 只统计 expr 不为 NULL 的行。门店订单 104 的 customer_id 为 NULL,因此 store 渠道的 member_sale_cnt 为 0。
CREATE MATERIALIZED VIEW mv_agg_count
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       COUNT(*) AS sale_cnt,
       COUNT(customer_id) AS member_sale_cnt
FROM sales
GROUP BY channel;
查询结果:
+---------+----------+-----------------+
| channel | sale_cnt | member_sale_cnt |
+---------+----------+-----------------+
| app     |        1 |               1 |
| store   |        1 |               0 |
| web     |        2 |               2 |
+---------+----------+-----------------+
计算合计。参数可以是列,也可以是确定性表达式,例如只累加 100 及以上的订单金额。
CREATE MATERIALIZED VIEW mv_agg_sum
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       SUM(amount) AS total_amount,
       SUM(IF(amount >= 100, amount, 0)) AS large_amount
FROM sales
GROUP BY channel;
查询结果:
+---------+--------------+--------------+
| channel | total_amount | large_amount |
+---------+--------------+--------------+
| app     |        80.00 |         0.00 |
| store   |        50.00 |         0.00 |
| web     |       320.00 |       320.00 |
+---------+--------------+--------------+
计算平均值。Doris 会在物化视图中额外保存隐藏的合计和计数,增量刷新时用它们重新计算平均值。
CREATE MATERIALIZED VIEW mv_agg_avg
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel, AVG(amount) AS avg_amount
FROM sales
GROUP BY channel;
查询结果:
+---------+------------+
| channel | avg_amount |
+---------+------------+
| app     |    80.0000 |
| store   |    50.0000 |
| web     |   160.0000 |
+---------+------------+
计算最小值和最大值。
CREATE MATERIALIZED VIEW mv_agg_minmax
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel, MIN(amount) AS min_amount, MAX(amount) AS max_amount
FROM sales
GROUP BY channel;
查询结果:
+---------+------------+------------+
| channel | min_amount | max_amount |
+---------+------------+------------+
| app     |      80.00 |      80.00 |
| store   |      50.00 |      50.00 |
| web     |     120.00 |     200.00 |
+---------+------------+------------+
新写入的值可以直接与当前的最小值、最大值比较。但如果删除或更新的行恰好持有当前的最小值或最大值,新的结果无法从已有结果推出,需要重新读取完整数据。例如建立基线后删除订单 101(web 渠道当前的最小值 120.00),严格 INCREMENTAL 刷新会失败,IvmFallbackReason 为 MIN_MAX_BOUNDARY_HIT;INCREMENTAL FALLBACK 刷新会回退到 COMPLETE。
BITMAP_UNION 合并分组内的 Bitmap,BITMAP_UNION_COUNT 返回合并结果中不同值的个数,常用于精确去重计数。下面的示例统计每个渠道的去重客户:customer_bitmap 保存客户 ID 集合,customer_cnt 是去重后的客户数,customer_id 为 NULL 的订单 104 不计入。
CREATE MATERIALIZED VIEW mv_agg_bitmap
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       BITMAP_UNION(TO_BITMAP(customer_id)) AS customer_bitmap,
       BITMAP_UNION_COUNT(TO_BITMAP(customer_id)) AS customer_cnt
FROM sales
GROUP BY channel;
Bitmap 列需要用 BITMAP_TO_STRING 转换后查看:
SELECT channel, BITMAP_TO_STRING(customer_bitmap) AS customers, customer_cnt
FROM mv_agg_bitmap
ORDER BY channel;
+---------+-----------+--------------+
| channel | customers | customer_cnt |
+---------+-----------+--------------+
| app     | 1         |            1 |
| store   |           |            0 |
| web     | 1,2       |            2 |
+---------+-----------+--------------+
Bitmap 只保存合并后的结果,无法从中减去某一行贡献的值。因此删除或更新参与聚合的行时,如果所在分组还有其他行,就需要重新计算完整 Bitmap:严格 INCREMENTAL 刷新会失败,IvmFallbackReason 为 BITMAP_AGG_DELETE;INCREMENTAL FALLBACK 会回退到 COMPLETE。
ARRAY_AGG 和 COLLECT_LIST 把分组内的值收集为数组,两者对 NULL 的处理不同:ARRAY_AGG 保留 NULL 元素,COLLECT_LIST 跳过 NULL。
CREATE MATERIALIZED VIEW mv_agg_array
BUILD DEFERRED REFRESH INCREMENTAL ON MANUAL
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES ("replication_num" = "1")
AS
SELECT channel,
       ARRAY_AGG(customer_id) AS customer_ids,
       COLLECT_LIST(customer_id) AS member_ids
FROM sales
GROUP BY channel;
查询结果:
+---------+--------------+------------+
| channel | customer_ids | member_ids |
+---------+--------------+------------+
| app     | [1]          | [1]        |
| store   | [null]       | []         |
| web     | [1, 2]       | [1, 2]     |
+---------+--------------+------------+
增量刷新把数组当作无序集合维护,数组中元素的顺序不固定。COLLECT_LIST 只支持单参数形式,不支持指定最大长度的 COLLECT_LIST(expr, max_size);ARRAY_AGG 不支持 JSONB 或 VARIANT 类型的元素。
不支持带 DISTINCT 的聚合函数,例如 COUNT(DISTINCT customer_id)。需要对非负整数列精确去重计数时,可以改用 BITMAP_UNION_COUNT(TO_BITMAP(customer_id)),但删除或更新数据时需要重新计算完整 Bitmap,见下文。
部分聚合函数在删除数据时无法只根据当前增量安全地得到新结果。Unique Key 表的更新会先删除旧行再写入新行,因此更新同样会触发以下情况:
- 删除的值可能是当前
MIN或MAX时,需要重新读取完整数据。 - 删除影响 Bitmap 聚合结果时,需要重新计算完整 Bitmap。
严格 INCREMENTAL 会在这些情况下失败;INCREMENTAL FALLBACK 会回退到 COMPLETE。
不支持的查询形式
以下形式不支持,使用显式 REFRESH INCREMENTAL 时创建失败:
UNION(即UNION DISTINCT)、INTERSECT和EXCEPT。ORDER BY、LIMIT和窗口函数。HAVING,以及写在FROM子查询或 Join 输入中的聚合。聚合只能位于查询最外层,需要过滤聚合结果时,可以在查询物化视图时再过滤。WHERE或SELECT列表中的子查询,例如IN (SELECT ...)、EXISTS (SELECT ...)和标量子查询。其中IN子查询和标量子查询可能报Multiple columns returned by subquery are not yet supported,原因同样是 IVM 不支持这类子查询。WITH子句(CTE)。可以改写为FROM子查询。LATERAL VIEW。- 使用普通异步物化视图作为基表。链式维护要求下层物化视图本身也是 IVM。
- 上文表格之外的其他运算。
另外,在聚合结果外再套表达式的写法虽然可以创建,但每次增量刷新都会失败,例如 SUM(amount) * 100、MAX(amount) + 1 和 SUM(amount) / COUNT(*)。严格 INCREMENTAL 刷新失败时,IvmFallbackReason 为 PLAN_REWRITE_FAILED;INCREMENTAL FALLBACK 每次都会回退到 COMPLETE。可以直接输出聚合结果,在查询物化视图时再计算;或者把表达式写进聚合函数的参数,例如 SUM(amount * 100)。
刷新和回退
创建时选择刷新策略
| 定义 | 创建时行为 | 后续默认刷新行为 |
|---|---|---|
REFRESH INCREMENTAL | 严格检查 IVM 支持范围,不支持则创建失败 | 只尝试 IVM,失败时任务失败 |
REFRESH INCREMENTAL FALLBACK | 与严格模式相同,仍需通过 IVM 检查 | 先尝试 IVM,失败后按原因回退 |
REFRESH AUTO | 先探测定义是否支持 IVM;不支持时按普通异步物化视图创建 | 对支持 IVM 的视图依次尝试 IVM、分区刷新和完整刷新 |
REFRESH PARTITIONS [FALLBACK] | 要求物化视图定义 PARTITION BY | 重算变化分区;指定 FALLBACK 后可回退到完整刷新 |
REFRESH COMPLETE | 不创建 IVM 元数据 | 始终完整刷新 |
设置自动刷新间隔
IVM 复用异步物化视图的触发方式,没有单独的触发语法。在 REFRESH INCREMENTAL [FALLBACK] 之后通过 ON 子句指定:
| 触发方式 | 语法 | 说明 |
|---|---|---|
| 手动触发 | ON MANUAL | 默认值。只在执行 REFRESH MATERIALIZED VIEW 时刷新 |
| 定时触发 | ON SCHEDULE EVERY <interval> <unit> [STARTS '<start_time>'] | 按固定间隔自动执行增量刷新 |
| 提交触发 | ON COMMIT | 基表导入事务提交后自动执行增量刷新 |
定时触发的间隔规则如下:
<interval>必须是正整数,<unit>支持MINUTE、HOUR、DAY、WEEK。- 最小刷新间隔为
EVERY 1 MINUTE。 指定SECOND会报错interval time unit can not be second。FE 配置enable_job_schedule_second_for_test可以放开秒级间隔,但该配置仅供测试,生产环境不要开启。 STARTS指定首次调度时间,格式为'yyyy-MM-dd HH:mm:ss',必须晚于当前时间。不指定时,第一次刷新在创建物化视图后经过一个间隔执行。后续调度时间固定为首次调度时间加整数倍间隔,不受上一次任务结束时间影响。
下面的示例每 5 分钟执行一次增量刷新,无法增量计算时允许回退:
CREATE MATERIALIZED VIEW orders_by_status
BUILD IMMEDIATE
REFRESH INCREMENTAL FALLBACK ON SCHEDULE EVERY 5 MINUTE
DISTRIBUTED BY RANDOM BUCKETS 1
PROPERTIES (
    "replication_num" = "1"
)
AS
SELECT
    order_status,
    COUNT(*) AS order_count,
    SUM(amount) AS total_amount
FROM orders
GROUP BY order_status;
定时触发和提交触发的任务按物化视图创建时定义的刷新策略执行:INCREMENTAL 只尝试 IVM,INCREMENTAL FALLBACK 先尝试 IVM 再按原因回退,AUTO 依次尝试 IVM、分区刷新和完整刷新。自动触发的任务还有以下行为:
- 首次自动刷新会自动建立基线。 物化视图还没有刷新成功过时(例如使用
BUILD DEFERRED创建后尚未刷新),第一次定时或提交触发的任务会自动执行COMPLETE建立完整基线,不需要手工执行COMPLETE;之后的任务才执行增量刷新。 - 同一物化视图的刷新任务串行执行,多余的触发会被跳过。 自动触发的任务最多保留一个正在运行和一个等待执行。当刷新间隔短于单次刷新耗时,或者
ON COMMIT下基表提交非常频繁时,新的触发会被跳过,FE 指标async_materialized_view_task_skip_num累加。等待中的任务执行时会一次性消费积累的全部变化,因此不会丢失变化,但实际刷新延迟会大于设定间隔。选择间隔时,应保证正常负载下单次增量刷新能在一个间隔内完成。 ON COMMIT只由参与增量维护的基表触发。excluded_trigger_tables中的基表提交不触发刷新,详见 excluded_trigger_tables。
修改触发方式时只指定 ON 子句,不要重复写 INCREMENTAL。IVM 的刷新方式不能通过 ALTER 修改,ALTER MATERIALIZED VIEW ... REFRESH INCREMENTAL ... 会被拒绝;只修改触发方式是允许的,修改后 Doris 会按新的触发方式重建调度任务:
ALTER MATERIALIZED VIEW orders_by_status REFRESH ON SCHEDULE EVERY 1 MINUTE;
ALTER MATERIALIZED VIEW orders_by_status REFRESH ON COMMIT;
ALTER MATERIALIZED VIEW orders_by_status REFRESH ON MANUAL;
手动覆盖刷新方式
IVM 创建后,可以根据需要执行:
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL;
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL FALLBACK;
REFRESH MATERIALIZED VIEW <mv_name> PARTITIONS;
REFRESH MATERIALIZED VIEW <mv_name> PARTITIONS FALLBACK;
REFRESH MATERIALIZED VIEW <mv_name> COMPLETE;
IVM 不允许使用旧的 PARTITION (<partition_name>) 或 PARTITIONS (<partition_name>, ...) 语法指定刷新分区。需要使用 PARTITIONS 关键字让 Doris 计算应刷新的分区,或者使用 COMPLETE 刷新全部数据。
回退顺序
当请求允许回退时,Doris 默认按以下顺序尝试:
IVM -> PARTITIONS -> COMPLETE
某些失败表示现有 IVM 基线已不能安全使用,Doris 会跳过分区刷新并直接执行 COMPLETE。常见原因包括:
IvmFallbackReason | 含义 | 恢复方式 |
|---|---|---|
STREAM_UNSUPPORTED | 内部 Stream 缺失或无法继续使用 | 完整刷新,同时重建内部 Stream 并重新对齐消费位点 |
MIN_MAX_BOUNDARY_HIT | 删除可能改变当前 MIN 或 MAX | 完整重算聚合结果 |
BITMAP_AGG_DELETE | 删除影响 Bitmap 聚合 | 完整重算 Bitmap |
PLAN_SIGNATURE_MISMATCH | 当前查询计划与已持久化的 IVM 布局不一致 | 完整刷新并建立新基线 |
INCOMPLETE_REFRESH_SNAPSHOT | 还没有可供回退链使用的完整刷新快照 | 完整刷新建立基线 |
严格 INCREMENTAL 不执行回退。任务失败后,物化视图保留刷新前的数据,内部 Stream 消费位点也不会推进。处理错误后,可以重新执行增量刷新,或者执行 COMPLETE 重建基线。
首次刷新和基线重建
增量刷新只能处理基线之后的变化。基线是物化视图最近一次完整计算的结果,以及与之对齐的内部 Stream 消费位点。Doris 按物化视图分区记录基线是否有效:基线失效的分区需要完整重建,其余分区继续增量刷新。
首次刷新
物化视图还没有刷新成功过时,所有分区都没有基线。无论请求哪种刷新方式,第一次刷新都会完整计算全部数据:
| 刷新请求 | 首次刷新的行为 |
|---|---|
COMPLETE | 完整刷新全部数据 |
INCREMENTAL | 先重建全部分区,再处理增量 |
INCREMENTAL FALLBACK、AUTO | 直接执行 COMPLETE |
| 定时或提交触发 | 执行 COMPLETE,见 设置自动刷新间隔 |
这些任务的 RefreshMode 都是 COMPLETE,IvmFallbackReason 为空。因此创建 IVM 后不需要专门执行一次 COMPLETE;快速上手 中显式执行 COMPLETE,是为了让建立基线的步骤更清楚。
部分分区的基线失效
以下基表操作只修改元数据,不产生 Row Binlog。增量刷新无法从变化数据中得知哪些行被删除或替换,因此读取了这些基表分区的物化视图分区需要重建:
TRUNCATE TABLE,包括只截断部分分区ALTER TABLE ... DROP PARTITIONRECOVER PARTITIONALTER TABLE ... REPLACE PARTITION,使用默认的严格范围匹配时
物化视图按基表的分区列分区时,Doris 只标记受影响的物化视图分区。下一次刷新(包括严格 INCREMENTAL)先重建这些分区,再增量刷新其余分区;tasks("type"="mv") 的 IvmRebuiltPartitions 列记录本次额外重建的分区数。基表分区被删除时,对应的物化视图分区会在分区同步时一并删除,不需要重建。
物化视图没有分区,或者 Doris 无法确定受影响的物化视图分区时,整个物化视图的基线失效,处理方式见下文。excluded_trigger_tables 中的基表执行上述操作,不会使基线失效。
整个物化视图的基线失效
以下情况会使整个物化视图的基线失效,物化视图进入 SCHEMA_CHANGE 状态,可以通过 mv_infos 的 State 和 SchemaChangeDetail 列查看:
- 基表执行
DROP COLUMN、MODIFY COLUMN、RENAME COLUMN、RENAME(重命名表)或REPLACE WITH TABLE。ADD COLUMN不会使基线失效。开启 Row Binlog 的表不允许MODIFY COLUMN和RENAME COLUMN,见 Row Binlog 对表 DDL 的约束。 - 基表执行不使用严格范围匹配的
REPLACE PARTITION,或者上一节的分区操作无法定位到具体的物化视图分区。 - 修改物化视图属性扩大了维护范围:从
excluded_trigger_tables中移除基表、扩大或移除ivm_partition_window_limit,或者扩大partition_sync_limit的同步范围。
物化视图处于 SCHEMA_CHANGE 状态时,下一次 INCREMENTAL、INCREMENTAL FALLBACK、AUTO、COMPLETE 或 PARTITIONS FALLBACK 刷新会完整重建物化视图,成功后状态恢复为 NORMAL。不带 FALLBACK 的 PARTITIONS 刷新会失败,并提示改用 COMPLETE、AUTO 或 PARTITIONS FALLBACK。
如果基表变更后定义 SQL 已无法分析,例如删除了物化视图使用的列,任何刷新都会失败,需要删除并重新创建物化视图。
内部 Stream 无法使用
内部 Stream 缺失或无法继续使用时,INCREMENTAL FALLBACK 和 AUTO 直接执行 COMPLETE,IvmFallbackReason 为 STREAM_UNSUPPORTED;COMPLETE 刷新会重建内部 Stream 并重新对齐消费位点。严格 INCREMENTAL 刷新会失败,需要执行一次 COMPLETE 或 AUTO。
预览和解释增量计划
使用 EXPLAIN 查看刷新计划
下面的命令只生成计划,不修改物化视图数据、内部 Stream 位点或 IVM 元数据:
EXPLAIN REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL;
默认计划只包含当前有未消费数据的 Stream。需要检查完整的增量计划结构时,使用:
EXPLAIN REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH ALL STREAMS;
WITH ALL STREAMS 会把当前已经消费完的 Stream 也放入计划,适合检查多表 Join 的完整增量形态。它不会改变任何持久化状态。
也可以解释完整刷新计划:
EXPLAIN REFRESH MATERIALIZED VIEW <mv_name> COMPLETE;
使用 DRY RUN 查看待写入数据
WITH DRY RUN 执行下一次增量刷新的增量查询并把结果返回给客户端,但不写入物化视图,也不推进 Stream 位点:
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH DRY RUN;
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH DRY RUN LIMIT 100;
REFRESH MATERIALIZED VIEW <mv_name> INCREMENTAL WITH DRY RUN LIMIT 100 OFFSET 200;
返回结果是刷新内部实际使用的写入行,因此除了业务列,还包含 IVM、Sequence 和 Delete Sign 等内部列。只要基表数据没有变化,重复执行会得到相同结果。
DRY RUN 只支持 IVM 的 INCREMENTAL 刷新,不能与 COMPLETE、EXPLAIN 或分区刷新组合使用。
内部 Table Stream
IVM 自动管理内部 Table Stream 的完整生命周期:
- 创建 IVM 时,为每张参与增量维护的基表创建内部 Stream。
- 修改
excluded_trigger_tables时,按新的基表集合增加或删除内部 Stream。 - 删除 IVM 时,清理该物化视图拥有的内部 Stream。
- 刷新时按基表分区记录和推进消费位点。
通过 mv_infos 可以直接查看基表和内部 Stream 的映射:
SELECT Name, IvmBaseTableStreams
FROM mv_infos("database" = "<database_name>")
WHERE Name = "<mv_name>";
也可以在 information_schema.table_streams 和 information_schema.table_stream_consumption 中查看 Stream 状态和分区积压。
内部 Stream 以 __doris_ivm_stream_ 开头,仅供 IVM 使用。不要对其执行 INSERT INTO ... SELECT 消费,也不要手工删除或重建。Doris 会拒绝把内部 Stream 用于普通 INSERT INTO 消费。
Table Stream 的位点、快照和并发语义见 Table Stream 基础 和 Table Stream 进阶。
IVM 属性
先根据行标识、分区窗口和触发关系选择属性,再结合下面的小节评估具体影响。
| 属性 | 默认值 | 是否可修改 | 作用 |
|---|---|---|---|
ivm_use_full_keys | false | 否 | 把来源行标识 Key 加入物化视图的 Unique Key,降低 Hash 碰撞风险 |
ivm_partition_window_limit | 不限制 | 是 | 只维护指定基表按分区值排序后的最后 N 个分区 |
excluded_trigger_tables | 不排除 | 是 | 指定不创建内部 Stream、也不独立触发增量刷新的基表 |
ivm_use_full_keys
ivm_use_full_keys 控制物化视图的 Unique Key 是否同时包含来源行的标识 Key:
| 项目 | 说明 |
|---|---|
| 类型 | Boolean |
| 默认值 | false |
| 是否可修改 | 否,只能在创建 IVM 时设置 |
| 作用 | 降低复合行标识使用 Hash 时发生碰撞的风险 |
| 代价 | 增加物化视图 Key 的宽度和存储开销 |
PROPERTIES (
    "ivm_use_full_keys" = "true"
)
当查询包含多表 Join、UNION ALL 或链式 IVM,并且业务更重视避免行标识 Hash 碰撞时,可以开启该属性。开启前应确认来源 Key 的类型和总长度满足 Doris Unique Key 限制。
ivm_partition_window_limit
ivm_partition_window_limit 限制 IVM 每次只维护指定基表按分区值排序后的最后 N 个分区。格式为 <table_name>:<partition_count>,多张表用逗号分隔:
PROPERTIES (
    "ivm_partition_window_limit" = "orders:7,users:1"
)
该属性只限制 IVM 增量刷新读取的分区,不是物化视图分区保留策略。COMPLETE 仍会读取完整基表并建立完整结果。被窗口排除的旧分区变化不会进入后续 IVM 结果,因此这是有损配置,只适合业务明确只关心最近分区的场景。
可以通过 ALTER MATERIALIZED VIEW ... SET 修改该属性。扩大窗口或移除限制后,先前被忽略的变化无法从已有位点恢复,物化视图的基线随之失效,下一次刷新会完整重建物化视图,见 首次刷新和基线重建。
excluded_trigger_tables
excluded_trigger_tables 中的基表不创建内部 Stream,也不独立触发增量刷新。刷新由其他基表变化触发时,Doris 仍会在计算中读取该表的当前数据。
只应排除变化很少的维表,或者业务允许其变化延迟到其他基表触发刷新时才进入结果。排除一张频繁变化的表会使物化视图在该表单独变化后保持旧结果。
资源和分区属性
workload_group:指定刷新任务使用的 Workload Group,用于限制 CPU 和内存资源。partition_sync_limit、partition_sync_time_unit:控制物化视图保留和同步的分区范围,与ivm_partition_window_limit的增量读取窗口不同。refresh_partition_num:控制分区刷新和回退时单条INSERT处理的分区数量,不控制 IVM delta 的行数。
所有物化视图属性见 CREATE ASYNC MATERIALIZED VIEW。
限制和注意事项
- IVM 只能在创建物化视图时启用。不能通过
ALTER MATERIALIZED VIEW把普通物化视图改为 IVM,也不能把 IVM 改为其他默认刷新方式。需要切换时,请重建物化视图。 - 开启 Row Binlog 会增加写入和存储开销。Unique Key MoW 表还需要读取并保存更新前的值。只为确实需要 IVM 的基表开启,并在生产上线前使用真实负载评估导入吞吐。
- IVM 仍通过异步任务刷新,不提供与基表事务同步的实时一致性。刷新延迟取决于触发方式、排队时间和增量计划的执行时间。定时触发的最小间隔为 1 分钟,见 设置自动刷新间隔。
- 复杂的嵌套外连接会扩大增量计划,尤其是空值产生端的复杂子树。遇到规划或刷新开销过高时,可以简化 Join,或者先把复杂子树物化为下层 IVM。
MIN、MAX和 Bitmap 聚合在部分删除场景下需要完整重算。生产环境建议使用INCREMENTAL FALLBACK或AUTO,并监控IvmFallbackReason。- Row Binlog 的表模型、列类型、Schema Change 和删除行为限制会直接影响 IVM,详见 Row Binlog 的支持范围与限制。
常见问题
遇到创建失败、刷新回退或数据未更新时,按下表定位原因。
| 问题 | 排查与处理 |
|---|---|
CREATE MATERIALIZED VIEW ... REFRESH INCREMENTAL 创建失败 | 检查 FE 是否开启 enable_feature_binlog 和 enable_table_stream,基表是否满足模型与 Row Binlog 要求,以及定义 SQL 是否在 IVM 支持范围内 |
严格增量刷新任务的 RefreshMode 为 COMPLETE,或 IvmRebuiltPartitions 大于 0 | 这是首次刷新或基线失效后的自动重建,不是错误。触发条件见 首次刷新和基线重建 |
不带 FALLBACK 的 PARTITIONS 刷新报错 The refresh baseline of MV ... was invalidated | 整个物化视图的基线已失效,改用 COMPLETE、AUTO 或 PARTITIONS FALLBACK 刷新 |
ON SCHEDULE EVERY 30 SECOND 报错 interval time unit can not be second | 定时刷新的最小间隔是 EVERY 1 MINUTE,单位只支持 MINUTE、HOUR、DAY、WEEK。需要更低延迟时改用 ON COMMIT,见 设置自动刷新间隔 |
| 定时刷新的实际延迟大于设定间隔 | 同一物化视图的任务串行执行,单次刷新耗时超过间隔时多余触发会被跳过。检查 tasks("type"="mv") 中的任务耗时和 FE 指标 async_materialized_view_task_skip_num,拉长间隔、简化定义或通过 workload_group 增加刷新资源 |
刷新任务回退到 COMPLETE | 查询 tasks("type"="mv") 的 IvmFallbackReason,并根据 回退顺序 中的原因处理 |
| 被排除的基表单独变化后,视图数据未更新 | excluded_trigger_tables 中的表不会独立触发刷新。等待其他基表变化触发刷新,或者执行一次 COMPLETE 刷新。把该表从 excluded_trigger_tables 中移除后,下一次刷新会完整重建物化视图 |
| 能否手工消费或重置内部 Stream | 不能。内部 Stream 仅供 IVM 使用,由 Doris 管理生命周期和消费位点 |
最佳实践
- 先比较变化行数和分区大小。 变化只占分区很小比例时优先考虑 IVM;变化覆盖大部分分区时,
PARTITIONS可能更简单。 - 生产环境启用安全回退。 使用
INCREMENTAL FALLBACK或AUTO,避免删除或基线问题让刷新长期失败。 - 按刷新耗时选择触发方式和间隔。 定时触发的最小间隔为 1 分钟,间隔应大于正常负载下单次增量刷新的耗时;需要更低延迟且基表提交不频繁时使用
ON COMMIT。 - 先核对基线。 首次刷新会完整计算全部数据,确认这次的结果正确后,再交给增量刷新维护。
- 更新和删除场景使用 Unique Key MoW。 Duplicate Key 表只适合追加型数据。
- 为刷新任务隔离资源。 通过
workload_group避免复杂增量计划与在线查询争抢资源。 - 监控任务和 Stream 积压。 同时观察
tasks("type"="mv")、mv_infos和information_schema.table_stream_consumption。 - 定期检查回退原因。 偶发回退可以保证正确性;持续回退说明查询形态、Binlog 连续性或基线需要处理。
清理示例
DROP MATERIALIZED VIEW orders_by_status;
DROP TABLE orders;
DROP DATABASE ivm_demo;
删除 IVM 时,Doris 会一并清理其内部 Table Stream,不需要单独执行 DROP STREAM。
更多参考
- 异步物化视图的整体能力和适用场景:异步物化视图概述
- 创建、查询和维护异步物化视图:创建、查询与维护异步物化视图
- 刷新策略选型与资源规划:异步物化视图使用指南
- Row Binlog 的开启方式和限制:Row Binlog
- Table Stream 的消费、位点和快照语义:Table Stream 基础
- 手动刷新语法:REFRESH MATERIALIZED VIEW
- 查看 IVM 与内部 Stream 映射:MV_INFOS
- 查看刷新范围和回退原因:TASKS
